

A LINQ a .NET-be egy új, erőteljes adamanipuláló nyelvként került be. A LINQ to SQL részeként lehetővé teszi, hogy kényelmesen kommunikáljunk az adatbázis-kezelő rendszerekkel, például az Entity Framework segítségével. Azonban gyakran, amikor használják, a fejlesztők elfelejtik megnézni, hogy pontosan milyen SQL-lekérdezést generál a queryable provider, az ön esetében – az Entity Framework.
Vizsgáljunk meg két fő szempontot példán keresztül.
Ehhez SQL Serverben létrehozunk egy Test adatbázist, amelyben a következő lekérdezéssel létrehozunk két táblát:
Táblák létrehozása
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD CONSTRAINT [DF_Ref_InsertUTCDate] DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD CONSTRAINT [DF_Customer_Ref_ID] DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD CONSTRAINT [DF_Customer_InsertUTCDate] DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Most töltsük fel a Ref táblát az alábbi szkript futtatásával:
A Ref tábla feltöltése
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Hasonlóképpen töltsük ki a Customer táblát az alábbi szkript segítségével:
A Customer tábla feltöltése
HASZNÁLD [TEST]
MENJ

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

MIKÖZBEN(@ind<=12000000)
KEZDD
	HA(@ind%3=0) ÁLLÍTSD BE @ind_ref=1;
	ELSE HA (@ind%5=0) ÁLLÍTSD BE @ind_ref=2;
	ELSE HA (@ind%7=0) ÁLLÍTSD BE @ind_ref=3;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=4;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=5;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=6;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=7;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=8;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=9;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=10;
	ELSE HA (@ind=0) ÁLLÍTSD BE @ind_ref=11;
	ELSE ÁLLÍTSD BE @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 VÁLASZTHATÓ
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
VÉGEZD
MENJ
Így két táblát kaptunk, az egyikkel több mint 1 millió sorral, a másikkal pedig több mint 10 millió sorral.
Most a Visual Studióban létre kell hozni egy tesztprojektet Visual C# Console App (.NET Framework):
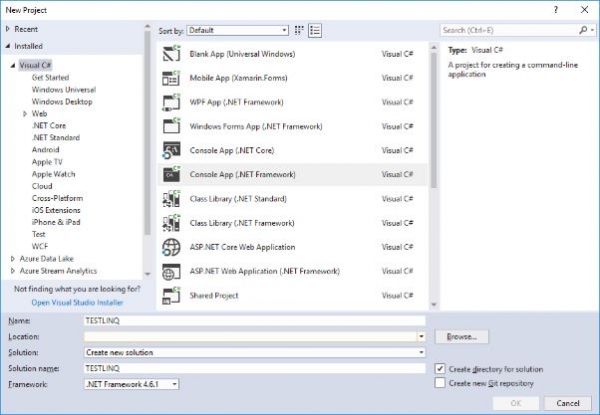
Ezután hozzá kell adnunk egy könyvtárat az Entity Framework számára az adatbázissal való interakcióhoz.
Az hozzáadásához kattintsunk a projektre a jobb gombbal, és válasszuk a helyi menüből a Manage NuGet Packages lehetőséget:
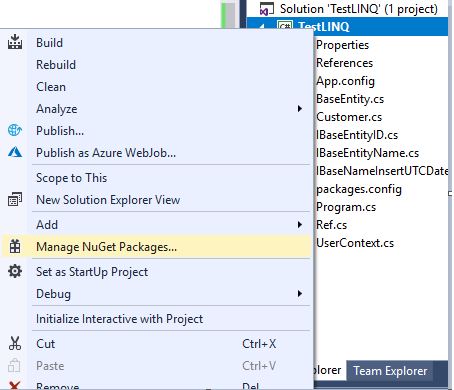
Ezután a megjelenő NuGet csomagkezelő ablakban a keresőmezőbe írjuk be az „Entity Framework” szót, válasszuk ki az Entity Framework csomagot, és telepítsük:
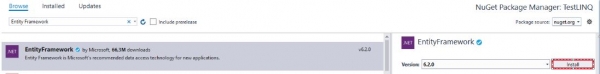
Ezután az App.config fájlban a configSections elem bezárása után a következő blokkot kell hozzáadnunk:
A connectionString-ben meg kell adni a csatlakozási sztringet.
Most külön fájlokban létrehozunk 3 interfészt:
- IBaseEntityID interfész megvalósítása
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - IBaseEntityName interfész megvalósítása
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - IBaseNameInsertUTCDate interfész megvalósítása
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
A külön fájlban létrehozunk egy alapvető BaseEntity osztályt a két entitásunk számára, amely tartalmazni fogja a közös mezőket:
BaseEntity alap osztály megvalósítása
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Ezután külön fájlokban létrehozzuk a két entitásunkat:
- Ref osztály megvalósítása
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Customer osztály megvalósítása
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Most létrehozzuk a UserContext kontextust külön fájlban:
UserContext osztály megvalósítása
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
Kész megoldást kaptunk a LINQ to SQL optimalizálásához EF-en keresztül az MS SQL Server számára:
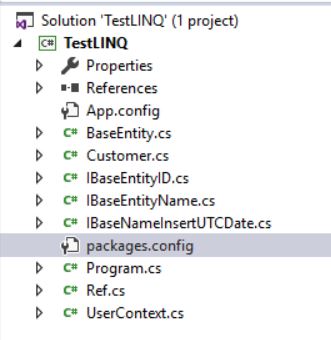
Most a Program.cs fájlba írjuk be a következő kódot:
Program.cs fájl
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Ezután elindítjuk a projektünket.
A program végén a következő jelenik meg a konzolon:
A generált SQL lekérdezés
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Ezért összességében elmondható, hogy a LINQ lekérdezés jól generálta az SQL lekérdezést az MS SQL Server adatbázis számára.
Most módosítsuk a feltételt ÉS-ről VAGY-ra a LINQ lekérdezésben:
LINQ lekérdezés
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Most újra elindítjuk a programunkat.
A végrehajtás egy hibával leáll, amely a 30 másodperces végrehajtási idő túllépésével kapcsolatos:
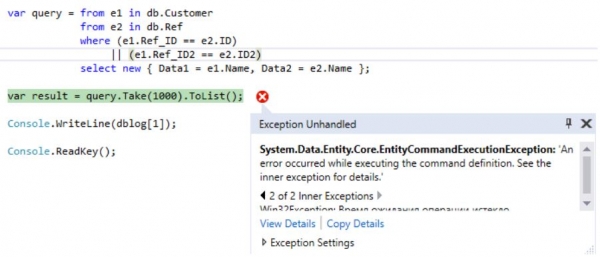
Ha megnézzük, hogy milyen lekérdezést generált a LINQ:
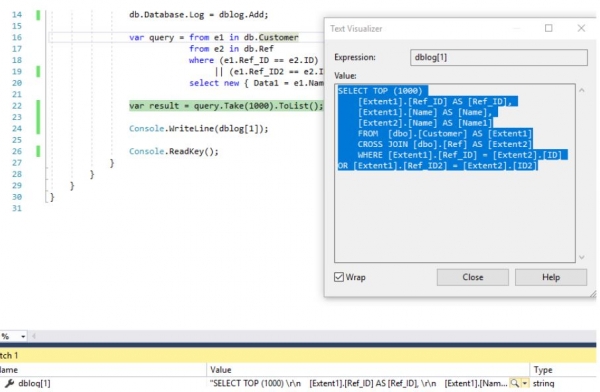
, akkor megbizonyosodhatunk arról, hogy a választás a két halmaz (táblázat) deszkart-halmazza alapján történik:
A generált SQL lekérdezés
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Írjuk át a LINQ lekérdezést a következőképpen:
Optimalizált LINQ lekérdezés
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Ekkor a következő SQL lekérdezést kapjuk:
SQL lekérdezés
VÁLASSZ
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    A BÓL ( VÁLASSZ KÜLÖNLEGESEN TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        A BÓL  (VÁLASSZ
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            A BÓL  [dbo].[Customer] AS [Extent1]
            BELÜL CSATLAKOZÁS [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNIÓ ÖSSZESEN
            VÁLASSZ
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            A BÓL  [dbo].[Customer] AS [Extent3]
            BELÜL CSATLAKOZÁS [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Sajnos a LINQ-lekérdezésekben csak egy kapcsolati feltétel lehet, ezért itt lehetséges egy ekvivalens lekérdezés végrehajtása két lekérdezésen keresztül, amely minden feltételtől függően egyesíti őket Union segítségével a sorok közötti duplikációk eltávolítása érdekében.
Igen, a lekérdezések általában nem lesznek ekvivalensek, figyelembe véve azt a tényt, hogy teljesen duplikált sorok is visszaadhatók. Azonban a valós életben a teljesen duplikált sorokra általában nincs szükség, és ezektől szokás megszabadulni.
Most hasonlítsuk össze a két lekérdezés végrehajtási terveit:
- CROSS JOIN esetén az átlagos végrehajtási idő 195 másodperc:

- INNER JOIN-UNION esetén az átlagos végrehajtási idő kevesebb mint 24 másodperc:

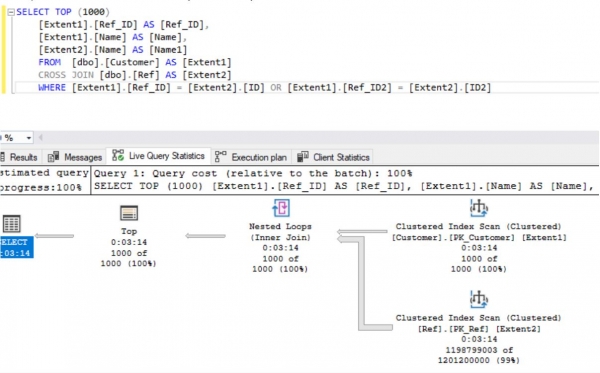
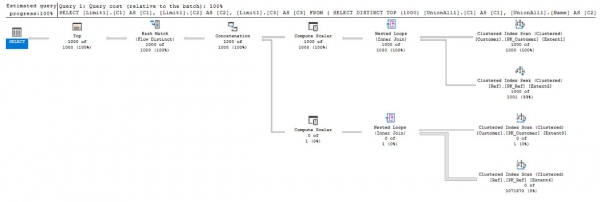
Az eredményekből látható, hogy két táblázat esetén, amelyek millió rekordot tartalmaznak, az optimalizált LINQ-lekérdezés sokkal gyorsabban működik, mint a nem optimalizált.
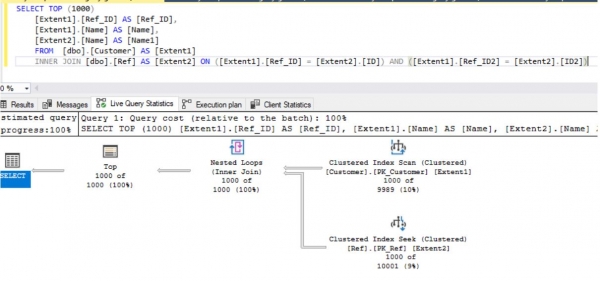
Az és feltételek esetén a LINQ-lekérdezés formája:
LINQ lekérdezés
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
szinte mindig helyes SQL-lekérdezés generálódik, amely átlagosan körülbelül 1 másodperc alatt fut le:
A LINQ to Objects manipulálásakor a lekérdezés típusa helyett lehet használni:
LINQ-lekérdezés (1. változat)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
lehet használni a következő formát:
LINQ-lekérdezés (2. változat)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
ahol:
Két tömb meghatározása
Para[] seq1 = új[] { új Para { Key1 = 1, Key2 = 2, Data = "777" }, új Para { Key1 = 2, Key2 = 3, Data = "888" }, új Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = új[] { új Para { Key1 = 1, Key2 = 2, Data = "777" }, új Para { Key1 = 2, Key2 = 3, Data = "888" }, új Para { Key1 = 3, Key2 = 5, Data = "999" } };
, és a Para típus a következőképpen van meghatározva:
A Para típus definiálása
class Para
{
        public int Key1, Key2;
        public string Data;
}
Így megvizsgáltuk a LINQ-queryk optimalizálásának néhány aspektusát a MS SQL Serverrel kapcsolatban.
Sajnos még a tapasztalt és vezető .NET-fejlesztők is hajlamosak megfeledkezni arról, hogy meg kell érteniük, mit csinálnak a háttérben azok az utasítások, amelyeket használnak. Ellenkező esetben konfigurálókká válnak, és óvó bombát állíthatnak be a jövőbeli problémákhoz, akár a programmegoldás skálázásakor, akár a környezet kis változásai esetén.
Egy kis áttekintés is készült és .
A projekt teszteléséhez szükséges forráskód, az adatbázis TEST tábláinak létrehozása, valamint ezeknek a tábláknak az adatokkal való feltöltése található .
Továbbá, ebben a tárolóban a Plans mappában találhatóak a lekérdezések végrehajtási tervei az OR feltételek alapján.
Forrás: habr.com
