

Ez a cikk a Mediumon írt cikkem fordítása — , amely meglehetősen népszerűvé vált, valószínűleg az egyszerűsége miatt. Ezért döntöttem úgy, hogy megírom oroszul, és egy kicsit kibővítem, hogy egy egyszerű ember, aki nem adatelemző, megértse, mi az adatgyűjtő tároló (DW) és mi az adat-tó (Data Lake), és hogyan léteznek együtt.
Miért szerettem volna írni az adat-tóról? Több mint 10 éve dolgozom az adatokkal és az analitikával, és most pontosan az Amazon Alexa AI-nál dolgozom Cambridge-ben, Bostonban, bár én Victoria szigetén élek, de gyakran járok Bostonban, Seattle-ben és Vancouverben, néha pedig Moszkvában is konferenciákon szerepelek. Időnként írok, de főleg angolul, és már írtam , és van egy igényem arra is, hogy megosszam az észak-amerikai analitika trendjeit, és néha írok a .
Mindig is dolgoztam adatgyűjtő tárolókkal, és 2015 óta szorosan együttműködöm az Amazon Web Services-szel, és valójában áttértem a felhőalapú analitikára (AWS, Azure, GCP). 2007 óta figyelemmel kísértem az analitikai megoldások fejlődését, és magam is dolgoztam egy adatgyűjtő tároló szállítónál, a Teradata-nál, és bevezettük a Sberbanknál, akkor jelent meg a Big Data a Hadoopdal. Mindenki azt mondta, hogy elmúlt az adatgyűjtő tárolók kora, és most már minden a Hadoopon alapul, majd pedig a Data Lake-ről kezdtek beszélni, ismét azt állítva, hogy az adatgyűjtő tárolónak most már valóban vége. De szerencsére (talán egyeseknek szerencsétlenség, akik sok pénzt kerestek a Hadoop beállításával) az adatgyűjtő tároló nem tűnt el.
A cikkben arra fogunk összpontosítani, mi az adat-tó. Az írás olyan embereknek készült, akiknek kevés tapasztalatuk van az adatgyűjtő tárolókkal, vagy egyáltalán nincs.
A képen a Bledi tó látható, ez az egyik kedvenc tó a számomra, bár csak egyszer voltam ott, de egy életen át emlékezni fogok rá. De mi egy másik típusú tóval fogunk foglalkozni — az adat-tóval. Talán sokan már hallottak erről a kifejezésről, de egy újabb meghatározás senkinek sem árt.
Először is, itt vannak a legnépszerűbb meghatározások az Adat-tóról:
"minden típusú nyers adat fájltárolója, amely bárki számára hozzáférhető a szervezeten belül" — Martin Fowler.
„Ha azt gondolja, hogy az adatok bemutatója olyan, mint egy üveg víz — tisztított, csomagolt és kényelmes fogyasztásra kész, akkor az adat-tó egy hatalmas víztárolónk, amely a természetes formájában van. A felhasználók bármikor meríthetnek belőle, lemerülhetnek a mélységbe és felfedezhetik” — James Dixon.
Most már pontosan tudjuk, hogy az adat-tó az analitikáról szól, lehetővé teszi számunkra, hogy nagy mennyiségű adatot tároljunk eredeti formában, és rendelkezésünkre áll a szükséges és kényelmes hozzáférés az adatokhoz.
Gyakran szeretem leegyszerűsíteni a dolgokat, ha képes vagyok egy bonyolult kifejezést egyszerű szavakkal elmagyarázni, az azt jelenti, hogy már megértettem, hogyan működik és mire van szükség. Egy alkalommal az iPhone-omat böngészve a fotógalériában, eszembe jutott, hogy ez az igazi adat-tó, még egy diát is készítettem a konferenciákhoz:
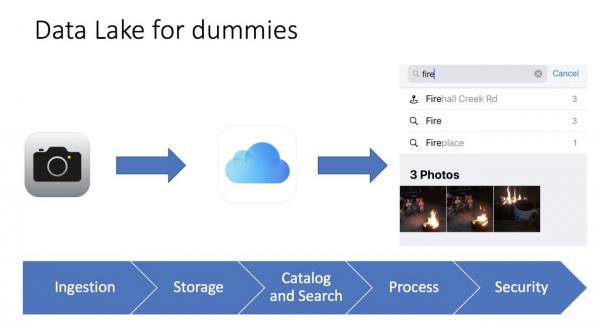
Minden nagyon egyszerű. Készítünk egy fényképet telefonunkkal, a fénykép a telefonra mentődik, és elmenthető az iCloudba (felhőalapú fájltároló). A telefon emellett összegyűjti a fénykép metaadatait: mi látható rajta, geolocation, időpont. Ennek eredményeként a kényelmes iPhone felületen keresztül megtalálhatjuk a fényképünket, és még az adatokat is láthatjuk, például, amikor a „tűz” (fire) szóra keresek, 3 fényképet találok a tűzrakásról. Számomra ez olyasmi, mint egy üzleti intelligencia eszköz, amely nagyon gyorsan és pontosan működik.
Természetesen nem feledkezhetünk meg a biztonságról (hitelesítés és azonosítás), különben az adatok könnyen nyilvánosságra kerülhetnek. Nagyon sok hír kering arról, hogy nagyvállalatok és startupok adatainak nyilvánosságra kerülése a fejlesztők gondatlansága és az egyszerű szabályok figyelmen kívül hagyása miatt történt.
Még egy ilyen egyszerű kép is segít nekünk elképzelni, hogy mi is az adat-tó, milyen eltérések vannak a hagyományos adattárolókkal szemben és mik az alapvető elemei:
- Adatok betöltése (Ingestion) — az adat-tó kulcsfontosságú komponense. Az adatok két módszerrel érkezhetnek az adattárolóba — batch (időközönkénti betöltés) és streaming (folyamatos adatáramlás).
- Fájlrendszer (Storage) — az Adat-tó fő komponense. Fontos, hogy a tárolónak könnyen skálázhatónak, rendkívül megbízhatónak és alacsony költségűnek kell lennie. Például az AWS-ben ez az S3.
- Katalógus és Keresés (Katalóg és Keresés) — annak érdekében, hogy elkerüljük az Adatlábujját (amikor minden adatot egy halomba dobunk, és utána lehetetlen velük dolgozni), szükségünk van egy metaadat réteg létrehozására az adatok osztályozásához, hogy a felhasználók könnyen megtalálják a szükséges adatokat az elemzéshez. Továbbá további keresési megoldások, például ElasticSearch használata is lehetséges. A keresés segít a felhasználónak a szükséges adatok kényelmes felületen való keresésében.
- Feldolgozás (Folyamat) — ez a lépés felelős az adatok feldolgozásáért és átalakításáért. Az adatokat át tudjuk alakítani, struktúráikat meg tudjuk változtatni, tisztíthatjuk és sok mást is csinálhatunk.
- Biztonság (Biztonság) — fontos időt szánni a megoldás biztonsági tervezésére. Például az adatok titkosítása tárolás, feldolgozás és betöltés során. Fontos, hogy autentikációs és autorizációs módszereket használjunk. Végezetül szükség van egy auditáló eszközre.
Gyakorlati szempontból a data lake-et három attribútummal jellemezhetjük:
- Gyűjtsd és tárold, amit csak akarsz — a data lake minden adatot tartalmaz, akár nyers, feldolgozatlan adatokat bármely időszakból, akár feldolgozott/tisztított adatokat.
- Mélyelemzés — a data lake lehetőséget ad a felhasználóknak az adatok felfedezésére és elemzésére.
- Rugalmas hozzáférés — a data lake rugalmas hozzáférést biztosít különböző adatokhoz és különböző forgatókönyvekhez.
Most beszélhetünk az adatbázis és a data lake közti különbségről. Az emberek általában azt kérdezik:
- De mi a helyzet az adatbázissal?
- Kicseréljük az adatbázist egy data lake-re, vagy kiegészítjük azt?
- Lehetséges egyáltalán a data lake nélkül?
Röviden mondva, egyértelmű válasz nincs. Minden a konkrét helyzettől, a csapat készségeitől és a költségvetéstől függ. Például az adatbázis migrálása Oracle-ról AWS-re és a Woot — Amazon leányvállalata — data lake létrehozása — .
Másrészről a Snowflake szállító azt állítja, hogy már nem kell a data lake-ről gondolkodnia, mivel az adatplatformjuk (2020 előtt ez adatbázis volt) lehetővé teszi, hogy ötvözzék a data lake-et és az adatbázist. Kicsit dolgoztam a Snowflake-kel, és valóban egyedi termék, amely ezt meg tudja csinálni. Az ára egy másik kérdés.
Összegzésképpen, személyes véleményem szerint még mindig szükségünk van egy adattárra, mint fő adatforrásra a jelentéseinkhez, és mindent, ami nem fér el, az adat-üzemanyag-tóban tárolunk. Az elemzés szerepe az, hogy könnyen hozzáférhetővé tegye az üzleti döntésekhez szükséges információkat. Akárhogy is, az üzleti felhasználók hatékonyabban dolgoznak az adattárral, mint az adat-tóval, például az Amazonnál — van Redshift (analitikus adattároló), és van Redshift Spectrum/Athena (SQL interfész az S3 adat-tóhoz, a Hive/Presto alapjain). Ugyanez vonatkozik más modern analitikus adattárolókra is.
Nézzük meg egy tipikus adattár architektúráját:
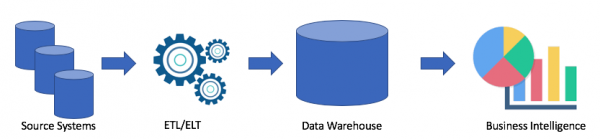
Ez a klasszikus megoldás. Van egy forrásszerverünk, az ETL/ELT segítségével az adatokat átmásoljuk az analitikus adattárba, és csatlakoztatjuk egy Business Intelligence megoldáshoz (az én kedvencem a Tableau, a tiéd?).
Ennek a megoldásnak a következő hátrányai vannak:
- Az ETL/ELT műveletek időt és erőforrásokat igényelnek.
- Általában az analitikus adattárolóban az adatok tárolására használt memória nem olcsó (például Redshift, BigQuery, Teradata), mivel egy teljes klaszter vásárlására van szükség.
- Az üzleti felhasználók hozzáférnek a tisztított és gyakran aggregált adatokhoz, ugyanakkor nincs lehetőségük a nyers adatok elérésére.
Természetesen minden az önök esetétől függ. Ha nincs probléma az adattárukkal, akkor valóban nincs szüksége adat-tóra. De amikor problémák merülnek fel a helyhiány, a teljesítmény vagy a költségek kapcsán, akkor megfontolható az adat-tó lehetősége. Éppen ezért az adat-tó nagyon népszerű. Íme egy példa az adat-tó architektúrájára:
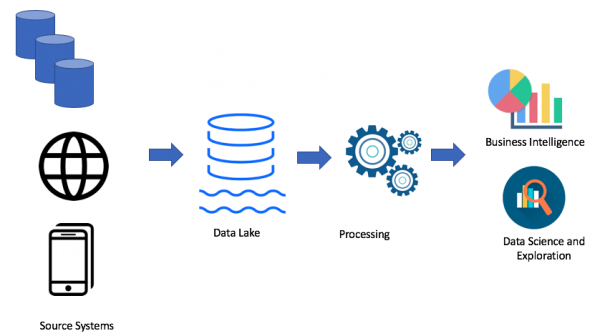
Az adat-tó megközelítése szerint nyers adatokat töltünk be az adat-tóba (batch vagy streaming), majd szükség szerint dolgozzuk fel az adatokat. Az adat-tó lehetővé teszi az üzleti felhasználók számára, hogy saját adat-transzformációkat (ETL/ELT) végezzenek, vagy elemezzék az adatokat a Business Intelligence megoldásokban (ha van megfelelő illesztőprogram).
Bármely analitikus megoldás célja, hogy szolgálja az üzleti felhasználókat. Ezért mindig a vállalati igényekből kell kiindulnunk. (Az Amazonnál ez az egyik alapelv — visszafelé dolgozni.)
Az adattárral és az adat-tóval való munka során összevethetjük a két megoldást:
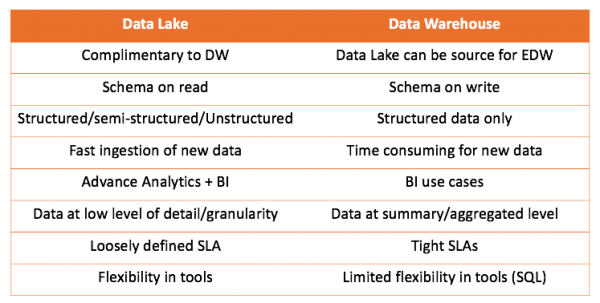
A fő következtetés, amelyet levonhatunk, az, hogy az adattár nem versenyez az adatbázissal, hanem inkább kiegészíti azt. De ez Önre van rábízva, hogy mi a megfelelő az Ön esetében. Mindig érdekes kipróbálni saját magát és helyes következtetéseket levonni.
Szeretnék mesélni egy esetről, amikor az adatbázis megközelítést kezdtem el használni. Minden elég banális, megpróbáltam használni egy ELT eszközt (volt Matillion ETL) és az Amazon Redshiftet; a megoldásom működött, de nem felelt meg a követelményeknek.
Szükségem volt arra, hogy webes naplókat vegyek, átalakítsam őket és aggregáljam, hogy adatokat biztosítsak két esethez:
- A marketing csapat azt akarta elemezni, hogy a botok hogyan viselkednek az SEO érdekében.
- Az IT a weboldalak teljesítményének metrikáit szerette volna megvizsgálni.
Nagyon egyszerű, nagyon egyszerű naplók. Íme egy példa:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Egy fájl 1-4 megabájt volt.
De volt egy nehézség. Hét doménünk volt világszerte, és naponta 7000 fájl keletkezett. Ez nem túl nagy mennyiség, összesen 50 gigabájt. De a Redshift klaszterünk is kicsi volt (4 node). Egy fájl hagyományos módszerrel történő betöltése körülbelül egy percet vett igénybe. Tehát, a helyzetet nem lehetett közvetlenül megoldani. Ez volt az a helyzet, amikor úgy döntöttem, hogy az adatbázis megközelítést használom. A megoldás körülbelül így nézett ki:
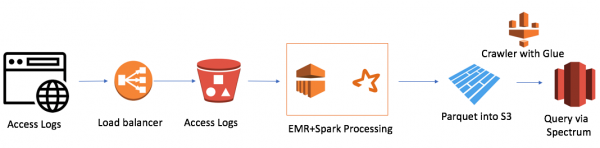
Ez elég egyszerű (feltűnő a felhőalapú munka előnye, hogy egyszerű). Használatba vettem:
- AWS Elastic Map Reduce (Hadoop) mint számítási kapacitás
- AWS S3 mint fájl tároló titkosítási lehetőséggel és hozzáférés-nyilvánossággal
- Spark mint InMemory számítási kapacitás és PySpark az adatok logikai és átalakító feldolgozásához
- Parquet mint a Spark munka eredménye
- AWS Glue Crawler mint új adatok és partíciók metadata gyűjtője
- Redshift Spectrum mint SQL felület az adatbázisra a meglévő Redshift felhasználók számára
A legkisebb EMR+Spark klaszter 30 perc alatt dolgozta fel az összes fájlcsomagot. Vannak más esettanulmányok is az AWS-en, különösen sok az Alexa körüli, ahol rengeteg adat található.
Nemrégiben felfedeztem a data lake egyik hátrányát — ez a GDPR. A probléma az, hogy amikor egy ügyfél azt kéri, hogy törölni kellene, és az adatok egy fájlban találhatók, nem tudjuk használni a Data Manipulation Language-t és a DELETE műveletet, mint az adatbázisban.
Remélem, hogy a cikk világossá tette a különbséget az adatbázis és a data lake között. Ha érdekesnek találtad, szívesen lefordítom más cikkeimet vagy szakértők írásait, akiket olvasok. Ezen kívül mesélhetek a megoldásokról, amelyekkel dolgozom, és azok architektúrájáról.
Forrás: habr.com
