

A Kubernetes klaszterének frissítési folyamata
A Kubernetes klaszter használata során idővel szükség lehet az aktív csomópontok frissítésére. Ez magába foglalhatja a csomagok frissítését, a kernel frissítését vagy új virtuális gépek telepítését. A Kubernetes terminológiában ezt " .
Ez a bejegyzés egy 4 részes sorozat része:
- Ez a bejegyzés.
- A podok helyes leállítása a Kubernetes klaszterben
- Késleltetett pod leállítás törléskor
- Hogyan kerülhetjük el a leállást a Kubernetes klaszter működése közben a PodDisruptionBudgets segítségével
(megj. ford. a sorozat többi cikkének fordítása a közeljövőben várható)
Ebben a cikkben bemutatjuk az összes eszközt, amelyet a Kubernetes biztosít az állásidő nullára csökkentéséhez a klaszterben futó csomópontok számára.
A probléma meghatározása
Kezdetben naiv megközelítést fogunk alkalmazni, amely során azonosítjuk a problémákat és felmérjük e megközelítés potenciális kockázatait, valamint tudást halmozunk fel, hogy megoldjuk azokat a problémákat, amelyekkel az egész ciklus során szembesülünk. Ennek eredményeként olyan konfigurációt kapunk, amely lifecycle hook-okat, readiness probes-t és Pod disruption budgets-t használ az állásidő nullára csökkentésére.
A folyamat megkezdéséhez vegyünk egy konkrét példát. Feltételezzük, hogy van egy két csomópontból álló Kubernetes klaszterünk, amelyben egy alkalmazás fut, két pod-dal, amelyek a következőket képezik: Service:
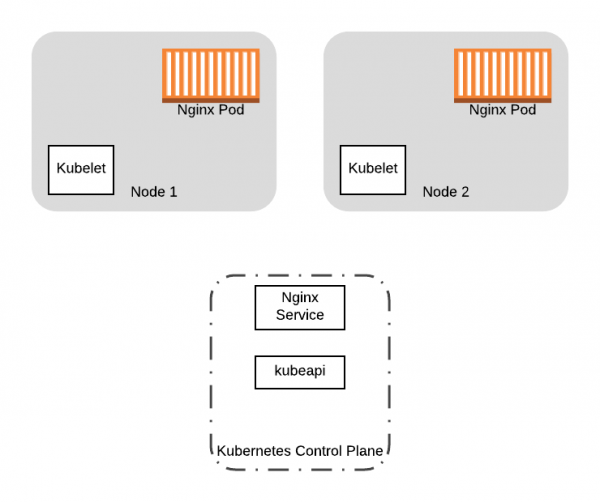
Kezdjük két pod-dal, amelyek Nginx-szel és egy szolgáltatással futnak a Kubernetes klaszterünk két csomópontján.
Frissíteni szeretnénk a két aktív csomópont kernel verzióját a klaszterünkben. Hogyan fogunk ezt megtenni? Egyszerű megoldás lenne, ha új csomópontokat indítanánk a frissített konfigurációval, majd leállítanánk a régi csomópontokat, miközben elindítjuk az újakat. Bár ez működhet, e megközelítésnek több problémája lesz:
- Amikor leállítja a régi csomópontokat, a rajtuk futó podok is leállnak. Mi van, ha a podokat tisztítani kell a megfelelő leállításhoz? Az általuk használt virtualizációs rendszer lehet, hogy nem várja meg a tisztítási folyamat befejezését.
- Mi történik, ha egyszerre állítja le az összes csomópontot? Jelentős állásidőt tapasztal, amíg a podok átköltöznek az új csomópontokra.
Szükségünk van egy helyes módra a podok migrálására a régi nódokról, és biztosra kell mennünk, hogy egyetlen munkafolyamatunk se indul el, miközben módosításokat végzünk a nódon. Vagy amikor teljesen kicseréljük a klasztert, mint a példában (azaz a virtuális gépek képeit cseréljük), szeretnénk áthelyezni a működő alkalmazásokat a régi nódokról az újakra. Mindkét esetben meg szeretnénk akadályozni az új podok ütemezését a régi nódokra, majd eltávolítani az összes futó podot róluk. E célok elérésére használhatjuk a parancsot kubectl drain.
minden pod áthelyezése a nódjáról
A drain művelet lehetővé teszi, hogy minden podot áthelyezzünk a nódjáról. A drain végrehajtása során a nódot unschedulable-ként jelölik meg (flag NoSchedule). Ez megakadályozza, hogy új podok jelenjenek meg rajta. A drain ezután elkezdi eltávolítani a podokat a nódjáról, befejezi a nódon jelenleg futó konténerek működését azzal, hogy jelet küld TERM a podban lévő konténereknek.
Bár kubectl drain jól kezeli a podok eltávolítását, van még két tényező, amely problémát okozhat a drain művelet végrehajtása során:
- Az alkalmazásának képesnek kell lennie a helyes leállásra a jel érkezésekor.
TERMAmikor a podokat eltávolítják, a Kubernetes jelet küld a konténereknek, és vár egy megadott ideig a leállításukra; ezt követően, ha nem álltak le, erőszakkal befejezi őket. Mindenesetre, ha a konténer nem reagál helyesen a jelre, még mindig kikapcsolhatja a podokat hibásan, ha azok adott pillanatban működnek (például, ha egy tranzakció zajlik az adatbázisban).TERMMinden podot elveszít, amely tartalmazza az alkalmazást. Az alkalmazás nem lehet elérhető, amikor új konténerek indulnak az új nódokon, vagy ha a podjai vezérlők nélkül lettek telepítve, akkor egyáltalán nem indulnak újra. - Leállás elkerülése
A kötelező megszakítások, mint például a nód drain művelete, miatti leállás minimalizálása érdekében a Kubernetes a következő hibakezelési lehetőségeket kínálja:
Graceful termination
A ciklus többi részében a Kubernetes funkcióinak adatait fogjuk felhasználni a podok áthelyezésének következményeinek mérséklésére. Az alapvető gondolat nyomon követésének megkönnyítése érdekében a fenti példánkat fogjuk használni a következő erőforrás-beállítással:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Ez a konfiguráció egy minimális példa. Deployment, amely az nginx podokat kezeli a klaszterben. Ezen kívül a konfiguráció leírja a forrást, Service, amelyet az nginx podok elérésére használhat a klaszterben.
A teljes folyamat során fokozatosan bővíteni fogjuk ezt a konfigurációt, hogy végül tartalmazza a Kubernetes által kínált összes lehetőséget a leállás minimalizálására.
A Kubernetes klaszter frissítéseinek teljes körű végrehajtott és tesztelt verziójáért, amely nulla leállási idővel rendelkezik AWS és más erőforrásokon, látogasson el a .
Olvasd el többi cikkünket a blogunkban:
Forrás: habr.com
