

A tárolófejlesztés hosszú és komoly feladat.
A projekt életében sok minden múlik azon, hogy az objektummodell és az adatbázis szerkezete mennyire van jól megtervezve a kezdetekkor.
A közkeletű megközelítések közé tartozik, hogy a "csillag" séma és a harmadik normálforma (3NF) különböző kombinációit alkalmazzák. Általában az elv szerint: az alapadatok – 3NF, a vitrinák – csillag. Ez a megközelítés, amelyet az idő próbája is megállt és számos kutatás alátámaszt, az első (és néha az egyetlen) dolog, ami egy tapasztalt DWH szakember eszébe jut, amikor arról gondolkodik, hogy hogyan kell kinéznie egy analitikai tárolónak.
Másrészről a vállalkozások és az ügyfél igényei általában gyorsan változnak, míg az adatok "mélységben" és "szélességben" is növekednek. Itt jelentkezik a csillag fő hátránya – a korlátozott flexibilitás.
És ha a DWH-fejlesztő csendes és kényelmes életébe hirtelen:
- felmerült a kérdés: "Csak csináljunk valamit gyorsan, aztán majd meglátjuk";
- megjelent egy dinamikusan fejlődő projekt, új források bekapcsolásával és heti legalább egy alkalommal történő üzleti modell átalakítással;
- megjelenik egy ügyfél, aki nem tudja, hogyan kell kinéznie a rendszernek és milyen funkciókat kell ellátnia a végén, de nyitott a kísérletezésre és a fokozatos pontosításra a kívánt eredmény elérésével;
- benézett egy projektmenedzser boldog hírekkel: "Mostantól agilis módszertanunk van!"
Vagy ha csak kíváncsi vagy, hogy még hogyan lehet tárolókat építeni – üdvözlünk a cikk alatt!
Mit jelent a „rugalmasság”?
Először határozzuk meg, hogy milyen tulajdonságokkal kell rendelkeznie a rendszernek ahhoz, hogy „rugálmasnak” mondhassuk.
Fontos megjegyezni, hogy a leírt tulajdonságoknak kifejezetten a rendszerre, nem pedig a fejlesztési folyamatra vonatkoznak. Tehát, ha az Agile módszertanról szeretnél olvasni, akkor jobb, ha más cikkekkel ismerkedsz. Például a Habr-on sok érdekes anyag található (mint és , valamint ).
Ez nem azt jelenti, hogy a fejlesztési folyamat és a DWH struktúrája egyáltalán nincs összefüggésben. Általánosságban elmondható, hogy az Agile módszerek szerint tervezett rugalmas architektúrájú adattároló fejlesztése lényegesen könnyebb kellene, hogy legyen. A gyakorlatban azonban gyakrabban találkozunk olyan megoldásokkal, mint az Agile klasszikus DWH a Kimball alapján és a Data Vault – vízesés módszertan szerint, mint a boldog véletlenekkel, ahol a két megközelítés egy projekten belül egyesül.
Tehát, milyen lehetőségekkel kell rendelkeznie egy rugalmas adattárolónak? Három pontot emelhetünk ki:
- Korai szállítás és gyors fejlesztés — ez azt jelenti, hogy ideálisan az első üzleti eredményt (például az első működő jelentéseket) a lehető legkorábban el kellene érni, tehát még azelőtt, hogy a rendszert teljesen megtervezték és bevezették. Ráadásul minden következő fejlesztésnek is a lehető legkevesebb időt kellene igényelnie.
- Iteratív fejlesztés — ez azt jelenti, hogy minden következő fejlesztés ideálisan nem érintheti a már működő funkciókat. Ez a szempont gyakran válik a legnagyobb rémálommá nagy projektek esetén – előbb-utóbb az egyes objektumok annyi kapcsolódást kapnak, hogy egyszerűbb a logikát egy másik példányban újraépíteni, mint egy mezőt hozzáadni a meglévő táblához. És ha meglep, hogy a meglévő objektumokra gyakorolt hatás elemzése több időt vehet igénybe, mint maga a fejlesztés – valószínűleg még nem dolgoztál nagy DWH projektekkel a banki szektorban vagy a telekommunikációban.
- Folyamatos alkalmazkodás a változó üzleti igényekhez — a teljes objektumstruktúrát nemcsak a lehetséges bővítések figyelembevételével kell megtervezni, hanem úgy is, hogy a következő bővítés iránya olyan dolgokat tartalmazzon, amiről az építési szakaszban még álmodni sem mertél.
Igen, mindezeknek a követelményeknek a megfelelése egy rendszerben lehetséges (természetesen bizonyos esetekben és néhány megszorítással).
Alább két legnépszerűbb módszertanát fogom vizsgálni a DWH rugalmas tervezésének — Anchor model és Data Vault. A zárójeleken kívül maradnak olyan csodás megoldások, mint például az EAV, a 6NF (tiszta formájában) és minden, ami a NoSQL megoldásokhoz kapcsolódik — nem azért, mert ezek valamilyen szempontból rosszabbak, és nem is azért, mert egyébként a cikk veszélybe került volna, hogy elveszíti a közép-hosszúságú dolgozatok méretét. Egyszerűen csak arról van szó, hogy ezek a megoldások egy másik osztályúak — vagy olyan módszerekkel kapcsolatosak, amelyeket speciális esetekben alkalmazhat, függetlenül a projekt általános architektúrájától (mint az EAV), vagy globálisan eltérő adatbevitel-paradigmákra vonatkoznak (mint például a gráf alapú DB-k és más NoSQL lehetőségek).
A „klasszikus” megközelítés problémái és megoldásai a rugalmas metodológiákban
„Klasszikus” megközelítés alatt a régi jó sztárt értem (függetlenül az alsóbb rétegek konkrét megvalósításától, bocsássanak meg nekem Kimball, Inmon és a CDM követői).
1. Szoros kapcsolatok cardinalitása
Egy ilyen modell alapja a data szigorú felosztása dimenziókra (Dimension) és tényekre (Fact). És ez, a fenébe is, logikus — hiszen az adatelemzés túlnyomó többsége valójában a bizonyos numerikus mutatók (tények) elemzésére vonatkozik meghatározott dimenziókban.
Ezért az objektumok közötti kapcsolatokat a külső kulcs által összekapcsolt táblák formájában rögzítik. Ez így elég természetesnek tűnik, de azonnal az első rugalmassági korlátozáshoz vezet — a kapcsolatok cardinalitásának szigorú meghatározása.
Ez azt jelenti, hogy a táblák tervezési szakaszában pontosan meg kell határoznia, hogy minden egyes kapcsolódó objektumpár sok-hoz-sok kapcsolatban, vagy csak 1-hez-sok kapcsolatban van-e, és hogy „milyen irányban”. Ez közvetlenül befolyásolja, hogy melyik táblában lesz az elsődleges kulcs és melyikben a külső. Az ilyen kapcsolatok megváltoztatása új követelmények bevezetése esetén nagy valószínűséggel a teljes adatbázis újragondolásához vezet.
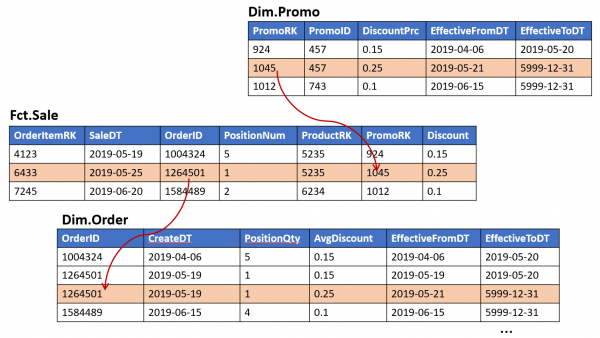
Például, amikor egy „pénztári bizonylat” objektumot tervezett, a sales részleg esküvői ígéreteire támaszkodva lehetőséget biztosított arra, hogy egy promóciós akció több bizonylati tételre vonatkozhasson (de nem fordítva):
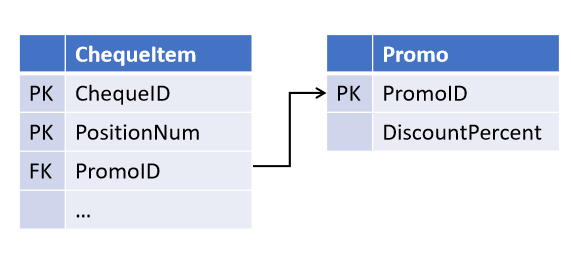
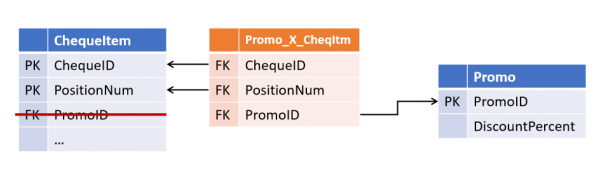
Nem sokkal később a kollégák bevezették az új marketing stratégiát, amelyben egyazon tételre több promóciós akció is érvényes lehet egyszerre.Most pedig ki kell dolgoznia a táblákat, kiemelve a kapcsolatot egy külön objektumban.
(Minden származtatott objektum, ahol a közvetlen ellenőrzés zajlik a promón, szintén szükségessé vált a pontosításra).
Kapcsolatok a Data Vault és Anchor Model
Ilyen helyzet elkerülése viszonylag egyszerűnek bizonyult: nem szabad hinni az értékesítési osztálynak, ehhez elegendő az összes kapcsolatot eredetileg külön táblákban tárolni és a sok-hoz-sok feldolgozása.
Ez a megközelítés Dan Linstedt által lett javasolva mint a paradigma része, Data Vault és teljesen támogatva van Lars Rönnbäck által be. Az Anchor Modelt.
Végül kapunk egy elsődleges jellemzőt a rugalmas metodológiákban:
A kapcsolatok az objektumok között nem a szülő entitások attribútumaiban, hanem különféle objektumként jelennek meg.
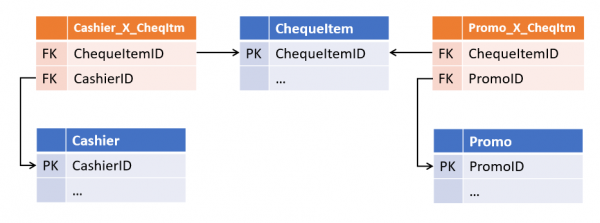
A Data Vault Ezeket a kapcsolótáblákat (lehetővé teszi a webfejlesztők számára, hogy optimalizálják az erőforrások betöltését az erőforrások relatív prioritásának megadásával)., míg a Anchor Modelnek — Köthetésnek. Első ránézésre nagyon hasonlítanak, bár a nevük közti eltérés nem merül ki (erről a továbbiekben beszélünk). Mindkét architektúrában a kapcsolótáblák bármilyen számú entitást összekapcsolhatnak, (nem feltétlenül 2). Ez a látszólagos redundancia jelentős rugalmasságot biztosít a későbbi módosítások során. Ez a struktúra toleránsá válik nemcsak a meglévő kapcsolatok kardinalitásának megváltozásával, hanem új kapcsolatok hozzáadásával is — ha a számlázási tételhez további hivatkozás kerül egy pénztárosra, az ilyen összekapcsolás egyszerűen egy meglévő táblákra épülő kiegészítés lesz anélkül, hogy bármely meglévő objektumra és folyamatra hatással lenne.
2. Adatduplikáció
A második probléma, amelyet a rugalmas architektúrák megoldanak, egyértelműbb és elsősorban
SCD2 típusú mérésekre jellemző, (lassan változó második típusú mérések), bár nem csak ezekre. A klasszikus adattárházban a mérés általában egy táblázat, amely tartalmaz egy szubjektív kulcsot (mint elsődleges kulcs) és egy üzleti kulcsokkal és attribútumokkal ellátott oszlopcsoportot.
Ha a mérés támogatja a verziókezelést, a standard mezőkészlethez időkereteket adunk a verzió érvényességének, és egy forrássoron több verzió jelenik meg az adattárban (mindegyik verzióváltoztatáshoz egy).
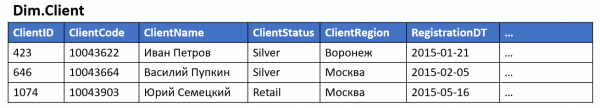
Если измерение поддерживает версионность, к стандартному набору полей добавляются границы времени действия версии, а на одну строку в источнике появляется несколько версий в хранилище (по одной на каждое изменение версионных атрибутов).
Ha a mérés tartalmaz legalább egy gyakran változó verzionált attribútumot, akkor az ilyen mérés verzióinak száma jelentős lesz (még akkor is, ha a többi attribútum nem verzionált, vagy soha nem változik), és ha ilyen attribútumokból több is van, a verziók száma geometrikus Progresszióban növekedhet ezek számához képest. Ez a mérés jelentős lemezterületet foglalhat el, bár a benne tárolt adatok nagy része csak az állandó attribútumok másolata más sorokból.
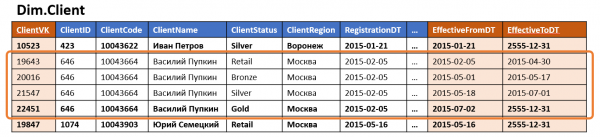
Ezen kívül gyakran alkalmazzák a denormalizálást — az attribútumok egy részét szándékosan értékként tárolják, nem pedig hivatkozásként egy adattárra vagy más mérésre. Ez a megközelítés felgyorsítja az adatokhoz való hozzáférést, csökkentve a lekérdezések számát a méréshez való hozzáféréskor.
Általában ez azt eredményezi, hogy ugyanaz az információ egy időben több helyen tárolódik. Például a lakóhelyre és az ügyfél kategóriába való tartozásra vonatkozó információk egyidejűleg tárolódhatnak a "Ügyfél" mérésekben, valamint a "Vásárlás", "Szállítás" és "Telefonos ügyfélszolgálati megkeresések" tényekben, illetve az "Ügyfél - Ügyfél menedzser" kapcsolótáblában.
Összességében a fenti leírás az általános (nem verzionált) mérésekre is vonatkozik, de a verzionáltak esetében más méretűek lehetnek: egy új verzió megjelenése (különösen visszamenőleges hatállyal) nem csupán a kapcsolódó táblák frissítéséhez vezet, hanem új verziók láncolatos megjelenéséhez is a kapcsolódó objektumokban — amikor az 1. táblát a 2. tábla elkészítéséhez használják, a 2. táblát pedig a 3. tábla összeállításához stb. Még ha az 1. tábla egyetlen attribútuma sem vesz részt a 3. tábla elkészítésében (hanem más attribútumok a 2. táblából, amelyek más forrásokból származnak), a keresztverziós frissítés ennek a konstrukciónak legalább további költségeket eredményez, legfeljebb pedig felesleges verziókhoz vezethet a 3. táblában, ami ebben az esetben "nem is tartozik ide", és így tovább a láncban.
3. A fejlesztés nemlineáris összetettsége
E mellett minden új ablak, amely egy másikon alapul, növeli annak a helyek számát, ahol az adatok "eltérhetnek" az ETL-folyamat módosításakor. Ez pedig a következő fejlesztések összetettségének (és időtartamának) növekedéséhez vezet.
Ha a fenti leírás a ritkán frissített ETL folyamatokkal rendelkező rendszerekre vonatkozik, akkor ebben a paradigma még működhet — elegendő figyelni arra, hogy az új frissítések helyesen legyenek beillesztve az összes kapcsolódó objektumba. Ha azonban a frissítések gyakran történnek, akkor jelentősen megnövekszik annak valószínűsége, hogy véletlenül "kihagyunk" néhány kapcsolatot.
Ha figyelembe vesszük, hogy a "verziós" ETL sokkal bonyolultabb, mint a "nem verziós", elkerülni a hibákat a gyakori frissítések esetén meglehetősen nehézzé válik.
Objektumok és attribútumok tárolása Data Vault és Anchor Model segítségével
A rugalmas architektúrák szerzői által javasolt megközelítést így lehet megfogalmazni:
El kell választani azt, ami változik, attól, ami változatlan. Vagyis a kulcsokat külön kell tárolni az attribútumoktól.
Ez nem összetévesztendő nem verziós attributummal, amely változatlan: az első nem tárolja a változásainak történetét, de változhat (például a bevitt hibák javításakor vagy új adatok beszerzésekor), míg a második sosem változik.
Azzal kapcsolatban, hogy mi számít változatlannak a Data Vault és az Anchor modellekben, eltérő nézetek léteznek.
Az architektúra szempontjából Data Vault, a változatlannak tekinthető az összes kulcs — természetes (cégek adószáma, a termék kódja a forrásszervezetben, stb.) és szubjektív. Ezzel párhuzamosan a többi attribútumot forrásonként és/vagy változási gyakoriság szerint csoportosítani lehet, és minden csoportnak külön táblát kell vezetni független verziókészlettel.
Az Anchor Model paradigma alapján az változatlan csak a szubjektív kulcs entitások. Minden más (természetes kulcsok is) csupán a saját attribútumainak külön esete. Ezenkívül az összes attribútum alapértelmezés szerint független egymástól , ezért minden attribútumhozkülön táblázatot kell létrehozni a kulcsok entitásait tartalmazó táblák neve.
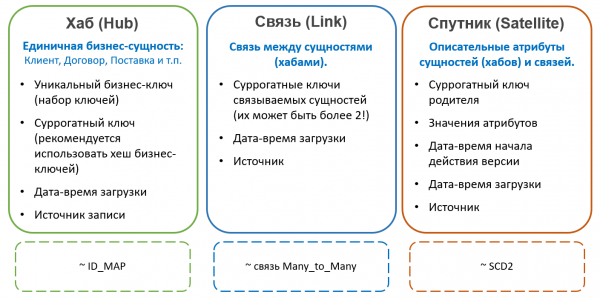
A Data Vault Hubok (Hub) . A Hubok mindig rögzített mezőkészletet tartalmaznak:Természetes kulcsok entitáshoz
- Szubjektív kulcs
- Hivatkozás a forrásra
- Bejegyzés időpontja
- A Hubokban lévő bejegyzések
soha nem változnak és nincsenek verzióik. никогда не изменяются и не имеют версий. A külső hubok nagyon hasonlítanak az ID-map típusú táblákra, amelyeket bizonyos rendszerek használnak szórakoztatók generálására, azonban a Data Vault-ban javasolt, hogy nem egész számú szekvenciát, hanem a vállalati kulcsok készletének hash-ét alkalmazzák szórakoztatóként. Ez a megközelítés egyszerűsíti a kapcsolatok és attribútumok betöltését a forrásokból (nem szükséges csatlakozni a hubhoz a szórakoztató megszerzéséhez, elegendő egyszerűen kiszámolni a hash-t a természetes kulcsból), de más problémákat is okozhat (például ütközésekkel, a nagybetűs írással és a nem nyomtatható karakterekkel a karakterkulcsokban stb.), ezért nem általánosan elfogadott.
Minden más entitás attribútumai speciális táblákban tárolódnak, amelyeket satelitoknak (Satellit). Egy hubnak több satelitja is lehet, amelyek különböző attribútumcsoportokat tárolnak.
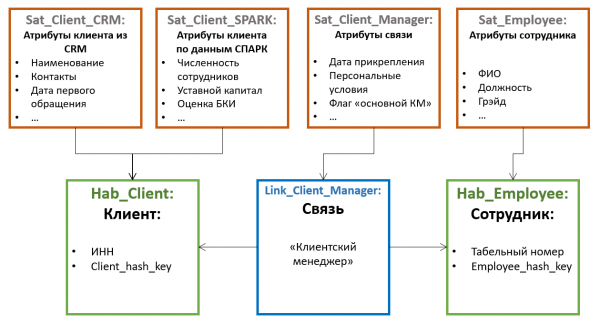
Az attribútumok elosztása a satelitok között a közös változtatás - elvén történik - egy satelitban tárolhatók nem verzionált attribútumok (például születési dátum és TAJ szám magánszemélyek számára), egy másikban - ritkán változó verzionáltak (például vezetéknév és személyi igazolvány szám), a harmadikban - gyakran változó attribútumok (például szállítási cím, kategória, utolsó rendelés dátuma stb.). A verzionálás az egyes satelitok szintjén történik, nem az entitás szintjén, ezért érdemes az attribútumok elosztását úgy végezni, hogy a verziók átfedése egy satelitban minimális legyen (ami csökkenti a tárolt verziók összes számát).
Emellett az adatok betöltési folyamatának optimalizálása érdekében gyakran egyes satelitokba kerülnek át az olyan attribútumok, amelyeket különböző forrásokból nyernek.
A satelitokat a hubbal a külső kulcs (ami megfelel az 1-hez-sok kapcsolódásnak). Ez azt jelenti, hogy a többszörös attribútumértékek (például több telefonszám egy ügyfélhez) az ilyen architektúra “alapértelmezés szerint” támogatva vannak.
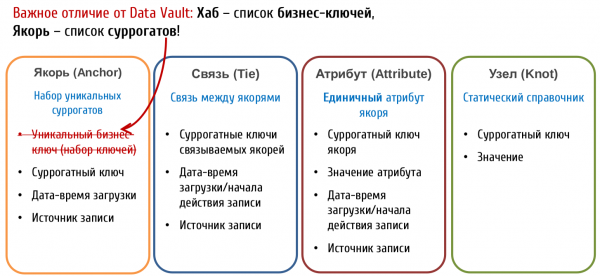
A Az anchor model (Anchor Model) táblák, amelyek a kulcsokat tárolják, úgynevezett anchoroknak (Anchor). Ezek tárolják:
- Csak szórakoztató kulcsok
- Bejegyzés időpontja
- A Hubokban lévő bejegyzések
A természetes kulcsok az Anchor Model szempontjából rendes attribútumoknakszámítanak. Ez a lehetőség talán bonyolultabbnak tűnik a megértés szempontjából, de sokkal nagyobb lehetőséget ad az objektum azonosítására.
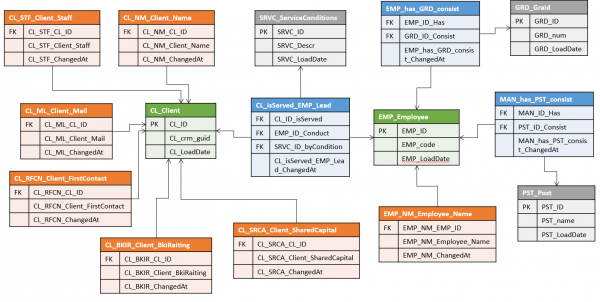
Például, ha ugyanarról a entitásról származó adatok különböző rendszerekből érkeznek, mindegyik saját természetes kulccsal rendelkezik. A Data Vault rendszerében ez elég sokrétű konstrukciókhoz vezethet, ahol több hub szükséges (egy forrásonként + egy összekapcsoló mesterverzió), míg a Horgony modellel az egyes források természetes kulcsai saját attribútumukba kerülnek és függetlenül használhatók a többitől a betöltés során.
De itt van egy ravasz pillanat: ha egy entitásban különböző rendszerekből származó attribútumok egyesülnek, valószínűleg léteznek bizonyos „összevonási”szabályok, amelyek alapján a rendszernek meg kell értenie, hogy a különböző forrásokból származó rekordok egy entitás példányához tartoznak.
A Data Vault Ezek a szabályok valószínűleg meghatározzák az „szurrogát hub” mester-enti tást, és egyáltalán nem befolyásolják a hhubokat, amelyek tárolják a források természetes kulcsait és azok eredeti attribútumait. Ha valamikor az összevonási szabályok változnak (vagy érkezik egy frissítés azokhoz az attribútumokhoz, amelyek alapján ez történik), elegendő lesz a szurrogát hubokat újraformálni.
A A Horgony modellel azonban egy ilyen entitás valószínűleg egyetlen horgon fog tárolódni.Ez azt jelenti, hogy minden attribútum, függetlenül attól, hogy mely forrásból származik, ugyanahhoz a szurrogáthoz lesz hozzárendelve. A tévesen összevont rekordok szétválasztása és az aktuális összevonás nyomon követése egy ilyen rendszerben lényegesen nehezebb lehet, különösen, ha a szabályok eléggé bonyolultak és gyakran változnak, és egy és ugyanazon attribútum különböző forrásokból származhat (bár ez pontosan lehetséges, mivel minden attribútum verziója hivatkozik a saját forrására).
Mindenesetre, ha a rendszerében tervezik a rekordok deduplikálásának, egyesítésének és más MDM elemeknek a funkcióját,különösen figyelmesen meg kell ismerkednie a természetes kulcsok tárolásának aspektusaival a rugalmas módszertanokban. Lehetséges, hogy a Data Vault bonyolultabb konstrukciója hirtelen biztonságosabbnak bizonyul az egyesítési hibák szempontjából.
A Horgony model szintén biztosít egy további objektum típust, amelyet Knotnak (Csomónak) hívnak, lényegében ez egy különleges degenerált típusa a horgonyának. вырожденный вид якоря, amely csak egyetlen attribútumot tartalmazhat. A csomópontokat sík adatbázisok tárolására szánják (például nem, családi állapot, ügyfélszolgálati kategória stb.). A horgonyoktól eltérően a csomópont nincs kapcsolódó attribútumtáblája, és az egyetlen attribútuma (a név) mindig ugyanabban a táblázatban van, mint a kulcs. A csomópontok a horgonyokkal kapcsolattartó táblák (Tie) révén kapcsolódnak, akárcsak a horgonyok egymással.
Nincs egyértelmű vélemény a csomópontok használatáról. Például , aki aktívan népszerűsíti a horgony modellek alkalmazását Oroszországban, úgy véli (nem alaptalanul), hogy egyetlen adatbázis esetén sem lehet pontosan állítani, hogy az kíméletlenek voltak statikus és egy szintű lesz, ezért minden objektum esetén a legjobb, ha azonnal teljes értékű horgonyt használunk.
Egy másik fontos különbség a Data Vault és a horgony modell között az, hogy a kapcsolatoknak vannak attribútumaik:
A Data Vault A kapcsolatok ugyanolyan teljes értékű objektumok, mint a központok, és rendelkezhetnek saját attribútumokkal. A A Horgony modellel A kapcsolatok kizárólag horgonyok összekapcsolására szolgálnak, és saját attribútumokkal nem rendelkezhetnek. Ez a különbség lényegesen eltérő megközelítéseket eredményez a modellezés során, a tényekkel, amelyről később szólunk.
Tények tárolása
Eddig főleg a dimenziók modellezéséről beszéltünk. A tények esetében a helyzet kissé kevesebb egyértelműséggel bír.
A Data Vault A tények tárolására tipikusan jellemző objektum a Kapcsolat (Link), amelynek egyes műholdai tartalmazzák a tényező mutatókat.
Ez a megközelítés intuitívnak tűnik. Könnyű hozzáférést biztosít az elemzett mutatókhoz és összességében hasonlít a hagyományos ténytáblázathoz (csak a mutatók nem magában a táblázatban, hanem a "szomszédos" táblázatban vannak tárolva). De vannak csapdák is: a modell egyik tipikus módosítása — a tény kulcsának kiterjesztése — szükségessé teszi új külső kulcs hozzáadását a Linkben. Ez pedig "megtöri" a modularitást, és potenciálisan más objektumok módosítását is szükségessé teheti.
A A Horgony modellel A kapcsolat nem rendelkezhet saját attribútumokkal, ezért ez a megközelítés nem működik — abszolút minden attribútumnak és mutatónak egy adott horgonyhoz kell kapcsolódnia. A következtetés egyszerű: minden tényhez is szükséges egy saját horgony. Ami a tényeket illeti, ez természetesnek tűnhet — például a vásárlás ténye jól egyeztethető a "rendelés" vagy "számla" objektummal, egy webhely látogatása pedig a session-nel stb. De léteznek olyan tények is, amelyeknél nem olyan egyszerű megtalálni az ilyen természetes "objektum-hordozót" — például a készletmaradványok a raktárakban minden nap elején.
Így a ténykulcs moduláris bővítésével kapcsolatos problémák nem lépnek fel az Anchor modellben (csak annyit kell tennünk, hogy új Kapcsolatot adunk a megfelelő Horgonyhoz), de a tények megjelenítésére tervezett modell kevésbé egyértelmű, „mesterséges” Horgonyok is megjelenhetnek, amelyek nem egyértelműen tükrözik az üzleti objektummodellt.
Hogyan érhető el a rugalmasság
A létrejövő konstrukció mindkét esetben tartalmaz lényegesen több táblát, mint a hagyományos dimenzió. De helyet foglalhat el lényegesen kevesebb lemezhelyet ugyanazzal a verziós attribútumokkal, mint a hagyományos dimenzió. Természetesen itt nincsen mágikus megoldás — az egész a normalizálásról szól. Az attribútumokat a Satelite-okba (Data Vault) vagy külön táblákba (Anchor Model) osztva csökkentjük (vagy teljesen kizárjuk) az egyes attribútumok értékeinek megismétlődését mások módosításakor..
A Data Vault A nyereség a Satelite-okhoz rendelt attribútumok eloszlásától függ, és a A Horgony modellel — gyakorlatilag egyenesen arányos az objektumdimenzió átlagos verziószámával.
A tárolt helyért elért nyereség azonban fontos, de nem a legfőbb előnye az attribútumok külön tárolásának. Az ilyen megközelítés a kapcsolatok külön tárolásával együtt az adattárat moduláris konstrukcióvá. Ez azt jelenti, hogy az egyes attribútumok és teljes új témakörök hozzáadása ilyen modellben úgy jelenik meg, mint kiegészítés a meglévő objektumcsoporthoz anélkül, hogy azokat módosítanánk. És ez az, ami rugalmassá teszi a leírt metodológiákat.
Ez emlékeztet a darabgyártásról a tömeggyártásra való átmenetre — míg a hagyományos megközelítésben minden táblának egyedileg kell kezelnie, addig a rugalmas metodológiákban ezek már egy sor tipikus "alkatrész". Az egyik oldalról nő a táblák száma, az adatok betöltési és lekérdezési folyamatai bonyolultabbnak tűnhetnek. Másrészt, ezek tipikusak. Ezért lehetnek automatizált és adatkezelés alatt álló metaadatok. A kérdés “hogyan fogjuk elhelyezni?”, amely korábban jelentős részesedést képviselt a projekttervezéshez szükséges munkákban, most már egyszerűen nem merül fel (mint ahogy a modellváltozás folyamatokra gyakorolt hatásának kérdése sem).
Ez nem jelenti azt, hogy analitikákra egy ilyen rendszerben egyáltalán nincs szükség — valakinek még mindig dolgoznia kell az objektumok attribútumkészletén, és ki kell derítenie, honnan és hogyan töltse be mindezt. De a munka mennyisége, valamint a hiba valószínűsége és költsége jelentősen csökken. Az analízis fázisában, és a legyártás során az ETL, ami nagy részben a metaadatok szerkesztésére redukálódhat.
Sötét oldal
Mindezek a fentebb leírtak valóban rugalmassá, technológiaivá és iteratív fejlesztésre alkalmassá teszik mindkét megközelítést. Természetesen van egy 'kád kátrány', amiről már gondolom, hogy sejtette.
Az adatok dekompozíciója, amely a rugalmas architektúrák modularitásának alapját képezi, a táblák számának növekedéséhez vezet, és ennek megfelelően a költségek a kitapintások során. Ahhoz, hogy egyszerűen megkapjuk az összes mérési attribútumot, a klasszikus adattárházban elegendő egy kiválasztás, míg a rugalmas architektúra több csatlakozást igényel. Ráadásul, míg ezek a csatlakozások a jelentésekhez előre megírhatók, az SQL-t kézzel író analitikák kétszer olyan nehezen fogják ezt megvalósítani.
Van néhány tény, amely megkönnyíti ezt a helyzetet:
Nagy dimenziók használata során szinte soha nem használják egyszerre az összes attribútumot. Ez azt jelenti, hogy a csatlakozások száma kevesebb lehet, mint ahogy első ránézésre a modell alapján tűnik. A Data Vault esetében a várható közös használat gyakoriságát is figyelembe lehet venni az attribútumok szatelitok közötti elosztásánál. Ezen kívül maguk a Hubok vagy Horgok elsősorban a megfelelők létrehozásához és térképezéséhez szükségesek a betöltési szakaszban, és ritkán használják a lekérdezések során (különösen a Horgok esetében ez igaz).
Minden csatlakozás kulcs alapján történik. Ezenkívül az adatok „tömörített” tárolásának módja csökkenti a táblák bejárásának költségeit, ahol ez szükséges (például attribútum érték szerinti szűréskor). Ez oda vezethet, hogy a normalizált adatbázisból számos csatlakozással végzett lekérdezés még gyorsabb lehet, mint egy nehéz dimenzió egy sorban lévő sok verzióval való bejárása.
Például itt van egy cikk, amely részletes összehasonlító teljesítménytesztet tartalmaz az Anchor modell és az egy táblából való lekérdezés között.
Sok függ a motortól. Sok modern platform rendelkezik belső csatlakozási optimalizáló mechanizmusokkal. Például a MS SQL és az Oracle képes „kihagyni” a csatlakozásokat a táblákra, ha ezek adatai sehol nem használatosak, csak más csatlakozásokban, és nem befolyásolják a végső eredményt (table/join elimination), míg a MPP Vertica a kiváló motorként bizonyult az Anchor modellhez, némi manuális lekérdezésoptimalizálással. Másrészről, az Anchor modell tárolása, például Click House-on, amely korlátozott csatlakozási támogatással rendelkezik, nem tűnik túl jó ötletnek.
Ezen kívül mindkét architektúra számára léteznek különleges technikák, amelyek megkönnyítik az adatokhoz való hozzáférést (mind a lekérdezések teljesítménye, mind a végfelhasználók szempontjából). Például, Point-In-Time táblák a Data Vault-ban vagy különleges táblázati funkciók az Anchor modellben.
Összesen
A fent említett rugalmas architektúrák lényege a „moduláris” szerkezetük.
Ez a tulajdonság teszi lehetővé:
- Néhány kezdő előkészítés után, amely magában foglalja a metainformációk telepítését és az alapvető ETL algoritmusok megírását, gyorsan bemutathatjuk az első eredményt néhány jelentés formájában, amelyek csak néhány forrást tartalmaznak. Az egész objektum modell teljes kidolgozása (még felső szinten sem) nem szükséges ehhez.
- Az adatmód modell 2-3 objektummal elkezdheti a működést (és előnyöket hozni), majd lassan kiterjedhet (az Anchor modellel kapcsolatban Nikolaj szép hasonlatot a gomba rendszerével).
- A legtöbb módosítás, beleértve a tárgykör kiterjesztését és új források hozzáadását, nem érinti a meglévő funkciókat, és nem jelent veszélyt arra, hogy valami már működőt elrontson..
- A standard element decomposition makes ETL processes in such systems uniform, their writing is subject to algorithmization and, ultimately, automation.
The price of such flexibility is teljesítmény. This does not mean that achieving acceptable performance on such models is impossible. Most often, you may just need to put in more effort and attention to detail to reach the desired metrics.
Alkalmazások
Entity types Data Vault
More about Data Vault:
Types of entities az változatlan
More about the Anchor Model:
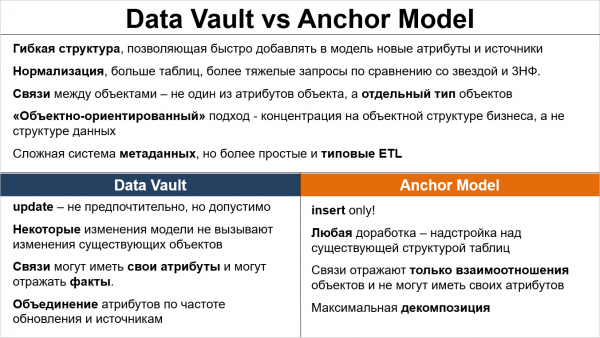
Summary table with common features and differences of the reviewed approaches:
Forrás: habr.com
