

Jelenleg egyre több vállalat költözteti az infrastruktúráját fizikai szerverekről és saját virtuális gépeikről a felhőkbe. Ez a döntés könnyen érthető: nincs szükség a hardver irányítására, a klaszter sokféleképpen konfigurálható... és legfőképpen a meglévő technológiák (mint például a Kubernetes) lehetővé teszik a számítási teljesítmény egyszerű skálázását a terhelés függvényében.
Mindig fontos a pénzügyi szempont is. Az eszköz, amelyről ez a cikk szól, arra hivatott, hogy elősegítse a költségek csökkentését a Kubernetes-alapú felhőinfrastruktúrák használatakor.
Bevezetés
— egy kaliforniai startup, amely korábbi Google-alkalmazottak által alakult, és a felhőszolgáltatások infrastruktúrájának költségeinek kiszámítására (a Kubernetes klaszteren belül + közös erőforrások), a klaszter beállításainak szűk keresztmetszeteinek keresésére, valamint a megfelelő értesítések Slackbe történő küldésére kínál megoldást.
Olyan ügyfeleink vannak, akik Kubernetes-t használnak a megszokott AWS és GCP felhőkben, valamint a Linux közösség számára ritkább Azure-ban — összességében minden olyan platformon, amelyet a Kubecost támogat. Néhányuk számára mi saját magunk számítjuk a belső klaszterszolgáltatások költségeit (olyan módszer szerint, amely hasonló a Kubecost által használthoz), és folyamatosan nyomon követjük az infrastruktúra költségeit, valamint igyekszünk azokat optimalizálni. Így logikus, hogy érdeklődtünk ezen feladatok automatizálásának lehetősége iránt.
A Kubecost fő moduljának forráskódja nyílt forráskódú licenc (Apache License 2.0) alatt érhető el. Szabadon felhasználható, és a rendelkezésre álló funkcióknak elegendőnek kell lennie kisebb projektekhez. Azonban a biznisz az biznisz: a termék többi része zárt, és igénybe vehető , amelyek keretében kereskedelmi támogatást is nyújtanak. Ezen kívül a szerzők ingyenes licencet kínálnak kisebb klaszterek számára (1 klaszter 10 node-hoz — a cikk írásának idején ez a határ 20 node-ra bővült) vagy próbaverziót teljes funkcionalitással egy hónapra.
Hogyan működik minden
Tehát a Kubecost fő része egy , amely Go nyelven készült. Az egész rendszert leíró Helm-diagram neve , és lényegében a cost-model, Prometheus, Grafana és néhány dashboard összeállítása.
Általánosságban elmondható, hogy a cost-model rendelkezik egy webes felülettel, amely grafikonokat és részletes statisztikákat mutat be a költségekről táblázatos formában, valamint természetesen költségoptimalizálási tippeket is tartalmaz. A Grafana dashboard-ok, amelyek bemutatásra kerülnek, a Kubecost fejlődésének korábbi szakaszát képviselik, és nagyban ugyanazokat az adatokat tartalmazzák, mint a cost-model, kiegészítve a klaszter és alkotórészei CPU/memória/hálózati/disk használatának szokásos statisztikáival.
Hogyan működik a Kubecost?
- A cost-model az API-n keresztül kapja meg a felhőszolgáltatók karbantartási árait.
- Ezt követően a csomópontok hardver típusa és a régió alapján kiszámításra kerül a csomópontok költsége.
- A csomópontok működési költségei alapján minden egyes végső pod óránkénti CPU használati költségét, gigabájt memóriafelhasználás költségét és gigabájt adatok tárolásának óránkénti költségét kapja — attól függően, hogy melyik csomóponton futott, vagy a tárolás osztályától.
- A különböző pod-ok működési költsége alapján számítják ki a névtér, szolgáltatások, Deployment-ek és StatefulSet-ek díját.
- A statisztikai számításhoz a kube-state-metrics és node-exporter által szolgáltatott metrikákat használják.
Fontos figyelembe venni, hogy a Kubecost alapértelmezés szerint csak a Kubernetes-ben elérhető erőforrásokat számolja. A külső adatbázisok, GitLab szerverek, S3 tárolók és egyéb, a klaszteren kívüli szolgáltatások (még ha ugyanabban a felhőben is találhatók) számára nem láthatók. Habár a GCP és AWS esetében hozzáadhatók a saját szolgáltatás-felhasználói kulcsai, és mindent együtt lehet számolni.
Telepítés
A Kubecost működéséhez ezekre van szükség:
- Kubernetes 1.8-as verzió és felette;
- kube-state-metrics;
- Prometheus;
- node-exporter.
Úgy alakult, hogy a mi klasztereinkben minden szükséges feltétel már korábban teljesült, ezért elegendő volt csak megadni a helyes végpontot a Prometheushoz való hozzáféréshez. Mindazonáltal a hivatalos Helm-chart kubecost mindent tartalmaz, ami a „meztelen” klaszteren való elinduláshoz szükséges.
A Kubecost-ot többféleképpen is telepítheted:
- A telepítés standard módja, amelyet a fejlesztői weboldalon írnak le. Először is a cost-analyzer Helm repót kell hozzáadni, majd a chart-ot telepíteni. Csak annyit kell tenned, hogy belső portot nyitsz és finomhangolod a beállításokat a kívánt állapotig manuálisan (kubectl-en keresztül) és/vagy a cost-model webes felületén.
Ezt a módszert még nem próbáltuk ki, mivel nem használunk harmadik féltől származó előre elkészített konfigurációkat, de jónak tűnik, mint egy "egyszerűen kipróbálom magamnak" lehetőség. Ha már telepítve van a rendszer egyes összetevői, vagy szeretne finomabb beállításokat, érdemes inkább a második utat választani.
- Lényegében használni , de saját magának konfigurálja és telepíti azt bármilyen kényelmes módon.
Ahogy említésre került, a kubecost mellett ez a chart tartalmazza a Grafana és a Prometheus chart-jait is, amelyeket szintén igény szerint testre lehet szabni.
A chart-ban lévő
values.yamla cost-analyzer számára lehetővé teszi a következők testreszabását:- a cost-analyzer összetevőinek listáját, amelyeket telepíteni kell;
- saját endpoint a Prometheus számára (ha már van);
- domainok és egyéb ingress beállítások a cost-model és a Grafana számára;
- annotations a pod-ok számára;
- a tartós tárolók szükségessége és méretük.
A teljes konfigurálási lehetőségek listáját és leírását megtalálja a .
Mivel a kubecost alapértelmezés szerint nem tud hozzáférést korlátozni, előre be kell állítani a basic-auth-ot a webpanelhez.
- Telepítse csak a rendszer magja — cost-model. Ehhez szükséges, hogy a klaszterben telepítve legyen a Prometheus, és a megfelelő címét meg kell adni a
prometheusEndpointa Helm számára. Ezt követően alkalmazni kell a klaszterben.Ismét manuálisan kell hozzáadni az Ingress-t basic-auth-dal. És végül, szükséges egy szakasz hozzáadása a cost-model metrikáinak gyűjtéséhez a
extraScrapeConfigsa Prometheus konfigurációjában:- job_name: kubecost honor_labels: true scrape_interval: 1m scrape_timeout: 10s metrics_path: /metrics scheme: http dns_sd_configs: - names: - <a kubecost szolgáltatásának címe> type: 'A' port: 9003
Mit kapunk?
Teljes telepítés esetén a kubecost webpanelje és a Grafana egy kész dashboarddal a rendelkezésünkre áll.
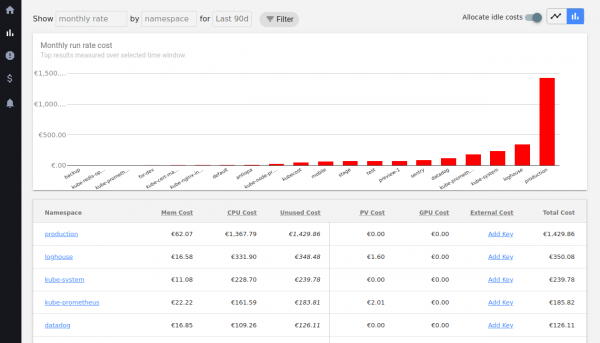
Teljes költség, amely a főképernyőn látható, lényegében a havi erőforrásköltséget mutatja. Ez előrejelzett ár, amely a klaszter használati költségét mutatja (havonta) a jelenlegi erőforrás-fogyasztási szinten.
Ez a metrika inkább a kiadások elemzésére és optimalizálására szolgál. Az absztrakt júliusi költségeket a kubecost-ban nem igazán lehet jól megvizsgálni: ehhez a bilingrekell menni. Viszont láthatja a költségeket namespace, címkék és pod-ok szerint 1/2/7/30/90 napra lebontva, amit a billing soha nem mutat meg.
A címkék kapcsán a címkékről. Azonnal érdemes belépni a beállításokba, és megadni a címkéket, amelyeket további kategóriákként használnak a költségek csoportosítására:
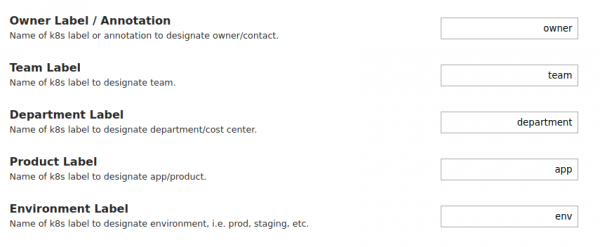
Bármilyen címkét rátehetünk — ez kényelmes, ha már létezik saját jelölési rendszerünk.
A címkék módosítása mellett az API endpoint címét is meg lehet változtatni, ahová a költségmodellel csatlakozunk, beállíthatjuk a GCP-segély mértékét, valamint saját árakat állíthatunk be az erőforrások és az azokhoz való mérések valutájára (ez a funkció valamiért nem befolyásolja a teljes költséget).
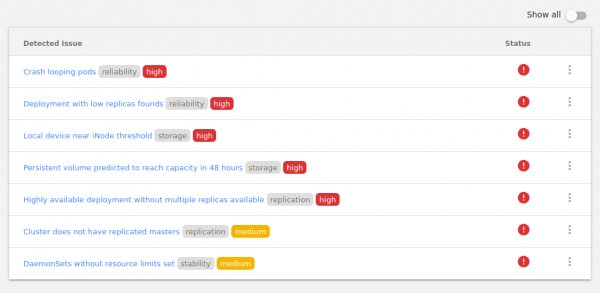
A Kubecost különböző problémákat tud megjeleníteni a klaszterben (és figyelmeztetni is tud, ha veszély áll fenn). Sajnos a lehetőség nem konfigurálható, így ha van fejlesztői környezetünk és azt használják, folyamatosan egy hasonló dologra lehet figyelni:
Fontos eszköz — Cluster Savings. Ez méri a podok aktivitását (erőforrás-fogyasztás, beleértve a hálózatiakat is), és számolja, mennyi pénzt és miken lehet megtakarítani.
A tippek az optimalizációra elég nyilvánvalónak tűnhetnek, de a tapasztalat azt mutatja, hogy mindig van mit észrevenni. Különösen a podok hálózati aktivitását követik (a Kubecost javasolja, hogy figyeljünk a nem aktívakra), összehasonlítják a kért és a tényleges memória- és CPU-fogyasztást, valamint a klaszter csomópontjai által használt CPU-t (javasolják, hogy több csomópontot egyesítsenek), a lemezek terhelése és további több tucat paraméter.
Mint minden optimalizálással kapcsolatos kérdésnél, a Kubecost adatain alapuló erőforrások optimalizálásához is óvatosan kell hozzáállni. Például a Cluster Savings azt javasolja, hogy töröljünk csomópontokat, azt állítva, hogy ez biztonságos, azonban nem veszi figyelembe a rajtuk lévő podok node-selector-ait és taint-ait, amelyek nincsenek más csomópontokon. Egyáltalán, még a termék szerzői is a (mellesleg, ez hasznos lehet azok számára, akiket érdekel a projekt témája) javasolják, hogy ne ugorjunk fejest az kiadások optimalizálásába, hanem tudatosan közelítsünk a kérdéshez.
Összegzés
A kubecost használata után egy hónapig néhány projekten azt a következtetést vonhatjuk le, hogy ez egy érdekes (ráadásul könnyen elsajátítható és telepíthető) eszköz a felhőszolgáltatók költségeinek elemzésére és optimalizálására, amelyeket Kubernetes klaszterekhez használnak. A számítások meglehetősen pontosak: kísérleteinkben ezek egybeestek azzal, amit a szolgáltatók valójában igényeltek.
Nem voltak hiányosságok sem: vannak nem kritikus hibák, a funkcionális lehetőségek helyenként nem fedik le a bizonyos projektek specifikus igényeit. Azonban, ha gyorsan szeretnénk megérteni, hová tűnnek el a pénzek, és mit lehet "levágni", hogy stabilan csökkentsük a felhőszolgáltatások számláját 5-30%-kal (ahogy ez a mi esetünkben is történt), akkor ez egy nagyszerű megoldás.
P.S.
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «».
Forrás: habr.com
