

Helló, Habr! Ez a folytatása a , amelyben a JMeter segítségével a sorokban üzenetkezelés lehetőségeit mutatom be.
Adatbuszt készítünk egy nagy állami vállalat számára. Különböző kérésformátumok, transzformációk, bonyolult irányítás. A teszteléshez sok üzenetet kell küldeni a sorokba. Kézi működéssel ez fájdalmas, nem minden manuális munkás bírja ezt el.
Bevezetés
Bár ezt a fájdalmat a kezdeti időszakban el kellett fogadni. Minden RFHUtil-lal kezdődött. Erőteljes, de kényelmetlen és félelmetes: Tudjátok, miről beszélek.
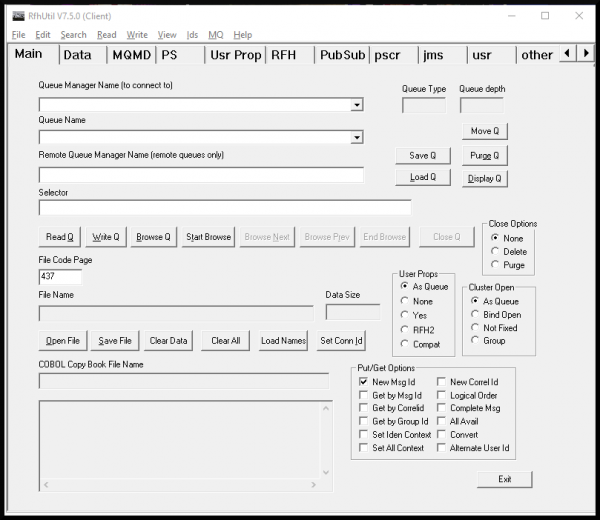
Néhány esetben pótolhatatlan, de folyamatos használat esetén állandóan összeomlik.
A tesztelés vele nem kényelmes.
A JMeter segítségével minden egyszerűbb lett. Az első lépés után, a megszokás után, kezdtem reménykedni a boldog tesztelésben.
Aktívan használom a JMS Publisher és JMS Subscriber mintákat. A JMS Point-to-Point-tól eltérően ez a pár sokkal kényelmesebbnek tűnt a munkában. Például a Subscriber JMS Selector-ában meg lehet adni egy változót, a Point-to-Point esetében viszont nem (vagy nem túl egyértelmű ez a módszer).
A minták előkészítése
JMS Publisher
- Beállítás — Minden mintánál. Apache használja ezt az opciót, ha a sorok/témák változók révén vannak megadva.
- Lejárati idő (ms) = 120000. Hiba esetén a tesztkérések 2 perc múlva eltűnnek a sorból.
- Non-persistent delivery mode használata? — igaz. IBM , hogy a persistent mode biztosítja az átadott üzenetek megbízható tárolását hirtelen hiba esetén. A non-persistent mode pedig gyorsabb cserét biztosít. Tesztelési célokra a sebesség fontosabb.
Minden Publisher esetében beállítok egy jms-jellemzőt, amelyet a Subscriber a JMS Selector-ban használni fog. Minden küldéskor véletlenszerű értéket generálunk a tesztterv User Parameters elemében:
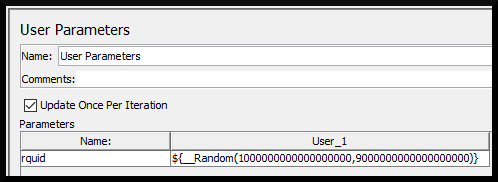
Így biztos lehet benne, hogy a megfelelő üzenetet olvassák.
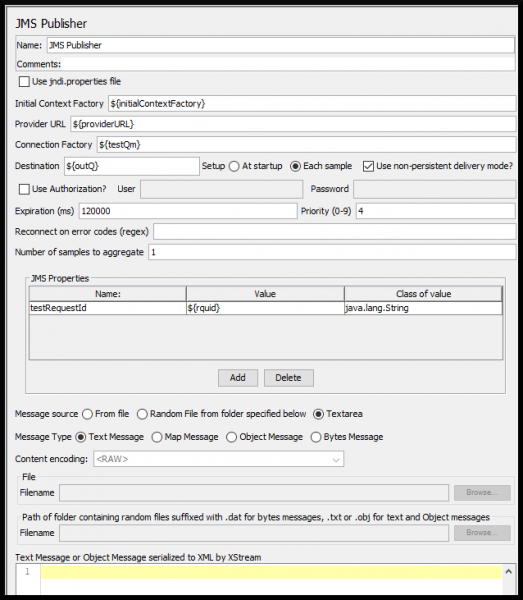
A végső "sablon" előre beállított JMS Publisher-hez:
JMS Subscriber
- Beállítás — Minden mintánál. Nos, érted.
- Timeout (ms) = 100000. Ha a kérés 100 másodperces várakozás után nem érkezik a sorba, akkor valami rosszul sült el.
- Megállni a minták között? — igaz.
JMS Selector — meglehetősen kényelmes . Végső JMS Subscriber:
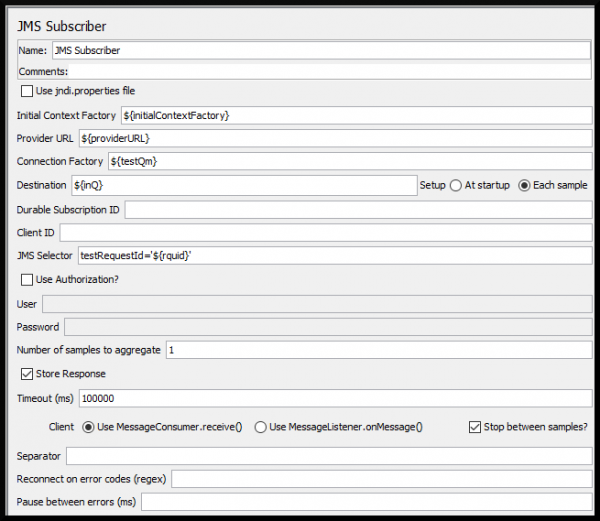
Hogyan kezeljük a cirill betűket a továbbított üzenetekben. A JMeter alapértelmezés szerint a kiolvasás után torzan jeleníti meg őket. Ennek elkerülésére és a nagy és hatalmas élvezetére mindig és mindenhol érdemes:
- Hozzáadni a JMeter "indítóhoz" JVM argumentumot:
-Dfile.encoding=UTF-8 - Hozzáadni egy JSR223 PostProcessor-t a Subscriberhez egy Groovy sorral:
prev.setDataEncoding("UTF-8")
Szövegátvitel
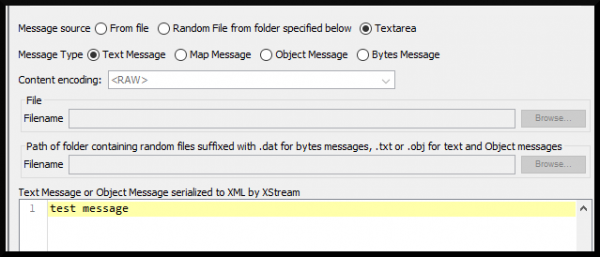
A leglazább lehetőség. Alkalmas frissen írt tesztek hibakeresésére. Vagy olyan esetekre, amikor valamit mindenképpen el kell küldeni, legalábbis kisebb méretben. Válaszd az opciót Üzenet forrás — Szövegdoboz és helyezd el az üzenet szövegét a szöveges blokkban:
Fájl átvitel
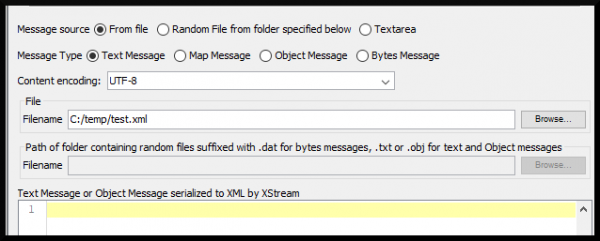
A leggyakoribb lehetőség. Alkalmas a legtöbb forgatókönyvhöz. Válaszd az opciót Üzenet forrás — Fájlból és add meg az üzenet útvonalát a mezőben Fájl — Fájlnév:
Fájl átvitel a szövegmezőben
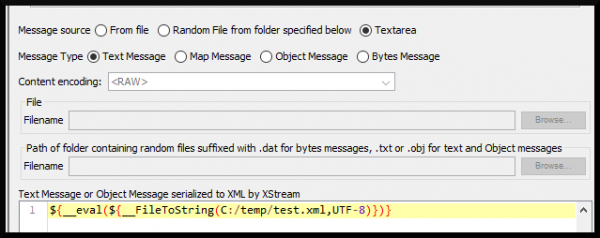
A leguniverzálisabb lehetőség. Alkalmas a legtöbb forgatókönyvhöz, és használható JMS Point-to-Point módban, ahol nincs másik küldési lehetőség:
Bájt tömb átvitel
A legbonyolultabb lehetőség. Alkalmas a bájtosan pontos kérésátvitel ellenőrzésére, torzulás, SMS és perturbációk nélkül. Ezt a JMeter alapértelmezett beállításával nem lehet megvalósítani, erről egyértelműen tájékoztattak.
Ezért le kellett töltenem és módosítanom kellett JMS Előfizető.
Kicseréltem a módszerben extractContent(..) a sort:
buffer.append(bytesMessage.getBodyLength() + " bájt érkezett a BytesMessage-ben");az alábbiakra:
byte[] bytes = new byte[(int) bytesMessage.getBodyLength()];
bytesMessage.readBytes(bytes);
try {
	buffer.append(new String(bytes, "UTF-8"));
} catch (UnsupportedEncodingException e) {
	throw new RuntimeException(e);
}
és újra kellett építenem a JMetert.
Még hozzá kell adni néhány JSR223 mintát. Az első — a Publisher/Subscriber párok előtt, a dat fájl létrehozásához, amely véletlenszerű bájtokat tartalmaz:
import org.apache.commons.lang3.RandomUtils;

import java.io.File;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;

vars.put("PATH_TO_BYTES", "C:temprandomBytes.dat");
File RESULT_FILE = new File(vars.get("PATH_TO_BYTES"));
byte[] arr = RandomUtils.nextBytes((int)(Math.random()*10000));
        try {
            FileOutputStream fos = new FileOutputStream(RESULT_FILE);
            fos.write(arr);
            fos.close();
        } catch (IOException e) {
            System.out.println("fájl nem található");
        }
A második — a forgatókönyv végén, törli a fájlt:
import java.io.File;

File RESULT_FILE = new File(vars.get("PATH_TO_BYTES"));
RESULT_FILE.delete();
És ne felejtsd el hozzáadni a fájl útvonalát a Publisherhez:
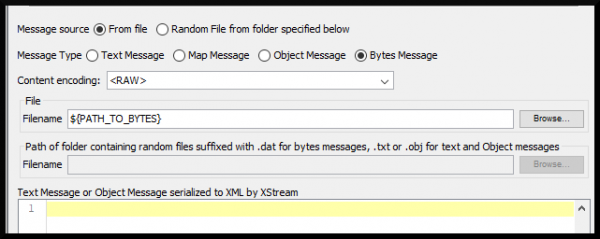
Ezen kívül szükséges egy JSR223 Assertion ellenőrzés a Subscriberhez — az eredeti bájtok összehasonlítása azzal, ami a címzett sorba érkezik:
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;
import java.util.Arrays;

Path path = Paths.get(vars.get("PATH_TO_BYTES"), new String[0]);
byte[] originalArray = Files.readAllBytes(path);
byte[] changedArray = ctx.getPreviousResult().getResponseData();
System.out.println(changedArray.length);

if (Arrays.equals(originalArray, changedArray))
	{
     	SampleResult.setResponseMessage("OK");

	} else {
	   SampleResult.setSuccessful(false);
     	   SampleResult.setResponseMessage("Összehasonlítás sikertelen");
	   SampleResult.setResponseData("Bájtok megváltoztak", "UTF-8");
     	   IsSuccess=false;
	}
Zárás
Négy módszert írtam le az üzenetek sorba állítására, amelyeket naponta használok a gyakorlatban. Remélem, ez az információ megkönnyíti az életét. A folytatásban tervezem, hogy mesélek a cserés tesztelési tapasztalataimról, ahol az egyik végén egy sor, a másikon pedig egy adatbázis vagy fájlrendszer található.
Őrizzétek meg az időtöket. Köszönjük a figyelmet.
Forrás: habr.com
