

Bevezetés az operációs rendszerekbe
Helló, Habr! Szeretném bemutatni nektek egy érdekes cikk-sorozat fordítását, amely az én véleményem szerint izgalmas irodalom — OSTEP. Ebben az anyagban elég mélyen megvizsgáljuk az unix-szerű operációs rendszerek működését, különösen a folyamatokkal, különböző ütemezőkkel, memóriával és hasonló összetevőkkel foglalkozunk, amelyek alkotják a modern OS-t. Az összes anyag eredeti változatát itt láthatjátok . Kérlek vegyétek figyelembe, hogy a fordítás szakértelem nélküli (elég szabad), de remélem, az általános értelemben megmaradt.
A tantárgyhoz kapcsolódó laboratóriumi munkák itt találhatók:
Egyéb részek:
Emellett látogathattok el a csatornámra a =)
Bevezetés a tervezőbe
A probléma lényege: Hogyan alakítsunk ki tervezési politikát
Hogyan kell kidolgozni a tervezési politikák alap kereteit? Mik legyenek a kulcsfeltételezések? Milyen metrikák fontosak? Milyen alapvető technikák voltak használatban a korai számítástechnikai rendszerekben?
Terhelési feltételezések
Mielőtt megbeszélnénk a lehetséges politikákat, először tegyünk néhány egyszerűsítő megjegyzést a rendszerben futó folyamatokról, amelyeket együtt terhelésnekhívunk. A terhelés meghatározása a politikák megalkotásának kritikus része, és minél többet tud a terhelésről, annál jobb politikát tud írni.
Következő feltételezéseket tegyünk a rendszerben futó folyamatokról, amelyeket néha jobs (feladatoknak) neveznek. Gyakorlatilag az összes feltételezés nem reális, de szükséges a gondolatmenet fejlesztéséhez.
- Minden feladat ugyanannyi ideig fut,
- Minden feladat egyszerre kerül beállításra,
- A beállított feladat a befejeződéséig dolgozik,
- Minden feladat csak a CPU-t használja,
- Minden feladat futási ideje ismert.
Tervezési metrikák
A terhelés néhány feltételezése mellett szükség van egy eszközre is a különböző tervezési politikák összehasonlítására: a tervezési metrikákra. A metrika csupán egy mérőszám. Számos metrika létezik, amelyek használhatók a tervezők összehasonlítására.
Például használjunk egy metrikát, amelyet forgási időnek (turnaround time) neveznek. A feladat forgási ideje a feladat befejezési ideje és a rendszerbe való érkezésének ideje közötti különbség.
Tturnaround=Tcompletion−Tarrival
Mivel feltételeztük, hogy minden feladat egyszerre érkezett, Ta=0, így Tt=Tc. Ez az érték természetesen megváltozik, ha a fenti feltételezéseket módosítjuk.
Egy másik metrika — fairness (igazságosság). A teljesítmény és az igazságosság gyakran ellentétes jellemzők a tervezés során. Például a tervező optimalizálhatja a teljesítményt, de más feladatok indításának várakozásának árán, így csökkentve az igazságosságot.
FIRST IN FIRST OUT (FIFO)
A legbasicabb algoritmus, amit megvalósíthatunk, a FIFO néven ismert, vagyis first come (in), first served (out). Ez az algoritmus több előnnyel rendelkezik: nagyon egyszerű megvalósítani, és megfelel minden feltételezésünknek, miközben egészen jól végzi a feladatát.
Nézzünk egy egyszerű példát. Tegyük fel, hogy 3 feladatot indítottunk el egyszerre. De feltételezzük, hogy az A feladat egy kicsit korábban érkezett, mint a többiek, ezért a feldolgozási listában előrébb fog állni, ahogyan a B is a V-hez képest. Tegyük fel, hogy mindegyik 10 másodpercig fog futni. Mi lesz ebben az esetben a feladatok átlagos végrehajtási ideje?
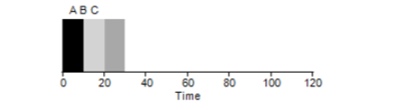
Az értékek kiszámításával — 10+20+30, és elosztva 3-mal, az átlagos végrehajtási idő 20 másodperc lesz.
Most próbáljuk meg módosítani a feltételezéseinket. Különösen az 1. feltételezést, és így már nem azt fogjuk feltételezni, hogy minden feladat azonos időtartamon fut. Milyen teljesítménnyel fog járni a FIFO ezúttal?
Kiderül, hogy a feladatok eltérő végrehajtási ideje rendkívül negatívan hat a FIFO algoritmus hatékonyságára. Tegyük fel, hogy az A feladat 100 másodpercig tart, míg a B és C továbbra is 10-10 másodpercig tartanak.
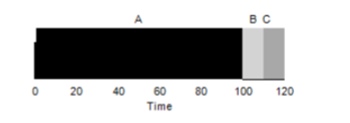
Ahogy a képen látható, a rendszer átlagos ideje (100+110+120)/3=110. Ezt a jelenséget hívják a konvojhatásnak, amikor egyes rövid távú erőforrást igénylő feladatok egy nehéz erőforrásigénylő mögött állnak a sorban. Ez hasonlít a boltban való sorban állásra, amikor Ön előtt egy teljes bevásárlókocsi áll. A probléma legjobb megoldása, ha megpróbál átállni egy másik kasszára, vagy egyszerűen csak megnyugszik és mélyeket lélegzik.
Shortest Job First
Van-e valami módja a nehéz folyamatokkal kapcsolatos ilyen helyzet megoldásának? Természetesen. Egy másik típusú ütemezés neveShortest Job First (SJF). Az algoritmus is elég primitív, ahogy a neve is sugallja, elsőként a legrövidebb feladatok futnak egymás után.
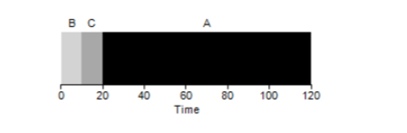
Ebben a példában ugyanazoknak a folyamatoknak a futtatása javítani fogja az programátlagos átfutási idejét, amely 50 lesz a 110 helyett, ami gyakorlatilag kétszer jobb.
Ezért, a feltételezésünk alapján, hogy minden feladat egyszerre érkezik, az SJF algoritmus a legoptimálisabbnak tűnik. Azonban a feltételezéseink továbbra sem tűnnek reálisnak. Most módosítsuk a 2. feltételezést, és képzeljük el, hogy a feladatok bármikor érkezhetnek, nem egyszerre. Milyen problémákhoz vezethet ez?
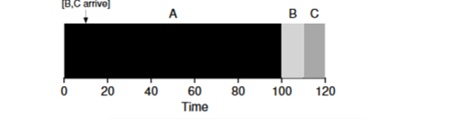
Képzeljük el, hogy az A feladat (100 másodperc) érkezik először, és elkezdődik a végrehajtása. T=10-nél érkezik a B és C feladat, mindkettő 10 másodpercet igényel. Így az átlagos végrehajtási idő (100+(110-10)+(120-10))/3 = 103 másodperc. Mit tehetne a tervező a helyzet javítása érdekében?
Legrövidebb befejezési idő első (STCF)
A helyzet javítása érdekében elhagyjuk a 3. feltételezést, miszerint a program elindul és folytatódik a befejezésig. Ezen kívül szükségünk lesz hardvertámogatásra, és mint kitalálhatták, használni fogjuk az időzítőt a futásban lévő feladat megszakításához és a kontextusok váltásához. Így a tervező beavatkozhat, amikor a B és C feladatok beérkeznek — leállíthatja az A feladatot, és feldolgozásra veheti a B és C feladatokat, majd azok befejezése után folytathatja az A feladat végrehajtását. Az ilyen tervezőt nevezzük STCFvagy Preemptív első feladat.
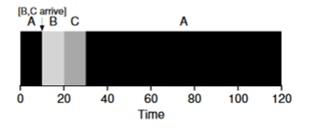
Ennek a tervezőnek az eredménye: ((120-0)+(20-10)+(30-10))/3=50. Így ez a tervező még optimálisabbá válik a feladatainkhoz.
Válaszidő metrika (Response Time)
Tehát ha tudjuk a feladatok futási idejét és azt, hogy ezek a feladatok csak CPU-t használnak, akkor az STCF a legjobb megoldás. Valaha ezek az algoritmusok működtek és eléggé jól is. Azonban ma a felhasználók a legtöbb időt a terminál előtt töltik, és elvárják, hogy az interaktív interakciók teljesítőképességét kapják. Így született meg az új metrika — válaszidő (response time).
A válaszidőt a következőképpen számoljuk:
Tresponse=Tfirstrun−Tarrival
Tehát az előző példa válaszideje a következő: A=0, B=0, C=10 (abg=3,33).
Kiderül, hogy az STCF algoritmus nem is olyan jó, ha három feladat egyszerre érkezik — meg kell várnia, amíg a kis feladatok teljesen befejeződnek. Így az algoritmus jó a fordulási idő mérésére, de rossz az interaktivitás mérésére. Képzelje el, hogy amikor a terminál előtt ül, és megpróbál karaktereket beírni egy szövegszerkesztőbe, 10 másodpercnél tovább kell várnia, mert egy másik feladat foglalja el a processzort. Ez nem túl kellemes.
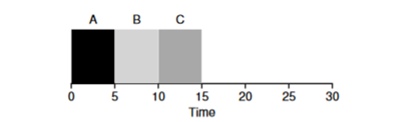
Ezzel a problémával szembesülünk — hogyan építhetünk egy ütemezőt, amely érzékeny a válaszidőre?
Körkörös Ütemezés
A probléma megoldására kifejlesztett algoritmus Körkörös Ütemezés (RR). Az alapgondolat nagyon egyszerű: ahelyett, hogy a feladatokat teljesen befejeznénk, egy bizonyos időtartamra (úgynevezett időkvantum) indítjuk el a feladatot, majd váltunk egy másik feladatra a sorban. Az algoritmus addig folytatja a munkát, amíg az összes feladat be nem fejeződik. A program futási idejének oszthatónak kell lennie a megszakító idővel. Például, ha a megszakító processzként 10 ms-ig működik, akkor a folyamat végrehajtási idejének is meg kell felelnie ezzel, és 10, 20 vagy x*10-nek kell lennie.
Nézzük meg a példát: Az A, B és C feladatok egyszerre érkeznek a rendszerbe, és mindhárom 5 másodpercet szeretne dolgozni. Az SJF algoritmus minden feladatot a végéig futtat, mielőtt egy másikat indítana. Ezzel szemben az RR algoritmus 1 másodperces futási ablakot választ, ami a következőképpen halad a feladatokon (4.3. ábra):
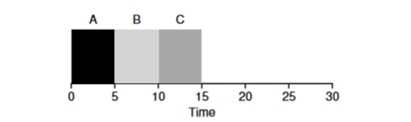
(SJF Ismét (Rossz a válaszidő szempontjából)
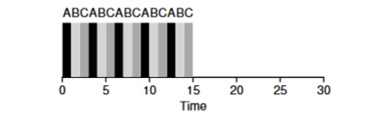
(Körkörös Ütemezés (Jó a válaszidő szempontjából)
Az RR algoritmus átlagos válaszideje (0+1+2)/3=1, míg az SJF esetén (0+5+10)/3=5.
Logikus feltételezni, hogy az időablak nagyon fontos szempont a RR számára; minél kisebb az, annál magasabb a válaszidő. Azonban nem szabad túl kicsire is beállítani, mivel a kontextusváltás ideje szintén szerepet játszik az összteljesítményben. Így a végrehajtási időablak megválasztása az operációs rendszer építészétől függ, és azoktól a feladatoktól függ, amelyeket végre kívánnak hajtani. A kontextusváltás nem az egyetlen olyan szolgáltatási művelet, amely időt vesz igénybe — a futó program sok más dologgal is operál, például különböző cache-ekkel, és minden egyes váltás során meg kell őrizni és visszaállítani ezt a környezetet, ami szintén sok időt igényelhet.
A RR kitűnő ütemező, ha csak a válaszidő metrikájáról van szó. De hogyan viselkedik a feladatforgás ideje ezzel az algoritmussal? Vegyünk egy példát, amikor A, B, C = 5 másodpercig működik, és egyszerre érkeznek. A feladat A 13 másodpercben, B 14 másodpercben, C pedig 15 másodpercben fejeződik be, és az átlagos forgásidő 14 másodperc lesz. Így a RR a forgási metrika szempontjából a legrosszabb algoritmus.
Általánosabb szavakkal, bármely RR típusú algoritmus tisztességes, mivel egyenlő arányban osztja el a CPU által végzett időt az összes folyamat között. Így ezek a metrikák folyamatosan konfliktusban állnak egymással.
Ennek megfelelően van néhány ellentétes algoritmusunk, és emellett több feltételezés is fennáll — hogy a feladat ideje ismert, és hogy a feladat csak a CPU-t használja.
Kevert I/O
Először is megszüntessük a 4. feltételezést, miszerint a folyamat csak a CPU-t használja, természetesen ez nem így van, a folyamatok más hardverekhez is fordulhatnak.
Abban a pillanatban, amikor egy folyamat I/O műveletet kér, a folyamat blocked állapotba kerül, várva az I/O befejezését. Ha az I/O a merevlemezre kerül, akkor ez a művelet akár több ms-t is igénybe vehet, vagy tovább is tarthat, és a processzor ebben az időben állni fog. Ez idő alatt az ütemező bármely más folyamatot be tud állítani a processzorba. A következő döntés, amelyet az ütemezőnek meg kell hoznia — mikor fejezi be a folyamat az I/O-t. Amikor ez bekövetkezik, megszakítás fog történni, és az operációs rendszer a hívó I/O folyamatot ready állapotba állítja.
Nézzük meg a példát több feladattal. Mindegyik 50 ms processzori időt igényel. Azonban az első feladat 10 ms-ként I/O-ra fog hivatkozni (ami szintén 10 ms-ot fog igénybe venni). A B folyamat pedig egyszerűen 50 ms-ot használ fel I/O nélkül.
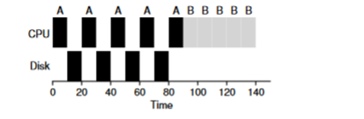
Ebben a példában az STCF ütemezőt fogjuk használni. Hogyan reagál az ütemező, ha egy A nevű folyamatot indítunk el rajta? Először teljes mértékben végrehajtja az A folyamatot, majd a B folyamatot.
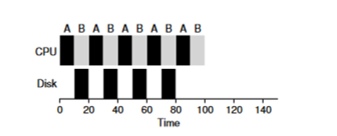
A probléma megoldásának hagyományos megközelítése az A folyamat 10 ms-enkénti részmunkáit külön feladatként értelmezni. Így, amikor az STJF algoritmussal indulunk, a 50 ms feladat és a 10 ms feladat közötti választás egyértelmű. Aztán, amikor az A részmunkája befejeződik, elindítjuk a B folyamatot és az I/O-t. Az I/O befejezése után újra elindul a 10 ms A folyamat a B folyamat helyett. Ezzel lehetővé válik a párhuzamos használat, amikor a CPU-t egy másik folyamat használja, míg az első I/O-ra vár. Ennek eredményeként a rendszer jobban kihasználható — amikor az interaktív folyamatok I/O-ra várnak, a CPU-n más folyamatok is végrehajthatók.
Az Oracle már nem létezik
Most próbáljuk meg megszabadulni attól a feltételezéstől, hogy a feladat végrehajtási ideje ismert. Ez alapvetően a legrosszabb és a legvalószínűtlenebb feltételezés a listán. A valóságban a hagyományos operációs rendszerek alig tudnak a feladatok végrehajtási idejéről, hogyan építhetünk ütemezőt anélkül, hogy tudnánk, mennyi ideig fog egy feladat végrehajtódni? Talán használhatnánk néhány RR elvet ennek a problémának a megoldására?
Result
Megvizsgáltuk a feladatütemezés alapvető ötleteit, és két ütemező családot. Az első a legrövidebb feladatot indítja el először, így csökkentve a körforgási időt, míg a második egyenletesen osztja el az időt minden feladat között, javítva a válaszidőt. Mindkét algoritmus rosszul teljesít ott, ahol a másik család algoritmusai jól teljesítenek. Azt is megvizsgáltuk, hogyan javíthatják a CPU és az I/O párhuzamos használata a teljesítményt, de nem oldottuk meg az operációs rendszer látomásának problémáját. A következő órán olyan ütemezőt fogunk megvizsgálni, amely a legközelebbi múltba tekint és próbálja megjósolni a jövőt. Ezt multi-level feedback queue-nak hívják.
Forrás: habr.com
