

Bevezetés az operációs rendszerekbe
Helló, Habr! Szeretném bemutatni nektek egy érdekes cikk-sorozat fordítását, amely az én véleményem szerint izgalmas irodalom — OSTEP. Ebben az anyagban elég mélyen megvizsgáljuk az unix-szerű operációs rendszerek működését, különösen a folyamatokkal, különböző ütemezőkkel, memóriával és hasonló összetevőkkel foglalkozunk, amelyek alkotják a modern OS-t. Az összes anyag eredeti változatát itt láthatjátok . Kérlek vegyétek figyelembe, hogy a fordítás szakértelem nélküli (elég szabad), de remélem, az általános értelemben megmaradt.
A tantárgyhoz kapcsolódó laboratóriumi munkák itt találhatók:
Egyéb részek:
Emellett látogathattok el a csatornámra a =)
Ütemezés: Többszintű Visszajelző Sor
Ebben az előadásban a legjobban ismert ütemezési megközelítés fejlesztési problémáiról fogunk beszélni, amelyet
Többszintű Visszajelző Sor-nak MLFQ-nak neveznek. Az MLFQ ütemezőt először 1962-ben Fernando J. Corbató írta le egy Kompatibilis Időmegosztó Rendszer (CTSS) nevű rendszerben. Ezek a munkák (beleértve a Multics későbbi munkáit) később a Turing-díjra kerültek. Az ütemező
később továbbfejlesztésre került, és olyan formát öltött, amely már megtalálható
néhány modern rendszerben.
Az MLFQ algoritmus megpróbálja megoldani 2 alapvető, átfedő problémát.
Megpróbálja optimalizálni a fordulási időt, amelyet, ahogy azt a korábbi előadásban áttekintettük, a legrövidebb feladatok elején való ütemezés módszerével optimalizálnak. Azonban az operációs rendszer nem tudja, hogy egy folyamat mennyi ideig fog futni, ez pedig
szükséges tudás az SJF és STCF algoritmusokhoz.
Először isAz MLFQ megpróbálja
visszajelzővé tenni a rendszert a felhasználók számára (például azok számára, akik ott ülnek és
bámulják a képernyőt a feladat befejezésére várva), így minimalizálva a Secondlyválaszidőt. Sajnos az olyan algoritmusok, mint a RR, csökkentik a válaszidőt, de rendkívül
rosszul hatnak a fordulási idő méretére. Innen adódik a problémánk: Hogyan tervezhetünk
olyan ütemezőt, amely megfelel az igényeinknek anélkül, hogy bármilyen tudással bírnánk a
folyamat természetéről, általában? Hogyan tud az ütemező tanulmányozni a feladatok jellemzőit,
amelyeket indít, és így jobban döntéseket hozni az ütemezésről?
A probléma lényege: Hogyan ütemezhetünk feladatokat ideális tudás nélkül?
Hogyan fejleszthetünk olyan ütemezőt, amely egyszerre minimalizálja a válaszidőt
az interaktív feladatok számára, és ugyanakkor minimalizálja a fordulási időt anélkül, hogy előre tudnánk a feladat végrehajtási idejét?
Megjegyzés: tanulunk a korábbi eseményekből.
Az MLFQ sor egy remek példája egy olyan rendszernek, amely a
múlt eseményein tanul, hogy előre jelezze a jövőt. Az ilyen megközelítések gyakran
megtalálhatók az operációs rendszerekben (és sok más informatikai ágazatban, beleértve a
hardver- és gyorsítótár algoritmusok előrejelzéseit). Az ilyen megközelítések
akkor működnek, amikor a feladatoknak viselkedési fázisaik vannak, és így kiszámíthatók.
események, hogy előre jelezzük a jövőt. Az ilyen megközelítések gyakran
megfigyelhetők operációs rendszerekben (és sok más területen az informatikában, beleértve az ágazatokat
előrejelzések az eszközökben és a cache algoritmusokban). Az ilyen megközelítések
akkor működnek, amikor a feladatok viselkedési fázisokkal rendelkeznek, és így előrejelezhetők.
Azonban ezzel a technológiával óvatosnak kell lenni, mert a jóslatok nagyon könnyen
hibásak lehetnek, és a rendszert a legrosszabb döntések meghozatalára késztethetik, mint
ha egyáltalán nem lennének ismeretek.
MLFQ: Alapvető Szabályok
Vizsgáljuk meg az MLFQ algoritmus alapvető szabályait. Bár ennek az algoritmusnak
több megvalósítása létezik, az alapvető megközelítések hasonlóak.
Az általam tárgyalt megvalósításban az MLFQ-ban több
különböző prioritású sor lesz. Minden pillanatban
a végrehajtásra kész feladat egy sorban található. Az MLFQ prioritásokat használ
annak eldöntésére, hogy melyik feladatot indítsuk el, azaz a magasabb prioritású
(a legmagasabb prioritású sorból származó feladat) kerül elsőként
végrehajtásra.
Bizonyára egy adott sorban több feladat is található, így
egyenlő prioritással rendelkeznek. Ebben az esetben az RR mechanizmus
fogja megszervezni a feladatok végrehajtását.
Így két alapvető szabályhoz érkezünk az MLFQ-hoz:
- Szabály1: Ha prioritás(A) > prioritás(B), A feladat kerül végrehajtásra (B nem)
- Szabály2: Ha prioritás(A) = prioritás(B), A és B az RR használatával kerülnek végrehajtásra
A fentiek alapján a prioritások kulcsfontosságú elemei az MLFQ tervezésének
Ahelyett, hogy fix prioritást rendelnénk minden
feladathoz, az MLFQ a megfigyelt viselkedés alapján módosítja a prioritását.
Például, ha egy feladat folyamatosan CPU-t vár beviteli műveletre,
az MLFQ magas szinten tartja a folyamat prioritását, mivel az interaktív folyamat
így kell működjön. Ha azonban egy feladat folyamatosan és
intenzíven használja a CPU-t hosszú ideig, az MLFQ csökkenti a
prioritását. Így az MLFQ tanulmányozza a folyamatok viselkedését működésük során
és az alapján használja őket.
Rajzoljunk egy példát arra, hogyan nézhetnének ki a sorok egy adott pillanatban
és akkor valami ilyesmi lenne:
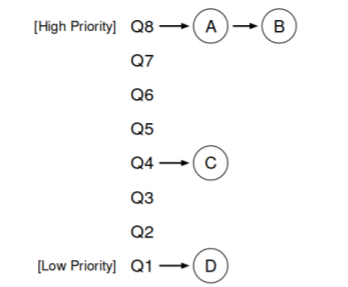
Ebben a táblázatban 2 A és B folyamat található a legmagasabb prioritású sorban. A C folyamat
valahol a középen, míg a D folyamat a sor végén található. Az MLFQ algoritmusának leírásai szerint
a tervező csak a legmagasabb prioritású feladatokat hajtja végre.
prioritás szerint RR, míg a C és D feladatok nem kapnak figyelmet.
Természetesen a statikus pillanatkép nem ad teljes képet arról, hogyan működik az MLFQ.
Fontos megérteni, hogy pontosan hogyan változik a kép az idő előrehaladtával.
Próbálkozás 1: Hogyan változtatható a prioritás
Ebben a pillanatban el kell döntenünk, hogy az MLFQ hogyan fogja változtatni a prioritási szintet
a feladatok (és így a feladat helyzete a sorban) életciklusa során. Ehhez
tartani kell észben a munkafolyamatot: bizonyos számú
interaktív feladatot rövid végrehajtási idővel (és így gyakori CPU felszabadítással)
és néhány hosszabb feladatot, amelyek teljes mértékben kihasználják a CPU-t, miközben
az ilyen feladatok esetében a válaszidő nem fontos. Így tehetjük meg az első kísérletet
az MLFQ algoritmus megvalósítására a következő szabályokkal:
- Rule3: Amikor egy feladat a rendszerbe érkezik, a legmagasabb prioritású sorba
- kerül.
- Rule4a: Ha a feladat teljes mértékben kihasználja az erre a feladatra előírt időablakot, akkor
- prioritása csökken.
- Rule4b: Ha a Feladat a CPU-t a megadott időablak lejárta előtt felszabadítja, akkor
- megmarad a korábbi prioritásán.
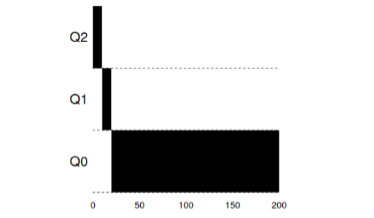
Példa 1: Egyetlen hosszútávú feladat
Ahogyan ebben a példában látható, a feladat a legmagasabb
prioritással érkezik. A 10 ms időablak után a prioritás csökken
a tervező által. A következő időablak után a feladat végül a
legalacsonyabb prioritásra csökken a rendszerben, ahol továbbra is marad.
Példa 2: Érkezik egy rövid feladat
Most nézzük meg azt a példát, ahogyan az MLFQ megpróbál közelíteni az SJF-hez. Ebben a
példában két feladat van: A, amely egy hosszú futású feladat, amely folyamatosan
kihasználja a CPU-t, és B, amely egy rövid interaktív feladat. Tegyük fel,
hogy A már dolgozott egy ideje, amikor B feladat érkezik.
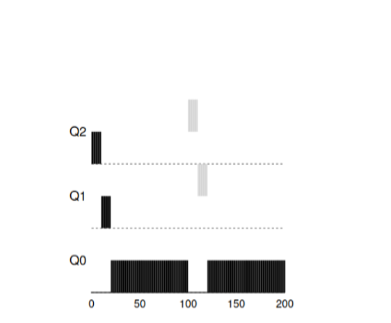
A grafikonon láthatóak a szcenárió eredményei. Az A feladat, mint bármelyik feladat,
amely használja a CPU-t, alul található. A B feladat a T=100 időpontban érkezik és
a legmagasabb prioritású sorba kerül. Mivel a végrehajtási ideje kicsi,
ezt a legutolsó sorba érés előtt befejezi.
Ebből a példából következtetni lehet a algoritmus fő céljára: mivel az algoritmus nem
tudja, hogy egy feladat hosszú vagy rövid, elsődlegesen azt feltételezi, hogy a feladat
rövid és a legmagasabb prioritást ad neki. Ha ez valóban egy rövid feladat, akkor
gyorsan elvégződik, ellenkező esetben, ha ez egy hosszú feladat, akkor lassan fog haladni
az alacsonyabb prioritás mellett, és hamarosan igazolni fogja, hogy ez valóban egy hosszú feladat, amely nem
igényel visszajelzést.
Példa 3: Mi a helyzet a bemenettel és kimenettel?
Most nézzük meg a bemenet-kimenettel kapcsolatos példát. Ahogy a 4b szabályban áll,
ha egy folyamat felszabadítja a processzort, anélkül, hogy teljesen kihasználta volna a processzori időt,
akkor az ugyanazon a prioritási szinten marad. Ennek a szabálynak a szándéka meglehetősen egyszerű
— ha egy interaktív feladat sok bemeneti kimeneti műveletet hajt végre, például várakozik
a felhasználó billentyűleütéseire vagy az egérre, egy ilyen feladat korábban felszabadítja a processzort
a kijelölt ablakból. Nem szeretnénk, ha egy ilyen feladat prioritásban lejjebb kerülne,
ezért ugyanazon a szinten marad.
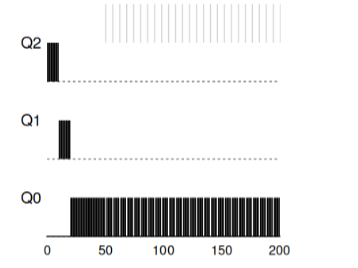
Ez a példa megmutatja, hogyan működik az algoritmus ezekkel a folyamatokkal — a B interaktív feladat, amelynek csak 1 ms-ra van szüksége a CPU-ra a bemeneti kimeneti folyamat végrehajtása előtt,
és az A hosszú feladat, amely folyamatosan használja a CPU-t.
Az MLFQ a B folyamatot a legmagasabb prioritáson tartja, mivel az folyamatosan
felszabadítja a CPU-t. Ha B egy interaktív feladat, akkor az algoritmus ebben az esetben elérte
célját, hogy gyorsan indítson interaktív feladatokat.
A jelenlegi MLFQ algoritmus problémái
Az előző példákban egy alapvető MLFQ modellt építettünk. És úgy tűnik, hogy jól és tisztességesen működik,
igazságosan osztva a processzori időt a hosszú feladatok között, és lehetővé téve a rövid feladatok számára, vagy azok számára, amelyek intenzíven használják
a bemeneti kimenetet, hogy gyorsan dolgozhassanak. Sajnos, ez a megközelítés néhány
komoly problémát tartalmaz.
, az éhség problémája: ha a rendszerben sok interaktív
Először isfeladat van, akkor ezek el fogják fogyasztani az összes processzori időt, így egyik hosszú
feladat sem fog lehetőséget kapni a végrehajtásra (éheznek).
, okos felhasználók képesek lennének úgy írni programjaikat, hogy
Secondlyátverjék az ütemezőt. Az átverés lényege, hogy valamit úgy csináljanak, hogy
az ütemező több processzori időt adjon a folyamatnak. Az algoritmus, amely
ütemező, hogy több processzorkapacitást biztosítson a folyamata számára. Az algoritmus, amely
a fent említett módszer teljesen sebezhető az ilyen támadásokkal szemben: mielőtt a időablak szinte
lejárna, végre kell hajtani egy bemeneti-kimeneti műveletet (akárhol, teljesen mindegy, melyik fájlon)
és így szabaddá tenni a CPU-t. Az ilyen viselkedés lehetővé teszi, hogy ugyanabban
a sorban maradjunk, és ismét nagyobb százalékos arányt kapjunk a processzori időből. Ha ezt
helyesen végezzük el (például, 99%-ban végrehajtva az időablakot a CPU felszabadítása előtt),
akkor a feladat egyszerűen monopolizálhatja a processzort.
Végül a programok idővel megváltoztathatják a viselkedésüket. Azok a feladatok,
amelyek CPU-t használtak, interaktívvá válhatnak. A példánkban az ilyen
feladatok nem fognak megfelelő bánásmódban részesülni a ütemezőtől, mintha más,
(eredeti) interaktív feladatokat kaptak volna.
Kérdés a teremben: milyen támadásokat lehetett végrehajtani a ütemező ellen a modern világban?
2. Kísérlet: Prioritás emelése
Próbáljuk meg megváltoztatni a szabályokat, és nézzük meg, sikerül-e elkerülni a
éhezést. Mit tehetnénk annak érdekében, hogy garantáljuk, hogy a CPU-hoz kapcsolódó
feladatok megkapják az idejüket (még ha nem is hosszú ideig).
Egyszerű megoldásként arra a problémára javasolt, hogy időnként
emeljük meg minden ilyen feladat prioritását a rendszerben. Számos módja van ennek
elérésére, próbáljunk ki egy egyszerű példát: minden feladatot azonnal a legmagasabb
prioritásra állítani, innen az új szabály:
- Szabály5: Egy bizonyos S idő elteltével az összes feladatot a rendszerben a legmagasabb sorba helyezni.
Új szabályunk két problémát is egy csapásra megold. Először is, a folyamatok
garantáltan nem éheznek: azok a feladatok, amelyek a legmagasabb sorban vannak, a RR algoritmus alapján
osztják el a processzoridőt, így minden folyamat megkapja a processzoridőt. Másodszor, ha bármelyik
folyamat, amely korábban csak a processzort használta, interaktívvá válik, akkor a legmagasabb
prioritású sorban fog maradni, miután egyszer már megkapta a legmagasabb prioritású emelést.
Nézzünk meg egy példát. Ebben a forgatókönyvben vegyünk egy olyan folyamatot, amely
használ
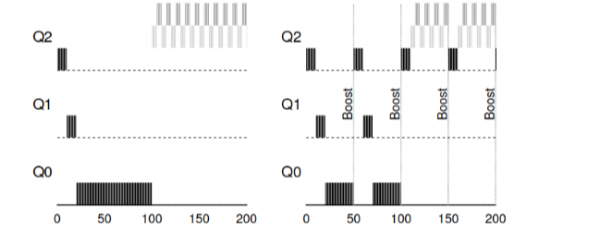
CPU és két interaktív, rövid folyamat. A bal oldalon a kép azt mutatja, hogy az előnyben részesítés nélküli viselkedés hogyan működik, így a hosszú feladat éhezni kezd, miután a rendszerbe két interaktív feladat érkezik. A jobb oldalon a prioritás 50 ms-onként emelkedik, így minden folyamat garantáltan kap processzoridőt és időszakosan elindul. A 50 ms itt példaként van megadva, a valóságban ez a szám kissé magasabb.
Nyilvánvaló, hogy az S periódikus emelési idő hozzáadása vezet a
kérdésekhez: milyen értéket kellene beállítani? Egy elismert
rendszermérnök, John Ousterhout, ilyen nagyságokat voo-doo
konstansnak nevezett, mivel bizonyos értelemben fekete mágiát követeltek a helyes
beállításhoz. És sajnos, az S-nek ilyen íze van. Ha túl magasra állítjuk az értéket,
a hosszú feladatok éhezni fognak. Ha pedig túl alacsonyra állítjuk,
az interaktív feladatok nem kapják meg a megfelelő processzoridőt.
Kísérlet 3: A legjobb nyilvántartás
Most egy újabb problémánk van, amelyet meg kell oldani: hogyan ne
engedjük meg, hogy a tervezőnket becsapják? Az ezt lehetővé tevő
4a, 4b szabályok felelősek, amelyek lehetővé teszik a feladat számára, hogy megtartja a prioritását, miközben a processzort
felszabadítja a kijelölt idő letelte előtt. Hogyan küzdjünk meg ezzel?
A megoldás ebben az esetben a CPU idő legjobb nyilvántartásának
alkalmazása minden MLFQ szinten. Ahelyett, hogy elfelejtenénk, mennyi időt használt el a program
a processzor alatt az adott időszak alatt, figyelembe kell venni és megtartani azt. Miután
a folyamat felhasználta a rá kijelölt időt, prioritását le kell csökkenteni a következő
prioritási szintre. Most már noha a folyamat hogyan használja az idejét — akár
folyamatosan számít a processzoron, akár több hívásként. Így
az 4es szabályt a következőképpen kell átírni:
- Rule4: Miután a feladat felhasználta a rá kijelölt időt a jelenlegi sorban (függetlenül attól, hogy hányszor szabadította fel a CPU-t), ennek a feladatnak a prioritása csökken (lelép a sorból).
Nézzünk egy példát:
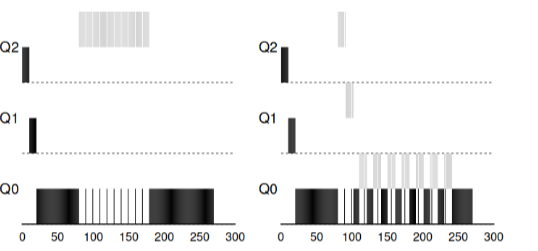 »
A képen látható, mi történik, ha megpróbáljuk megtéveszteni a tervezőt, hogyan
ha a korábbi 4a, 4b szabályokkal valósult volna meg, az eredmény balra lett volna. Az új szabály mellett - az eredmény jobbra. A védelem előtt bármilyen folyamat okozhatott I/O-t a befejezés előtt, és
így dominálhatott a CPU-n, a védelem aktiválása után pedig, függetlenül a viselkedéstől, az I/O továbbra is sorban hátra fog kerülni, és így nem tudja tisztességtelenül
elfoglalni a CPU erőforrásait.
Javítva az MLFQ-t és egyéb problémákat
A fent említett fejlesztésekkel új problémák merülnek fel: az egyik legfontosabb
kérdés az, hogy hogyan paraméterezhessünk egy ilyen tervezőt? Tehát, hány sor legyen? Mekkora legyen a program futási ablaka a soron belül? Milyen gyakran kell emelni a program prioritását, hogy elkerüljük az éhezést és
figyelembe vegyük a program viselkedésének változását? Ezekre a kérdésekre nincsen egyszerű
válasz, és csak a terhelésekkel végzett kísérletek és a tervező későbbi konfigurálása vezethet valami kielégítő egyensúlyhoz.
Például, a legtöbb MLFQ implementáció lehetővé teszi, hogy különböző
időtartamokat rendeljünk különböző sorokhoz. A magas prioritású sorok általában
rövid időtartamokat kapnak. Ezek a sorok interaktív feladatokból állnak,
amelyek közötti váltás elég érzékeny, és 10 ms vagy kevesebb időt igényel. Ezzel szemben, az alacsony prioritású sorok hosszú feladatokat tartalmaznak, melyek CPU-t használnak.
Ebben az esetben a hosszú időtartamok nagyon jól megfelelnek (100 ms).
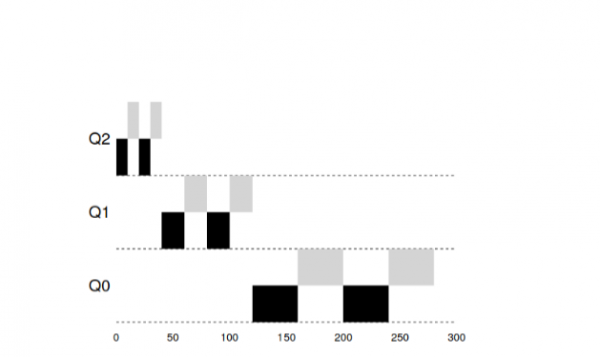
Ebben a példában 2 feladat futott a magas prioritású sorban 20
ms-ig, 10 ms-enkénti ablakokra bontva. 40 ms az átlagos sorban (20 ms-os ablak) és az alacsony prioritású
sorban az időtartam 40 ms-ra nőtt, ahol a feladatok befejezték a munkájukat.
Az MLFQ implementációja a Solaris OS-ben - egy osztályú tervező, amely időmegosztást alkalmaz.
A tervező egy sor táblázatot biztosít, amelyek pontosan meghatározzák, hogy hogyan kell
változnia a folyamat prioritásának élete során, mekkora legyen az allokált ablak mérete és milyen gyakran kell emelni a feladat prioritását. A rendszeradminisztrátor
interakcióba léphet ezzel a táblázattal, és kényszerítheti a tervezőt eltérő módon viselkedni.
Alapértelmezetten ebben a táblázatban 60 sor van, fokozatosan növekvő
ablakmérettel 20 ms (magas prioritás) és több száz ms (alacsony prioritás) között.
A MLFQ megvalósítása a Solaris operációs rendszerben — az időbeli ütemezők klasszikus típusa.
Az ütemező egy sor táblát biztosít, amelyek pontosan meghatározzák, hogyan kell
változtatni a folyamat prioritását az élete során, mekkora legyen a mérete
a kiosztott ablaknak és milyen gyakran kell emelni a feladatok prioritását. Az adminisztrátor
interakcióba léphet ezzel a táblázattal, és kényszerítheti az ütemezőt arra, hogy másképp viselkedjen.
Alapértelmezés szerint ebben a táblázatban 60 sor van, fokozatosan növekvő
ablakmérettel 20 ms-tól (magas prioritás) néhány száz ms-ig (alacsony prioritás), és
szintén minden feladatot másodpercenként megnövelve.
Más MLFQ ütemezők nem használnak táblázatot vagy valamilyen konkrét
szabályt, ami ebben az előadásban van leírva, ehelyett prioritásokat számítanak ki
matematikai képletek segítségével. Például a FreeBSD ütemezője egy képletet használ a
aktuális prioritás kiszámításához, figyelembe véve, hogy mennyi CPU-t használt a folyamat.
Továbbá, a CPU használat az idő múlásával csökken, így a
prioritás növelése kissé eltérően történik, mint ahogy fent leírtuk. Ezek a
ún. decay algoritmusok. A FreeBSD 7.1-es verziójától kezdődően ULE ütemezőt használnak.
Végül, sok ütemezőnek vannak más jellemzői is. Például néhány
ütemező a legmagasabb szinteket fenntartja az operációs rendszer számára, így
nincs felhasználói folyamat, amely a legmagasabb prioritást kapná a
rendszerben. Néhány rendszer lehetővé teszi, hogy tanácsokat adjunk az ütemezőnek,
hogy segítsük a prioritások helyes beállításában. Például a parancs segítségével kellemes
növelhetjük vagy csökkenthetjük egy folyamat prioritását, ezzel növelve vagy
csökkentve a program processzoraidőre való esélyeit.
MLFQ: Összefoglalás
Leírtuk az MLFQ néven ismert ütemezési megközelítést. A neve
abban az elvben rejlik, hogy több sorral rendelkezik és visszajelzést használ
a feladat prioritásának meghatározásához.
A szabályok végső formája a következő lesz:
- Rule1: Ha prioritás(A) > prioritás(B), akkor A feladat fut (B nem)
- Rule2: Ha prioritás(A) = prioritás(B), A és B RR használatával futnak
- Rule3: Amikor a feladat bekerül a rendszerbe, a legmagasabb prioritású sorba kerül.
- Rule4: Miután a feladat felhasználta a rá kijelölt időt a jelenlegi sorban (függetlenül attól, hogy hányszor szabadította fel a CPU-t), ennek a feladatnak a prioritása csökken (lelép a sorból).
- Szabály5: Egy bizonyos S idő elteltével az összes feladatot a rendszerben a legmagasabb sorba helyezni.
Az MLFQ érdekessége, hogy nem követeli meg a feladat természetének
előzetes ismeretét, a algoritmus a feladat korábbi viselkedését tanulmányozza és állítja
be a prioritásokat ennek megfelelően. Így próbálja meg egyszerre a két székben ülni –
a kis feladatok (SJF, STCF) teljesítményét elérni és méltányosan futtatni a hosszú,
CPU-t igénylő feladatokat. Éppen ezért sok rendszer, beleértve a BSD-t és azok
ágaikat, a Solaris-t, a Windows-t és a Mac-et is, valamilyen formáját használja az MLFQ
További anyagok:
- en.wikipedia.org/wiki/Scheduling_
Forrás: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish