

A mikroszervizes architektúra, akárcsak minden a világon, rendelkezik előnyökkel és hátrányokkal. Egyes folyamatok egyszerűbbé válnak, mások bonyolultabbá. Az átalakulás sebessége és a jobb skálázhatóság érdekében áldozatokat kell hozni. Az egyik ilyen áldozat a háttérben lévő analitika bonyolultsága. Ha a monolitikus rendszerben az operatív analitikát csupán SQL lekérdezésekre lehet csökkenteni az analitikai replikához, akkor a multiszervizes architektúrában minden szolgáltatásnak megvan a saját adatbázisa, és úgy tűnik, hogy egyetlen lekérdezéssel nem lehet megoldani a helyzetet (vagy mégis?). Akik érdeklik, hogyan oldottuk meg az operatív analitika problémáját a vállalatunknál, és hogyan tanultunk meg együtt élni ezzel a megoldással — üdvözöljük.
A nevem Pavel Sivash, a DomClicknél dolgozom azon a csapatban, amely az analitikai adatcsoport fenntartásáért felelős. Tevékenységünket meg lehetne határozni, mint adat-informatikai mérnökséget, de valójában a feladatkörök sokkal szélesebb spektrumot ölelnek fel. Vannak standard adat-informatikai feladatok, mint például az ETL/ELT, az adatelemző eszközök támogatása és adaptálása, valamint a saját eszközeink fejlesztése. Különösen az operatív jelentésekhez úgy döntöttünk, hogy „eljátszuk”, hogy nekünk monolitunk van, és egy adatbázist adunk az elemzőknek, amelyben minden szükséges adat megtalálható.
Tényleg, különféle lehetőségeket fontolgattunk. Fel lehetett volna építeni egy teljes értékű tárolót – meg is próbáltuk, de őszintén szólva, nem sikerült jól összehangolni a viszonylag gyakori logikai változásokkal a tároló építésének és az abba való változtatásoknak a viszonylag lassú folyamatát (ha valakinek sikerült, kérem írja meg a kommentekben, hogyan). Mondhattuk volna az elemzőknek: "Figy srácok, tanuljatok meg python-t és menjetek az analitikai replikákhoz", de ez plusz követelmény a munkaerő kiválasztásához, és úgy tűnt, hogy ezt érdemes lenne elkerülni, ha lehetséges. Úgy döntöttünk, hogy megpróbáljuk használni a FDW (Foreign Data Wrapper) technológiát: lényegében ez egy standard dblink, amely megtalálható a SQL szabványban, de sokkal kényelmesebb interfésszel. Ennek alapján készítettünk egy megoldást, ami végül bevált, ezen álltunk meg. Ennek részletei egy külön cikk témája, talán több is, mivel sok mindent szeretnék elmondani: az adatbázis sémák szinkronizálásától kezdve a hozzáférés kezeléséig és a személyes adatok anonimizálásáig. Ezen kívül szükséges megjegyezni, hogy ez a megoldás nem helyettesíti a valódi analitikai adatbázisokat és tárolókat, csupán egy konkrét feladatot old meg.
Magas szinten ez így néz ki:
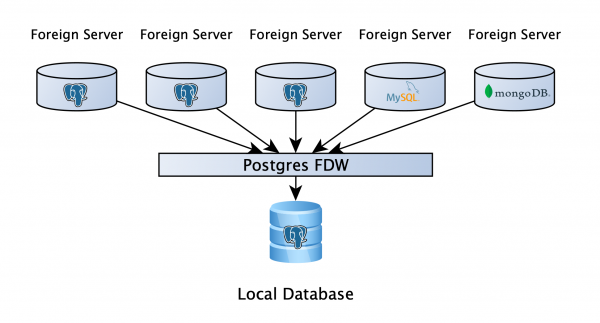
Van egy PostgreSQL adatbázis, ahol a felhasználók tárolhatják a munkaadatokat, és ami a legfontosabb – ez az adatbázis FDW-n keresztül csatlakozik az összes szolgáltatás analitikai replikáihoz. Ez lehetővé teszi, hogy lekérdezéseket írjunk több adatbázishoz, függetlenül attól, hogy ez PostgreSQL, MySQL, MongoDB vagy bármi más (fájl, API, ha véletlenül nincs megfelelő wrapper, írhatunk sajátot). Nos, ezek szerint minden rendben van, szuper! Oszoljunk?
Ha minden ilyen gyorsan és egyszerűen végződött volna, valószínűleg nem is lett volna cikk.
Fontos világosan megérteni, hogy a PostgreSQL hogyan kezeli a lekérdezéseket távoli szerverekhez. Ez logikusnak tűnik, de gyakran nem figyelnek rá: a PostgreSQL a lekérdezést részletekre bontja, amelyeket a távoli szervereken függetlenül hajtanak végre, összegyűjti ezeket az adatokat, és a végső számításokat már önállóan végzi, ezért a lekérdezés végrehajtásának sebessége nagyban függ attól, hogyan írják meg. Meg kell jegyezni azt is: amikor az adatok egy távoli szerverről érkeznek, már nincsenek indexek, nincs semmi, ami segítené a tervezőt, így csak mi tudunk neki segíteni és útmutatót adni. Pontosan erről szeretnék részletesebben beszélni.
Egyszerű lekérdezés és a hozzá tartozó terv
Ahhoz, hogy megmutassuk, hogyan hajt végre a PostgreSQL lekérdezést egy 6 milliós soros táblán távoli szerveren, nézzük meg az egyszerű tervet.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
A VERBOSE utasítás használatával láthatjuk a lekérdezést, amely a távoli szerverre kerül küldésre és az eredmények, amelyeket a további feldolgozáshoz kapunk (RemoteSQL sor).
Menjünk tovább, és adjunk hozzá a lekérdezésünkhöz néhány szűrőt: egyet egy boolean mezőn, egyet egy tartományon belül, és egyet timestamp a meta egyenlőség alapján. jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Itt rejlik az a pont, amelyre figyelmet kell fordítani a lekérdezések írásakor. A szűrők nem kerültek át a távoli szerverre, ami azt jelenti, hogy a PostgreSQL az összes 6 millió sort ki kell nyernie a végrehajtáshoz, hogy aztán helyben szűrhessük (Filter sor) és aggregálhassuk. A siker kulcsa, hogy a lekérdezést úgy írjuk meg, hogy a szűrők átkerüljenek a távoli gépre, és mi csak a szükséges sorokat kapjuk és aggregáljuk.
Ez már elég bolond dolog
A boolean típusokkal minden egyszerű. Az alap lekérdezésben a probléma az operátor miatt merült fel, is. Ha ezt kicseréljük =, akkor a következő eredményt kapjuk:
magyarázd el, elemezd részletesen
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 hónap'
AND CURRENT_DATE - INTERVAL '6 hónap'
AND meta->>'source' = 'test';

Összesített (költség=508010.14..508010.15 sorok=1 szélesség=8) (valós idő=19064.314..19064.314 sorok=1 ciklus=1)
  Kimenet: count(1)
  ->  Külső lekérdezés fdw_schema."table"  (költség=100.00..507988.44 sorok=8679 szélesség=0) (valós idő=33.035..18951.278 sorok=1360025 ciklus=1)
        Kimenet: "table".id, "table".is_active, "table".meta, "table".created_dt
        Szűrő: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 hónap'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 hónap'::interval)))
        Szűrő által eltávolított sorok: 3567989
        Távoli SQL: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Tervezési idő: 0.834 ms
Végrehajtási idő: 19064.534 ms
Ahogy látja, a szűrő egy távoli szerverre került, és a végrehajtási idő 27 másodpercről 19 másodpercre csökkent.
Érdemes megjegyezni, hogy a művelet is különbözik a művelettől = abban, hogy képes kezelni a Null értéket. Ez azt jelenti, hogy is not True a szűrőben megőrzi a False és Null értékeket, míg != True csak a False értékeket hagyja meg. Ezért, amikor a műveletet is not helyettesítjük, két feltételt kell átadni a szűrőben OR operátorral, például, WHERE (col != True) OR (col is null).
A boolean értékekkel tisztában vagyunk, lépjünk tovább. De először visszaállítjuk a logikai érték szűrőt az eredeti állapotába, hogy függetlenül megvizsgálhassuk a többi változás hatását.
timestamptz? hz
Valójában gyakran kísérleteznünk kell azzal, hogyan írjunk meg egy lekérdezést, amely távoli szervereket érint, és csak utána keresünk magyarázatot, hogy miért történik éppen így. Nagyon kevés információt találhatunk erről az interneten. Az kísérletek során észrevettük, hogy a rögzített dátum szűrője zavartalanul működik a távoli szerveren, míg amikor dinamikusan akarunk dátumot megadni, például now() vagy CURRENT_DATE, az nem történik meg. A példánkban olyan szűrőt adtunk hozzá, hogy a created_at oszlop pontosan egy hónappal korábbi adatokat tartalmazzon (BETWEEN CURRENT_DATE - INTERVAL '7 hónap' AND CURRENT_DATE - INTERVAL '6 hónap'). Mit tettünk ebben az esetben?
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt >'source' = 'test';

Aggregate  (cost=306875.17..306875.18 rows=1 width=8) (actual time=4789.114..4789.115 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.007..0.008 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..306874.86 rows=105 width=0) (actual time=23.475..4681.419 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text))
        Rows Removed by Filter: 76934
        Remote SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Planning time: 0.703 ms
Execution time: 4789.379 ms
A tervezőnek előre jeleztük, hogy számolja ki a dátumot a lekérdezésben, és már egy kész változót adjunk át a szűrőben. Ez a javaslat rendkívüli eredményt hozott, a lekérdezés majdnem hatszor gyorsabb lett!
Ismét fontos, hogy figyeljünk: az alsó lekérdezés adattípusa ugyanaz kell, hogy legyen, mint a szűréshez használt mezőé, különben a tervező úgy dönt, hogy mivel az adattípusok eltérnek, először az összes adatot le kell hozni, majd helyben szűrjük.
Visszaállítjuk a dátum szűrőt az eredeti értékre.
Freddy vs. Jsonb
Egyébként a logikai mezők és a dátumok már kellően felgyorsították a lekérdezésünket, azonban még mindig volt egy másik adattípus. A szűrési küzdelem még mindig nem zárult le, bár itt is vannak sikerek. Íme, így sikerült átadni a szűrőt a jsonb mező a távoli szerverre.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=245463.60..245463.61 rows=1 width=8) (actual time=6727.589..6727.590 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=1100.00..245459.90 rows=1478 width=0) (actual time=16.213..6634.794 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.747 ms
Execution time: 6727.815 ms
A szűrőoperátorok helyett a meglét-operátort kell használni. jsonb más módban. 7 másodperc a korábbi 29 helyett. Ez eddig az egyetlen sikeres megoldás a szűrők átadására jsonb egy távoli szerverre, de itt fontos figyelembe venni egy korlátozást: a 9.6-os adatbázis verziót használjuk, azonban április végéig tervezünk befejezni az utolsó teszteket, és átállni a 12-es verzióra. Amint frissítünk, beszámolunk arról, hogy ez hogyan befolyásolta, hiszen számos, nagy reményekkel várt változás jön: json_path, új CTE viselkedés, push down (amely a 10-es verzió óta létezik). Nagyon szeretnénk mielőbb kipróbálni.
Fejezd be őt
Megvizsgáltuk, hogy minden egyes változás hogyan hat az egyes lekérdezések sebességére. Most nézzük meg, mi történik, amikor mindhárom szűrőt helyesen írják.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Igen, a lekérdezés bonyolultabbnak tűnik, ez egy kényszerű áldozat, de a végrehajtási idő 2 másodperc, ami több mint tízszer gyorsabb! És erről egy egyszerű lekérdezésről beszélünk, viszonylag kis adathalmazon. Valós lekérdezéseknél akár több százszoros növekedést is tapasztaltunk.
Összegzésül: ha PostgreSQL-t használsz FDW-vel, mindig ellenőrizd, hogy az összes szűrő a távoli szerverre jut-e el, és boldog leszel... Legalábbis, amíg el nem éred a különböző táblák közötti joinokat szerverek. De ez már egy újabb cikk története.
Köszönöm a figyelmet! Örömmel várom a kérdéseidet, megjegyzéseidet, valamint a tapasztalataidat a megjegyzések között.
Forrás: habr.com
