

A jelentés a Kubernetes-ben történő operátorfejlesztés gyakorlati kérdéseinek, architektúrájának megtervezésének és alapvető működési elveinek szentelhető.
A beszámoló első részében a következőket vizsgáljuk:
- mi az operátor a Kubernetes-ben és miért van rá szükség;
- hogyan egyszerűsíti az operátor a bonyolult rendszerek kezelését;
- mit tud az operátor, és mit nem tud az operátor.
Ezt követően áttérünk az operátor belső felépítésének megvitatására. Lépcsőzetesen megvizsgáljuk az operátor architektúráját és működését. Részletesen elemezzük:
- az operátor és a Kubernetes közötti interakciót;
- milyen funkciókat vállal magára az operátor, és mi az, amit a Kubernetes-re delegál.
Megvizsgáljuk a shardok és DB replikák kezelését a Kubernetes-ben.
Ezt követően adatkezelési kérdéseket vitatunk meg:
- hogyan kell Persistent Storage-t kezelni az operátor szemszögéből;
- a helyi tárolás használatának buktatói.
A beszámoló záró részében gyakorlati példákat fogunk megvizsgálni a Az Amazon vagy Google Cloud Service esetében. A beszámoló a ClickHouse operátor fejlesztésének és üzemeltetésének tapasztalatain alapul.
Videó:
A nevem Vlagyimir Klimenko. Ma szeretném megosztani a ClickHouse adatbázis klaszterek kezelésére specializálódott operátorunk fejlesztéséről és üzemeltetéséről szerzett tapasztalatainkat. A példáján keresztül a ClickHouse klaszter kezelésére.
Miért van lehetőségünk az operátorról és a ClickHouse-ról beszélni?
- A ClickHouse támogatásával és fejlesztésével foglalkozunk.
- Jelenleg fokozatosan próbálunk hozzájárulni a ClickHouse fejlesztéséhez. A változtatások mértékét tekintve másodikak vagyunk a Yandex után a ClickHouse-ban.
- Törekszünk további projekteket létrehozni a ClickHouse ökoszisztémához.
Egy ilyen projektről szeretnék beszámolni. Ez a Kubernetes számára készült ClickHouse-operator.
A beszámolóm során két témát szeretnék érinteni:
- Az első téma – az, hogy operátorunk hogyan működik a ClickHouse adatbázisok kezelésében a Kubernetes-ben.
- A második téma – a bármilyen operátor működése, azaz hogyan interakcióba lép a Kubernetes-szel.
Ezek a két kérdés a teljes előadásom során keresztezik egymást.
Kinek lehet érdekes az, amit próbálok elmondani?
- Leginkább azoknak lesz érdekes, akik operátorokat üzemeltetnek.
- Vagy azoknak, akik sajátot szeretnének készíteni, hogy megértsék, hogyan működik belülről, hogyan lép kölcsönhatásba az operátor a Kubernetes-szel és milyen buktatók merülhetnek fel.
Ahhoz, hogy jobban megértsük, amiről ma beszélni fogunk, hasznos lenne tudni, hogyan működik a Kubernetes, és rendelkezni egy alapvető felkészültséggel a felhőtechnológiák terén.
Mi az a ClickHouse? Ez egy oszlop alapú adatbázis, amely az analitikai lekérdezések online feldolgozására specializálódott. Ráadásul teljesen nyílt forráskódú.
Két dolgot kell tudnunk. Először is, tudnunk kell, hogy ez egy adatbázis, ezért az, amiről beszélni fogok, gyakorlatilag bármely adatbázisra alkalmazható. Másodszor, a ClickHouse DBMS nagyon jól skálázódik, szinte lineáris skálázhatóságot biztosít. Éppen ezért a klaszter állapota a ClickHouse esetében természetes állapot. A legérdekesebb a ClickHouse klaszter Kubernetes alatti karbantartása.
Miért van szükség rá ott? Miért nem folytathatjuk az önálló üzemeltetést? A válasz részben technikai, részben szervezeti.
- A gyakorlatban egyre gyakrabban találkozunk olyan helyzetekkel, amikor a nagyvállalatokban már gyakorlatilag minden komponens a Kubernetesben található. Csak az adatbázisok maradtak kívül.
- Egyre többen teszik fel a kérdést: "Lehet ezt belülre is helyezni?". Ezért a nagyvállalatok arra törekednek, hogy a kezelés maximális egységesítése érdekében gyorsan tudják kezelni adatbázisaikat.
- Ez különösen segít, ha szükség van a maximális lehetőségre, hogy ugyanazt egy új helyen reprodukálhassuk, azaz maximális hordozhatóságra.
Mennyire egyszerű vagy bonyolult ez? Természetesen kézzel is megtehető. De nem olyan egyszerű, mert a Kubernetes kezelésének nehézségei összeadódnak a ClickHouse sajátosságaival. Így egyfajta aggregáció jön létre.
Ez együtt olyan nagyszámú technológiát eredményez, amelynek kezelése már elég nehézkessé válik, mivel a Kubernetes saját napi üzemeltetési kérdéseket hoz, míg a ClickHouse saját napi üzemeltetési problémákat hoz. Különösen, ha több ClickHouse-unk van, és folyamatosan tenni kell velük valamit.
A ClickHouse-dinamikus konfigurációjával több kérdés is felmerül, amelyek állandó terhet jelentenek a DevOps számára:
- Amikor valamit meg akarunk változtatni a ClickHouse-ban, például replikát vagy shardot szeretnénk hozzáadni, a konfiguráció kezelését kell elvégeznünk.
- Ezután módosítani kell az adatmodellt, mivel a ClickHouse specifikus módszerrel végzi a shardolást. Az adatmodellt és a konfigurációkat szétszórva kell elhelyezni.
- Be kell állítani a monitoringot.
- A naplózási rendszer beállítása az új shardokhoz és replikákhoz.
- Gondoskodni kell a helyreállításról.
- És az újraindításról.
Ezek olyan rutin munkák, amelyeket nagyon szeretnénk megkönnyíteni a használat során.
Magának a Kubernetesnek valóban segít a használat során, de alapvető rendszerszintű dolgokban.
A Kubernetes jól segíti és automatizálja az olyan feladatokat, mint:
- Helyreállítás.
- Újraindítás.
- A tároló rendszer kezelését.
Ez jó, ez a helyes irány, de teljesen nincs tisztában azzal, hogyan kell működtetni az adatbázis klasztert.
Többre vágyunk, szeretnénk, ha az egész adatbázisunk Kubernetesben működne.
Olyasmit szeretnénk, mint egy nagy, varázslatos piros gomb, amelyet megnyomsz, és elindul egy klaszter, amelyet az életciklusa során támogatnak, a napi feladatokkal, amiket meg kell oldani. ClickHouse klaszter Kubernetesben.
Próbáltunk egy olyan megoldást kidolgozni, amely segítene megkönnyíteni a munkát. Ez a ClickHouse-operator Kuberneteshez az Altinity-től.
Az operator egy program, amelynek fő feladata más programok kezelése, azaz ő a menedzser.
Tartalmaz magatartási sablonokat is. Ezt a szakterületről kódolt tudásnak lehet nevezni.
Fő feladata az, hogy megkönnyítse a DevOps életét és csökkentse a mikromenedzsmentet, hogy ő (a DevOps) már magas szintű területeken gondolkodjon, azaz ne kelljen minden részletet kézzel konfigurálni.
Az operator éppen egy segítő robot, amely a mikrotasks elleni küzdelemben segít a DevOps-nak.
Mire való az operator? Különösen két kérdésben bizonyítja az értékét:
- Amikor a ClickHouse-szal foglalkozó szakembernek nincs elegendő tapasztalata, de már szükség van a ClickHouse üzemeltetésére, az operator megkönnyíti az üzemeltetést, és lehetővé teszi a ClickHouse klaszter elég bonyolult konfigurációban való működtetését, anélkül, hogy túlzottan belemerülnénk abba, hogyan működik mindez belül. Egyszerűen adsz neki magas szintű feladatokat, és ez működik.
- A második feladat, amelyben a legjobban teljesít, az, amikor egy nagy mennyiségű tipikus feladat automatizálására van szükség. Leválasztja a mikrofokozatokat a rendszergazdákról.
Ez leginkább azoknak hasznos, akik csak kezdik a pályájukat, vagy azoknak, akik sokat foglalkoznak automatizálással.
Mi a különbség az operátorok alapú megközelítés és más rendszerek között? Ott van például a Helm. Az is segít telepíteni a ClickHouse-t, lehet rajzolni helm chartokat, amelyek akár egy teljes ClickHouse klasztert is telepítenek. Mi tehát a különbség az operátor és például a Helm között?
A fő, alapvető különbség az, hogy a Helm - ez csomagkezelés, míg az operátor tovább lép. Ez az egész életciklus támogatása. Nem csak a telepítés, hanem a napi feladatok is, melyek közé tartozik a méretezés, a shardolás, tehát minden, amit az életciklus során végre kell hajtani (ha szükséges, akkor a törlés is) – ezt mind az operátor oldja meg. Ő próbálja automatizálni és fenntartani az összes szoftver életciklusát. Ez a fundamentális különbség más megoldásokhoz képest, amelyek elérhetőek.
Ez volt az intro rész, lépjünk tovább.
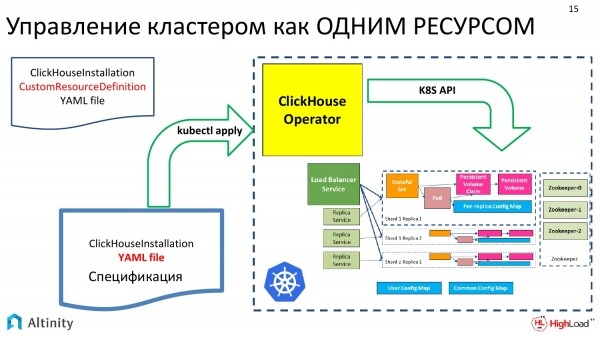
Hogyan építjük fel az operátorunkat? Megpróbálunk úgy közelíteni a kérdéshez, hogy a ClickHouse klasztert egyetlen erőforrásként kezeljük.
Itt a bal oldalon az input adatok találhatóak. Ez egy YAML a klaszter specifikációjával, amelyet klasszikus módon a kubectl-en keresztül küldenek a Kubernetesbe. Itt az operátor ezt lefogja, végrehajtja a varázslatát, és a kimeneten így néz ki a séma. Ez a ClickHouse implementáció Kubernetesben.
És ezután lassan megnézzük, pontosan hogyan működik az operátor, milyen tipikus feladatokat lehet megoldani. Csak tipikus feladatokat fogunk áttekinteni, mivel korlátozott időnk van. Nem mindenről fogunk beszélni, amit az operátor meg tud oldani.
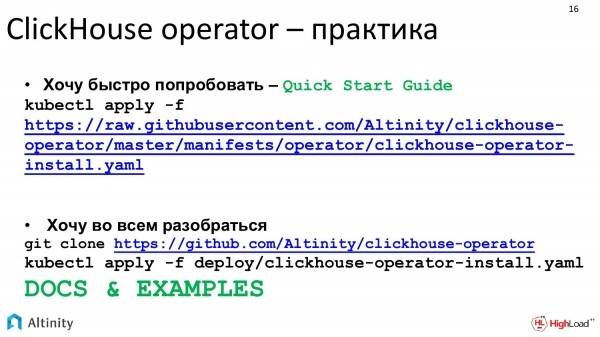
Lépjünk a gyakorlatra. A projektünk teljesen open source, ezért megnézheted a GitHub-on, hogy működik. És abból a szempontból is lehet indulni, hogy ha csak el akarod indítani, akkor a Quick Start Guide alapján kezdhetsz.
Ha pedig részletesebben szeretnél foglalkozni, igyekszünk a dokumentációt viszonylag jó állapotban tartani.
Kezdjük egy gyakorlati feladattal. Az első feladat, amivel mindannyian szeretnénk kezdeni, az, hogy elindítsuk az első példát valahogy. Hogyan indíthatjuk el a ClickHouse-t egy operátor segítségével, anélkül hogy igazán tudnánk, hogyan működik? Készítünk egy manifesztumot, mivel minden kommunikáció a k8s-szel manifesztumokon keresztül történik.
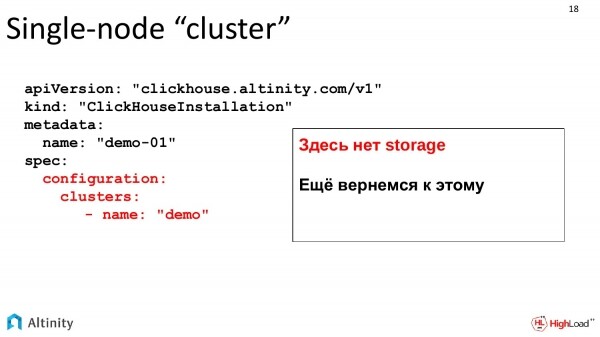
Itt van egy ilyen bonyolult manifesztum. Az, ami pirossal van kiemelve, az, amire fókuszálni kell. Kérjük az operátort, hogy hozzon létre egy demo nevű klasztert.
Eddig ezek alap példák. A tároló még nincs leírva, de a tárolóra később visszatérünk. Egyelőre a klaszter fejlődését fogjuk figyelemmel kísérni.
Létrehoztuk ezt a manifesztumot. Átadjuk azt az operátorunknak. Ő dolgozik rajta, varázsol.
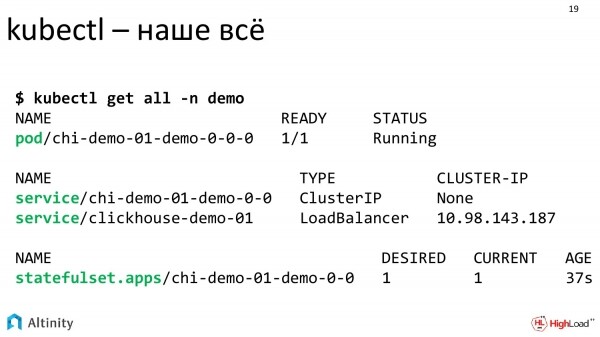
Nézzük a konzolon. Három komponens hívja fel a figyelmet – ez a Pod, két Szolgáltatás és a StatefulSet.
Az operátor végzett a feladatával, és megnézhetjük, pontosan mit hozott létre.
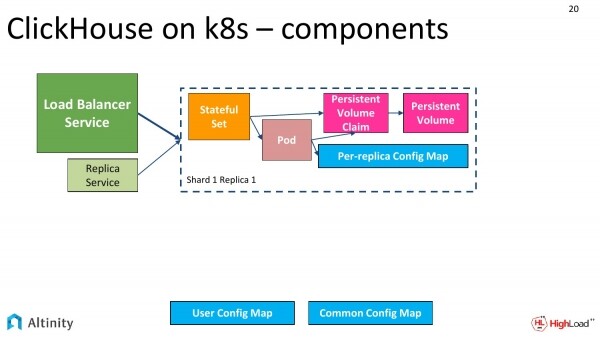
Olyan sémát hoz létre, mint ez. Van StatefulSet, Pod, ConfigMap minden replikához, ConfigMap az egész klaszthoz. Különösen fontosak a szolgáltatások mint belépési pontok a klaszterbe.
A szolgáltatások a központi Load Balancer szolgáltatás, és lehet még minden replikához, minden shardhoz is.
Alapvetően a klaszterünk körülbelül így néz ki. Ez egyetlen node-ból áll.
Haladjunk tovább, bonyolítsuk a dolgokat. A klasztert shard-olni kell.
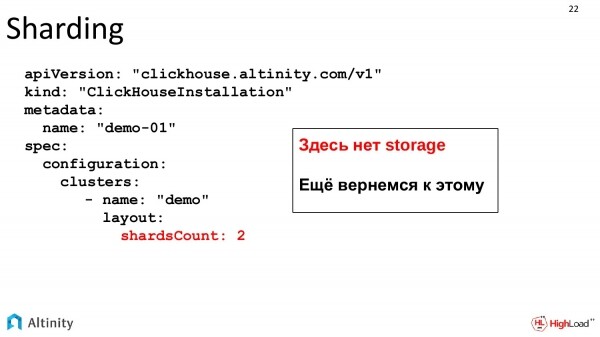
A feladataink növekednek, elkezdődik a dinamika. Szeretnénk egy shardot hozzáadni. Figyeljük a fejlődést. Megváltoztatjuk a specifikációt. Megadjuk, hogy két shardot akarunk.
Ez ugyanaz a fájl, amely dinamikusan fejlődik a rendszer növekedésével. A tároló még nincs, a tároló később kerül megvitatásra, ez egy külön téma.
Átadjuk a YAML operátort, és nézzük meg, mi történik.
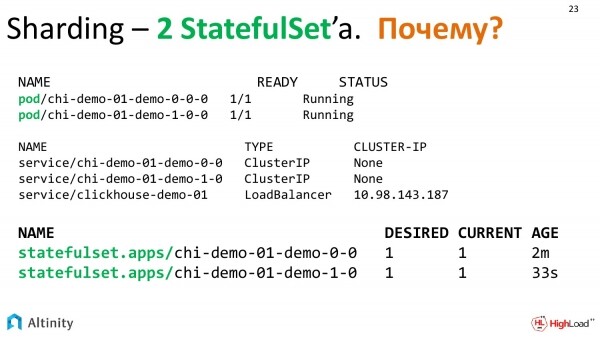
Az operátor gondolkodott és a következő entitásokat hozta létre. Már van két Pod, három Szolgáltatás és, váratlanul, 2 StatefulSet.
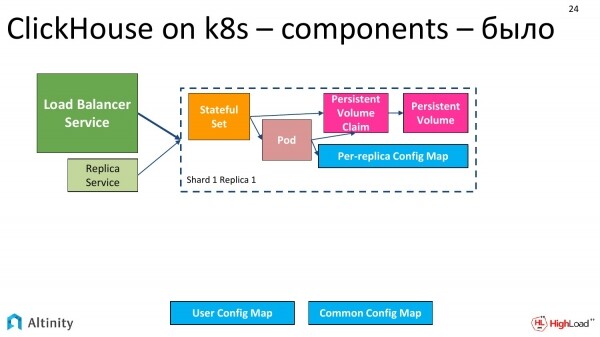
A sémán így volt – ez a kezdeti állapot, amikor csak egy pod volt.
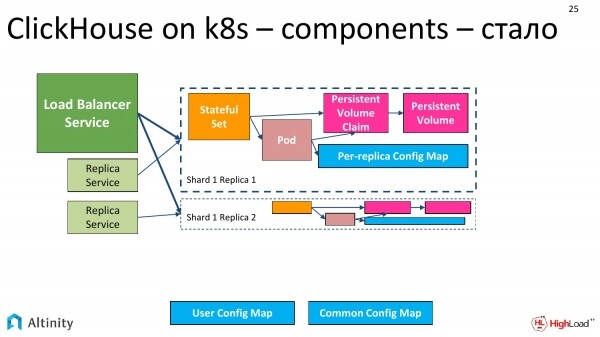
Így változott. Egyelőre minden egyszerű, megduplázódott.
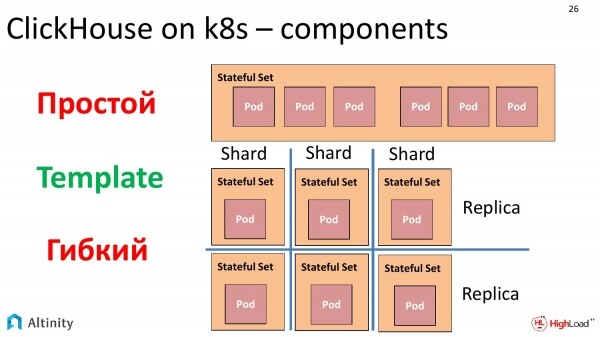
És miért lett a StatefulSet kettő? Itt el kell térni és meg kell beszélni, hogyan történik a Pod-ok kezelése a Kubernetes-ben.
Van egy objektum, amelyet StatefulSet-nek hívnak, amely lehetővé teszi, hogy Pod-ok halmazát hozzuk létre egy sablonból. A kulcselem itt a Template. Egy StatefulSet-en belül sok Pod-ot indíthatunk egy sablon alapján. A kulcsfontosságú mondat itt az, hogy «egy sablon alapján sok Pod».
Nagy kísértés volt, hogy az egész klasztert egy StatefulSet-be csomagoljuk. Ez működni fog, ezzel nincs probléma. De van egy kis árnyalat. Ha heterogén klasztert szeretnénk összerakni, azaz több ClickHouse verzióból, akkor itt már kérdések merülnek fel. Igen, a StatefulSet képes végrehajtani a rolling update-et, és lehet új verziót bevezetni, megmagyarázva, hogy egyszerre nem több, mint annyi node-ra van szükség.
De ha extrapolálni szeretnénk a feladatot, és azt mondanánk, hogy teljesen heterogén klasztert szeretnénk létrehozni, és nem a régi verziót szeretnénk újra cserélni rolling update-tel, hanem egyszerűen egy heterogén klasztert szeretnénk létrehozni a különböző ClickHouse verziók és különböző tárolók tekintetében. Például néhány replikát különböző lemezekre szeretnénk tenni, lassú lemezekre, szóval teljesen heterogén klasztert szeretnénk felépíteni. És az a helyzet, hogy mivel a StatefulSet egy sablonból szabványos megoldást ad, ezért erre nincs lehetőség.
Néhány gondolkodás után úgy döntöttünk, hogy így csináljuk. Minden replikánknak a saját StatefulSet-je van. Ennek a megoldásnak vannak hátrányai, de a gyakorlatban mindent teljesen összefoglal az üzemeltető. És számos előnye van. Teljesen olyan klasztert építhetünk, amilyet akarunk, például abszolút heterogént. Ezért abban a klaszterben, ahol két shard van, egy replikával, két StatefulSet és két Pod lesz, éppen azért, mert ezt a megközelítést választottuk a fent említett okok miatt a heterogén klaszter felépítésének lehetősége érdekében.
Térjünk vissza a gyakorlati feladatokhoz. A klaszterünkben felhasználókat kell beállítani, azaz valamilyen konfigurációt kell végezni a ClickHouse-ban a Kubernetes-en. Az üzemeltető ehhez minden lehetőséget biztosít.
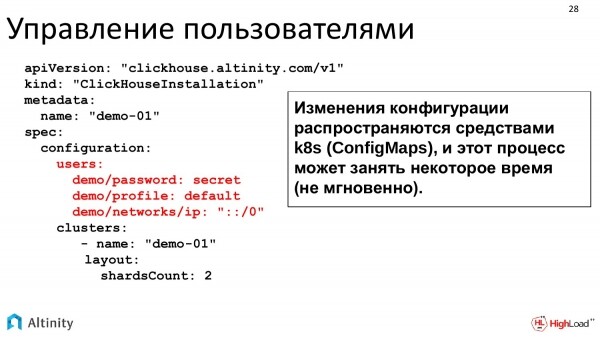
Közvetlenül a YAML-ben is megírhatjuk, amit szeretnénk. Minden konfigurációs lehetőség közvetlenül térképeződik ebből a YAML-ből a ClickHouse konfigurációkba, amelyeket később elosztanak az egész klaszterben.
Ilyen formában is írhatsz. Ez példa kedvéért van. A jelszó titkosítva is készülhet. Minden ClickHouse konfigurációs lehetőség támogatott. Ez itt csak példa.
A klaszter konfigurációja ConfigMap-on keresztül terjed. A gyakorlatban a ConfigMap frissítése nem azonnal történik, ezért ha a klaszter nagy, akkor a konfiguráció átnyomása bizonyos időt vesz igénybe. De mindez nagyon kényelmes a használat során.
Bonyolultabb feladatot kapunk. A klaszter fejlődik. Szeretnénk replikálni az adatokat. Azaz már van két shardunk, egy-egy replikával, felhasználók beállítva. Növekszünk, és a replikálással szeretnénk foglalkozni.
Mire van szükségünk a replikáláshoz?
Szükségünk van ZooKeeperre. A ClickHouse replikációja ZooKeeper használatával épül fel. A ZooKeeper szükséges ahhoz, hogy a különböző ClickHouse replikák konszenzusra jussanak arról, hogy mely adatrészek találhatóak a különböző ClickHouse példányokban.
Bármilyen ZooKeeper használható. Ha van a vállalatnak külső ZooKeepera, akkor azt lehet használni. Ha nincs, akkor a mi repo-nkból telepíthető. Van egy telepítő, ami megkönnyíti ezt a folyamatot.
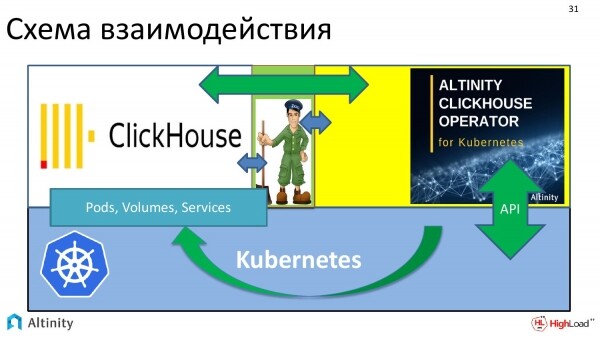
A rendszer teljes interakciójának sémája így néz ki. Van egy Kubernetes platformunk. Ezen fut a ClickHouse operátor. A ZooKeeper-t itt ábrázoltam. Az operátor így interakcióba lép mind a ClickHouse-zal, mind a ZooKeeper-rel. Azaz interakció jön létre.
Mindez azért szükséges, hogy a ClickHouse sikeresen replikálja az adatokat a k8s-ben.
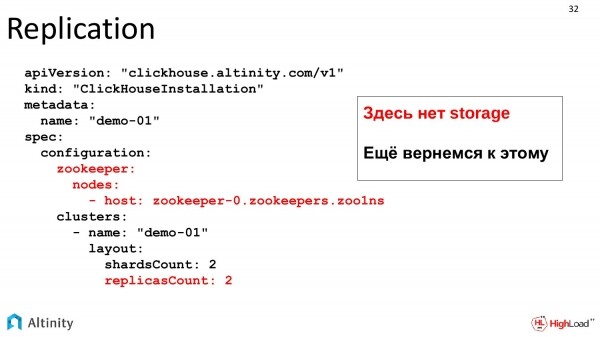
Nézzük most meg magát a feladatot, hogy hogyan fog kinézni a replikálási manifest.
A manifestünkhöz két szekciót adunk hozzá. Az első az, hogy honnan szerezzük be a ZooKeeper-t, ami lehet a Kubernetesen belül vagy külső is. Ez egyszerű leírás. Rendelünk replikákat. Azaz szeretnénk két replikát. Összesen tehát 4 pod-unk kellene. A tárolásra emlékezünk, erről később beszélünk. A tárolás egy külön téma.
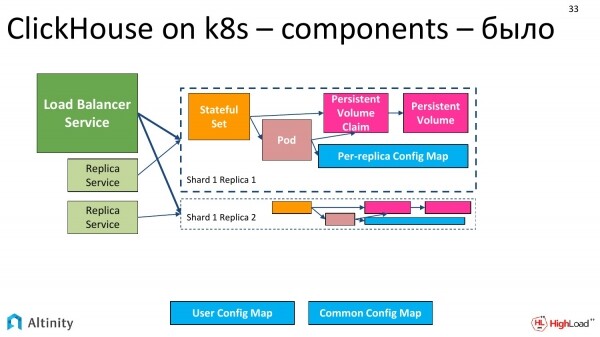
Így nézett ki ez korábban.
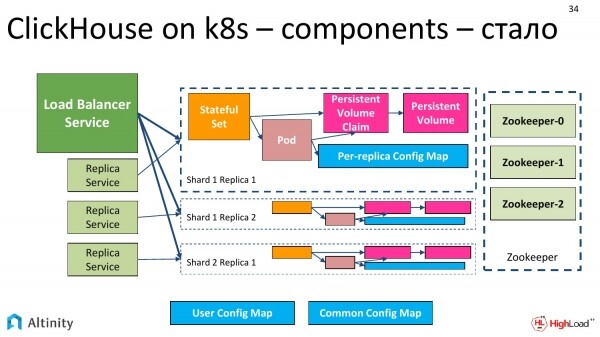
Most így néz ki. Hozzáadódnak a replikák. A 4. nem fért be, de hisszük, hogy ott lehet sok. És oldalra kerül a ZooKeeper. A sémák bonyolultabbá válnak.
Elérkezett az idő, hogy hozzáadjuk a következő feladatot. Hozzáadjuk a Persistent Storage-t.
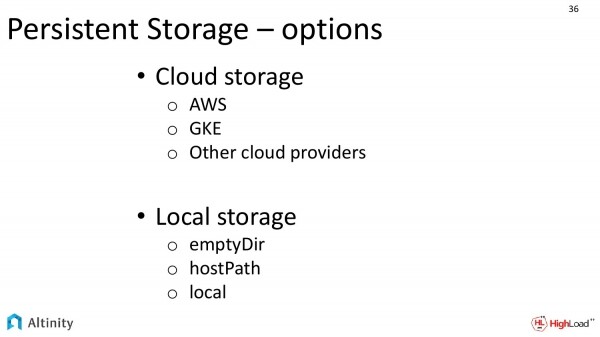 A Persistent Storage esetében különböző végrehajtási lehetőségeink vannak.
Ha felhőszolgáltatókkal működünk, például az Amazonnal vagy a Googlenál, akkor nagy a kísértés, hogy felhőalapú tárolót használjunk. Ez nagyon kényelmes és jó.
Van egy másik lehetőség is. Ez a helyi tároló, amikor minden node-nak helyi lemezei vannak. Ez a lehetőség sokkal bonyolultabb végrehajtani, de cserébe produktívabb.
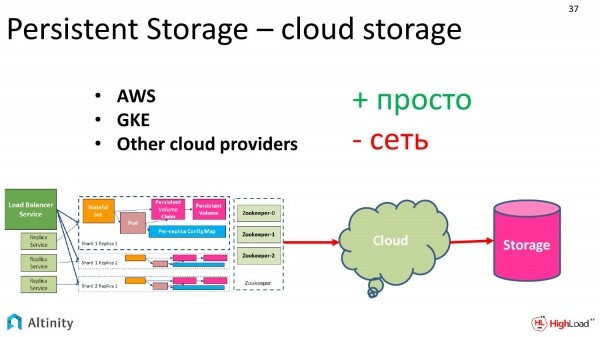
Nézzük meg, mi a helyzet a felhőtárolóval.
Vannak előnyei. Nagyon könnyen konfigurálható. Csak megrendeljük a felhőszolgáltatótól, hogy kérjük, adj nekünk egy ilyen kapacitású, ilyen osztályú tárolót. Az osztályokat a szolgáltatók önállóan határozzák meg.
És van egy hátránya is. Valakinek ez nem kritikus hátrány. Nyilván lesznek teljesítménybeli problémák. Ez nagyon kényelmes a munka során, megbízható, de vannak potenciális teljesítménycsökkenések.
Mivel a ClickHouse kifejezetten a teljesítményre összpontosít, még azt is mondhatjuk, hogy mindent kihoznak belőle, ezért nagyon sok ügyfél megpróbálja maximális teljesítményt nyerni.
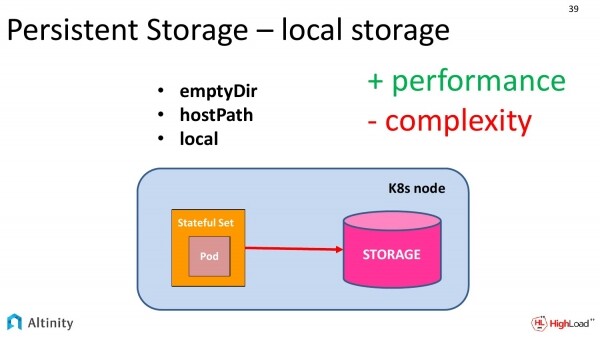
Ahhoz, hogy a lehető legjobbat kihozzuk, szükségünk van helyi tárolóra.
A Kubernetes három absztrakciót kínál a helyi tároló használatához. Ezek:
- EmptyDir
- HostPath.
- Helyi
Nézzük meg, miben különböznek és miben hasonlítanak.
Először is, mindhárom megközelítés esetén a tároló – helyi lemezek, amelyek ugyanazon a fizikai k8s nodon találhatók. De van néhány különbség.
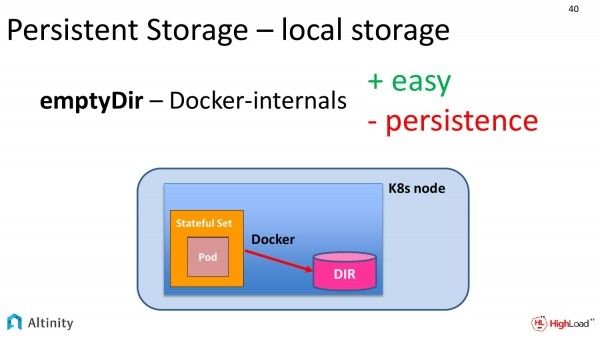
Kezdjük a legegyszerűbbel, az emptyDir-ral. Mi ez a gyakorlatban? Azt kérjük a specifikációnkból, hogy a konténerizáló rendszer (leggyakrabban Docker) biztosítson hozzáférést a helyi lemez egy mappájához.
A gyakorlatban a Docker valahol a saját útvonalain létrehoz egy ideiglenes mappát, és hosszú hash-ként nevezi el. És hozzáférési interfészt kínál.
Hogyan fog működni a teljesítmény szempontjából? Helyi lemez sebességgel fog működni, tehát teljes hozzáférést kapunk a saját meghajtónkhoz.
De ennek van egy hátránya. A Persistent ebben a kontextusban meglehetősen kérdőjeles. A Docker konténerek első mozdulatánál a Persistent elveszik. Ha a Kubernetes valamilyen okból át akarja helyezni ezt a Pod-ot egy másik lemezre, az adatok elvesznek.
Ez a megközelítés jól működik tesztelés során, mert a sebességet már normálisnak mutatja, de valami komolyabb célra nem alkalmas.
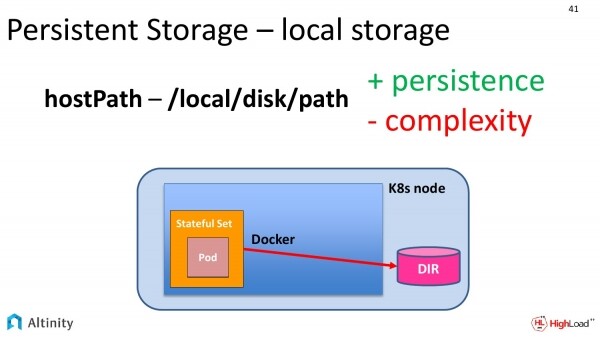
Ezért van a második megközelítés. Ez a hostPath. Ha megnézzük az előző diát és ezt, láthatjuk, hogy van egyetlen különbség. A mappa kiemelkedett a Dockerből közvetlenül a Kubernetes nodera. Itt egy kicsit egyszerűbb a helyzet. Közvetlenül megadjuk a helyi fájlrendszeren a helyet, ahol szeretnénk tárolni az adatainkat.
Ennek a módszernek vannak előnyei. Ez már valódi Persistent, ráadásul klasszikus értelemben. Az adatok a lemezen egy adott címre lesznek mentve.
Vannak hátrányai is. Ez a kezelés bonyolultsága. A Kubernetesünk áthelyezheti a Podot egy másik fizikai csomópontba. Itt lép be a DevOps szerepe. Meg kell magyaráznia a rendszernek, hogy ezeket a podokat csak olyan csomópontokra lehet áthelyezni, ahol az adott útvonalakon valami van csatolva, és egyszerre nem több mint egy csomópontba. Ez meglehetősen bonyolult.
Ezen célok érdekében nálunk az üzemeltetőnél készítettünk sablonokat, hogy ezt a bonyolultságot eltakarhassuk. Így egyszerűen csak annyit mondhatunk: „Azt szeretném, hogy minden fizikai csomópontra legyen egy ClickHouse példány, és ezen a-milyen úton”.
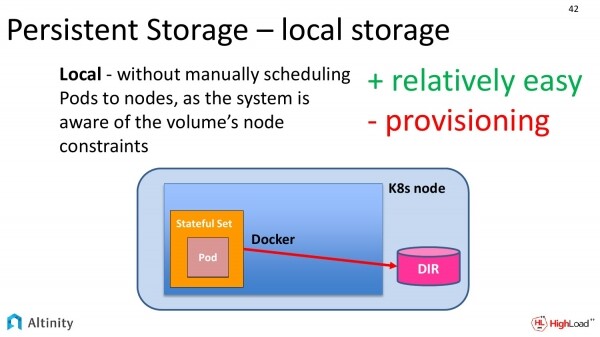
De ez a szükséglet nemcsak számunkra van, ezért a Kubernetes úriemberei is értik, hogy az emberek szeretnék elérni a fizikai lemezeket, ezért megadják a harmadik szintet.
Ez a local. A különbség az előző diához szinte észrevétlen. Korábban kézzel kellett elvégezni a feladatokat, ami megakadályozta, hogy ezeket a podokat csomópontról csomópontra áthelyezzük, mert azoknak egy adott úton kellett összekapcsolódniuk a helyi fizikai lemezzel, de most ezeket az ismereteket a Kubernetes magába foglalja. Így sokkal egyszerűbbé válik a konfigurálás.
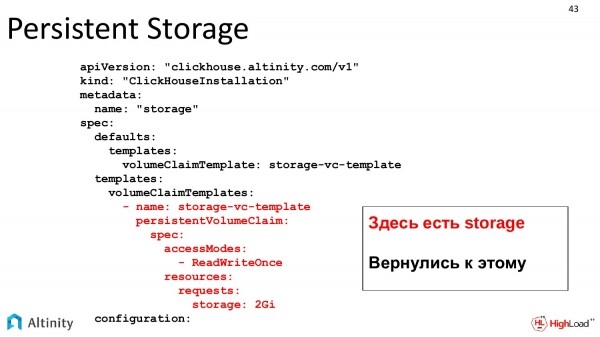
Térjünk vissza a gyakorlati feladatunkra. Térjünk vissza a YAML sablonhoz. Itt megjelent egy valódi tároló. Visszatértünk ehhez. A klasszikus VolumeClaim sablont olyan módon adjuk meg, ahogy a k8s-ben szokás, és leírjuk, hogy milyen tárolót szeretnénk.
Ezután a k8s kérni fogja a tárolót. Kiosztja nekünk a StatefulSet-ben. Ennek eredményeként ez a ClickHouse rendelkezésére áll.
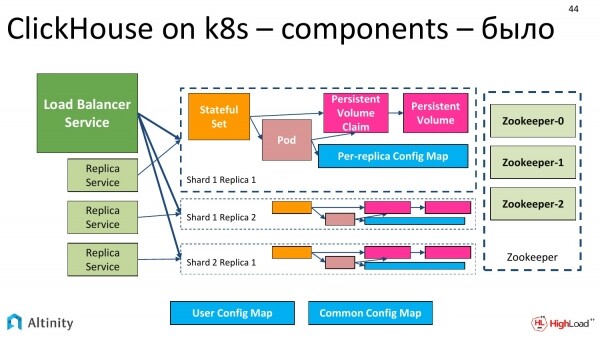
Volt egy ilyen diagramunk. A Persistent Storage-unk piros volt, ami úgy tűnt, hogy jelezni akarja, hogy ezt meg kellene csinálni.
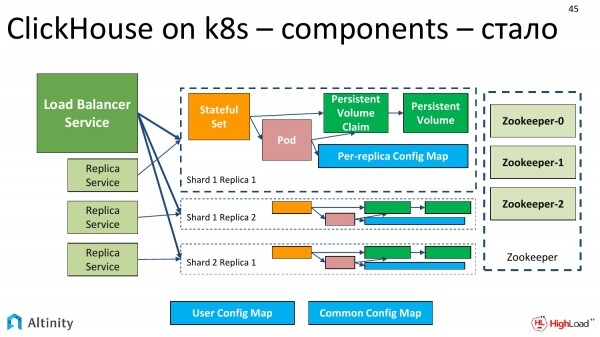
És ez zölddé válik. Most a ClickHouse k8s klaszter diagramja teljesen véglegesítve lett. Van shardunk, replikáink, ZooKeeper, és egy valódi Persistent, amelyet valamilyen módon megvalósítottunk. A diagram már teljesen működőképes.
Továbbra is élünk. A klaszter fejlődik. Alexei igyekszik, és kiadja az új ClickHouse verziót.
Gyakorlati feladat merül fel - tesztelni az új ClickHouse verziót a klaszterünkön. Természetesen nem akarjuk az egész rendszert frissíteni, hanem szeretnénk egy távoli sarokban új verziót telepíteni, vagy talán nem is egy új verziót, hanem rögtön kettőt, mert gyakran jelennek meg.
Mit mondhatunk ezzel kapcsolatban?
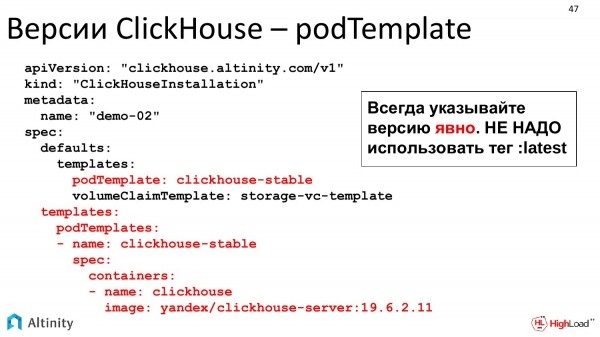
Itt lehetőségünk van egy ilyen sablonokkal rendelkező pod létrehozására. Az operátorunk teljesen lehetővé teszi hibrid klaszter építését. Azaz, a konfigurációt bármely replikából kiindulva testre szabhatjuk, egészen odáig, hogy meghatározzuk, melyik ClickHouse verziót és milyen tároló verziót szeretnénk. Teljesen testre tudjuk szabni a klasztert a kívánt konfigurációban.
Most már kicsit mélyebben belemegyünk a részletekbe. Eddig a ClickHouse operátor működéséről beszéltünk, összefüggésben a ClickHouse sajátosságaival.
Most szeretnék pár szót szólni arról, hogy bármely operátor hogyan működik általában, és arról, hogyan kapcsolódik a K8s-hez.
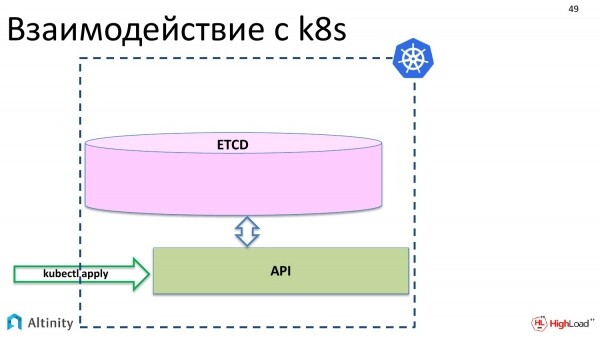
Először vizsgáljuk meg a K8s-hez való kapcsolódást. Mi történik, amikor végrehajtjuk a kubectl apply parancsot? Az API-n keresztül az etcd-ben megjelennek az objektumaink.
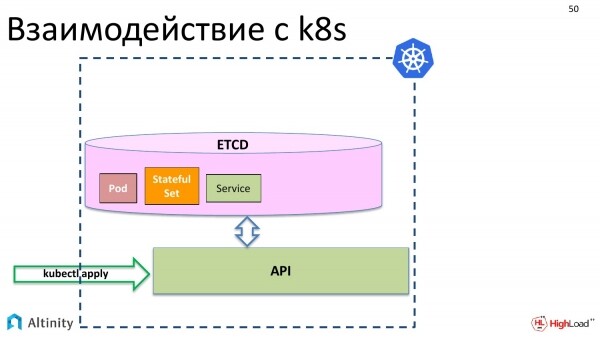
Például a Kubernetes alapvető objektumai: pod, StatefulSet, service, és így tovább.
Ekkor fizikailag még semmi sem történik. Ezeket az objektumokat materializálni kell a klaszterben.
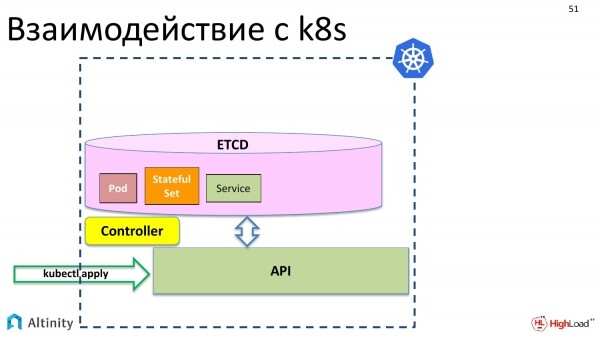
Ehhez egy vezérlő (controller) jön létre. A vezérlő egy speciális K8s komponens, amely képes a leírások materializálására. Tudja, hogyan és mit kell fizikailag tenni. Tudja, hogyan kell konténereket indítani, és mit kell beállítani ahhoz, hogy a szerver működjön.
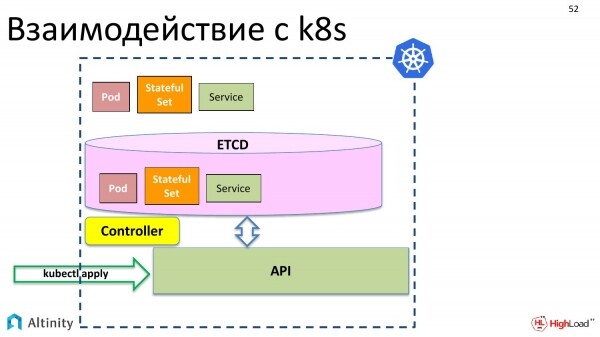
A vezérlő a K8s-ben materializálja az objektumainkat.
De nemcsak podokkal és StatefulSet-ekkel akarunk foglalkozni, hanem létre akarunk hozni egy ClickHouseInstallation-t, azaz egy ClickHouse típusú objektumot, hogy mint egy egységes egészet tudjunk vele operálni. Jelenleg erre nincs lehetőség.
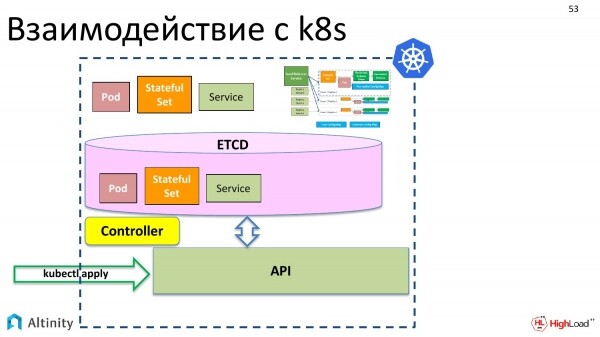
Viszont a K8s-nek van egy következő kedvező aspektusa. Azt szeretnénk, hogy valahol legyen egy ilyen összetett entitás, amely podokból és StatefulSet-ekből állítaná össze a klaszterünket.
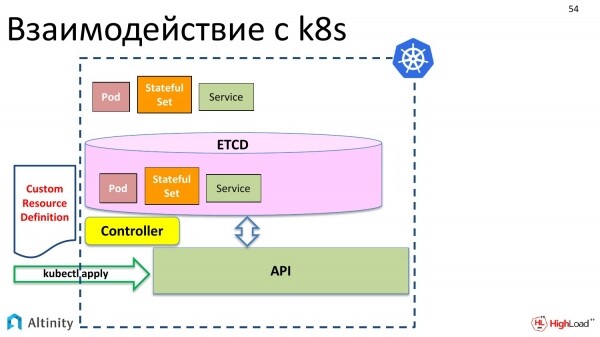
Ehhez mit kell tennünk? Először is, színre lép a Custom Resource Definition. Mi ez? Ez egy leírás a K8s számára arról, hogy lesz még egy adategység, amelyet a podokhoz és StatefulSet-ekhez szeretnénk hozzáadni, és amely belsőleg összetett lesz. Ez az adatstruktúra leírása.
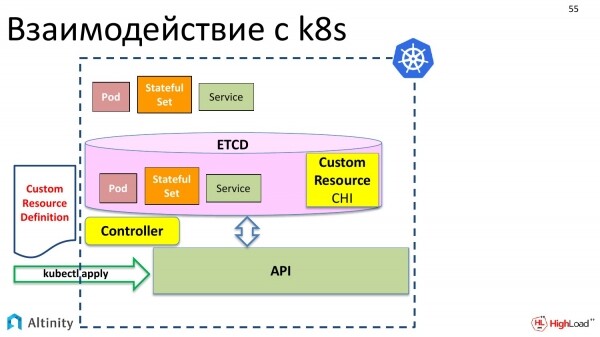
Ezt is elküldjük a kubectl apply segítségével. A Kubernetes ezt örömmel fogadta.
Most pedig a tárolóban, az etcd-ben megjelenik a lehetőség, hogy létrehozzuk a ClickHouseInstallation nevű egyedi erőforrást.
De még nem történt semmi. Azaz, ha most létrehozunk egy YAML-fájlt, amelyben a sharde-okat, replikákat írjuk le, és mondjuk, hogy „kubectl apply”, akkor a Kubernetes elfogadja, elhelyezi az etcd-ben, és azt mondja: „Jól van, de nem tudom, mit tegyek vele. Hogyan kell karbantartani a ClickHouseInstallation-t, azt nem tudom.”
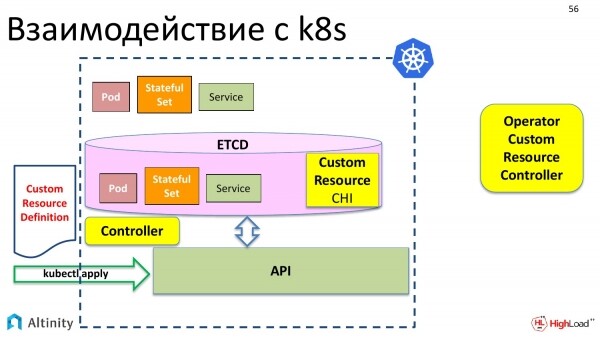
Ezért szükségünk van valakire, aki segít a Kubernetesnek kezelni az új adat típust. Bal oldalon van a natív Kubernetes vezérlő, amely a natív adat típusokkal dolgozik. Jobb oldalon pedig meg kell jelennie egy testreszabott vezérlőnek, amely képes dolgozni a testreszabott adattípusokkal.
És ezt másként operátornak hívják. Ezt itt szándékosan a Kubernetesen kívülire hoztam, mert képes futni a K8s-en kívül is. Legtöbbször természetesen az összes operátor a Kubernetesben fut, de semmi nem akadályozza meg, hogy kint álljon, ezért itt szándékosan kivettük a Kubernetesből.
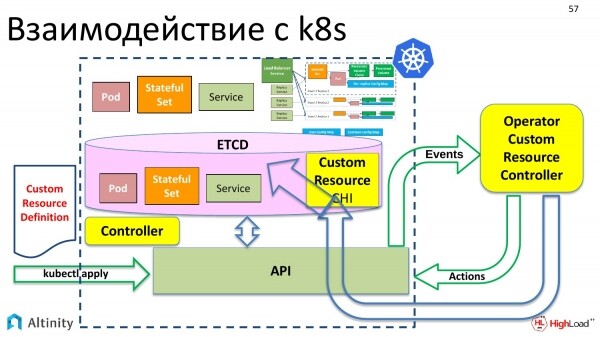
A testreszabott vezérlő, más néven operátor, a Kubernetes-szel az API-n keresztül lép kapcsolatba. Ő már képes kommunikálni az API-val. És már tudja, hogyan lehet a testreszabott erőforrásból megvalósítani a bonyolult sémát, amit létre szeretnénk hozni. Ezzel foglalkozik az operátor.
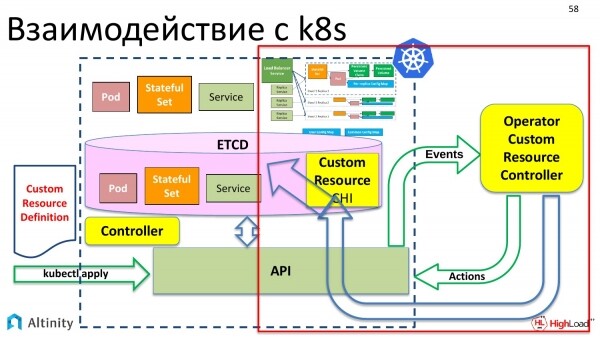
Hogyan működik az operátor? Nézzük meg a jobb oldalt, hogy megtudjuk, hogyan csinálja. Fedezzük fel, hogyan realizálja az operátor mindezt, és hogyan történik a további interakció a K8s-szel.
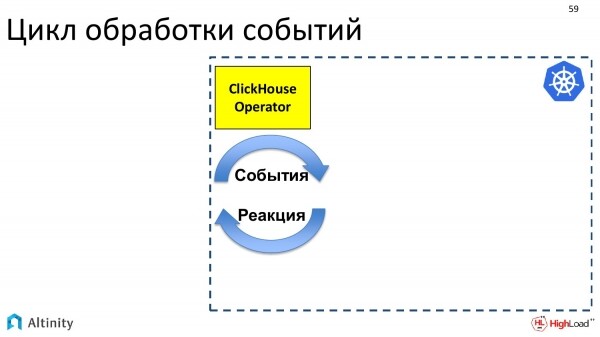
Az operátor egy program. Eseményorientált. Az operátor a Kubernetes API segítségével feliratkozik az eseményekre. A Kubernetes API-n vannak belépési pontok, ahol fel lehet iratkozni az eseményekre. Ha valami változik a K8s-ben, akkor a Kubernetes eseményeket küld minden érdeklődőnek, azaz aki feliratkozott arra az API pontra, az fog értesítéseket kapni.
Az operátor feliratkozik az eseményekre, és valamilyen reakciót kell tennie. Az ő feladata reagálni a megjelenő eseményekre.
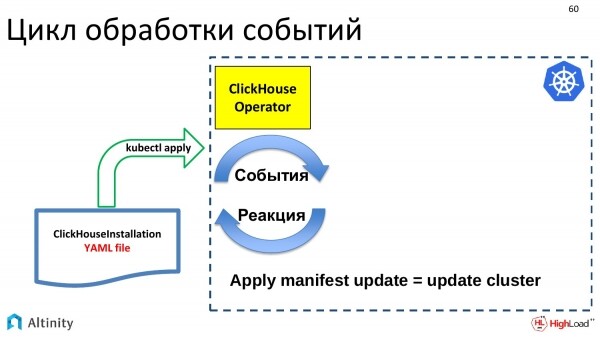
Az események valamilyen frissítések által generálódnak. Megérkezik a YAML-fájlt a ClickHouseInstallation leírásával. Az a kubectl apply-n keresztül jut el az etcd-hez. Ott létrejött egy esemény, amely végül eljutott a ClickHouse-operátorhoz. Az operátor megkapta ezt a leírást. És valamit tennie kell. Ha frissítés érkezik a ClickHouseInstallation objektumra, akkor frissíteni kell a klasztert. Az operátor feladata pedig az, hogy frissítse a klasztert.
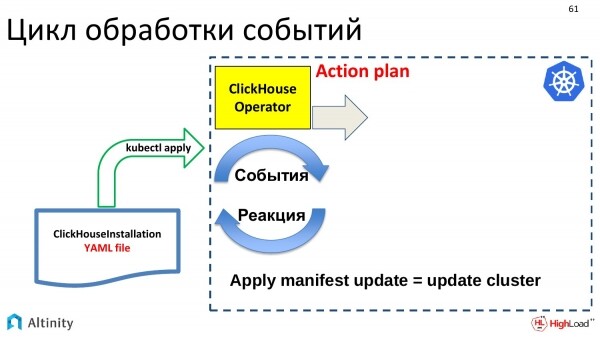
Mit csinál? Először is, tervet kell készítenünk arról, hogy mit fogunk tenni ezzel a frissítéssel. A frissítések lehetnek nagyon kicsik, például YAML formátumban, de jelentős változásokat okozhatnak a klaszterben. Ezért az üzemeltető elkészíti a tervet, amelyhez ezután tartja magát.
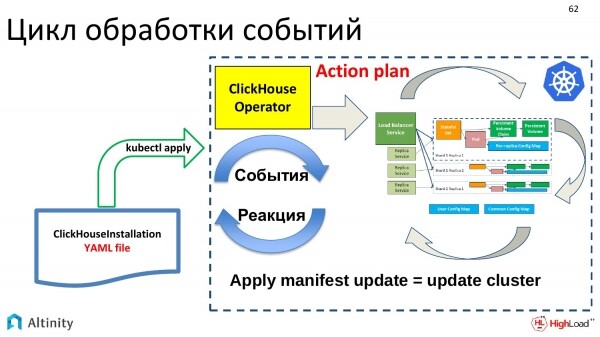
A terv szerint nekiáll az alapstruktúrának, hogy megvalósítsa a podokat, szolgáltatásokat, tehát azt, ami a fő feladata. Ez olyan, mint egy ClickHouse klaszter építése Kubernetes alatt.
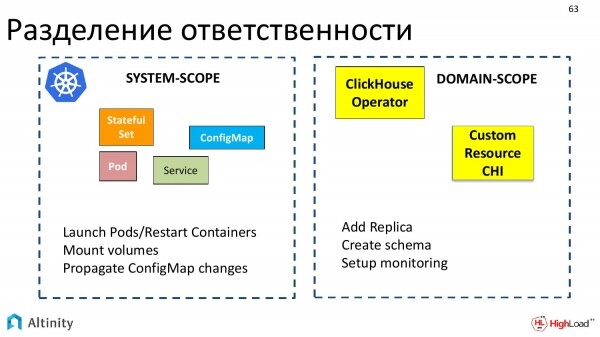
Most érintsünk meg egy érdekes dolgot. Ez a felelősségek megosztása a Kubernetes és az üzemeltető között, tehát mi a Kubernetes feladata, mi az üzemeltetőé, és hogyan működnek együtt.
A Kubernetes a rendszerszintű feladatokért felelős, tehát az alapvető objektumok készletéért, amelyeket rendszerszintűnek tekinthetünk. A Kubernetes tudja, hogyan indítsa el a podokat, hogyan indítsa újra a konténereket, hogyan csatlakoztassa a tárolókat, hogyan működjön a ConfigMap-el, tehát mindent, amit rendszernek nevezhetünk.
Az üzemeltetők a szakterületeken működnek. Minden üzemeltető saját szakterületére készült. Mi a ClickHouse-hoz készítettük.
Az üzemeltető pontosan a szakterület kifejezéseiben kommunikál, mint például egy replikát hozzáadni, sémát készíteni, monitoringot beállítani. Ez egyfajta megosztottságot eredményez.
Nézzük meg egy gyakorlati példa segítségével, hogy ez a felelősségmegosztás hogyan valósul meg, amikor a replikát szeretnénk hozzáadni.
Az üzemeltetőhöz érkezik a feladat – replikát hozzáadni. Mit csinál az üzemeltető? Az üzemeltető kiszámítja, hogy új StatefulSet-et kell létrehozni, amelyben a megfelelő sablonokat és a tároló igényt kell leírni.
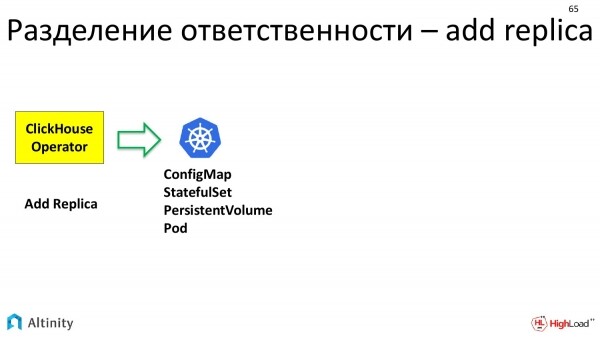
Mindennel elkészült, és továbbítja a K8s-nek. Megmondja, hogy szüksége van ConfigMap-re, StatefulSet-re, Volumere. A Kubernetes feldolgozza. Megvalósítja az alapvető egységeket, amelyekkel dolgozik.
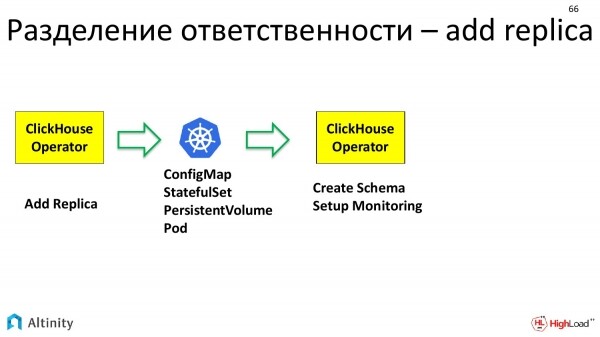
Ezután újra belép a képbe a ClickHouse-ügyintéző. Már van egy fizikai podja, amelyen tevékenykedni lehet. A ClickHouse-ügyintéző ismét szakterületi kifejezésekben dolgozik. Tehát konkrétan a ClickHouse-nál ahhoz, hogy a replikát a klaszterbe integrálhassuk, először a klaszter adatainak sémáját kell beállítani. Másodszor, ezt a replikát be kell állítani a monitoring számára, hogy jól nyomon követhető legyen. Ezt az üzemeltető állítja be.
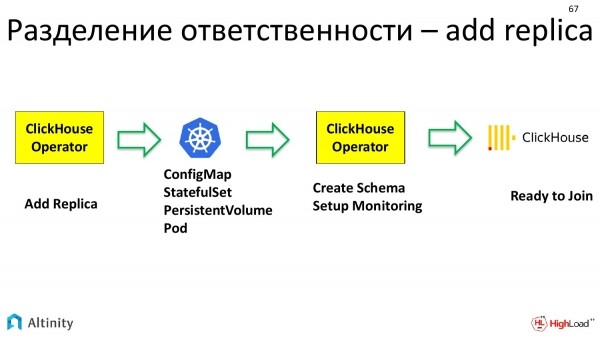
És csak ezután lép működésbe a ClickHouse, azaz egy még magasabb szintű entitás. Ez már egy adatbázis. Van egy saját példánya, egy újabb konfigurált replikája, amely készen áll a klaszterbe való bekapcsolódásra.
Így a replikák hozzáadásának végrehajtási lánca és a felelősségek megosztása meglehetősen hosszú.
Folytatjuk a gyakorlati feladatainkat. Ha már van klaszter, akkor lehetőség van a konfiguráció migrálására.
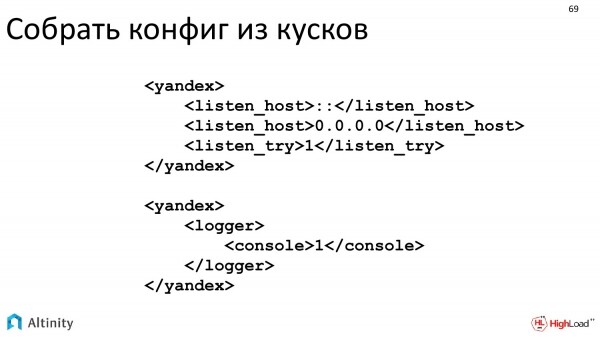
Úgy alakítottuk, hogy a meglévő XML-be, amelyet a ClickHouse ért, átbocsáthatók az adatok.
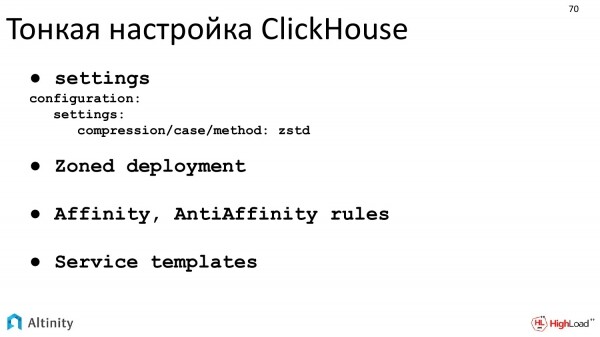
Lehetőség van a ClickHouse finomhangolására. A zoned deployment pontosan az, amiről beszéltem a hostPath és a lokális tároló magyarázata során. Ez az, hogyan kell helyesen megvalósítani a zoned deploymentet.
A következő gyakorlati feladat a monitoring.
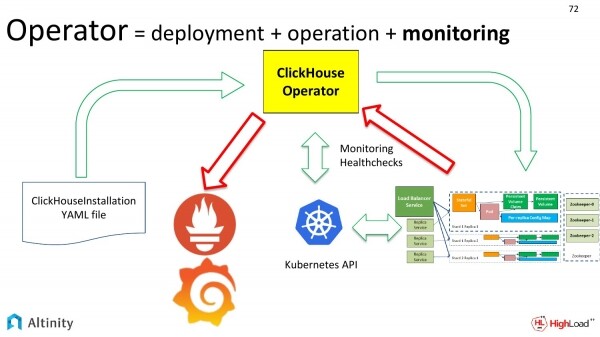
Ha a klaszterünk változik, rendszeresen be kell állítani a monitoringot.
Nézzük meg a sémát. A zöld nyilakat már megvitattuk. Most nézzük meg a piros nyilakat. Ez az, ahogyan szeretnénk monitorozni a klaszterünket. Hogyan jutnak a ClickHouse klaszterből származó metrikák a Prometheushoz, majd a Grafanába.
Mi a nehézség a monitoringgal? Miért tekintik ezt valamilyen elért eredménynek? A nehézség a dinamizmusban rejlik. Amikor egy klaszter statikus, be lehet állítani egyszer a monitoringot, és azután nem kell vele foglalkozni.
De ha sok klaszterünk van, vagy folyamatosan változik valami, akkor a folyamat dinamikus. Folyamatosan újra kellene állítani a monitoringot, ami erőforrás- és időigényes, tehát még csak lustaság is. Ezt automatizálni kell. A nehézség éppen a folyamat dinamikájában rejlik. Az operátor ezt nagyon jól automatizálja.
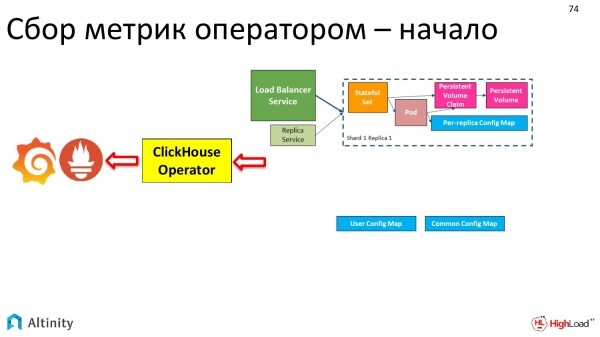
Hogyan fejlődött a klaszterünk? Eleinte ilyen volt.
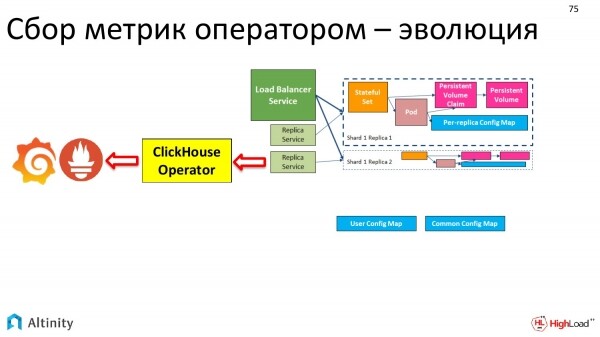
Aztán ilyen lett.
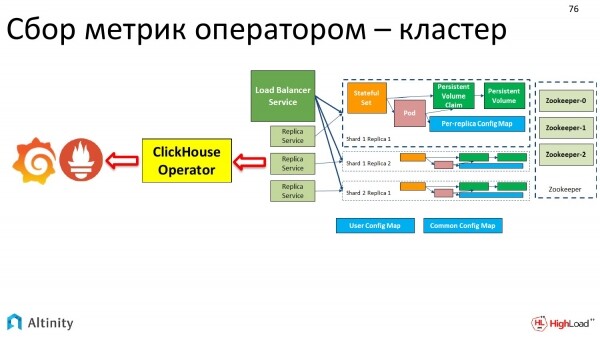
Végül pedig ilyen lett.
A monitoringot automatikusan végzi az operátor. Egységes belépési pont.
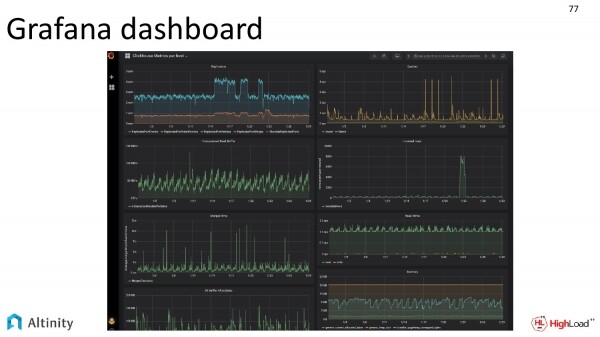
Mi csak a kimeneten nézzük a Grafana vezérlőpulton, hogyan pezseg a klaszterünk élete.
Egyébként a Grafana vezérlőpult is az operátorunkkal együtt terjesztésre kerül, közvetlenül a forrásokban. Csatlakozhatunk és használhatjuk. Ezt a képernyőképet a DevOps csapatunk adta nekem.
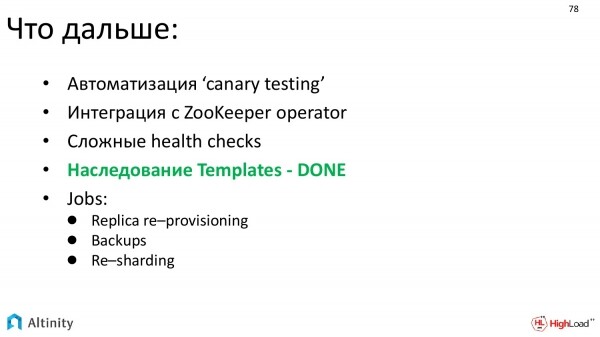
Hová szeretnénk továbbhaladni? Ez:
- Fejleszteni az automatizált tesztelést. A fő cél az új verziók automatizált tesztelése.
- Szeretnénk automatizálni az integrációt a ZooKeeper-rel. Tervezzük a ZooKeeper-operátorral való integrációt is. Tehát a ZooKeeper-hez írtunk egy operátort, amely logikus lenne, hogy integrálódjon két operátor, hogy egy kényelmesebb megoldást építhessünk.
- Komplexebb életjel-ellenőrzéseket szeretnénk végezni.
- Zöld színnel jelöltem meg, hogy elérkezett a Templates öröklése – KÉSZ, azaz a következő operátor kiadásával már rendelkezni fogunk a sablonok öröklésével. Ez egy erőteljes eszköz, amely lehetővé teszi bonyolult konfigurációk építését darabokból.
- És szeretnénk automatizálni a bonyolult feladatokat. A legfontosabb ezek közül a Re-sharding.
Készítsünk egy közbenső összegzést.
Mit kapunk végül? Érdemes-e ezzel foglalkozni, vagy nem? Érdemes-e egyáltalán megpróbálni beilleszteni az adatbázist Kubernetesbe és alkalmazni az operátort általában és az Alitnity-operator esetében?
Végül ezt kapjuk:
- Jelentős egyszerűsítést és automatizálást a konfigurálásban, telepítésben és folyamatos karbantartásban.
- Azonnal beépített megfigyelés.
- És készen használható kódolt sablonok bonyolult helyzetekhez. Eddig a replika hozzáadása már nem kell manuálisan történjen. Ezt az operátor végzi.
Csak az utolsó kérdés maradt. Az adatbázisunk már Kubernetesben van, virtualizálásban. Mi a helyzet ennek a megoldásnak a teljesítményével, különösen figyelembe véve, hogy a ClickHouse az optimalizált teljesítményre van tervezve?
A válasz – minden rendben van! Nem fogom részletezni, ez egy másik előadás témája.
De van egy projekt, mint a TSBS. Mi az alapvető feladata? Ez egy adatbázis-teljesítmény teszt. Próbálkozás a „meleg” összehasonlításával, „puha” dolgok összehasonlítása.
Hogyan működik? Egy adat készletet generálnak. Majd ezt az adatot azonos tesztkészlet segítségével futtatják különböző adatbázisokon. És minden adatbázis egy adott feladatot a tudása szerint old meg. Aztán az eredményeket össze lehet hasonlítani.
Ez már számos adatbázist támogat. Három főt emeltem ki. Ezek:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
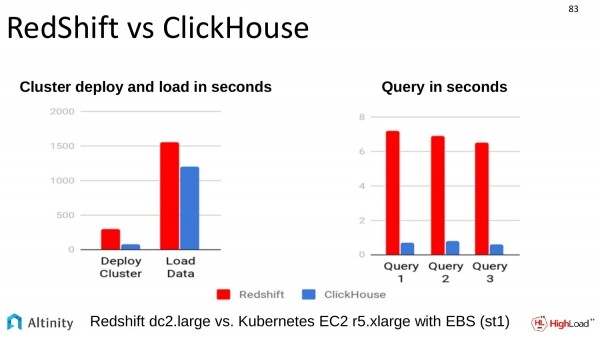
Szintén összehasonlítást végeztek egy hasonló megoldással. Az összehasonlítást a RedShift-tel végezték. Az összehasonlítást az Amazon-on végezték. A ClickHouse ezen a téren is jól teljesít.
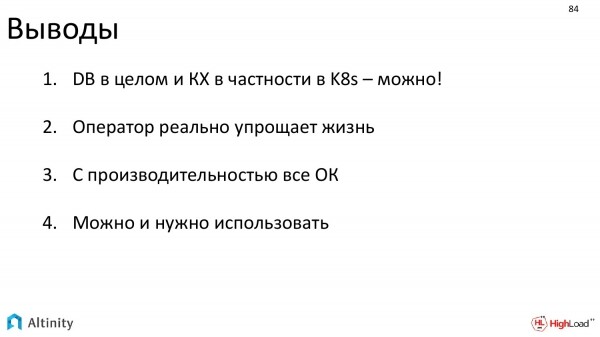
Milyen következtetéseket vonhatunk le abból, amit elmondtam?
- Adatbázis Kubernetesben lehetséges. Valószínűleg bármilyen típusú, de összességében úgy tűnik, hogy lehetséges. A ClickHouse Kubernetesben biztosan működik a mi operátorunk erejével.
- Az operátor segít automatizálni a folyamatokat, és valóban megkönnyíti az életet.
- A teljesítmény normális.
- És úgy gondoljuk, hogy ezt lehet és kell is használni.
Nyílt forráskódú – csatlakozzon!
Ahogy már említettem, az operátor egy teljesen nyílt forráskódú termék, ezért nagyon jó lenne, ha minél több ember használná. Csatlakozzon! Várjuk Önöket!
Köszönöm mindenkinek!
Kérdések
Köszönöm a bemutatót! Anton vagyok a SEMrush-tól. Engem érdekel, mi a helyzet a naplózással. A monitorozásról hallottunk, de a naplózásról semmit, ha az egész klaszterre gondolunk. Nálunk például egy klasztert indítottunk hardveren. Központosított naplózást használunk, a standard eszközökkel gyűjtjük össze az adatokat. Majd onnan kinyerjük az érdekes számunkra adatokat.
Jó kérdés, tehát a naplózás a teendők listáján szerepel. Az operátorunk ezt jelenleg nem automatizálja. Még vždy fejlődik, a projekt még elég fiatal. Megértjük a naplózás szükségességét. Ez is egy nagyon fontos téma. Valószínűleg nem kevésbé fontos, mint a monitorozás. De az első a megvalósítási listán a monitorozás volt. A naplózás lesz. Természetesen igyekszünk automatizálni a klaszter működésének minden aspektusát. Tehát a válasz - jelen pillanatban az operátorunk, sajnos, ezt nem tudja, de tervben van, hogy megcsináljuk. Ha van kedvük csatlakozni, akkor nyugodtan küldjenek pull request-et.
Jó napot! Köszönöm a bemutatót! Van egy standard kérdésem a Persistent Volumes-zal kapcsolatban. Amikor ezt az operátort használva konfigurálunk, hogyan határozza meg az operátor, hogy melyik node-on van egy adott lemez vagy mappa? Előre kell mondanunk neki, hogy kérjük, helyezze el a ClickHouse-t kifejezetten azokon a node-okon, ahol lemez található?
Amennyire tudom, ez a kérdés a helyi tárolás folytatása, különösen a hostPath részéről. Ez arról szól, hogy hogyan mondhatunk el a rendszernek, hogy a podnak egy adott node-on kell elindulnia, ahol fizikai diszk csatlakozik, amely egy adott úton van csatolva. Ez egy egész szekció, amelyet nagyon felszínesen érintettem, mert a válasz elég hosszú.
Röviden ez így néz ki. Természetesen provisioning-ra van szükségünk ezeknek a tárolóknak. Jelenleg a helyi tárolóban nincs dinamikus provisioning, ezért a DevOps-nak magának kell létrehoznia a lemezeket, ezeket a tárolókat. És el kell magyarázniuk a Kubernetes provisioning-nak, hogy milyen Persistent storage típust kell használni, ami adott csomópontokon található. Aztán el kell magyarázniuk a Kubernetes-nek, hogy azokat a pod-okat, amelyek ilyen típusú helyi tárolót igényelnek, csak adott címkékkel kell ütemezni az ilyen csomópontokra. Ezekre a célokra az operátorban lehetőség van címkéket és egy host instance-t hozni létre. Így a pod-ok a Kubernetes általi ütemezés során csak azokra a csomópontokra fognak indulni, amelyek megfelelnek a követelményeknek, egyszerűen fogalmazva a címkék alapján. Az adminisztrátorok címkéket rendelnek, és kézzel végzik a lemezek provisioning-ját. Így skálázhatóvá válik.
És éppen ez a harmadik helyi lehetőség segít egy kicsit megkönnyíteni ezt. Ahogy már hangsúlyoztam, ez egy aprólékos beállítási munka, amely végül a maximális teljesítmény elérésében segít.
Van egy második kérdésem is ezzel kapcsolatban. A Kubernetes úgy lett megálmodva, hogy számunkra nem számít, hogy elveszítünk-e egy csomópontot vagy sem. Mi a teendő, ha elveszítjük azt a csomópontot, ahol egy shard található?
Igen, a Kubernetes-t eredetileg úgy pozicionálták, hogy a pod-jainkra mint jószágra tekintsünk, most azonban minden lemez kicsit olyan, mint egy házikedvenc. Van egy probléma, hogy ezeket nem dobhatjuk ki csak úgy. A Kubernetes fejlődése arra mutat, hogy nem lehet teljesen filozófiai módon tekinteni rá, mint ami teljesen eldobható erőforrás.
Most egy gyakorlati kérdés. Mi a teendő, ha elveszik egy csomópont, amelyen a lemez volt? Itt már a feladat egy magasabb szinten oldható meg. A ClickHouse esetében vannak replikák, amelyek egy szinttel feljebb működnek, tehát a ClickHouse szintjén.
Mi az elrendezés? A DevOps felelős azért, hogy ne vesszenek el az adatok. Meg kell felelően beállítania a replikációt, és figyelnie kell, hogy a replikáció végrehajtódjon. A ClickHouse szintjén a replikában az adatoknak duplikálva kell lenniük. Ez nem az a feladat, amit az operátor végez el. És nem az a feladat, amit a Kubernetes végez el. Ez a ClickHouse szintjén történik.
Mi a teendő, ha eltűnt a vas node? Így második node-ot kell majd felügyelni, helyesen be kell állítani a lemezt és címkéket kell rátenni. Ekkor már megfelel a követelményeknek, hogy a Kubernetes elindítson rajta egy podot. A Kubernetes el fogja indítani. Az Ön podjainak száma ugyanis nem elegendő a megadotthoz. Átlép a cikluson, amit mutattam. A legfelső szinten a ClickHouse megérti, hogy egy replikánk van, ami még üres, és elkezdeni kell az adatok átvitelét. Tehát ez a folyamat még nem eléggé automatizált.
Köszönöm az előadást! Amikor történnek különféle rossz dolgok, a vezérlő eltűnik és újraindul, és ebben a pillanatban érkeznek az események, Ön hogyan dolgozza fel ezeket?
Mi történik, ha a vezérlő eltűnik és újraindul, ugye?
Igen. És ebben a pillanatban érkeztek az események.
A feladat, hogy mit tegyünk ebben az esetben, részben megoszlik a vezérlő és a Kubernetes között. A Kubernetes lehetőséget ad az események újrajátszására. Ő újrajátszik. A vezérlő feladata az, hogy amikor az események naplójára újrajátszást végeznek, azok idempotent-ek legyenek. És hogy az azonos esemény újbóli megjelenése ne törje meg a rendszerünket. A vezérlőnk képes megbirkózni ezzel a feladattal.
Üdvözlöm! Köszönöm az előadást! Dmitrij Zavyalov, cég Smedova. Tervezik, hogy a vezérlőbe beépítik a haproxy beállításának lehetőségét? Érdekelne valamilyen más egyensúlyozó, ami okos és tudja, hogy valójában ClickHouse.
Az Ingress-re gondol?
Igen, az Ingress-t helyettesítsük haproxy-ra. A haproxy-ban megadható a klaszter topológiai elhelyezkedése, ahol a replikák vannak.
Jelenleg nem gondolkodtunk ezen. Ha szüksége van rá és el tudja magyarázni, miért van szükség rá, akkor megvalósítható lesz, főleg, ha helyet tud szorítani rá. Örömmel megvizsgáljuk a lehetőséget. Rövid válasz: nem, a jelenlegi funkcióink között ez nem szerepel. Köszönöm az ötletet, megnézzük. Ha még el tudja magyarázni az alkalmazási esetet és miért van szükség rá a gyakorlatban, például GitHub-ra issues-t készít, akkor az nagyszerű lenne.
Már létezik.
Rendben. Nyitottak vagyunk bármilyen javaslatra. A haproxy szerepel a teendők listáján. A teendők listája folyamatosan nő, és nem csökken. De ez jó, ez azt jelenti, hogy a termék keresett.
Forrás: habr.com
