

Helló, Habr! A nevem Makszim Vasiljev, elemző és projektmenedzser vagyok a FINCH-nél. Ma szeretnék mesélni arról, hogyan tudtunk az ElasticSearch segítségével 15 millió lekérdezést feldolgozni 6 perc alatt, és optimalizálni egy ügyfelünk weboldalának napi terhelését. Sajnos névnélkül kell maradnunk, mivel NDA-nk van, reméljük, hogy a cikk tartalma ettől nem szenved. Induljunk!
Hogyan működik a projekt
A backendünkön olyan szolgáltatásokat hozunk létre, amelyek biztosítják ügyfelünk weboldalának és mobilalkalmazásának működését. Az általános struktúrát az alábbi ábrán láthatjátok:
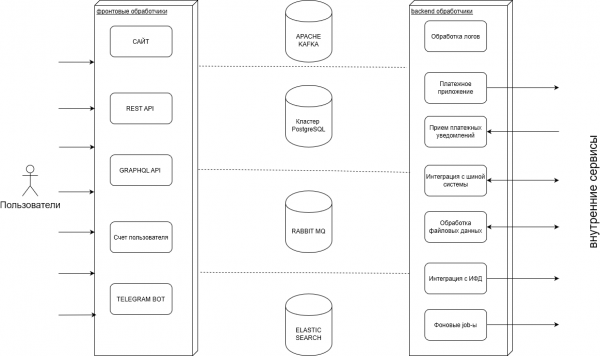
A munkánk során nagy mennyiségű tranzakciót dolgozunk fel: vásárlásokat, kifizetéseket, felhasználói egyenlegekkel kapcsolatos műveleteket, amelyekhez sok naplót tárolunk, és ezen adatokat importáljuk és exportáljuk külső rendszerekbe.
Vannak visszafelé irányuló folyamatok is, amikor adatokat kapunk az ügyféltől, és ezeket a felhasználóknak továbbítjuk. Ezen kívül léteznek folyamatok a fizetésekkel és a bónuszprogramokkal kapcsolatban is.
Rövid előtörténet
Kezdetben egyedüli adatbázisként a PostgreSQL-t használtuk. Ennek a DBMS-nek a szokásos előnyei: tranzakciók, fejlett adateverítési nyelv, széleskörű integrációs eszközkészlet; a jó teljesítménnyel kombinálva hosszú időn keresztül kielégítette igényeinket.
A Postgres-ben tároltunk minden adatot: tranzakcióktól kezdve a hírekig. De a felhasználók száma növekedett, és vele együtt a lekérdezések száma is.
Hogy pontosabb képet kapjatok, 2017-ben a desktop weboldalon évente 131 millió ülés volt. 2018-ban 125 millió. 2019-ben ismét 130 millió. Ezen kívül adjatok hozzá még 100-200 milliót a mobil weboldal és a mobilalkalmazás forgalmából, és hatalmas lekérdezésmennyiséget kaptok.
A projekt növekedésével a Postgres már nem bírta el a terhelést, nem tudtunk lépést tartani — rengeteg különböző lekérdezés jelent meg, amelyekhez nem tudtunk elegendő indexet létrehozni.
Tudtuk, hogy szükség van más adatbázisokra, amelyek kielégítik igényeinket és enyhítik a PostgreSQL terhelését. Lehetséges lehetőségekként fontolóra vettük az Elasticsearch-t és a MongoDB-t. Az utóbbi hátrányban volt a következő szempontok miatt:
- A lassú indexelési sebesség a sindexekben lévő adatok mennyiségének növekedésével nő. Az Elastic esetében a sebesség nem függ az adatmennyiségtől.
- Nincs teljes szöveges keresés
Így választottuk az Elastic-et, és felkészültünk az átállásra.
Átállás az Elastic-ra
1. Az átállást az értékesítési pontok keresőszolgáltatásával kezdtük. Ügyfelünk összesen körülbelül 70 000 értékesítési ponttal rendelkezik, és szükség van különböző keresési típusokra a weboldalon és az alkalmazásban:
- Szöveges keresés településnév alapján
- Geokeresés meghatározott sugárban egy ponttól. Például, ha a felhasználó látni szeretné, mely értékesítési pontok vannak a legközelebb az otthonához.
- Keresés egy meghatározott négyzeten belül – a felhasználó körvonalaz egy négyzetet a térképen, és megjelennek a pontok ebben a sugárban.
- Keresés további szűrők szerint. Az értékesítési pontok eltérhetnek a kínálat alapján.
Ha a szervezésről beszélünk, a Postgres-ben a térképre és a hírekre vonatkozó adatforrás található, míg az Elastic-ben az eredeti adatok snapshotjai készülnek. A helyzet az, hogy a Postgres eredetileg nem tudott megfelelni az összes kritériumnak megfelelő keresésnek. Nemcsak sok index létezett, hanem ezek átfedésben is lehettek, ezért a Postgres ütemezője elveszett, és nem tudta, melyik indexet kellene használnia.
2. A következő a hírek szekciója volt. A weboldalon naponta jelennek meg publikációk, hogy a felhasználó ne veszítse el a fonalat az információáradatban, a adatokat rendezni kell a megjelenítés előtt. Erre van szükség a kereséshez: a weboldalon szöveges egyezés alapján lehet keresni, és közben további szűrőket is lehet csatlakoztatni, mivel ezek is Elastic-en keresztül készültek.
3. Ezután áttelepítettük a tranzakciók feldolgozását. A felhasználók bizonyos termékeket vásárolhatnak a weboldalon, és részt vehetnek a nyereményjátékban. Az ilyen vásárlások után nagy mennyiségű adatot dolgozunk fel, különösen hétvégén és ünnepekkor. Összehasonlításul, ha normál napokon a vásárlások száma körülbelül 1,5-2 millió, ünnepekkor ez a szám elérheti az 53 milliót.
Ekkor az adatokat minimális időn belül kell feldolgozni — a felhasználók nem szeretik várni, hogy napokig megkapják az eredményt. A Postgres-en keresztül ilyen határidőket nem lehetett betartani — gyakran kaptunk zárolásokat, és amíg az összes kérést feldolgoztuk, a felhasználók nem tudták ellenőrizni, hogy nyertek-e. Ez nem túl kellemes az üzlet számára, ezért az adatfeldolgozást az Elasticsearch-re helyeztük át.
Gyakoriság
Jelenleg az frissítések esemény alapúak, a következő feltételek szerint:
- Eladási pontok. Amint adatokat kapunk egy külső forrásból, azonnal elindítjuk a frissítést.
- Hírek. Amint a weboldalon szerkesztenek egy hírt, az automatikusan elküldésre kerül az Elasticbe.
Ezúttal érdemes megemlíteni az Elastic előnyeit. A Postgres esetében a kérés elküldésekor meg kell várni, amíg valóban feldolgozza az összes bejegyzést. Az Elasticben 10 ezer bejegyzést küldhetünk egyszerre, és azonnal elkezdhetjük a munkát anélkül, hogy meg kellene várnunk, amíg a bejegyzések eloszlanak az összes Shardon. Természetesen valamelyik Shard vagy Replika lehet, hogy azonnal nem látja az adatokat, de nagyon hamar minden elérhetővé válik.
Integrációs lehetőségek
Két lehetőség van az Elastic integrációra:
- A natív kliensen keresztül TCP-n. A natív meghajtó fokozatosan eltűnik: már nem támogatják, a szintaxisa nagyon kényelmetlen. Ezért gyakorlatilag nem használjuk, és megpróbálunk teljesen lemondani róla.
- HTTP interfészen keresztül, amelyen JSON kérdéseket és Lucene szintaxist is használhatunk. Az utóbbi egy szövegmotor, amelyet az Elastic használ. Ilyen módon Batch-típust kapunk JSON kérdéseken keresztül HTTP-n. Ezt a megoldást próbáljuk alkalmazni.
A HTTP interfésznek köszönhetően olyan könyvtárakat használhatunk, amelyek aszinkron HTTP kliens megvalósítást nyújtanak. Használhatjuk a Batch és aszinkron API előnyét, ami végső soron magas teljesítményt eredményezett, amely nagyon segített a nagy akciók idején (erről később).
Néhány szám az összehasonlításhoz:
- Felhasználók, akik nyereményeket kaptak Postgresben 20 szálon csoportosítás nélkül: 460713 bejegyzés 42 másodperc alatt.
- Elastic + reaktív kliens 10 szálon + batch 1000 elemre: 596749 bejegyzés 11 másodperc alatt.
- Elastic + reaktív kliens 10 szálon + batch 1000 elemre: 23801684 bejegyzés 4 perc alatt.
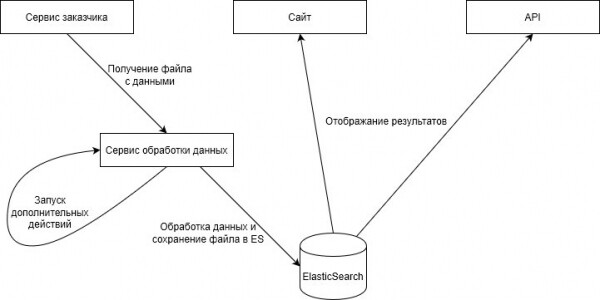
Jelenleg írtunk egy HTTP lekérdezéskezelőt, amely JSON-t épít, Batch/nem Batch formátumban, és bármilyen HTTP kliensen keresztül küld el, függetlenül a könyvtártól. Az is választható, hogy szinkron vagy aszinkron módon küldjük el a lekérdezéseket.
Néhány integrációban még mindig használjuk a hivatalos transport klienst, de ez csak a legközelebbi refaktorálás kérdése. Ezenkívül egy saját fejlesztésű klienst használunk, amely a Spring WebClient alapjain nyugszik.
Nagy akció
Évente egyszer nagyszabású akciót szervezünk a felhasználók számára — ez a Highload, mivel ilyenkor egyszerre több tízmillió felhasználóval dolgozunk.
Általában a forgalmi csúcsok ünnepi időszakokban fordulnak elő, de ez az akció — teljesen más szint. Két éve az akció napján 27 580 890 terméket adtunk el. Az adatok feldolgozása több mint fél óráig tartott, ami kellemetlenséget okozott a felhasználók számára. A felhasználók nyereményeket kaptak a részvételükért, de világossá vált, hogy a folyamatot gyorsítani kell.
2019 elején úgy döntöttünk, hogy szükség van az ElasticSearch-ra. Egy éven át szerveztük az érkező adatok feldolgozását Elastic-ben, és azok kiadását a mobilalkalmazás API-ján és a weboldalon. Ennek eredményeképpen a következő évben az akció alatt 15 131 783 rekordot dolgoztunk fel 6 perc alatt.
Mivel nagyon sokan szeretnének terméket vásárolni és részt venni a nyereményjátékokon, ez egy átmeneti intézkedés. Jelenleg a legfrissebb információkat az Elastic-be küldjük, de a jövőben tervezzük a múlt hónapokra vonatkozó archív információk átadását a Postgres-be, mint állandó tárolóba. Így elkerülhetjük az Elastic index felhalmozódását, amelynek szintén megvannak a saját korlátai.
Következtetések
Jelenleg az Elastic-be átkonvertáltunk minden szolgáltatást, amit szerettünk volna, és most egy kis szünetet tartunk. Jelenleg a fő tartós tároló fölé, a Postgres-be építünk egy indexet Elastic-ben, amely felveszi a felhasználói terhelést.
A jövőben tervezzük a szolgáltatások átadását, ha úgy érezzük, hogy az adatok lekérdezése túlságosan sokféle és korlátlan számú oszlopra keresünk. Ez már nem a Postgres feladata.
Ha szükségünk lesz teljes szöveges keresésre a funkcionálisan, vagy ha sokféle keresési kritériumunk lesz, akkor már tudjuk, hogy ezt át kell vinnünk az Elastic-be.
⌘⌘⌘
Köszönöm, hogy elolvastátok. Ha a cégetekben is használtok ElasticSearch-t, és vannak saját megvalósítási eseteitek, meséljetek róla. Érdekes lenne tudni, hogy másoknál hogyan működik 🙂
Forrás: habr.com
