

A ClickHouse analitikai DBMS különböző szövegeket dolgoz fel, fogyasztva az erőforrásokat. A rendszer teljesítményének javítása érdekében folyamatosan új optimalizálások kerülnek bevezetésre. A ClickHouse fejlesztője, Nikolai Kochetov beszél az új szöveg adattípusról, a LowCardinality-ról, és elmagyarázza, hogyan lehet gyorsítani a szövegekkel való munkát.
— Először nézzük meg, hogyan lehet szövegeket tárolni.
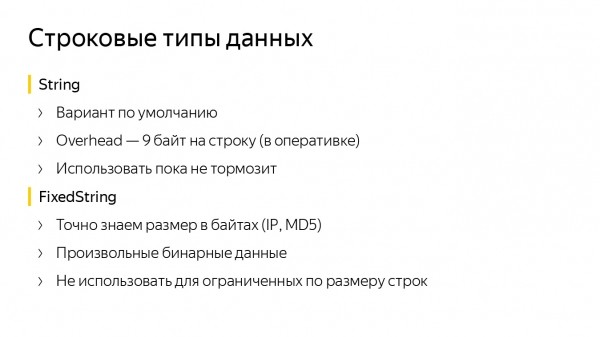
Van néhány szöveg adattípusunk. A String alapértelmezés szerint jól használható, érdemes szinte mindig ezt választani. Kis Overhead-dal rendelkezik — 9 byte egy szövegre. Ha szeretnénk, hogy a szövegek mérete fix és előre ismert legyen, akkor a FixedString használata a legjobb. Itt megadhatjuk a kívánt byte számot, ami kényelmes az IP-címek vagy hash-funkciók esetén.
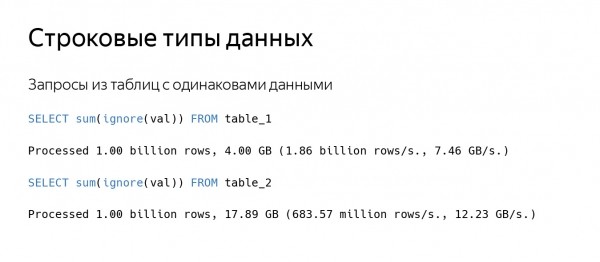
Természetesen néha valami lassít. Tegyük fel, hogy lekérdezést végzünk egy táblázatra. A ClickHouse meglehetősen nagy mennyiségű adatot olvas, például 100 GB/s sebességgel, de a feldolgozott sorok száma alacsony. Két táblánk van, amelyek szinte azonos adatokat tárolnak. A ClickHouse a második táblából gyorsabban olvas adatokat, de másodpercenként háromszor kevesebb sort olvas.
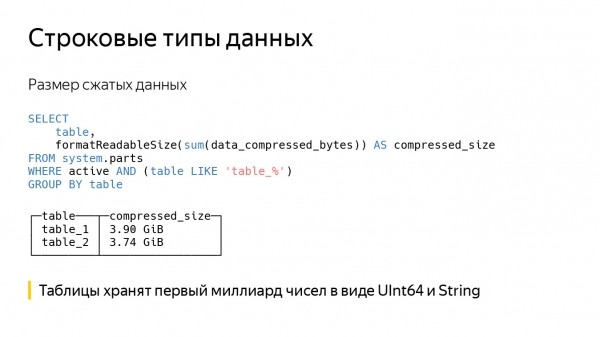
Ha megnézzük a tömörített adatok méretét, majdnem egyenlőnek találjuk. Valójában a táblákban ugyanazok az adatok vannak rögzítve - az első egy milliárd szám - csupán az első oszlopban UInt64-ként, a másodikban pedig String-ként. Ezért a második lekérdezés lassabban olvassa az adatokat a lemezről és tömöríti őket.
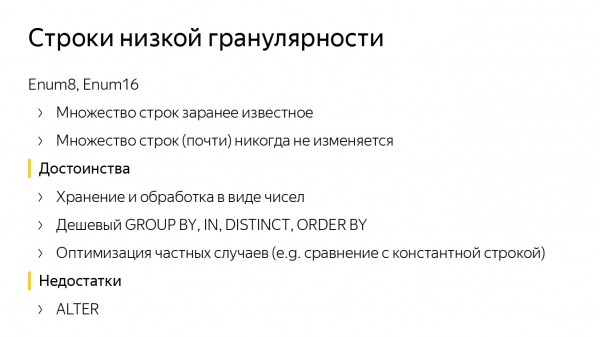
Itt van egy másik példa. Tegyük fel, hogy előre ismert szövegek halmazával van dolgunk, amelyet egy 1000 vagy 10 000-es konstans határoz meg, és gyakorlatilag soha nem változik. Ebben az esetben az Enum adattípus megfelelő számunkra, a ClickHouse-ban két fajtája van — Enum8 és Enum16. Az Enum tárolásának köszönhetően gyorsan dolgozzuk fel a lekérdezéseket.
A ClickHouse-ban vannak gyorsítások a GROUP BY, IN, DISTINCT parancsokhoz, és optimalizálások néhány funkcióhoz, például a konstans szövegek összehasonlításához. Természetesen a számokat a szövegben nem alakítják át, hanem éppen ellenkezőleg, a konstans szöveget Enum értékre alakítják. Ezután minden gyorsan összehasonlításra kerül.
De hátrányok is vannak. Még ha tudjuk is a pontos szövegek halmazát, néha azt bővíteni kell. Ha egy új szöveg érkezik — ALTER-t kell végeznünk.
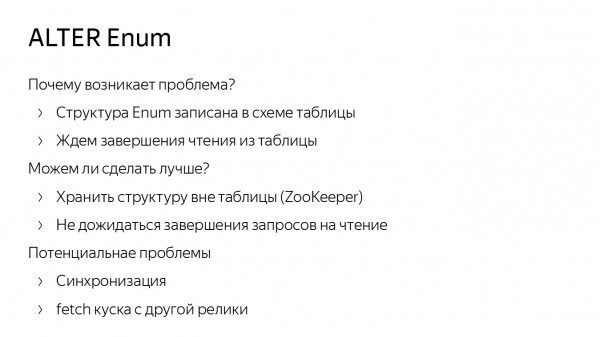
Az ALTER az Enum esetében a ClickHouse-ban optimálisan van megvalósítva. Nem írjuk felül az adatokat a lemezen, de az ALTER lelassulhat, mivel az Enum struktúrák a tábla sémájában találhatók. Ezért meg kell várnunk a tábla olvasási lekérdezéseit, például.
Felmerül a kérdés, lehet-e ezt jobban csinálni? Valószínűleg igen. Az Enum struktúrát nem lehetne a tábla sémájában tárolni, hanem a ZooKeeper-ben. Azonban szinkronizálási problémák adódhatnak. Például, ha az egyik replik megkapta az adatokat, a másik nem, és ha annak régi Enum-ja van, akkor valami elromlik. (A ClickHouse-nál közel vagyunk a nem blokkoló ALTER lekérdezések befejezéséhez. Amikor ez teljesen kész van, nem kell majd várni az olvasási lekérdezésekre.)
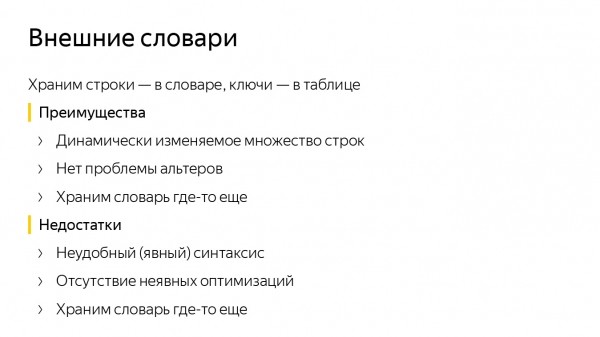
Az ALTER Enum kezelésének megkönnyítése érdekében használhatjuk a ClickHouse külső szótárakat. Emlékeztetnék, hogy ez egy kulcs-érték adatszerkezet a ClickHouse-ban, amely lehetővé teszi, hogy adatokat nyerjünk ki külső forrásokból, például MySQL táblákból.
A ClickHouse szótárban sok különböző karakterláncot tárolunk, míg a táblázatban azonosítóikat számok formájában tartjuk. Ha karakterláncot kell kapnunk, a dictGet funkciót hívjuk és ezzel dolgozunk. Ezután nem kell ALTER-t végrehajtanunk. Ha valamit hozzá akarunk adni az Enumhoz, azt ugyanabba a MySQL táblába illesztjük be.
De itt más problémák merülnek fel. Először is, a szintaxis nem kényelmes. Ha karakterláncot akarunk kapni, a dictGet-et kell hívnunk. Másodszor, bizonyos optimalizálások hiánya. A szótárakkal való konstans karakterlánccal való összehasonlítás nem olyan gyorsan elvégezhető.
Frissítési problémák is felmerülhetnek. Tegyük fel, hogy kérjük a karakterláncot a gyorsítótárazott szótárban, de nem került be a gyorsítótárba. Akkor várnunk kell, amíg az adatok betöltődnek a külső forrásból.
Mindkét módszer közös hátránya, hogy minden kulcsot egy helyen tárolunk, és ezeket szinkronizáljuk. Tehát miért ne tárolnánk a szótárakat helyben? Nincs szinkronizálás — nincsenek problémák. A szótárat helyben lehet tárolni egy lemezdarabban. Tehát végrehajtottuk az Insert parancsot, és leírtuk a szótárat. Ha az adatokkal a memóriában dolgozunk, akkor a szótárat a blokkokban, a tárolók egy darabjában, vagy valamilyen gyorsítótárban is rögzíthetjük, hogy felgyorsítsuk a számításokat.
Karakterláncok kódolása szótári formában
Így jutottunk el a ClickHouse új adattípusának megalkotásához — LowCardinality. Ez az adatok tárolási formátuma: hogyan írják őket a lemezre és hogyan olvassák, hogy miért vannak a memóriában és hogyan történik a feldolgozásuk.
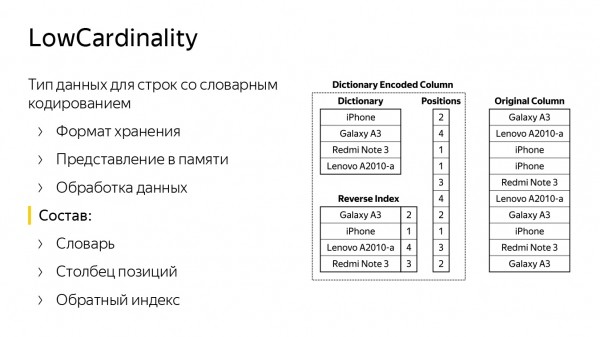
A dián két oszlopot tartalmaz. Jobbra a sorok állandóan String típusban tárolódnak. Látható, hogy ezek mobiltelefon modellek. Balra pontosan ugyanaz az oszlop található, csak LowCardinality típusban. Ez egy szótárból áll, amely sok különböző sort tartalmaz (a jobb oldali oszlop sorai) és egy pozíciós listából (a sorok száma).
Ezekkel a két struktúrával vissza lehet állítani az eredeti oszlopot. Van egy visszafelé index — egy hash-tábla, amely segít a szótárban megtalálni a pozíciót egy sor alapján. Ez a néhány lekérdezés gyorsításához szükséges. Például, ha össze szeretnénk hasonlítani, keresni szeretnénk egy sort a mi oszlopunkban, vagy össze szeretnénk vonni őket.
A LowCardinality egy paraméterezett adattípus. Ez lehet akár szám, akár valami, ami számként van tárolva, akár szöveg, akár Nullable ezekből.
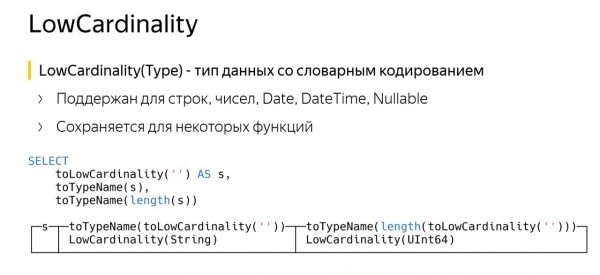
A LowCardinality sajátossága, hogy egyes függvények számára meg lehet tartani. A dián látható egy lekérdezés példája. Az első sorban létrehoztam egy LowCardinality típust a String-ből, elneveztem S-nek. Ezután megkérdeztem a nevét — a ClickHouse azt mondta, hogy ez LowCardinality a String-ből. Minden rendben van.
A harmadik sor szinte ugyanolyan, csak a length függvényt hívtuk meg. A ClickHouse-ban a length függvény UInt64 adattípust ad vissza. De nálunk LowCardinality lett az UInt64-ből. Mi ennek a jelentősége?
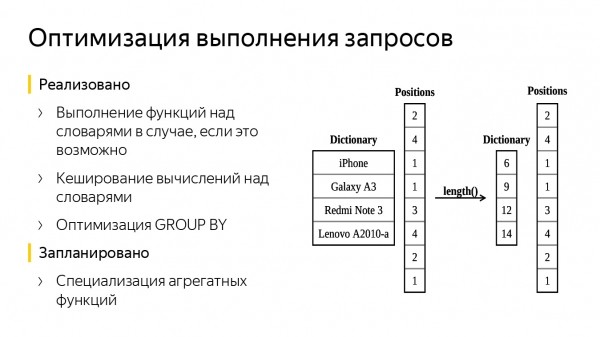
A szótárban mobiltelefonok nevei voltak, alkalmaztuk a length függvényt. Most egy analóg szótárunk lett, amely csak számokból áll — ezek a sztringek hossza. A pozíciós oszlop nem változott. Végül kevesebb adatot dolgoztunk fel, így időt takarítottunk meg a lekérdezés során.
Lehetnek más optimalizálások is, például egy egyszerű gyorsítótár hozzáadása. A függvény értékének kiszámítása során el lehet raktározni, és egy hasonlót összeállítani anélkül, hogy újra kiszámítanánk.
Továbbá lehet optimalizálni a GROUP BY-t is, mert a szótáros oszlopunk már részlegesen aggregált — gyorsabban lehet kiszámítani a hash-függvények értékeit, és körülbelül meghatározni, hova helyezzük az új sort. Továbbá néhány aggregáló függvényt is specializálhatunk, például a uniq-ot, mivel csak a szótárt lehet elküldeni, míg a pozíciók érintetlenül maradnak — így minden gyorsabban működik. Az első két optimalizálást már hozzáadtuk a ClickHouse-hoz.
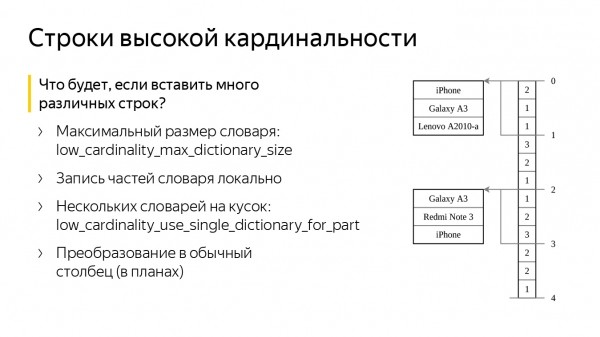
Mi történik, ha létrehozunk egy oszlopot a saját adattípusunkkal, és sok rossz különböző sort illesztünk be? Nem fogja túlcsordulni a memóriánkat? Nem, erre a ClickHouse-ban két speciális beállítás van. Az első a low_cardinality_max_dictionary_size. Ez a dizájn maximális mérete, amelyet le lehet írni a lemezre. Az illesztés a következőképpen történik: amikor adatokat illesztünk be, egy nagy közös szótárat alakítunk ki az érkező sorokból. Ha a szótár mérete meghaladja a beállítás értékét, a jelenlegi szótárt leírjuk a lemezre, míg a többi sort valahol „oldalt” tároljuk az indexek közelében. Végül soha nem számoljuk újra a nagy szótárt, tehát nem lesznek memória problémáink.
A második beállítást low_cardinality_use_single_dictionary_for_part-nak hívják. Képzelje el, hogy a korábbi sémában, amikor adatokat illesztettünk be, a szótárunk túlcsordult, és azt leírtuk a lemezre. Felmerül a kérdés, miért ne alakítanánk most egy újabb pontosan olyan szótárt?
Amikor az újabb túlcsordul, azt ismét leírjuk a lemezre, és elkezdjük a harmadikat kialakítani. Ez a beállítás alapértelmezetten éppen ezt a lehetőséget kapcsolja ki.
Valójában sok szótár hasznos lehet, ha tömegesen szeretnénk adatokat illeszteni, de véletlenül "szemét" adatok kerülnek be. Mondjuk, először rossz sorokat illesztettünk be, majd jót. Ekkor a szótár sok kis szótárra fog oszlani. Néhány közülük "szemét" lesz, de az utolsók jó sorokat tartalmaznak. Ha például csak az utolsó granulát olvassuk el, akkor minden gyorsan fog működni.
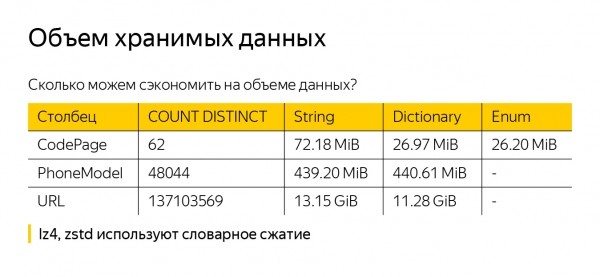
Mielőtt a LowCardinality előnyeiről beszélnénk, azonnal elmondom, hogy valószínűleg nem fogunk elérni lemezterület-csökkenést (bár ez megtörténhet), mivel a ClickHouse tömöríti az adatokat. Van egy alapértelmezett opció — LZ4. Továbbá lehetséges ZSTD tömörítést is alkalmazni. De mindkét algoritmus már megvalósít szótári tömörítést, tehát a mi külső szótárunk a ClickHouse-nál nem lesz nagy segítség.
Annak érdekében, hogy ne csak a szavakat használjam, néhány adatot vettem a metrikából - String, LowCardinality(String) és Enum - és eltérő adattípusokba mentettem őket. Három oszlopot kaptunk, amelyek egy milliárd sort tartalmaznak. Az első oszlopban, a CodePage-en, mindössze 62 érték található. Látható, hogy a LowCardinality(String) jobban tömörített. A String kicsit gyengébben, de valószínűleg azért, mert a karakterláncok rövidek, tároljuk a hosszúságukat, ami sok helyet foglal el, és rosszul tömörül.
Ha megnézzük a PhoneModel-t, azok 48 ezer - már több, és a különbség a String és LowCardinality(String) között szinte észrevehetetlen. Az URL esetében is mindössze 2 GB-ot takarítottunk meg - úgy gondolom, erre nem érdemes támaszkodni.
A teljesítményértékelés
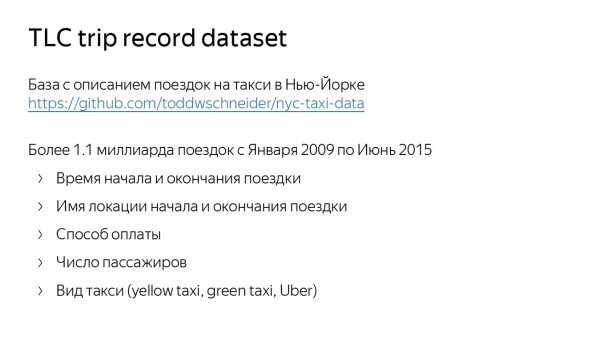
Most értékeljük a teljesítményt. Az értékeléshez egy New York-i taxiútadatbázist használtam. Ez a GitHub-on található. Több mint egy milliárd utazást tartalmaz. Mindenben tükröződik a helyszín, az utazás kezdési és befejezési ideje, a fizetési mód, az utasok száma, sőt még a taxi típusa is - zöld, sárga és Uber.
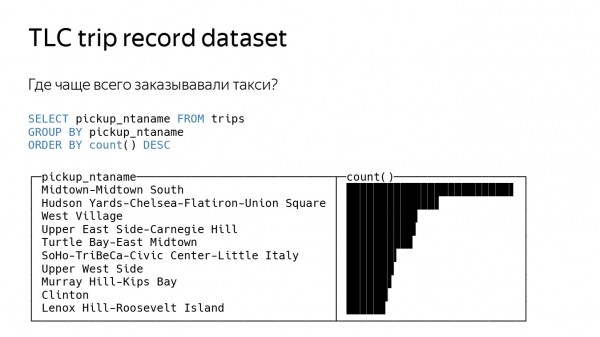
Az első lekérdezést meglehetősen egyszerűre készítettem - azt kérdeztem, hol rendelik a legtöbbször a taxit. Ehhez szükséges a helyszín, ahonnan rendeltek, GROUP BY-t kell végezni, és megszámolni a count függvényt. Ezzel a ClickHouse valami kiad.
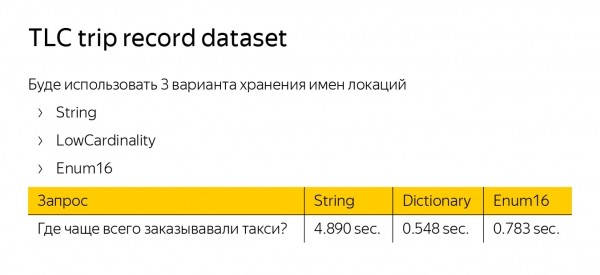
A lekérdezés feldolgozási sebességének mérésére három táblát készítettem azonos adatokkal, de három különböző adattípust használtam a kiindulási helyszínünkhöz - String, LowCardinality és Enum. A LowCardinality és az Enum ötször gyorsabbnak bizonyult a Stringnél. Az Enum gyorsabb, mert számokkal dolgozik. A LowCardinality pedig azért, mert megvalósították a GROUP BY optimalizálást.
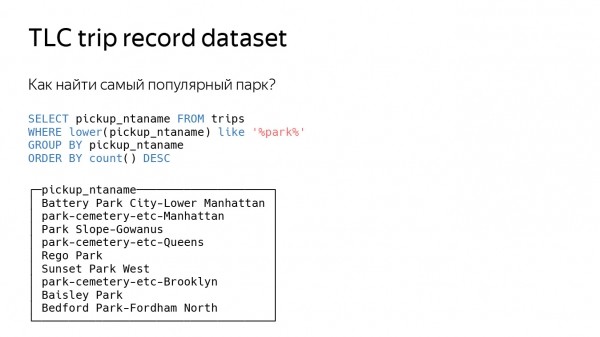
Nézzük meg, hogyan bonyolíthatnánk a lekérdezést - kérdezzük meg, hol található a legnépszerűbb park New Yorkban. Ismét azt mérjük, hol rendelik a legtöbbet a taxit, de szűrjük azokat a helyszíneket, ahol szerepel a „park” szó. Ezen kívül hozzáadunk egy like függvényt.
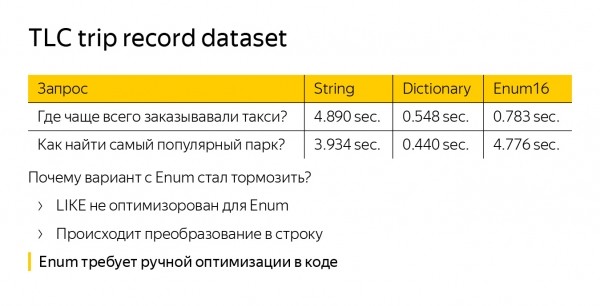
Megnézzük az időt - látjuk, hogy az Enum hirtelen elkezdett lelassulni. Ráadásul még lassabban is működik, mint a standard String adattípus. Ennek oka, hogy a like függvény egyáltalán nem optimalizált az Enum esetén. Átalakítanunk kell a Stringjeinket Enum-ból normál String-ekké - több munkát végzünk. A LowCardinality(String) alapértelmezés szerint szintén nem optimalizált, de ott a like a szótáron működik, így a lekérdezés felgyorsul a Stringhez képest.
Az Enum használatakor egy komolyabb probléma merül fel. Ha optimalizálni akarjuk, azt a kód minden helyén meg kell tennünk. Tegyük fel, hogy írtunk egy új funkciót - feltétlenül ki kell találnunk az Enum optimalizálását. Ezzel szemben a LowCardinality alapértelmezetten optimalizálva van.
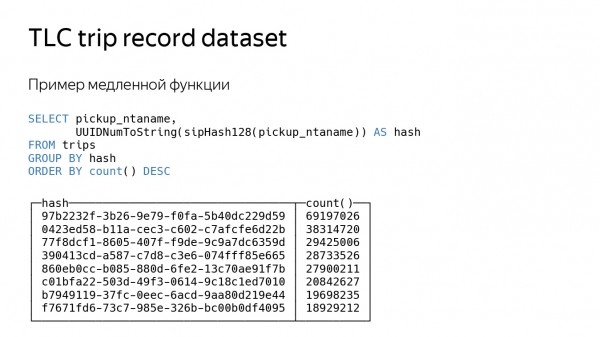
Nézzük meg az utolsó, mesterséges példát. Egyszerűen csak kiszámítjuk a helyünk hash-funkcióját. A hash-funkció elég lassú lekérdezés, sokáig tart, ezért minden körülbelül háromszor lassabb lesz.
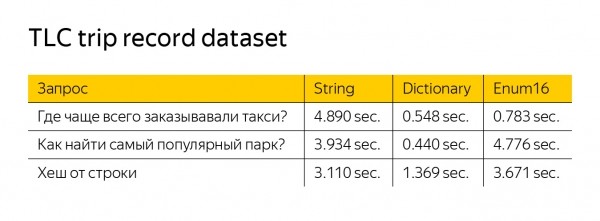
A LowCardinality még mindig gyorsabb, bár itt nincs szűrés. Ez azért van, mert a funkcióink csak a szótáron dolgoznak. A hash számítására vonatkozó funkciónak egy argumentuma van - kevesebb adatot tud kezelni, és szintén vissza tud adni LowCardinality-t.
Globális tervünk az, hogy a teljesítményünk bármilyen esetben ne legyen alacsonyabb, mint a String-é, és megőrizzük az optimalizálásokat. Lehet, hogy egyszer majd a String-et LowCardinality-ra cseréljük, frissíti a ClickHouse-t, és minden egy kicsit gyorsabban fog működni.
Forrás: habr.com
