

Mi késztethet egy akkora céget, mint a Lamoda, amelynek jól bevált folyamatai és tucatnyi kölcsönösen összefüggő szolgáltatása van, hogy drasztikus módon megváltoztassa a megközelítését? A motiváció teljesen eltérő lehet: a jogi előírásoktól kezdve a programozókra jellemző kísérletezési vágyig.
De ez egyáltalán nem jelenti azt, hogy ne számíthatnánk további előnyökre. Konkrétan miben lehet nyerni, ha bevezetjük az eseményalapú API-t Kafka segítségével, arról Szergiej Zaika beszél majd (). Kötelezőek lesznek a tapasztalataink és a érdekes felfedezések is – nem lehet kísérlet nélkülük.
Megjegyzés: Ez a cikk a Szergiej által 2018 novemberében a HighLoad++ során tartott meetup anyagain alapul. A Lamoda Kafka-val kapcsolatos tapasztalata élénken vonzotta a hallgatóságot, hiszen a többi előadás is nagy érdeklődést keltett. Úgy véljük, ez egy nagyszerű példa arra, hogy mindig lehet és kell is keresni az egyetértő feleket, és a HighLoad++ szervezői a jövőben is igyekezni fognak olyan légkört teremteni, amely ezt elősegíti.
A folyamatról
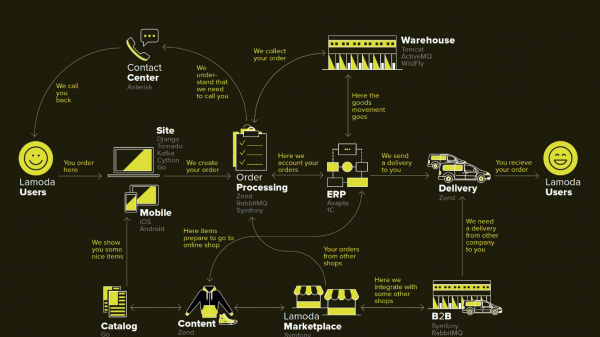
A Lamoda egy nagy e-kereskedelmi platform, amely rendelkezik saját ügyfélszolgálatával, szállító szolgáltatással (és számos partnerrel), fotóstúdióval, hatalmas raktárral, és mindez a saját szoftverén működik. Számtalan fizetési mód és b2b-partner van, akik használhatják ezeket a szolgáltatásokat, és szeretnék tudni a legfrissebb információkat termékeikről. Ráadásul a Lamoda három országban is működik az orosz Föderáción kívül, ahol minden kicsit másként történik. Összességében több mint száz módja létezik egy új rendelés konfigurálásának, amelyeket különbözőképpen kell feldolgozni. Mindez több tucat szolgáltatással működik, amelyek néha nem nyilvánvaló módon kommunikálnak egymással. Van egy központi rendszer is, amelynek fő feladata a rendelés státuszának kezelése. Ezt BOB-nak hívjuk, én dolgozom vele.
Visszatérítési eszköz eseményalapú API-val
Az eseményalapú kifejezés elég elcsépelt, kicsit később részletesebben meghatározzuk, mit is értünk ez alatt. Azt a kontextust szeretném bemutatni, amelyben eldöntöttük, hogy kipróbáljuk az eseményalapú API megközelítést a Kafka használatával.
Bármely boltban, a megrendelések mellett, amelyek után a vásárlók fizetnek, vannak olyan pillanatok is, amikor a bolttól azt várják el, hogy visszatérítse a pénzt, mert az ügyfélnek nem felelt meg a termék. Ez a viszonylag rövid folyamat: szükség esetén tisztázzuk az információkat, majd elindítjuk a visszatérítést.
A visszatérítési folyamat bonyolultabbá vált a jogszabályi változások miatt, és kötelezővé vált, hogy egy külön mikroszolgáltatást valósítsunk meg ennek megfelelően.
Motivációnk:
- 54. számú törvény — röviden, a törvény megköveteli, hogy minden pénzügyi tranzakcióról, legyen az visszatérítés vagy bevétel, rövid SLA keretében, pár percen belül tájékoztassuk az adóhatóságot. Mi, mint e-kereskedelmi vállalat, számos tranzakciót bonyolítunk. Technikai értelemben ez új felelősséget jelent (tehát új szolgáltatást) és fejlesztéseket a kapcsolódó rendszerekben.
- BOB split — a cég belső projektje, amelynek célja BOB-tól a nem főbb feladatok eltávolítása és összetettségének csökkentése.
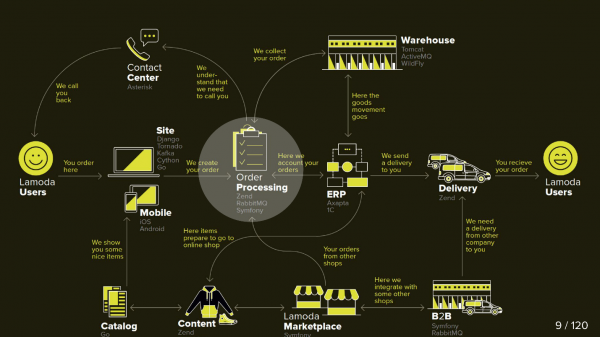
Ezen a diagramon a Lamoda főbb rendszerei láthatók. Jelenleg ezek többsége inkább 5-10 mikroszolgáltatásból álló csillaghalmazként funkcionál a csökkenő monolit körül.Fokozatosan nőnek, de próbáljuk őket kisebbre venni, mert félelmetes egy középső részt telepíteni — nem engedhetjük meg, hogy leálljon. Minden adatcsere (nyilak) esetén tartalékolnunk kell, mert bármelyikük elérhetetlenné válhat.
A BOB-ban is elég sok adatcsere van: fizetési, szállítási rendszerek, értesítések stb.
Technikailag a BOB a következőkből áll:
- ~150k sor kód + ~100k sor teszt;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 kimenő integráció;
- 4 ország a saját üzleti logikájával.
A BOB telepítése drága és fájdalmas, a kód mennyisége és az általa megoldott feladatok olyannyira komplexek, hogy senki sem képes minden részletét teljesen átlátni. Összességében sok ok van a leegyszerűsítésére.
A visszatérítési folyamat
Kezdetben két rendszer van bevonva a folyamatba: BOB és Payment. Most már újabb kettő is csatlakozik:
- Fiscalization Service, amely átvállalja a fiskalizálási problémákat és a külső szolgáltatásokkal való kommunikációt.
- Refund Tool, amely lehetővé teszi az új adatcserék kiemelését, hogy ne bővítsük tovább a BOB-ot.
Most a folyamat így néz ki:
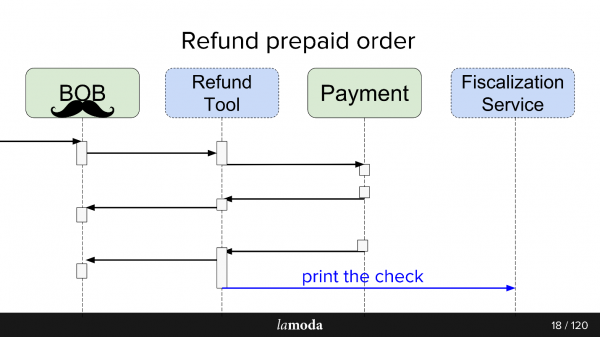
- A BOB-hoz érkezik egy kérés a pénz visszatérítésére.
- A BOB tájékoztatja erről a Refund Tool-t.
- A Refund Tool azt mondja a Payment-nek: „Itt a pénz visszatérítése”.
- A Payment visszatéríti a pénzt.
- A Refund Tool és a BOB szinkronizálják az állapotokat, mert egyelőre mindkettőnek szüksége van rá. Még nem vagyunk teljesen készen a Refund Tool-ra való áttéréshez, mivel a BOB-nak van UI-ja, könyvelési jelentések és sok olyan adat, amelyet így nem lehet egyszerűen áthelyezni. Két szék között kell egyensúlyozni.
- Kérdés küldése a fiskalizálásra.
A végeredmény az lett, hogy létrehoztunk egy eseménybuszt a Kafkán, amire minden épült. Hurrá, most van egy központi hibapontunk (irónia).
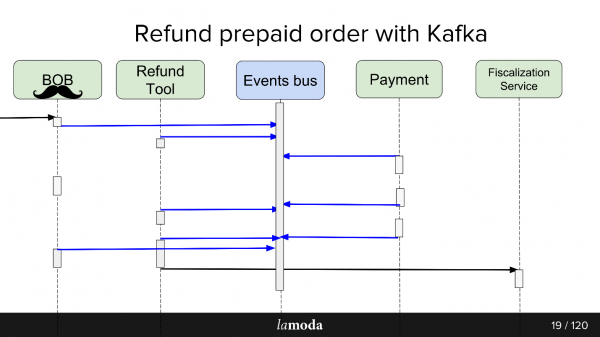
A pozitívumok és negatívumok egyértelműek. Létrehoztunk egy buszt, így most minden szolgáltatás tőle függ. Ez leegyszerűsíti a tervezést, de egy központi hibapontot is bevezet a rendszerbe. Ha a Kafka leáll, a folyamat megáll.
Mi az eseményalapú API?
Egy jó válasz erre a kérdésre Martin Fowler (GOTO 2017) előadásában található. .
Röviden, amit csináltunk:
- Központosítottá tettük az összes aszinkron cserét eseménytároló révén.Ahelyett, hogy a hálózaton minden érdekelt fogyasztót értesítenénk az állapotváltozásról, írtunk egy eseményt a központosított tárolóba az állapotváltozásról, és az érdekeltek olvasnak mindent, ami megjelenik ott.
- Az esemény egy értesítés (értesítések) arról, hogy valami megváltozott valahol. Például megváltozott a rendelés státusza. A fogyasztó, akinek fontosak a státuszmódosításhoz kapcsolódó adatok, amit az értesítés nem tartalmaz, magának tudhatja meg azok állapotát.
- A maximális variáció a teljes eseményforrás használata, állapotátvitel, amelyben az esemény minden információt tartalmaz, ami a feldolgozáshoz szükséges: honnan és milyen státuszba kerültek, hogyan változtak az adatok stb. Csak a célszerűség és az információk mennyisége a kérdés, amit megengedhetünk magunknak tárolni.
A Refund Tool bevezetése során a harmadik változatot használtuk. Ez megkönnyítette az események feldolgozását, mivel nem kellett részletes információt kinyerni, és kizárta azon forgatókönyvet, amikor minden új esemény újabb tisztázó get-kéréseket generál a fogyasztóktól.
A Refund Tool szolgáltatás nem terhelt, ezért a Kafka ott inkább egy próbálkozás, mint szükségszerűség. Nem hiszem, hogy a visszatérítési szolgáltatás highload projektté vált volna, az üzlet örült volna.
Aszinkron csere JELENLEG
Aszinkron cserékhez a PHP osztály általában RabbitMQ-t használ. Összegyűjtöttük az adatokat a kéréshez, beraktuk a sorba, és a fogyasztó ugyanonnan kiolvasta és elküldte (vagy nem küldte el). Magához az API-hoz a Lamoda aktívan használja a Swagger-t. Megtervezzük az API-t, leírjuk a Swaggerben, és generálunk kliens- és szerverkódot. Ezen kívül egy kicsit kiterjesztett JSON RPC 2.0-t is használunk.
Néhány helyen esb buszokat használnak, mások activeMQ-n élnek, de összességében, RabbitMQ - szabvány.
Async exchange TO BE
Az esemény buszra történő cserék tervezése során analógiát vonhatunk. Hasonló módon írjuk le az adatcserét az események szerkezetének leírása révén. A YAML formátumú kódgenerálást magunknak kellett megvalósítanunk, a specifikációnak megfelelően a generátor DTO-t hoz létre, és megtanítja az ügyfeleknek és a szervereknek, hogyan dolgozzanak vele. A generálás két nyelven történik - golang és php. Ez lehetővé teszi, hogy a könyvtárak összhangban maradjanak. A generátort golang nyelven írták, ezért gogi nevet kapta.
Az eseményforrás Kafka segítségével - tipikus dolog. Van megoldás a fő vállalati verziótól, a Kafka Confluenttől, van , a Zalando domain területén lévő 'testvéreink' megoldása. A motivációnk, hogy a vanilla Kafkával kezdjünk, az, hogy a megoldás ingyenes maradjon, amíg véglegesen el nem döntjük, hogy széles körben használni fogjuk, és hogy legyen mozgásterünk a fejlesztésre: támogatni szeretnénk a saját JSON RPC 2.0 , generátorokat két nyelvhez, és megnézzük, mi még.Ironikus, hogy még egy ilyen boldog helyzetben is, ahol van körülbelül hasonló üzlet, mint a Zalando, amely hasonló megoldást működtetett, nem tudjuk hatékonyan kihasználni.
Architekturálisan a futtatáskor a minta a következő: közvetlenül olvasunk a Kafkából, de csak az esemény buszon keresztül írunk. Számos már meglévő megoldás van a Kafka olvasására: brókerek, terheléselosztók, melyek többé-kevésbé felkészültek a vízszintes skálázásra, ezt meg akartuk őrizni. Az írás azonban átkonfigurálva, egy Gateway-n keresztül történik, más néven Events-bus, és ez az oka.
Events-bus
Vagy esemény busz. Ez egy egyszerű stateless HTTP gateway, amely több fontos szerepet vállal:
A gyártás érvényesítése
- ellenőrizzük, hogy az események megfelelnek-e a specifikációnknak. Események fő rendszer
- , ez az egyetlen rendszer a cégen belül, amely válaszol azokra a kérdésekre, hogy mely események és milyen szerkezetek számítanak érvényesnek. Az érvényesítés magában foglalja az adattípusokat és az enumokat a tartalom szigorú specifikációjára.Hash-funkció
- a sharding számára - a Kafka üzenetszerkezete kulcs-érték pár, és a kulcs hash-e alapján számítódik, hová kell ezt elhelyezni. Miért
Egy nagy cégnél dolgozunk, amelynek jól bejáratott folyamata van. Miért kellene bármit is megváltoztatni?
Ez egy kísérlet , és számítunk arra, hogy több előnyt szerzünk.1:n+1 cserék (egy a sokhoz)
A Kafkával nagyon könnyű új fogyasztókat csatlakoztatni az API-hoz.
A Kafka segítségével nagyon könnyen csatlakoztathatunk új fogyasztókat az API-hoz.
Tegyük fel, hogy van egy adatbázis, amelyet több rendszert egyszerre kell frissíteni (és új rendszerekben is). Korábban létrehoztunk egy bundle-t, amely megvalósította a set API-t, és a főrendszernek jeleztük a fogyasztók címét. Most a főrendszer frissítéseket küld a témába, és mindenki, akit ez érdekel, elolvassa. Megjelent egy új rendszer — a témára feliratkoztunk. Igen, ugyanaz a bundle, de egyszerűbb.
A refund-tool esetében, amely lényegében a BOB egy része, kényelmes, ha a Kafka segítségével tartjuk őket szinkronban. A Payment azt mondja, hogy a pénz vissza lett térítve: a BOB, a RT erről értesült, statusaikat megváltoztatták, a Fiscalization Service is tudomást szerzett róla, és kiállította a blokkot.
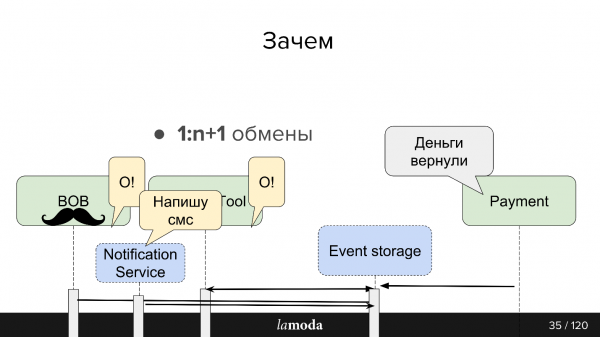
Tervezzük, hogy létrehozunk egy egységes Notifications Service-t, amely értesíti az ügyfelet a rendeléseivel/visszatérítéseivel kapcsolatos hírekről. Jelenleg ez a felelősség szétszórva van a rendszerek között. Elég, ha megtanítjuk a Notifications Service-t, hogy a Kafka-ból releváns információkat szűrjön ki és reagáljon ezekre (és leállítjuk a többi rendszeren ezeket az értesítéseket). Nincs szükség új közvetlen cserék kialakítására.
Adatok vezérelt
Az információk átláthatóvá válnak a rendszerek között — bármilyen „vérző vállalat” is álljon a háttérben, és akármilyen vastag legyen a backlog-otok. A Lamodánál van egy Data Analytics osztály, amely adatokat gyűjt a rendszerekből, és újrahasználható formába rendezi őket, mind az üzlet, mind az intelligens rendszerek számára. A Kafka lehetővé teszi, hogy gyorsan sok adatot biztosítsunk számukra, és folyamatosan naprakészen tartsuk ezt az információs áramlást.
Replikációs napló
Az üzenetek nem tűnnek el az olvasás után, mint a RabbitMQ-ban. Amikor az esemény elegendő információt tartalmaz a feldolgozáshoz, rendelkezésünkre áll az objektum utolsó változásainak története, és ha akarjuk, lehetőségünk van ezeket a változásokat alkalmazni.
A replikációs napló tárolási ideje a téma írási intenzitásától függ, a Kafka lehetővé teszi, hogy rugalmasan beállítsuk a tárolási időkorlátokat és az adatmennyiséget. Intenzív témák esetén fontos, hogy minden fogyasztó időben el tudja olvasni az információt, mielőtt az eltűnik, még akkor is, ha átmeneti leállás van. Általában sikerül az adatokat a napok egységeiig, ami teljesen elegendő a támogatás számára.
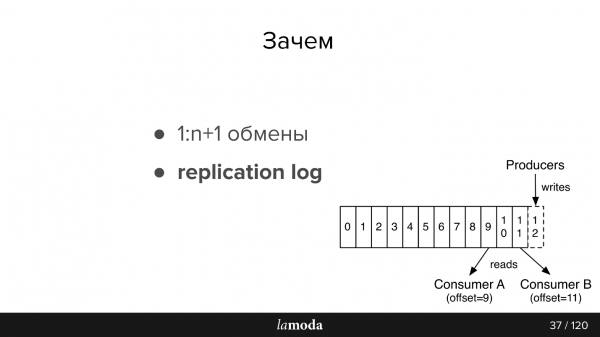
Kicsit még a dokumentáció átírása, azok számára, akik nem ismerik a Kafkát (a kép szintén a dokumentációból származik)
Az AMQP-ban vannak sorok: üzeneteket írunk a fogyasztó sorába. Általában egy sorral egy rendszer foglalkozik, amelynek ugyanaz a üzleti logikája. Ha több rendszert kell értesíteni, az alkalmazást meg lehet tanítani, hogy több sorba írjon, vagy beállíthatunk egy exchange-et fanout mechanizmussal, amely saját magát klónozza.
A Kafka hasonló absztrakcióval rendelkezik téma, ahová üzeneteket ír, de azok nem tűnnek el az olvasás után. Alapértelmezés szerint, amikor csatlakozik a Kafkához, megkapja az összes üzenetet, és van lehetősége megőrizni azt a helyet, ahol abbahagyta. Tehát folyamatosan olvas, nem kell megjelölnie az üzenetet olvasottként, de megőrizheti az id-t, ahonnan folytatja az olvasást. Az id, ahol megállt, offset-nek (eltolás) nevezzük, a mechanizmus pedig commit offset.
Ennek megfelelően különböző logikát lehet megvalósítani. Például a BOB négy példányban létezik különböző országok számára – a Lamoda Oroszországban, Kazahsztánban, Ukrajnában és Fehéroroszországban elérhető. Mivel külön telepítik őket, kicsit eltérő konfigurációik és saját üzleti logikájuk van. Az üzenetben megadjuk, hogy melyik országhoz tartozik. Minden egyes BOB fogyasztó minden országban különböző groupId-kkal olvas, és ha az üzenet nem a saját országához tartozik, akkor átugorja azt, tehát azonnal commitolja az offset +1-et. Ha ugyanaz a téma olvassa a Payment Service-t, akkor külön csoporttal csinálja, így az offset-ek nem metszik egymást.
Az eseményekre vonatkozó követelmények:
- Az adatok teljessége. Szeretnénk, ha az eseményben elegendő adat lenne ahhoz, hogy feldolgozható legyen.
- Integritás. Az Events-busra bízzuk, hogy ellenőrizze, hogy az esemény következetes-e, és hogy képes-e azt feldolgozni.
- Fontos a sorrend. Visszatérés esetén kénytelenek vagyunk a történelemmel dolgozni. Az értesítések esetében a sorrend nem fontos, ha homogén értesítésekről van szó, az e-mail azonos lesz, függetlenül attól, hogy melyik rendelés érkezett előbb. Visszatérés esetén világos folyamat van, ha megváltoztatjuk a sorrendet, akkor kivételek léphetnek fel, a refund nem jön létre vagy nem kerül feldolgozásra – más állapotba kerülünk.
- Konzisztencia. Van egy tárolónk, és most eseményeket hozunk létre API helyett. Szükségünk van egy módra, hogy gyorsan és olcsón továbbítsuk a szolgáltatásainkba az új eseményekről és a már meglévő változásokról szóló információkat. Ezt egy közös specifikációval érjük el egy külön git-reposzitoriumban és kódgenerátorok segítségével. Így az ügyfelek és a szerverek a különböző szolgáltatásokban össze vannak hangolva.
Kafka a Lamodában
Három Kafka telepítésünk van:
- Naplók;
- R&D;
- Esemény-busz.
Ma csak az utolsó pontról fogunk beszélni. Az esemény-buszunk nem túl nagy telepítésekből áll - 3 bróker (szerver) és összesen 27 téma van. Általában egy téma egy folyamatot jelent. De ez egy finom dolog, és most foglalkozni fogunk vele.
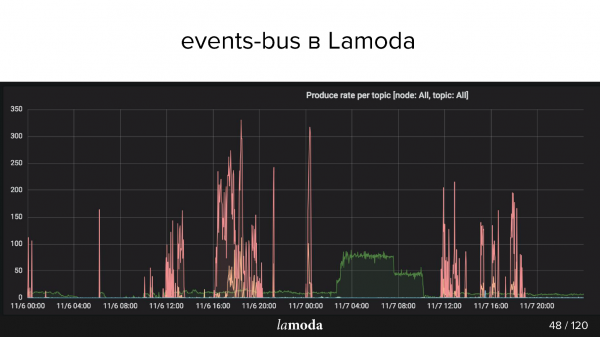
Fent a rps grafikon. A visszatérítési folyamat a ciánkék vonallal van megjelölve (igen, az, amelyik az X tengelyen fekszik), a rózsaszín pedig a tartalom frissítésének folyamata.
A Lamoda katalógusában millió termék található, és az adatok folyamatosan frissülnek. Egyes kollekciók kimentek a divatból, újakat adnak ki helyettük, a katalógus folyamatosan új modellekkel bővül. Folyamatosan próbáljuk megjósolni, mi lesz érdekes az ügyfeleink számára holnap, ezért folyamatosan új dolgokat vásárolunk, fényképezzük őket, és frissítjük a vitrinünket.
A rózsaszín csúcsok a termékfrissítéseket jelölik, tehát a termékeken végrehajtott változtatásokat. Látható, hogy a srácok fényképezték, fényképezték, majd hirtelen! - betöltöttek egy csomó eseményt.
Lamoda eseményhasználati esetek
Az épített architektúrát az alábbi műveletekhez használjuk:
- A visszatérítések státuszának nyomon követése: call-to-action és a státuszok nyomon követése minden érintett rendszerből. Fizetés, státuszok, fiskalizáció, értesítések. Itt kipróbáltuk az megközelítést, készítettünk eszközöket, összegyűjtöttük az összes hibát, dokumentációt írtunk, és elmondtuk a kollégáknak, hogyan használják ezt.
- Termékadatlap frissítése: konfiguráció, metaadatok, jellemzők. Egy rendszer olvas (ami megjeleníti), míg több ír.
- Email, push és sms: a rendelés összeállt, a rendelés megérkezett, a visszatérés elfogadva, stb., sok van belőlük.
- Készlet, a raktár frissítése — mennyiségi frissítés az elemekről, csak számok: készletbe érkezés, visszatérés. Meg kell győződni arról, hogy minden termékfenntartással kapcsolatos rendszer a lehető legaktuálisabb adatokkal dolgozik. Jelenleg a készletfrissítési rendszer meglehetősen bonyolult, a Kafka lehetővé teszi ennek egyszerűsítését.
- Adat elemzés (K+F osztály), ML eszközök, analitika, statisztika. Azt szeretnénk, ha az információ átlátható lenne – ezért a Kafka jól megfelel.
Most jöjjön a szórakoztatóbb rész a tapasztalatokról és a figyelemre méltó felfedezésekről, amelyek az elmúlt fél évben történtek.
Tervezési problémák
Tegyük fel, hogy szeretnénk létrehozni egy új dolgot – például átállítani a Kafka-ra az egész szállítási folyamatot. Jelenleg a folyamat egy része az Order Processing-ben van a BOB-ban. A rendelés szolgáltatásra továbbítása, az átmeneti raktárba történő áthelyezés és hasonlók mögött egy státuszmodell áll. Van egy nagy monolit, sőt kettő, ráadásul egy csomó API, amely a szállítással foglalkozik. Sokkal többet tudnak a szállításról.
Úgy tűnik, hogy ezek hasonló területek, de az Order Processing a BOB-ban és a szállítási rendszer esetében a státuszok eltérnek. Például egyes futárszolgálatok nem küldenek köztes státuszokat, csak véglegeseket: „kézbesítették” vagy „elveszett”. Mások viszont nagyon részletesen tájékoztatnak az áruk mozgásáról. Mindnek megvannak a saját validációs szabályai: valakinek egy érvényes email címmel már feldolgozzák; másoknál érvénytelen, de a rendelés még mindig feldolgozásra kerül, mert van telefonszám a kapcsolattartásra, és van, aki azt mondja, hogy az ilyen rendelést egyáltalán nem fogják feldolgozni.
Adatfolyam
A Kafka esetében felmerül az adatfolyam megszervezésének kérdése. Ez a feladat a stratégia kiválasztásával kapcsolatos több szempontból, végigmegyünk az összesen.
Egy témába vagy különböző témákba?
Van egy eseményspecifikációnk. A BOB-ban azt írjuk, hogy egy adott rendelést szállítani kell, és megadjuk: a rendelés száma, összetevői, SKU-k, vonalkódok stb. Amikor az áru megérkezik a raktárba, a szállítás képes lesz megkapni a státuszokat, időbélyegeket és minden szükséges információt. De ezután szeretnénk a BOB-ban frissítéseket kapni ezekről az adatokból. Van egy visszafordított adatgyűjtési folyamat a szállítástól. Ez ugyanaz az esemény? Vagy ez egy külön csere, amely külön témát érdemel?
Valószínűleg nagyon hasonlóak lesznek, és a kísértés, hogy egy téma legyen, nem alaptalan, mert egy külön téma külön fogyasztókat, külön konfigurációkat és annak minden generálását jelent. De nem biztos.
Új mező vagy új esemény?
De ha ugyanazokat az eseményeket használjuk, akkor egy másik probléma merül fel. Például nem minden kézbesítési rendszer képes olyan DTO-t generálni, amely képes BOB-ot generálni. Az ID-t küldjük nekik, de ők nem mentik el, mert nem szükséges számukra, és az event-bus folyamatának kezdése szempontjából ez a mező kötelező.
Ha bevezetünk egy szabályt az event-bus számára, hogy ez a mező kötelező, akkor kénytelenek vagyunk BOB-ban vagy a kezdő esemény kezelőben további validálási szabályokat megállapítani. A validálás szétszóródik a szolgáltatáson — ez nem túl kényelmes.
Egy másik probléma a fokozatos fejlesztés csábítása. Azt mondják nekünk, hogy valamit hozzá kell adni az eseményhez, és talán, ha jól belegondolunk, ez külön eseménynek kellett volna lennie. De a séma szerint a külön esemény külön topik. A külön topik az az egész folyamat, amelyet fentebb leírtam. A fejlesztőben felmerül a csábítás, hogy csak hozzáadjon egy új mezőt a JSON sémához és újragenerálja.
A refunds esetében így jutottunk el fél év alatt az események eseményéhez. Volt egy meta-eseményünk, ami refund update néven ismert, amelyben volt egy type mező, ami leírta, miről szól ez a frissítés. Ebből adódóan „csodás” kapcsolók voltak a validátorokkal, amelyek megmondták, hogyan kell validálni ezt az eseményt ezzel a typal.
Eseményverziózás
A Kafka üzenetek validálásához használható , de ezt már az elején figyelembe kellett venni és használni a Confluentot. Az eseményverziózással óvatosnak kell lennünk az esetünkben. Nem mindig lesz lehetséges az üzeneteket újraolvasni a replication log-ból, mert a modell „elment”. Alapvetően mindig úgy kell verziókat építenünk, hogy a modell visszafelé kompatibilis legyen: például egy mezőt ideiglenesen nem kötelezővé tenni. Ha a különbségek túl nagyok, új topikba kezdünk írni, és az ügyfeleket átültetjük, amikor befejezik a régit.
A partíciók olvasási sorrendjének garantálása
A Kafka-n belüli topikokat partíciókra osztják. Ez nem túl fontos, amíg megtervezzük a lényegét és az exchange-eket, de fontos, amikor eldöntjük, hogyan kell ezeket fogyasztani és méretezni.
Általában egy témát ír a Kafka-ba. Alapértelmezés szerint egy partíciót használ, és az összes üzenet ebbe a témába kerül. A fogyasztó pedig ennek megfelelően sorban olvassa ezeket az üzeneteket. Tegyük fel, hogy most a rendszert úgy kell bővítenünk, hogy az üzeneteket két különböző fogyasztó olvassa. Például, ha SMS-t küldesz, akkor kérheted a Kafkától, hogy készítsen egy további partíciót, és a Kafka elkezdi felosztani az üzeneteket két részre – egy része ide, egy része oda.
Hogyan osztja fel ezeket a Kafka? Minden üzenetnek van egy törzse (amelyben a JSON-t tároljuk) és van egy kulcs. Ehhez a kulcshoz hozzárendelhetsz egy hash-funkciót, amely meghatározza, hogy melyik partícióba kerül az üzenet.
A refunds esetében ez fontos, mert ha két partíciót veszünk, van esély arra, hogy a párhuzamos fogyasztó az első eseményt feldolgozza elsőként, és ez probléma lehet. A hash-funkció garantálja, hogy az azonos kulccsal rendelkező üzenetek egy és ugyanazon partícióba kerülnek.
Események vs parancsok
Ez egy újabb probléma, amellyel szembesültünk. Az esemény egy esemény: azt mondjuk, hogy valami valahol történt (something_happened), például a tételt visszavonták, vagy megtörtént a refund. Ha valaki hallgatja ezeket az eseményeket, akkor az 'item visszavont' kifejezés esetén létrejön a refund entitás, és a 'megtörtént a refund' valahol bekerül a beállításokba.
De általában, amikor eseményeket tervezel, nem akarsz feleslegesen írni őket - arra számítasz, hogy valaki majd olvassa őket. Nagy a csábítás, hogy ne something_happened (item_canceled, refund_refunded), hanem something_should_be_done kifejezéseket írj. Például, a tétel készen áll a visszatérítésre.
Egyrészt ez jelzi, hogyan fogják felhasználni az eseményt. Másrészt ez sokkal kevésbé tűnik normális eseménynévnek. Emellett ez már közel áll a do_something parancshoz. De nincs garancia arra, hogy ezt az eseményt valaki elolvasta; és ha elolvasta, akkor azt sikeresen tette; és ha sikeresen olvasta, akkor tett valamit, és az valami sikeresen ment végbe. Abban a pillanatban, amikor az esemény do_something-ná válik, szükség van visszajelzésre, és ez probléma.
Aszinkron csere a RabbitMQ-ban, amikor elolvastál egy üzenetet, és mentél az http-re, van válaszod - legalább annyi, hogy az üzenetet fogadták. Amikor írtál a Kafkába, van üzenet arról, hogy írtál a Kafkába, de arról, hogy hogyan dolgozták fel, semmit nem tudsz.
Ezért a mi esetünkben be kellett vezetni egy válasz eseményt, és be kellett állítani a megfigyelést arra, hogy ha ennyi esemény bekövetkezett, akkor ennyi válasz eseménynek kell érkeznie egy adott időn belül. Ha ez nem történt meg, akkor úgy tűnik, hogy valami nem stimmelt. Például, ha elküldtük az "item_ready_to_refund" eseményt, azt várjuk, hogy a refund létrejöjjön, a kliens visszakapja a pénzét, és megérkezik a "money_refunded" esemény. De ez nem biztos, ezért szükséges a megfigyelés.
Részletek
Van egy meglehetősen nyilvánvaló probléma: ha a témából folyamatosan olvas, és van egy rossz üzenet, akkor a fogyasztó leáll, és nem tud továbblépni. Önnek le kell állítania az összes fogyasztót, el kell köteleznie a további offsetet, hogy folytathassa az olvasást.
Tudtunk erről, számoltunk is vele, és mégis megtörtént. Az történt, hogy az esemény érvényes volt az events-bus szempontjából, az esemény érvényes volt az alkalmazás érvényesítője szempontjából, de nem volt érvényes a PostgreSQL szempontjából, mert egy MySQL rendszerben UNSIGNED INT-t használtunk, míg az újonnan írt rendszerben csak INT volt PostgreSQL. A mérete kicsit kisebb, és az Id nem fért el. A Symfony kivétellel leállt. Persze elkapjuk a kivételt, mert erre számítottunk, és el akartuk kötelezni ezt az offsetet, de előtte meg akartuk növelni a problémákat számláló mutatót, mivel az üzenet feldolgozása sikertelen volt. A projektben a számlálók is az adatbázisban vannak, de a Symfony már megszüntette az adatbázissal való kapcsolatot, és a második kivétel megölte az egész folyamatot, esély nélkül arra, hogy kötelezzük az offsetet.
Egy ideig a szolgáltatás pihent - szerencsére a Kafka esetében ez nem olyan ijesztő, mert az üzenetek megmaradnak. Amikor a munka helyreáll, a meg lehet őket olvasni. Ez kényelmes.
A Kafka lehetővé teszi a tooling segítségével tetszőleges offset beállítását. De ahhoz, hogy ezt megtehesse, le kell állítania az összes fogyasztót - a mi esetünkben egy külön kiadást kell készítenie, amelyben nem lesznek fogyasztók, redeployments. Akkor a tooling segítségével a Kafka-ban az offsetet el lehet tolni, és az üzenet átmegy.
Egy másik részlet - replikációs napló vs rdkafka.so — a projektünk jellegével függ össze. PHP-nk van, és a PHP-ban általában minden könyvtár a rdkafka.so tárolón keresztül kapcsolódik a Kafka-hoz, majd jön valamilyen csomagolás. Lehet, hogy ezek a mi saját nehézségeink, de kiderült, hogy csak újraolvasni egy már olvasott részt nem is olyan egyszerű. Összességében programozási problémáink voltak.
Visszatérve a partíciók kezelésének sajátosságaira, a dokumentációban egyértelműen le van írva consumers >= topic partitions. De erről sokkal később értesültem, mint szerettem volna. Ha méretezni szeretne és két fogyasztója van, akkor legalább két partícióra van szüksége. Tehát, ha volt egy partíciója, amiben 20 ezer üzenet gyűlt össze, és készített egy újat, az üzenetek száma nem fog egyhamar egyenlővé válni. Ezért, hogy párhuzamos két fogyasztója legyen, meg kell értenie a partíciókat.
Monitorozás
Gondolom, ahogy figyeljük, egyértelműbb lesz, milyen problémák vannak a meglévő megközelítésben.
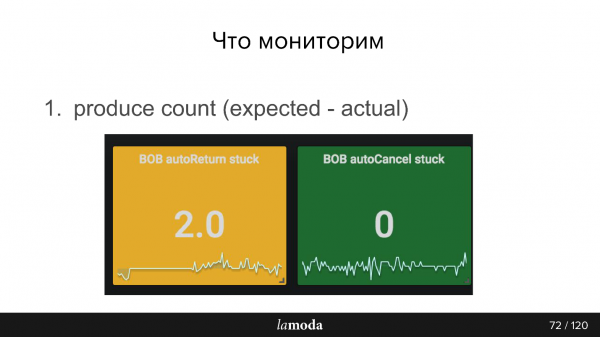
Például számoljuk, hány termék állapota változott meg a közelmúltban, és ennek megfelelően eseményeknek kell történniük, és ezt a számot elküldjük a saját figyelőrendszerünkbe. Aztán a Kafka-ból megkapjuk a második számot, hogy valójában hány eseményt regisztráltak. Nyilvánvaló, hogy a különbség a két szám között mindig nullának kell lennie.
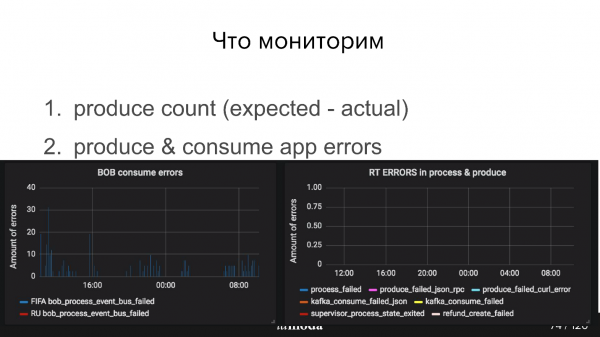
Ezen kívül figyelni kell a producer állapotát, hogy a events-bus elfogadta-e az üzeneteket, és hogy a fogyasztónak hogy áll a dolga. Például az alábbi grafikonokon a Refund Tool-nál minden rendben, míg a BOB-nál nyilvánvalóan problémák vannak (kék csúcsok).
Már említettem a consumer-group lag-ot. Durván szólva ez a nem olvasott üzenetek száma. Összességében a fogyasztók nálunk gyorsan dolgoznak, ezért a lag általában 0, de néha lehet egy rövid ideig tartó csúcs. A Kafka ezt a dobozból tudja, de szükséges beállítani egy intervallumot.
Van egy projekt , amely több információt ad a Kafka-ról. Egyszerűen az API-n keresztül a consumer-group ad vissza állapotot, hogy az adott csoportnak hogy áll a dolga. Az OK és a Failed mellett ott van a warning is, amiből megtudhatja, hogy a fogyasztói nem tartanak lépést a termelési tempóval – nem tudják elolvasni, ami íródik. A rendszer elég okos, könnyen használható.
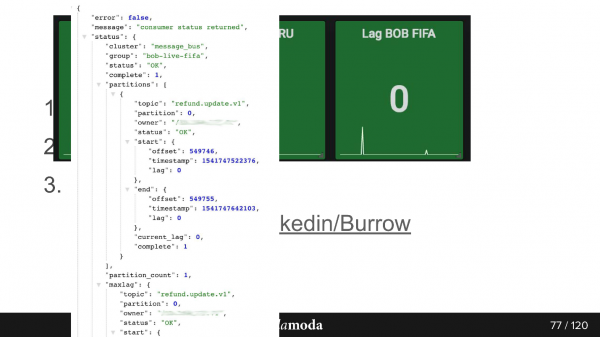
Így néz ki az API szerint a válasz. Itt a bob-live-fifa csoport, a partition refund.update.v1, állapot OK, lag 0 – az utolsó végső offset ilyen.
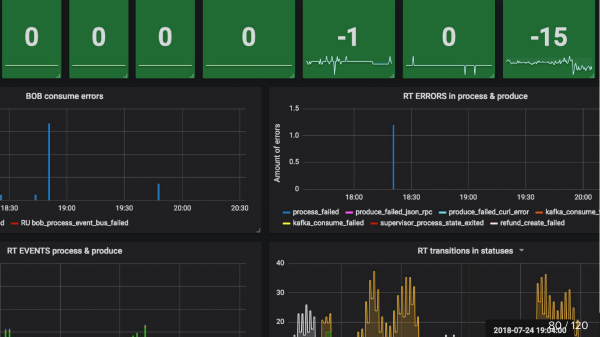
Monitorozás updated_at SLA (stuck) Már említettem. Például a termék státusza átkerült arra, hogy készen áll a visszatérítésre. Beállítunk egy Cron-t, ami azt mondja, hogy ha 5 perc alatt ez az objektum nem került visszatérítésre (a pénzt gyorsan visszatérítjük a fizetési rendszereken keresztül), akkor biztos, hogy valami nem működik jól, és ez egyértelműen egy támogatási eset. Ezért egyszerűen használunk egy Cron-t, ami olvassa ezeket a dolgokat, és ha ezek száma meghaladja a 0-t, akkor küld egy riasztást.
Összegzésképpen az események használata kényelmes, amikor:
- az információ több rendszer számára szükséges;
- nem fontos a feldolgozás eredménye;
- kevesebb esemény van, vagy az események kicsik.
Kézenfekvőnek tűnik, hogy a cikknek konkrét témája van – aszinkron API Kafka-ra, de ezzel kapcsolatban azonnal sok mindent szeretnék ajánlani.
Először is, a következő nem kell novemberig várni, már áprilisban lesz a pétervári verziója, és júniusban beszélünk a nagy terhelésekről Novoszibirszkben.
Másodszor, a jelentés szerzője, Szergej Zaika része a tudásmenedzsmenttel foglalkozó új konferenciánk programbizottságának. . A konferencia egynapos, április 26-án kerül megrendezésre, de a program nagyon tartalmas.
Továbbá májusban lesz és (a DevOpsConf részeként) – oda még lehet javasolni saját téma ajánlatot, tapasztalatokról beszélni és panaszolni a felmerült nehézségekre.
Forrás: habr.com
