

Bármely nagy projekt pár szerverrel kezdődött. Eleinte volt egy DB-szerver, majd ehhez adtak hozzá replikákat a lekérdezések skálázása érdekében. És itt álljunk meg! Az alapszerver egy, de a replikák sokan vannak; ha egyik replikát elhagyja, akkor minden rendben lesz, de ha az alapszerver tűnik el — az már rossz: leállás, a rendszergazdák pedig kétségbeesetten indítják újra a szervert. Mit tehetünk? Rendelkezünk alapszerverről. A kollégám, Pavel, már írt erről. , nem fogom megismételni. Ehelyett elmondom, miért szükséges feltétlenül az Orchestrator MySQL-hez!
Kezdjük a legfontosabb kérdéssel: "Hogyan vált át a kód új gépre az alapszerver távozásakor?".
- A VIP (Virtual IP) séma tetszik a legjobban, erről fogunk beszélni alább. Ez a legegyszerűbb és legnyilvánvalóbb, bár van egy nyilvánvaló korlátozása: az alapszerver, akit átkonfigurálunk, a L2 szegmensen kell lennie az új géppel, tehát a második adatközpontot el lehet felejteni. Ráadásul, ha jól átgondoljuk, az a szabály, hogy a nagy L2 rossz, mert az L2 csak a rackre vonatkozik, míg a rackek között L3 van, és egy ilyen séma még több korlátozással jár.
- Lehetőség van a kódba DNS-nevet írni és azt a \/etc\hosts-on keresztül feloldani. Valójában nem lesz feloldás. A séma előnye: nincsenek a legelső módszerre jellemző korlátozások, tehát lehet cross-Datacenter rendezni. De akkor felmerül a nyilvánvaló kérdés, hogy milyen gyorsan juttatjuk el a változtatást a \/etc\hosts-on keresztül Puppet-Ansible segítségével.
- A második módszert kissé módosíthatjuk: minden webes szerverre telepítünk egy gyorsítótárazó DNS-t, amelyen keresztül a kód az alapszerver adatbázisára megy. Beállíthatunk 60 TTL-t erre a DNS-bejegyzésre. Úgy tűnik, hogy megfelelő megvalósítással ez egy jó módszer.
- A service discovery séma, amely a Consul és az etcd használatát feltételezi.
- Érdekes lehetőség a . Az összes MySQL-forgalmat a ProxySQL-en keresztül kell irányítani, a ProxySQL pedig képes meghatározni, ki az aktuális alapszerver. Egyébként a termék használatának egyik lehetőségéről olvashatsz az én .
Az Orchestrator szerzője, aki a Github-on dolgozik, először megvalósította az első VIP sémát, majd átállt a Consul-alapú sémára.
Tipikus infrastruktúra séma:
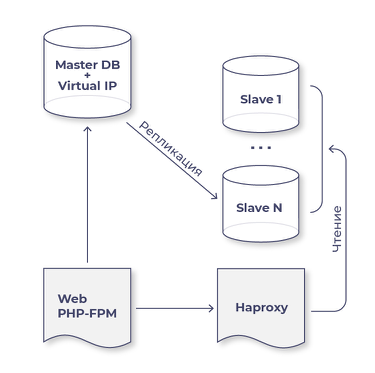
Azonnal felvázolom a nyilvánvaló helyzeteket, amelyeket figyelembe kell venni:
- A VIP-címnek nem szabad szerepelnie a konfigurációban egyetlen szerveren sem. Képzeljük el a helyzetet: az alapszerver újraindul, és amíg betölt, az Orchestrator átvált leállítási üzemmódba, és az egyik replikából alapszerver lesz; ezután a régi alapszerver is feláll, és most a VIP két gépen található. Ez rossz.
- Az orkesztrátor számára írni kell egy szkriptet, amely a régi mestert és az új mestert célozza meg. A régin végre kell hajtani az ifdown parancsot, míg az új mester esetében az ifup vip parancsot. Jó lenne, ha a szkriptbe azt is beírnánk, hogy hiba esetén a régi mesteren a port a kapcsolón egyszerűen le legyen kapcsolva, hogy elkerüljük a split-brain helyzetet.
- Miután az Orchestrator meghívta a szkriptjét, hogy először vegye le a VIP-t és/vagy kapcsolja le a portot a kapcsolón, majd az új mesteren meghívta a VIP felemelő szkriptet, ne felejtse el az arping parancsot kiadni, hogy mindenki tudja, hogy az új VIP most itt van.
- Minden slave-nak read_only=1-nek kell lennie, és amint a slavet promotálja mesterré, akkor read_only=0-ra kell váltania.
- Ne feledje, hogy mesterré válhat bármelyik slave, amelyet mi kiválasztottunk erre (az Orchestrator rendelkezik egy teljes preferencia mechanizmussal, amely meghatározza, hogy melyik slave legyen az elsődleges jelölt új mesterként, melyik a másodlagos, és melyik slave soha nem válhat mesterré). Ha a slave mesterré válik, akkor rajta marad a slave terhelés, és hozzáadódik a mester terhelés, ezt figyelembe kell venni.
Miért van szüksége feltétlenül Orchestratorra, ha még nincs?
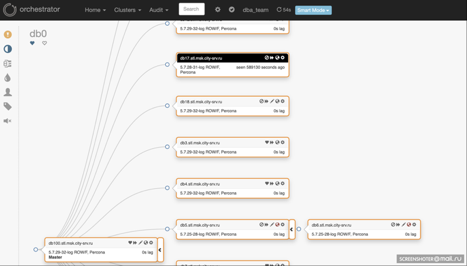
- Az Orchestrator nagyon felhasználóbarát grafikus felülettel rendelkezik, amely megjeleníti az összes topológiát (lásd a képernyőképet lent).
- Az Orchestrator nyomon tudja követni, hogy melyik slave késlekedik, és hol hibásodott meg a replikáció (az Orchestratorhoz SMS küldésére írt szkriptek csatlakoznak).
- Az Orchestrator megmondja, hogy melyik slave-en van GTID errant hiba.
Orchestrator felület:
Mi az a GTID errant?
Az Orchestrator működéséhez két alapvető követelmény van:
- Biztosítani kell, hogy az összes MySQL klaszter gépen engedélyezve legyen a pseudo GTID, nálunk a GTID be van kapcsolva.
- Egyforma binlog típust kell biztosítani mindenhol, lehet statement. Nekünk volt egy olyan konfigurációnk, amelyben a mesteren és a legtöbb slave-en Row volt, míg kettőn történelmileg a Mixed mód maradt. Ennek eredményeként ezek a slave-ek az Orchestrator nem akarta csatlakoztatni az új mesterhez.
Ne feledje, hogy a legfontosabb a production slave-nél a konzisztenciája a mestertől! Ha a master-en és a slave-en is engedélyezve van a Global Transaction ID (GTID), akkor a gtid_subset funkcióval meg lehet tudni, hogy valóban végrehajtották-e ugyanazokat az adatmódosító lekérdezéseket ezeken a gépeken. Ezt részletesebben is olvashatja. .
Ezért az Orchestrator a GTID errant hibán keresztül jelzi Önnek, hogy a slave-en olyan tranzakciók vannak, amelyek nincsenek a master-en. Miért történik ez?
- A slave-en nincs bekapcsolva a read_only=1, valaki csatlakozott és végrehajtott egy adatváltoztatási lekérdezést.
- A slave-en nincs bekapcsolva a super_read_only=1, így az admin, a szerverek összekeverése miatt, belépett és ott végrehajtott egy lekérdezést.
- Ha mindkét korábbi pontot figyelembe vette, van még egy trükk: a MySQL flush binlogokkal kapcsolatos lekérdezése is bekerül a binlogba, így a master első flush-a során és minden slave-en meg fog jelenni a GTID errant. Hogyan lehet ezt elkerülni? A perona-5.7.25-28-ban megjelent a binlog_skip_flush_commands=1 beállítás, amely megakadályozza, hogy a flush bekerüljön a binlogokba. A mysql.com oldalon ez be van jegyezve. .
Összefoglalva mindazt, amit korábban mondtunk. Ha még nem szeretné használni az Orchestrator-t failover üzemmódban, állítsa be megfigyelési módba. Így mindig láthatja a MySQL gépek kölcsönhatásának térképét, valamint a világosan látható információt arról, hogy milyen típusú replikáció van minden gépen, lemaradnak-e a slave-ek, és ami a legfontosabb — mennyire konzisztens a master-rel!
Nyilvánvaló kérdés: „Hogyan kell működnie az Orchestrator-nak?”. Új master-t kell választania a jelenlegi slave-ek közül, majd újra kell csatlakoztatnia az összes slave-t hozzá (éppen ezért van szükség a GTID-ra; ha a régi mechanizmust használnánk binlog_name és binlog_pos alapján, akkor lehetetlen lett volna a slave-et a jelenlegi master-ről az újra kapcsolni!). Mielőtt megjelent volna az Orchestrator, egyszer kézzel kellett mindezt megcsinálnom. A régi master megakadt egy hibás Adaptec vezérlő miatt, körülbelül 10 slave-je volt. A VIP-t át kellett raknom a masterről az egyik slave-re, és az összes többi slave-et át kellett csatlakoztatnom rá. Hány konzolt kellett megnyitnom, hány párhuzamos parancsot kellett beírnom... 3 óráig várnom kellett, levegőt venni az összes slave-ből, kivéve kettőt, az egyik gépet masterré kellett tennem, azonnal csatlakoztatni a második gépet, így a régi masterhez kapcsolódó összes többi slave-hez és visszaállítani a terhelést. Szóval, borzalmas...
Hogyan működik az Orchestrator, amikor átvált failover módba? Ezt a legkönnyebb bemutatni például abban a helyzetben, amikor erősebb, modernebb gépet akarunk masterré tenni, mint amilyen jelenleg van.
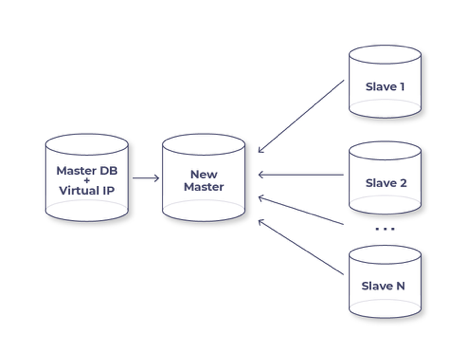
A képen a folyamat közepe látható. Mi történt eddig? Azt mondtuk, hogy szeretnénk egy slave-ből új mestert csinálni, az Orchestrator pedig egyszerűen újra csatlakoztatja az összes többi slave-t hozzá, miközben az új mester átmeneti gépként működik. Ezzel a módszerrel hibák nem merülnek fel, minden slave működik, az Orchestrator eltávolítja a VIP-t a régi mesterről, áthelyezi az újra, beállítja a read_only=0 értéket, és elfelejti a régi mestert. Ennyi! A szolgáltatásunk leállása – ez a VIP áthelyezése, ami 2-3 másodpercet vesz igénybe.
Ennyi volt mára, köszönöm mindenkinek. Hamarosan érkezik a második cikk az Orchestrator-ról. A híres szovjet filmben, a «Garázs»-ban az egyik karakter azt mondta: «Én vele nem mennék felderítésre!» Nos, Orchestrator, veled szívesen mennék felderítésre!
Forrás: habr.com
