

A SitiMobilnál az MySQL adatbázist használjuk alapvető tárolóként. Számos adatbázis klaszterünk van különféle szolgáltatások és célok számára.
A mester folyamatos elérhetősége kritikus teljesítménymutatója a rendszer és a benne található egyes részek működésének. A mester leállása esetén a klaszter automatikus helyreállítása jelentősen csökkenti a válaszidőt és a leállási időt. Ebben a cikkben a MySQL klasterek magas rendelkezésre állásának (HA) biztosítási schemáját fogom tárgyalni és virtuális IP-címek (VIP).
VIP-alapú HA-megoldás
Először is, röviden elmondom, hogy milyen a tárolórendszerünk.
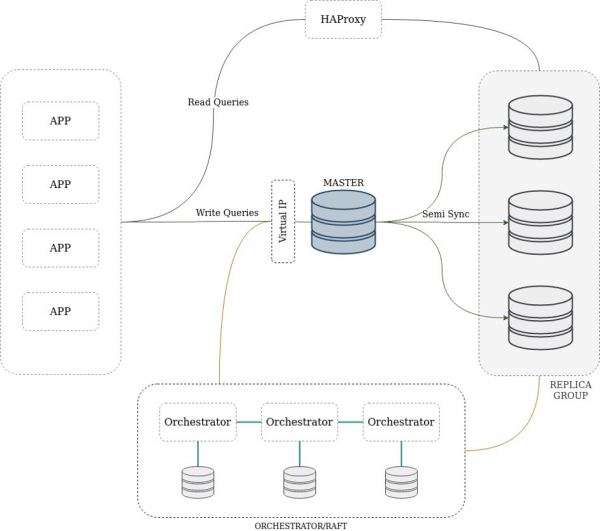
Hagyományos replikációs sémát használunk egyetlen írásra elérhető mesterrel és sok replikával, amelyek kizárólag olvasásra szolgálnak. A klaszter tartalmazhat közbenső mestert — olyan csomópontot, amely egyszerre replikaként és mások mestereként működik. Az ügyfelek a replikákhoz HAProxy-n keresztül férnek hozzá, ami lehetővé teszi a terhelés egyenletes eloszlását és a könnyű méretezhetőséget. Az HAProxy használata történeti okokból ered, és jelenleg átállás folyamatban van a ProxySQL-ra.
A replikáció félszinkron módban történik a következő alapján GTID. Ez azt jelenti, hogy legalább egy replikának fel kell vennie a tranzakciót a naplóba, mielőtt azt sikeresnek nyilvánítják. Ez a replikációs mód optimális egyensúlyt biztosít a teljesítmény és az adatbiztonság között a fő csomópont meghibásodása esetén. A módosítások többsége a mestertől a replikákhoz a következőkkel kerül átadásra Row Based Replication (RBR), de néhány csomópont vegyes binlog formátummal rendelkezhet.
Az Orchestrátor rendszeresen frissíti a klaszter topológiájának állapotát, elemzi a kapott információkat, és problémák esetén elindíthatja az automatikus helyreállítási eljárást. Magát az eljárást a fejlesztő irányítja, mivel különféle módokon valósítható meg: VIP, DNS, szolgáltatáskereső (service discovery) vagy saját mechanizmusok alapján.
Az egyik egyszerű módja a mester helyreállításának a meghibásodás esetén a lebegő VIP-címek használata.
A következőket kell tudni erről a megoldásról, mielőtt továbblépnénk:
- A VIP — egy IP-cím, amely nincs hozzárendelve egy konkrét fizikai hálózati interfészhez. Ha egy csomópont meghibásodik, vagy tervezett karbantartás történik, a VIP-t minimális leállási idővel egy másik erőforrásra tudjuk áthelyezni.
- Egy virtuális IP-cím felszabadítása és kiadása gyors és olcsó műveletek.
- A VIP használatához SSH-n keresztüli hozzáférés szükséges a szerverhez, vagy speciális eszközök, például
keepalived.
Nézzük meg a lehetséges problémákat a mesterünkkel, és bemutatjuk, hogyan kell működnie az automatikus helyreállító mechanizmusnak.
Elveszett a hálózati kapcsolat a mesterhez, vagy probléma lépett fel a hardver szintjén, és a szerver nem elérhető.
- Az orkestrátor frissíti a klaszter topológiáját, minden replikát értesít a mester elérhetetlenségéről. Az orkestrátor elindítja a replikák közül a megfelelő új mester választási folyamatát és megkezdi a helyreállítást.
- Megpróbáljuk eltávolítani a VIP-t a régi mesterről — sikertelenül.
- A replikát mesterré vált. A topológia átalakul.
- Új hálózati interfészt adunk hozzá VIP-vel. Mivel a VIP eltávolítása nem sikerült, a háttérben elindítjuk a periódikus kérés küldését gratuitous ARP. Ez a kérdés/válasz típus lehetővé teszi a csatlakoztatott switch-ek számára, hogy frissítsék az IP- és MAC-címek közötti megfeleltetési táblázatukat, ezáltal értesítve a VIP áthelyezéséről. Ez minimalizálja a valószínűségét
split braina régi mester visszatértekor. - Minden új kapcsolat azonnal átirányításra kerül az új mesterhez. A régi kapcsolatok sikertelenül záródnak, és ismételt lekérdezések történnek az adatbázison a alkalmazás szintjén.
A szerver normál módban működik, a hiba a DB szintjén következett be.
Az algoritmus hasonló az előző esethez: a topológia frissítése és a helyreállítási folyamat indítása. Mivel a szerver elérhető, sikeresen felszabadítjuk a VIP-t a régi mesterről, áthelyezzük az újra, és több ARP-kérést küldünk. A régi mester esetleges visszatérése nem befolyásolhatja az átalakított klasztert és az alkalmazás működését.
Egyéb problémák
A replikák vagy átmeneti mesterek meghibásodása nem eredményez automatikus intézkedéseket, és kézi beavatkozást igényel.
A virtuális hálózati interfészt mindig ideiglenesen adnak hozzá, tehát a VIP automatikusan nem kerül hozzárendelésre a szerver újraindítása után. Minden adatbázis példány alapértelmezés szerint csak olvasási módban indul el, az orkesztrátor automatikusan átvált egy új író mesterre és megpróbálja beállítani csak olvasás a régi mesternél. Ezek a lépések a valószínűség csökkentésére irányulnak split brain.
A helyreállítási folyamat során felmerülhetnek problémák, amelyeket szintén értesíteni kell az orkesztrátor UI-ján keresztül a szokásos monitorozási eszközök mellett. Kiterjesztettük a REST API-t, hogy ezt a lehetőséget hozzáadjuk ( jelenleg elbírálás alatt).
A HA-megoldás általános ábrázolása alább látható.
Új mester kiválasztása
Az orkesztrátor elég intelligens, és megpróbálja kiválasztani mint új mestert a következő kritériumok alapján:
- a replikák lemaradása a mestertől;
- a MySQL mester és replika verziója;
- a replikáció típusa (RBR, SBR vagy vegyes);
- elhelyezkedés egy vagy több adatközpontban;
- létezik
eltérő GTID— tranzakciók, amelyeket a replikán hajtottak végre, és amelyek hiányoznak a mesterről; - a felhasználói kiválasztási szabályokat is figyelembe kell venni.
Nem minden replika ideális jelölt a mester szerepére. Például egy replika adatmentésre is használható, vagy a szerver gyengébb hardverkonfigurációval rendelkezik. Az orkesztrátor kézi szabályokat is tartalmaz, amelyek segítségével a felhasználók testre szabhatják jelöltválasztási preferenciáikat a legjobban preferáltaktól a figyelmen kívül hagyottakig.
Reagálási és helyreállítási idő
Egy incidens esetén fontos minimalizálni a rendszer leállásának idejét, ezért vegyük figyelembe azokat a MySQL paramétereket, amelyek befolyásolják az orkesztrátor klasztertopológiai felépítését és frissítését:
- — azoknak a másodperceknek a száma, amelyek alatt a replika várakozik az új adatok vagy a mestertől érkező heartbeat-jelzés megérkezésére, mielőtt a kapcsolat elveszettnek minősül és újracsatlakozik. Minél kisebb az érték, annál gyorsabban észlelheti a replika, hogy a kapcsolat a mesterről megszakadt. Ezt az értéket 5 másodpercre állítjuk.
- — másodpercek száma a próbák közötti újrakapcsolódáshoz. Hálózati problémák esetén az alacsonyabb érték lehetővé teszi a gyors újrakapcsolódást és megakadályozza a klaszter helyreállítási folyamatának elindulását. Ajánlott érték: 1 másodperc.
MASTER_RETRY_COUNT— a maximális újrakapcsolódási kísérletek száma.MASTER_HEARTBEAT_PERIOD— másodpercekben kifejezett intervallum, amely után a mester heartbeat jelet küld. Alapértelmezés szerint értéke aslave_net_timeout.
Orkesztrátor paraméterek:
DelayMasterPromotionIfSQLThreadNotUpToDate— ha ezigaz, akkor a mester szerep nem alkalmazható a jelölt replikán addig, amíg a replikák SQL szálának minden nem alkalmazott tranzakcióját a Relay Log-ból végrehajtják. Ezt az opciót azért használjuk, hogy ne veszítsük el a tranzakciókat a jelölt replikák lemaradása esetén.InstancePollSeconds— a topológia lekérdezésének és frissítésének gyakorisága.RecoveryPollSeconds— a topológia elemzésének gyakorisága. Probléma észlelése esetén a topológia helyreállítása elindul. Ez egy, amely 1 másodperc.
Minden klasztercsomópontot az orkesztrátor egyszer kérdez le InstancePollSeconds másodpercenként. Probléma észlelése esetén a klaszter állapota kényszerített frissítést kap,A HA séma tesztelését egy helyi
Tesztkörnyezet
tesztkörnyezet kifejlesztésével kezdtük, A gyakorlatok során az alábbi problémamodellek közül választunk: a mester azonnali leállítása a
, a folyamat finom leállítása és a szerver leállítása ( kill -9docker-compose stop), hálózati problémák szimulálása aziptables -j REJECT iptables -j DROP vagy . Az alábbi eredményekre számítunk:az orkesztrátor észleli a mesterrel kapcsolatos problémákat, és a topológiát legfeljebb 10 másodpercen belül frissíti;
- a helyreállítási eljárás automatikusan elindul: a hálózati konfiguráció megváltozik, a mester szerepe átkerül a replikára, a topológia újraépül;
- автоматически запустится процедура восстановления: изменится сетевая конфигурация, роль мастера перейдёт к реплике, топология перестроится;
- Az új mester elérhetővé válik a felvételre, az élő replikák nem fognak elveszni az újraépítés során;
- az adatok elkezdenek a új mesterre íródni és replikálódni;
- a teljes helyreállítási idő legfeljebb 30 másodperc lesz.
Ahogy tudjátok, a rendszer különbözőképpen viselkedhet teszt- és éles környezetekben a különböző „hardver” és hálózati konfigurációk, a szintetikus és valós terhelések közötti eltérések miatt, és így tovább. Ezért időnként valós körülmények között gyakorlatokat végzünk, ellenőrizve, hogyan viselkedik a rendszer a hálózati kapcsolatok elvesztésénél vagy egyes részeinek degradációjánál. A jövőben szeretnénk teljesen azonos infrastruktúrát építeni a két környezet számára, és automatizálni a tesztelését.
Következtetések
A tárolórendszer fő csomópontjának működése az SRE és üzemeltetési csapat egyik legfontosabb feladata. Az orchestrátor és a VIP-alapú HA-megoldás bevezetése az alábbi eredményeket hozta:
- megbízható problémaazonosítás a DB klaszter topológiájában;
- automatikus és gyors reagálás a mesterrel kapcsolatos incidensekre, ami csökkenti a rendszer leállási idejét.
Azonban a megoldásnak vannak korlátai és hátrányai:
- a HA-rendszer több adatközpontba történő skálázása egy egységes L2-hálózat meglétét igényli közöttük;
- mielőtt a VIP-t az új mesteren hozzárendelhetjük, azt el kell távolítani a régiről. A folyamat soros, ami növeli a helyreállítási időt;
- a VIP eltávolítása SSH-hozzáférést igényel a szerverhez, vagy bármilyen más módon történő távoli eljárások hívására. Mivel a szerver vagy a DB problémákkal küzd, amelyek a helyreállítási folyamatot okozták, nem biztos, hogy a VIP eltávolítása sikeres lesz. Ez pedig két azonos virtuális IP-címmel rendelkező szerverhez és problémákhoz vezethet.
split brain.
A megakadályozás érdekében split brain, használhatjuk a módszert ("Shoot The Other Node In The Head"), amely teljesen elszigeteli vagy kikapcsolja a problémás csomópontot. Léteznek más megoldások is a klaszter magas rendelkezésre állásának megvalósítására: a VIP és DNS kombinációja, szolgáltatásfelfedezés és proxy-szolgáltatások, szinkron replikáció és egyéb módszerek, amelyeknek megvannak a hátrányaik és előnyeik.
Beszéltem arról, hogyan hozunk létre egy megbízható MySQL klasztert. Könnyen megvalósítható és elfogadható szintű megbízhatóságot biztosít a jelenlegi körülmények között. Ahogy az egész rendszer és az infrastruktúra fejlődik, ez a megközelítés kétségtelenül fejlődni fog.
Forrás: habr.com
