

Javaslom, hogy ismerje meg Alexey Lesovsky jelentésének értelmezését a Data Egret-től "A PostgreSQL monitorozás alapjai"
Ebben a jelentésben Alexey Lesovsky bemutatja a PostgreSQL statisztikájának kulcspillanatait, azok jelentőségét és miért kell szerepelniük a monitorozás során; arról, hogy milyen grafikonoknak kell szerepelniük a monitorozás során, hogyan lehet őket hozzáadni, és hogyan lehet értelmezni őket. A jelentés hasznos lesz adatbázis-adminisztrátorok, rendszergazdák és fejlesztők számára, akik érdeklődnek a PostgreSQL hibakeresése iránt.
Az én nevem Alexey Lesovsky, a Data Egret céget képviselem.
Röviden magamról. Réges-régen rendszergazdaként kezdtem.
Különböző Linux rendszereket adminisztráltam, és foglalkoztam különböző Linuxhoz kapcsolódó dolgokkal, mint például virtualizációval, monitorozással, proxyval stb. De egy idő után egyre inkább az adatbázisokkal kezdtem foglalkozni, különösen a PostgreSQL-lel. Nagyon tetszett. Idővel a munkám jelentős részét a PostgreSQL-nek szenteltem, így fokozatosan PostgreSQL DBA lettem.
Karrierem során mindig is foglalkoztatott a statisztika, monitorozás, telemetria kivonásának témája. Amikor rendszergazda voltam, nagyon szoros kapcsolatban voltam a Zabbix-szal. Írtam egy kis script gyűjteményt, mint . Ez abban az időben elég népszerű volt. Ezen keresztül különböző fontos dolgokat lehetett monitorozni, nemcsak Linuxot, hanem más komponenseket is.
Jelenleg a PostgreSQL-lel foglalkozom. Már írok egy másik eszközt, ami lehetővé teszi a PostgreSQL statisztikájával való munkát. Ezt hívják (cikk a Habrén — ).
Rövid bevezető. Milyen helyzetek szoktak előfordulni ügyfeleinknél? Valamilyen hiba lép fel az adatbázissal kapcsolatban. Miután helyreállították az adatbázist, a részleg vezetője vagy a fejlesztési vezető megérkezik, és azt mondja: „Barátok, monitorozni kellene az adatbázist, mert történt valami rossz, és meg kellene akadályozni, hogy a jövőben hasonló esetek történjenek.” Itt kezdődik az izgalmas folyamat a monitorozó rendszer kiválasztásában vagy a meglévő rendszer adaptálásában, hogy monitorozhassuk az adatbázisunkat – legyen az PostgreSQL, MySQL vagy más. A kollégák kezdenek javaslatokat tenni: „Hallottam, hogy létezik egy ilyen adatbázis. Használjuk azt.” A kollégák elkezdenek vitatkozni egymással. Végül kiválasztunk egy adatbázist, de a PostgreSQL monitorozás benne meglehetősen gyenge, és mindig szükség van valamilyen kiegészítésre. Repo-kat kell vennünk a GitHubról, klónoznunk kell azokat, át kell alakítanunk a szkripteket, valahogy be kell állítanunk. Ennek eredményeképpen ez kézi munkává válik.
Ezért ebben a beszámolóban megpróbálom átadni azokat a tudásokat, amelyek révén nemcsak PostgreSQL, hanem más adatbázisok monitorozását is választhatjuk. Olyan tudást kívánok adni, ami lehetővé teszi, hogy tökéletesítsük a monitorozási rendszerünket, hogy hasznot nyerhessünk belőle, és időben figyelmeztethessünk a közelgő viharokra, amelyek felmerülhetnek.
A beszámolóban szereplő ötletek közvetlenül alkalmazhatók bármely adatbázisra, legyen az relációs adatbázis vagy noSQL. Tehát itt nemcsak PostgreSQL lesz, hanem sok recept is arról, hogyan lehet ezt megvalósítani PostgreSQL-ben. Példák lesznek lekérdezésekre, entitásokra, amelyek jelen vannak a PostgreSQL-ben monitorozáshoz. Ha az ön adatbázisa rendelkezik hasonló funkciókkal, amelyeket bele lehet illeszteni a monitorozásba, azokat is alkalmazhatja, hozzáadhatja, és akkor minden rendben lesz.
 A beszámolóban nem fogok
mesélni arról, hogyan szállítsuk és tároljuk a metrikákat. Nem fogok semmit mondani az adatok utófeldolgozásáról vagy azok felhasználók számára történő megjelenítéséről. És nem fogok semmit mondani az értesítésekről.
A történet során különböző monitorozásokról fogok képernyőképeket mutatni, és bizonyos kritikákat fogalmazok meg. Ennek ellenére megpróbálom elkerülni a márkák említését, hogy ne hozzak létre reklámot vagy negatív reklámot ezen termékek számára. Így tehát minden egybeesés véletlenszerű, és a fantáziájukra bízzuk őket.
Először is tisztázzuk, mi is az a monitorozás. A monitorozás egy nagyon fontos dolog, amivel rendelkezni kell. Ezt mindenki érti. Ugyanakkor a monitorozás nem tartozik a vállalati termékek közé, és közvetlen hatással nincs a cég profitjára, ezért a monitorozásra mindig a fennmaradó időből jut idő. Ha van időnk, foglalkozunk a monitorozással, ha nincs időnk, akkor rendben, betesszük a hátralékba, és egy nap visszatérünk ezekhez a feladatokhoz.
Ezért a gyakorlatunk alapján, amikor ügyfelekhez megyünk, a monitorozás gyakran alulfejlesztett, és nem rendelkezik olyan érdekes dolgokkal, amelyek segítenének jobban végezni a munkát az adatbázissal. Ezért a monitorozást mindig finomítani kell.
Az adatbázisok olyan bonyolult dolgok, amelyeket szintén monitorozni kell, mert az adatbázisok információtárolóként funkcionálnak. Az információ nagyon fontos a cég számára, és semmiképpen sem szabad elveszíteni. Ugyanakkor az adatbázisok nagyon összetett szoftverdarabok. Sok összetevőből állnak. És ezek közül sok összetevőt figyelemmel kell kísérni.
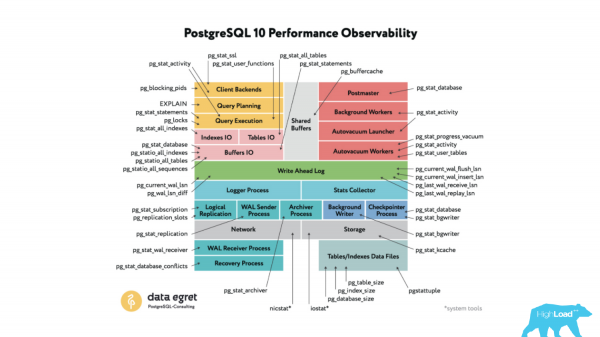 Ha kifejezetten a PostgreSQL-ról beszélünk, akkor azt egy olyan séma formájában lehet ábrázolni, amely sok összetevőből áll. Ezek az összetevők kölcsönhatásban állnak egymással. Ugyanakkor a PostgreSQL-ben létezik egy úgynevezett Stats Collector alrendszer, amely lehetővé teszi e alrendszerek működésének statisztikájának gyűjtését, és valamilyen felületet biztosít az adminisztrátor vagy a felhasználó számára, hogy megtekinthesse ezeket a statisztikákat.
Ez a statisztika egy funkciók és nézetek (view) halmazaként van megjelenítve. Ezeket táblázatokként is nevezhetjük. Tehát egy egyszerű psql kliens segítségével csatlakozhat az adatbázishoz, végrehajthat egy select parancsot ezekre a funkciókra és nézetekre, és konkrét számadatokat kap a PostgreSQL alrendszerek működéséről.
Ezeket a számadatokat hozzáadhatja a kedvenc monitorozó rendszeréhez, grafikonokat rajzolhat, funkciókat adhat hozzá, és hosszú távú elemzést kaphat.
De a jelentésben nem fogom részletezni ezeket a funkciókat, mert ez egész napot igénybe vehet. Csak két-három-négy dologra fogok koncentrálni, és elmondom, hogyan segítenek a jobb monitorozásban.
Ha a databázis monitorozásáról beszélünk, mit kell figyelni? Először is a rendelkezésre állást kell monitorozni, mert az adatbázis egy szolgáltatás, amely hozzáférést biztosít az adatokhoz az ügyfelek számára, és figyelni kell a rendelkezésre állást, valamint bizonyos minőségi és mennyiségi jellemzőit is.
Azt is monitorozni kell, hogy hány ügyfél csatlakozik az adatbázisunkhoz, mert ezek lehetnek normális ügyfelek, de lehetnek káros ügyfelek is, akik kárt okozhatnak az adatbázisban. Őket is figyelni és nyomon követni kell.
Amikor az ügyfelek csatlakoznak az adatbázishoz, nyilvánvaló, hogy dolgozni kezdenek az adatokkal, ezért figyelni kell arra is, hogyan dolgoznak az ügyfelek az adatokkal: mely táblákkal és kisebb mértékben milyen indexekkel. Azaz meg kell vizsgálnunk az ügyfeleink által létrehozott munkaterhelést.
De a munkaterhelés természetesen lekérdezésekből áll. Az alkalmazások csatlakoznak az adatbázishoz, és lekérdezéseken keresztül kérdezik le az adatokat, ezért fontos, hogy értékeljük, milyen lekérdezések vannak az adatbázisunkban, figyeljük azok megfelelőségét és hogy nincsenek-e elírások, és hogy bizonyos lehetőségeket át kell írni, hogy gyorsabban és jobb teljesítménnyel működjenek.
És mivel az adatbázisról beszélünk, az adatbázis mindig háttérfolyamatokat is jelent. A háttérfolyamatok lehetővé teszik, hogy az adatbázis teljesítménye jó szinten maradjon, ezért működésükhöz szükséges némi erőforrás. Ugyanakkor átfedésbe kerülhetnek az ügyféllekérdezések erőforrásaival, így a hajlamos háttérfolyamatok közvetlenül befolyásolhatják az ügyféllekérdezések teljesítményét. Ezért ezeket is figyelni és nyomon követni kell, hogy ne legyenek eltérések a háttérfolyamatokkal kapcsolatban.
A rendszeres metrikák tekintetében a database monitoring továbbra is a rendszeres metrikákban marad. De figyelembe véve, hogy az infrastruktúránk jelentős része a felhőbe költözik, egy külön állomás rendszeres metrikái mindig másodlagossá válnak. Mégis, az adatbázisok esetében ezek továbbra is aktuálisak, és természetesen a rendszeres metrikák figyelése is szükséges.
A rendszeres metrikák viszonylag jól állnak, a legtöbb modern monitoring rendszer már támogatja ezeket a metrikákat, de összességében néhány komponens mégis hiányzik, és bizonyos dolgokat hozzá kell adni. Erről is beszélni fogok, néhány dián fogok említeni őket.
A terv első pontja az elérhetőség. Mi az elérhetőség? Az elérhetőség számomra azt jelenti, hogy az adatbázis képes kiszolgálni a kapcsolatokat, azaz az adatbázis üzemel, mint egy szolgáltatás, és fogadja az ügyfelek kapcsolatait. Ezt az elérhetőséget néhány jellemző alapján lehet értékelni. Ezeket a jellemzőket nagyon kényelmesen megjeleníthetjük a műszerfalakon.
Mindenki tudja, mi az a műszerfal. Amikor egy pillantást vetsz a képernyőre, amelyen az összes szükséges információ össze van gyűjtve. Azonnal meg tudod állapítani – van-e probléma az adatbázisban vagy nincs.
Ennek megfelelően az adatbázis elérhetőségét és más kulcsfontosságú jellemzőit mindig be kell emelni a műszerfalakra, hogy ez az információ mindig kéznél legyen. Néhány további részlet, amely segíthet a incidensek, illetve az események nyomozásában, már másodlagos műszerfalakon kell hogy legyen, vagy el kell rejteni a drilldown linkeken, amelyek külső monitoring rendszerekre vezetnek.
Egy jól ismert monitoring rendszer példája. Ez egy nagyon menő monitoring rendszer. Nagyon sok adatot gyűjt, de véleményem szerint furcsa a műszerfalak fogalma. Van egy "műszerfal létrehozása" link. De amikor te létrehozol egy műszerfalat, akkor létrehozol egy listát, amely két oszlopból áll, egy grafikonokból álló listát. És amikor meg akarsz nézni valamit, akkor elkezdesz kattintani, lapozni, keresni a szükséges grafikont. Erre időt kell fordítani, azaz ilyen értelemben nincsenek valódi műszerfalak. Csak grafikonok listái léteznek.
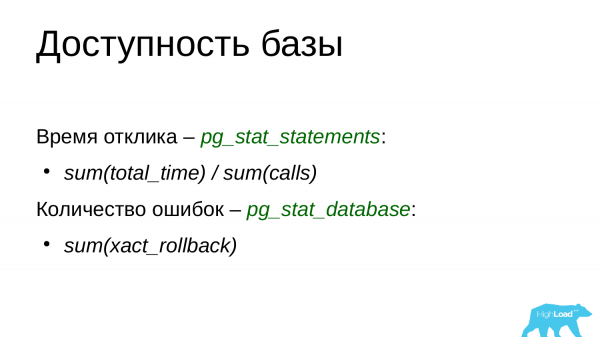
Mi szükséges hozzáadni ezekhez a műszerfalakhoz? Kezdhetjük a válaszidővel, amely egy fontos jellemző. A PostgreSQL-ben van egy nézet, a pg_stat_statements. Alapértelmezés szerint ez ki van kapcsolva, de ez egy fontos rendszer nézet, amelyet mindig be kell kapcsolni és használni. Információt tárol az összes végrehajtott lekérdezésről, amelyek az adatbázisban teljesültek.
Ennek megfelelően kiindulhatunk abból, hogy összeadjuk az összes lekérdezés teljesítési idejét, és elosztjuk a lekérdezések számával a fent említett mezők segítségével. De ez egy átlagos hőmérséklet a kórházban. Kiindulhatunk más mezőkből is - a lekérdezések minimum, maximum és medián teljesítési idejéből. Sőt, percentiliseket is képezhetünk, a PostgreSQL-ben vannak megfelelő funkciók erre. Így kapunk olyan számokat, amelyek jellemzik az adatbázisunk válaszidejét a már végrehajtott lekérdezések alapján, tehát nem végzünk hamis lekérdezéseket, mint például 'select 1', és nem mérjük a válaszidőt, hanem elemzünk a már végrehajtott lekérdezések válaszidejét, és ábrázoljuk vagy különböző számként, vagy grafikonon.
Fontos nyomon követni a rendszer által jelenleg generált hibák számát is. Ehhez használhatjuk a pg_stat_database nézetet. Az xact_rollback mezőre összpontosítunk. Ez a mező nemcsak az adatbázisban történt rollbackek számát mutatja, hanem a hibák számát is figyelembe veszi. Más szóval, ezt a számot megjeleníthetjük a műszerfalunkon, és figyelhetjük, hány hibánk van jelenleg. Ha sok hiba van, az már jó ok arra, hogy megnézzük a naplókat, és lássuk, mik azok a hibák és miért történnek, majd pedig nyomozzunk és megoldjuk őket.
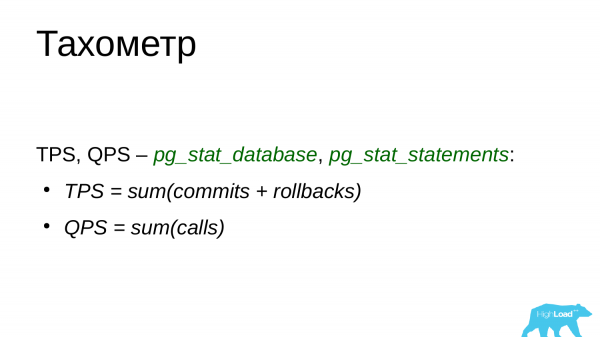
Hozzáadhatunk egy tachométert is. Ez a tranzakciók számát másodpercenként és a lekérdezések számát másodpercenként méri. Más szóval, ezeket a számokat használhatja az adatbázisának aktuális teljesítményének meghatározására, és figyelheti, hogy vannak-e lekérdezések, tranzakciós csúcsok, vagy éppen ellenkezőleg, az adatbázis alul van terhelve, mert egy backend leállt. Ezt a számot mindig figyelemmel kell kísérni, és emlékezni kell, hogy a projektünk számára ez a teljesítmény normális, míg a magasabb és alacsonyabb értékek már problémásnak tűnnek, ezáltal figyelmet igényel, hogy miért is vannak ilyen számok.
A tranzakciók számának értékeléséhez ismételten hívhatjuk a pg_stat_database nézetet. Összeadhatjuk a commitok és a rollbackek számát, így megkaphatjuk a másodpercenkénti tranzakciók számát.
Mindenki tudja, hogy egy tranzakcióba több kérés is belefér? Ezért a TPS és QPS kicsit eltérőek.
A másodpercenkénti kérések számát a pg_stat_statements segítségével nyerhetjük ki, és egyszerűen összeadhatjuk az összes végrehajtott kérés számát. Nyilvánvaló, hogy az aktuális értéket a korábbi értékkel összehasonlítva kivonjuk, így megkapjuk a deltát, ami a mennyiséget adja.
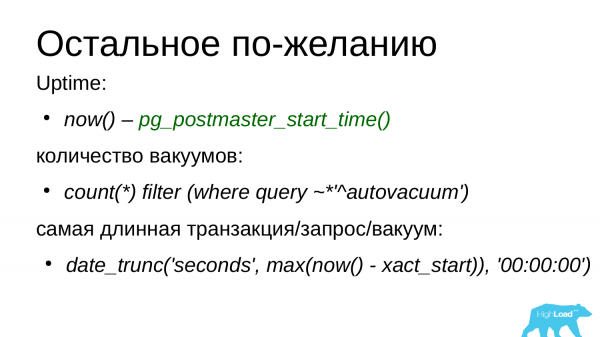
Lehetőségünk van további metrikák hozzáadására, amelyek segítenek értékelni az adatbázisunk elérhetőségét és nyomon követni, hogy történt-e valamilyen leállás.
Egyik ilyen metrika az uptime. Az uptime a PostgreSQL-ben kicsit trükkös dolog. Elmondom, miért. Amikor a PostgreSQL elindul, elkezdődik az uptime számítása. De ha egy adott pillanatban, például éjjel végrehajtásra került egy feladat, és a OOM-killer kényszerített módon leállította a PostgreSQL gyermekfolyamatát, akkor a PostgreSQL az összes kliens kapcsolatot megszünteti, visszaállítja a sharded memória területét és az utolsó ellenőrzési pontról kezd helyreállítani. Amíg ez a helyreállítás tart, az adatbázis nem fogad kapcsolatokat, tehát ezt a helyzetet leállásként lehet értékelni. De az uptime számláló nem fog nullázódni, mert figyelembe veszi a postmaster indításának időpontját az első pillanattól kezdve. Ezért az ilyen helyzetek kihagyhatók.
A munkavállalók számát is figyelemmel kell kísérni. Mindenki tudja, mi az az autovacuum a PostgreSQL-ben? Ez egy érdekes alrendszer a PostgreSQL-ben. Róla sok cikk készült, számos előadás tartalmazza. Sok vita van a vákuumról, arról, hogyan kell működnie. Sokan szükségtelen rossznak tartják. De így van. Ez valami analóg a szeméttisztítóval, amely tisztítja az elavult sorverziókat, amelyekre egyik tranzakció sem tart igényt, és helyet szabadít fel a táblákban és indexekben az új sorok számára.
Miért fontos ezt figyelemmel kísérni? Mert a vákuum néha nagyon fájdalmas lehet. Nagy mennyiségű erőforrást igényel, és emiatt a kliens kérdések szenvednek.
A pg_stat_activity nézet segítségével kell figyelemmel kísérni, amelyről a következő szakaszban fogok beszélni. Ez a nézet megmutatja az adatbázis aktuális aktivitását. Ezen keresztül nyomon tudjuk követni, hány vákuum fut éppen most. Nyomon tudjuk követni a vákuumokat, és látni fogjuk, hogy ha túllépjük a korlátot, akkor ez okot ad a PostgreSQL beállításainak ellenőrzésére és a vákuum működésének optimalizálására.
A PostgreSQL egy másik sajátossága, hogy a hosszú tranzakcióktól nagyon súlyosan szenved. Különösen azoktól a tranzakcióktól, amelyek sokáig fognak és semmit sem csinálnak. Ezeket stat idle-in-transaction néven ismerjük. Egy ilyen tranzakció zárolásokat tart, ami akadályozza a vákuum működését. Ennek következményeként a táblák megnőnek, méretük nő. Az ezekkel a táblákkal dolgozó lekérdezések egyre lassabbá válnak, mert minden régi verziót ki kell ásni a memóriából a lemezre és vissza. Ezért figyelni kell a leghosszabb tranzakciók, a leghosszabb vákuumlekérdezések időtartamát is. Ha olyan folyamatokat látunk, amelyek már nagyon hosszú ideje, több mint 10-20-30 percig futnak az OLTP terhelés alatt, akkor rájuk figyelmet kell fordítani, és kényszeríteni kell a befejezésüket, vagy optimalizálni kell az alkalmazást, hogy ne hívták őket meg, és ne lógjanak olyan sokáig. Analitikai terhelés esetén a 10-20-30 perc normális, ott előfordulhatnak ennél hosszabb időtartamok is.
Továbbá van lehetőségünk az ügyfelekkel való kapcsolódás nyomon követésére. Amikor már létrehoztuk a műszerfalat, és figyelembe vettük a rendelkezésre állás kulcsfontosságú mutatóit, további információkat is hozzáadhatunk a csatlakoztatott ügyfelekről.
A csatlakoztatott ügyfelekről szóló információ azért fontos, mert a PostgreSQL szempontjából az ügyfelek különbözőek lehetnek. Vannak jó ügyfelek és rossz ügyfelek.
Egyszerű példa. Ügyfél alatt értem az alkalmazást. Az alkalmazás csatlakozott az adatbázishoz, és azonnal elkezdi küldeni a kérdéseit, az adatbázis feldolgozza azokat és visszaküldi az eredményeket az ügyfélnek. Ezek jó és helyes ügyfelek.
Előfordulhat, hogy az ügyfél csatlakozott, fenntartja a kapcsolatot, de közben semmit sem csinál. Ez állapot idle-ben van.
De vannak rossz ügyfelek is. Például, ugyanaz az ügyfél csatlakozott, megnyitott egy tranzakciót, végzett valamit az adatbázisban, majd visszament a kódhoz, hogy mondjuk, egy külső forráshoz forduljon vagy adatfeldolgozást végezzen. De eközben nem zárta le a tranzakciót. Így a tranzakció lóg az adatbázisban, és blokkolást tart fent egy sorra. Ez rossz állapot. Ha az alkalmazás valahol belül megbukik egy kivétel (Exception) miatt, a tranzakció nagyon sokáig nyitva maradhat. Ez közvetlen hatással van a PostgreSQL teljesítményére. A PostgreSQL lassabban fog működni. Ezért fontos, hogy az ilyen ügyfeleket időben nyomon kövessük és kényszerítsük az ő munkájuk befejezésére. Az alkalmazásunkat is optimalizálni kell, hogy ne forduljanak elő ilyen helyzetek.
Más rossz ügyfelek a várakozó ügyfelek. De ők a körülmények miatt válnak rossz ügyfelekké. Például egy egyszerű várakozó tranzakció: meg tud nyitni egy tranzakciót, le tudja blokkolni bizonyos sorokat, majd valahol a kódban megbukik, és lógó tranzakció marad. Egy másik ügyfél jön, megkéri ugyanazokat az adatokat, de találkozik a blokkolással, mert az a lógó tranzakció már blokkolás alatt tart bizonyos szükséges sorokat. A második tranzakció így várakozni fog, amíg az első tranzakció befejeződik vagy az adminisztrátor kényszerítve zárja be. Így a várakozó tranzakciók felhalmozódhatnak, és túlléphetik az adatbázis kapcsolatok limitjét. Amikor a limit átlépésre kerül, az alkalmazás már nem tud dolgozni az adatbázissal. Ez már vészhelyzet a projekt számára. Ezért fontos figyelni a rossz ügyfelekre, és időben reagálni rájuk.
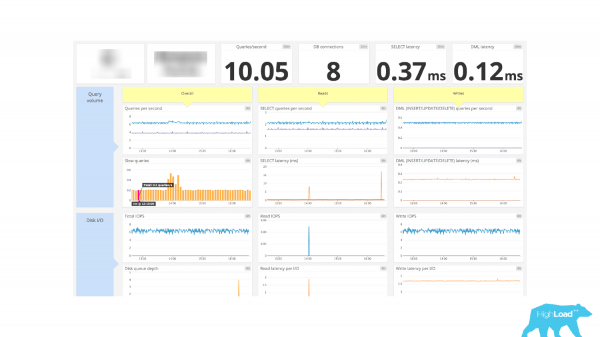
Egy másik példa a monitorozásra. Itt már egy rendezett irányítópult van. Fent található az információ a kapcsolatok számáról. DB connection – 8 darab. És ennyi. Nincs információnk arról, hogy mely ügyfelek aktívak, melyek csak tétlenek és nem csinálnak semmit. Nincs adat a lógó tranzakciókról és a várakozó kapcsolatok számáról, azaz ez egy olyan szám, amely megmutatja a kapcsolatok számát és ennyit. A továbbiakban találgassanak csak.
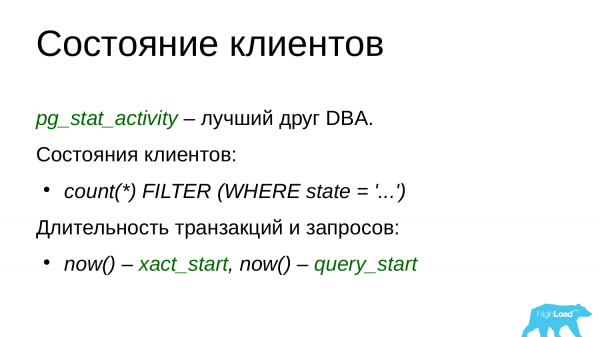
Ezért, hogy ezt az információt a monitorozásba beilleszthessük, a pg_stat_activity rendszer nézethez kell fordulnunk. Ha sok időt töltöttél PostgreSQL-ben, ez egy nagyon hasznos nézet, amely a barátoddá válhat, mivel megmutatja a PostgreSQL jelenlegi tevékenységét, azaz mi történik benne. Minden folyamatnak van egy külön sora, amely információt ad az adott folyamatról: milyen gépről történt a csatlakozás, mely felhasználóval, milyen név alatt, mikor indult a tranzakció, milyen lekérdezés folyik éppen, és mi volt az utolsó végrehajtott lekérdezés. Így a kliens állapotát az stat mező alapján tudjuk értékelni. Más szóval, csoportosítást végezhetünk e mező szerint, és megkaphatjuk azokat a statisztikákat, amelyek most a adatbázisban vannak, és a csatlakozások számát, amelyek e statisztikával rendelkeznek az adatbázisban. A kapott számokat pedig elküldhetjük a monitorozónkba, és grafikonokat készíthetünk belőlük.
A tranzakciók időtartamának értékelése is fontos. Már beszéltem arról, hogy a takarítás időtartamát fontos mérni, de a tranzakciók értékelése pontosan ugyanígy történik. Vannak xact_start és query_start mezők. Ezek felejtsük el, a tranzakciók és a lekérdezések indítási idejét mutatják. Az now() függvényt vesszük, amely a jelenlegi időbélyeget mutatja, és kivonjuk a tranzakció és a lekérdezés timestamp-jét. Így megkapjuk a tranzakció időtartamát, valamint a lekérdezés időtartamát.
Ha hosszú tranzakciókat látunk, már be kell fejeznünk őket. OLTP terhelés esetén a hosszú tranzakciók már 1-2-3 percnél hosszabbak.. OLAP terhelés esetén a hosszú tranzakciók normálisak, de ha azok két óránál tovább futnak, az is jelzi, hogy valahol probléma van.
Amikor az ügyfelek csatlakoznak az adatbázishoz, elkezdik feldolgozni az adatainkat. Hozzáférnek a táblákhoz, hozzáférnek az indexekhez, hogy adatokat nyerjenek ki a táblából. Fontos értékelni, hogyan dolgoznak az ügyfelek ezekkel az adatokkal.
Ez arra szolgál, hogy értékeljük a munkaterhelésünket, és nagyjából megértsük, hogy mely táblák a leg"forróbbak". Például, amikor a "forró" táblákat szeretnénk egy gyors SSD tárolóra helyezni. Azok a régi archív táblák, amelyeket már régóta nem használunk, áthelyezhetők egy "hideg" archívumba, SATA lemezekre, ahol élhetnek, és csak szükség esetén hivatkozunk rájuk.
Ez hasznos anomáliák észlelésére is a különféle kiadások és telepítések után. Tegyük fel, hogy a projekt kiadott egy új funkciót. Például, hozzáadtak egy új funkciót az adatbázissal való munkához. Ha grafikonokat készítünk a táblák használatáról, könnyen észlelhetjük ezeket az anomáliákat a grafikonokon. Például, a frissítési vagy törlési csúcsokat. Ez nagyon jól látható lesz.
Anomáliákat lehet felfedezni a "módosult" statisztikák esetén is. Mit jelent ez? A PostgreSQL-ben nagyon erős és jó lekérdezés-tervező található. A fejlesztők sok időt szánnak a fejlesztésére. Hogyan működik? Ahhoz, hogy jó terveket készítsen, a PostgreSQL egy bizonyos időintervallumban, rendszeresen gyűjti a statisztikákat az adatok eloszlásáról a táblákban. Ezek a leggyakoribb értékek: egyedi értékek száma, NULL-információ a táblázatban, rengeteg információ.
Ezek alapján a tervező különböző lekérdezéseket épít, választja ki a legoptimálisabbat, és ezt a lekérdezési tervet használja a lekérdezés végrehajtásához és az adatok visszaadásához.
Előfordulhat, hogy a statisztika "elúszik". Az adatok minősége és mennyisége megváltozott a táblában, de a statisztikát nem gyűjtötték össze. Így a létrehozott tervek nem optimálisak lehetnek. Ha a terveink nem optimálisak a gyűjtött megfigyelések alapján, a tábláknál láthatjuk ezeket az anomáliákat. Például, ha valahol lényegesen megváltoztak az adatok, és az index helyett a táblán való soros áthaladás kezdett el használódni, tehát, ha a lekérdezésnek csak 100 sort kell visszaadnia (limittel 100), akkor ehhez a lekérdezéshez teljes átvizsgálást kell végezni. Ez mindig nagyon rossz hatással van a teljesítményre.
És ezt láthatjuk a megfigyelés során. Már megnézhetjük ezt a lekérdezést, elvégezhetjük rajta az explain-t, összegyűjthetjük a statisztikákat, létrehozhatunk egy új, kiegészítő indexet. És már reagálhatunk erre a problémára. Ezért ez fontos.
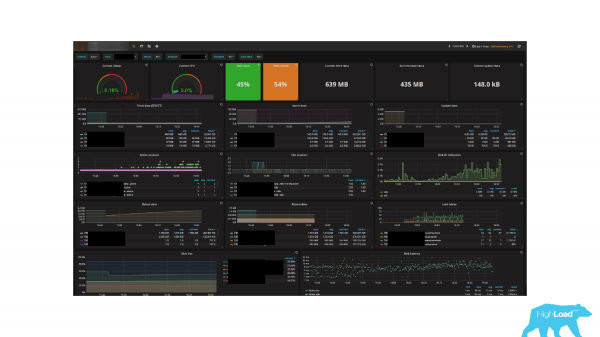
Egy másik példa a megfigyelésre. Azt hiszem, sokan már ismerik, mert nagyon népszerű. Ki használja a projektjeiben? ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. De van itt egy rossz részlet.
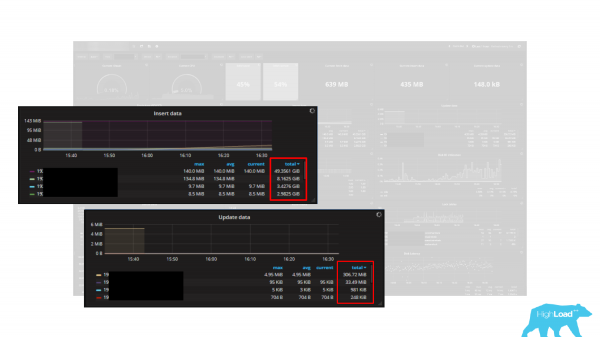
Több grafikon van. És az egységükként byte-ok vannak megadva, azaz 5 grafikon van. Ezek: Insert data, Update data, Delete data, Fetch data és Return data. Az egység mérése byte-okban van. De az a helyzet, hogy a PostgreSQL statisztikái tuple-ként (sorokban) szolgáltatják az adatokat. Ennek megfelelően ezek a grafikonok nagyon jó módját jelenthetik a munkaterhelés jelentős csökkentésének, mert a tuple nem byte, a tuple egy sor, az sok byte, és mindig változó hosszúságú. Azaz a munkaterhelés byte-okban való kiszámítása tuple-k segítségével irreális feladat vagy nagyon nehéz. Ezért amikor dashboard-ot vagy beépített megfigyelést használ, mindig fontos megérteni, hogy az helyesen működik, és helyesen értékelt adatokat ad vissza.
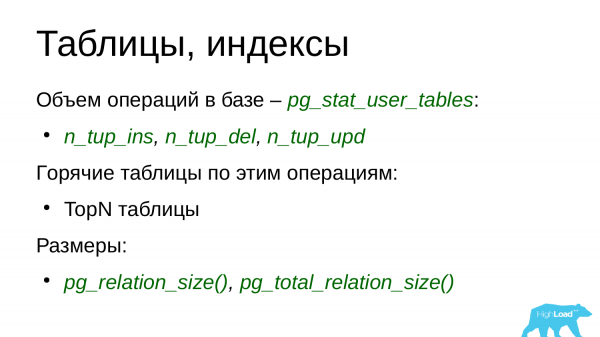
Hogyan nyerhetünk statisztikákat ezeken a táblákon? Erre a PostgreSQL-ben van egy bizonyos család nézet. A fő nézet pedig az . A user_tables azt jelenti, hogy a felhasználó által létrehozott táblák. Ezzel szemben léteznek rendszerszintű nézetek, amelyeket maguk a PostgreSQL használnak. És van egy összesítő táblázat, az Alltables, amely tartalmazza mind a rendszerszintű, mind a felhasználói táblákat. Bármelyikből kiindulhat, ami a legjobban tetszik.
A fent említett mezők alapján értékelhetjük az insert, update és delete mennyiségét. Az a dashboard példa, amit használtam, pontosan ezeket a mezőket használja a munkaterhelés jellemzőinek értékelésére. Ezért mi is támaszkodhatunk ezekre. De érdemes emlékezni arra, hogy ezek tuple-k, nem byte-ok, ezért nem tudjuk egyszerűen byte-ként kezelni őket.
Ezeken az adatokon alapulva elkészíthetjük az úgynevezett TopN táblázatokat. Például Top-5, Top-10. És nyomon követhetjük azokat a „forró” táblákat, amelyek jobban használódnak, mint a többiek. Például az 5 „forró” tábla beszúrása. És ezeken a TopN táblázatokon keresztül értékeljük a munkaterhelésünket, és nyomon követhetjük a munkaterhelés ingadozásait különböző kiadások és frissítések, valamint deployok után.
Fontos, hogy értékeljük a táblázatok méretét, mert néha a fejlesztők új funkciókat vezetnek be, és a táblázataink megnövekednek az új adatok miatt, anélkül hogy előre megjósolták volna, hogyan fog ez hatni az adatbázis méretére. Az ilyen esetek néha meglepetések lehetnek számunkra.
Most jön egy kis kérdés az ön számára. Milyen kérdés merül fel, amikor észreveszi a terhelést az adatbázis szerverén? Mi a következő kérdés, ami felmerül önben?
De a következő kérdés így merül fel. Milyen lekérdezések okozzák a terhelést? Tehát, nem érdekes nézni a folyamatokat, amelyek terhelést okoznak. Nyilvánvaló, hogy ha a hoston adatbázis van, akkor az adatbázis fut és értelemszerűen csak az adatbázisok fogják lefoglalni a rendszert. Ha megnézzük a Top parancsot, akkor látni fogjuk a PostgreSQL folyamatainak listáját, amelyek valamit csinálnak. A Top-ból azonban nem lesz világos, hogy mit csinálnak.
Ezért fel kell ismerni azokat a lekérdezéseket, amelyek a legnagyobb terhelést okozzák, mert a lekérdezések optimalizálása általában nagyobb hasznot hoz, mint a PostgreSQL vagy az operációs rendszer konfigurációjának optimalizálása, esetleg a hardver optimalizálása. Szerintem ez körülbelül 80-85-90%-ot jelent. Ráadásul ezt sokkal gyorsabban lehet elvégezni. Gyorsabb módosítani egy lekérdezést, mint a konfigurációt módosítani, újraindítást tervezni, különösen, ha az adatbázist nem lehet újraindítani, vagy ha hardvert kell hozzáadni. Egyszerűbb valahol átírni a lekérdezést vagy indexet hozzáadni, hogy jobb eredményt kapjunk a lekérdezésből.
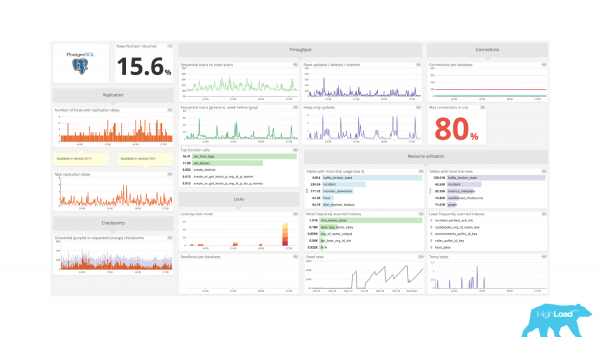
Ezért szükség van a lekérdezések és azok ésszerűségének figyelésére. Vegyünk egy másik példát a monitorozásra. És itt is, látszólag kitűnő a monitorozás. Van információ a replikációról, az átviteli sebességről, a zárolásokról, az erőforrások kihasználásáról. Minden csodálatos, de nincs információ a lekérdezésekről. Nem világos, hogy milyen lekérdezések futnak az adatbázisunkban, mennyi ideig tartanak, hány ilyen lekérdezés van. Mindig szükség van erre az információra a monitorozásban.
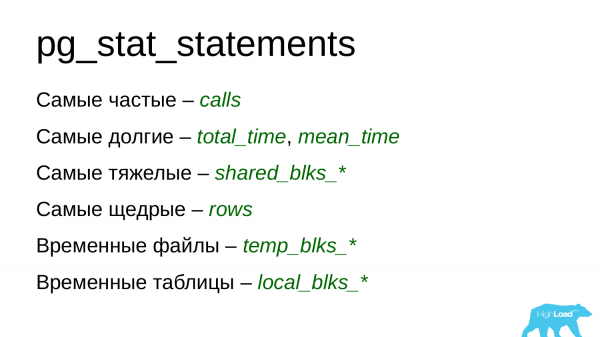
És ennek az információnak a megszerzéséhez használhatjuk a pg_stat_statements modult. Ennek alapján különféle grafikonokat építhetünk. Például információt nyerhetünk a leggyakoribb lekérdezésekről, azaz azokról a lekérdezésekről, amelyeket a leggyakrabban futtatnak. Igen, a telepítések után is nagyon hasznos ránézni és megérteni, hogy van-e valamilyen hirtelen kérdésrobbanás.
Megmonitorozhatjuk a leghosszabb lekérdezéseket, azaz azokat, amelyek a leghosszabb ideig futnak. Ezek a processzoron dolgoznak, és igénylik a bemeneti-kimeneti műveleteket. Ezt is értékelhetjük a total_time, mean_time, blk_write_time és blk_read_time mezők alapján.
Értékelhetjük és monitorozhatjuk a legnagyobb erőforrás-igényű lekérdezéseket, azokat, amelyek lemezről olvasnak, amelyek a memóriahasználattal foglalkoznak, vagy éppen ellenkezőleg, valamilyen írási terhelést generálnak.
Értékelhetjük a legbőkezűbb lekérdezéseket is. Ezek azok a lekérdezések, amelyek nagy mennyiségű sort adnak vissza. Például lehet egy olyan lekérdezés, ahol elfelejtették megadni a limitet. Ez egyszerűen visszaadja az összes táblázat tartalmát, vagy a kért táblázatok nyomán a lekérdezést.
Monitorozhatjuk a lekérdezéseket is, amelyek ideiglenes fájlokat vagy ideiglenes táblázatokat használnak.
Maradtak a háttérfolyamatok is. A háttérfolyamatok elsősorban a checkpointok, amelyeket ellenőrző pontoknak is hívnak, az autovacuum és a replikáció.
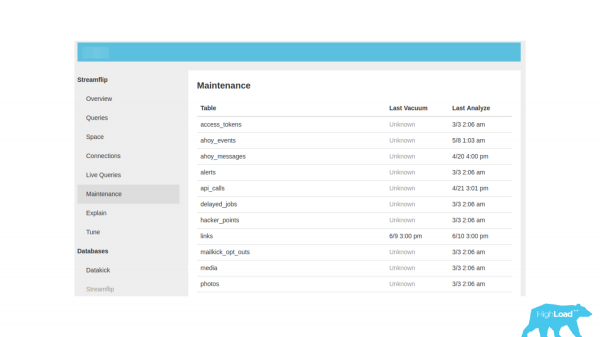
Egy másik példa a monitorozásra. Balra található a Karbantartás fül, átválthatunk, és reméljük, hogy találunk valami hasznosat. De itt csak a vákuum időtartama és a statisztikai gyűjtés ideje található, más semmi. Ez nagyon szegényes információ, ezért mindig szükség van arra, hogy megértsük, hogyan működnek a háttérfolyamatok az adatbázisunkban, és hogy vannak-e problémák a működésükkel.
Amikor a checkpointokat vizsgáljuk, emlékeznünk kell arra, hogy a checkpointok a 'piszkos' oldalakat a shardolt memóriából a lemezre írják, majd létrehoznak egy checkpointot. Ez a checkpoint már később felhasználható egy hely, amikor a PostgreSQL váratlanul leállt.
Tehát ahhoz, hogy az összes „piszkos” oldalt le tudjuk írni a lemezre, bizonyos mennyiségű írási műveletet kell végezni. Általában, ha sok a memória, az nagyon sok. Ha a csekkpontok nagyon gyakran történnek rövid időintervallumokban, akkor a lemez teljesítménye jelentősen csökken. Ez pedig a klienslekéréseket is hátrányosan érinti, mivel az erőforrásokért küzdenek, és nem lesz elegendő teljesítményük.
Így a pg_stat_bgwriter segítségével nyomon követhetjük a csekkpontok számát a megadott mezők alapján. Ha egy adott időintervallumban (például 10-15-20 perc, fél óra) túl sok csekkpont történik, mondjuk 3-4-5 darab, akkor ez már probléma lehet. Ekkor érdemes megnézni az adatbázist és a konfigurációt, hogy mi okozhatja ezt a sok csekkpontot. Lehet, hogy nagy írási műveletek zajlanak. A munkaterhelés alapján már tudunk értékelni, mivel a munkaterhelési grafikonok is fel lettek véve. Ki tudjuk finomítani a csekkpontok beállításait, és úgy módosítani, hogy ne befolyásolják jelentősen a lekérések teljesítményét.
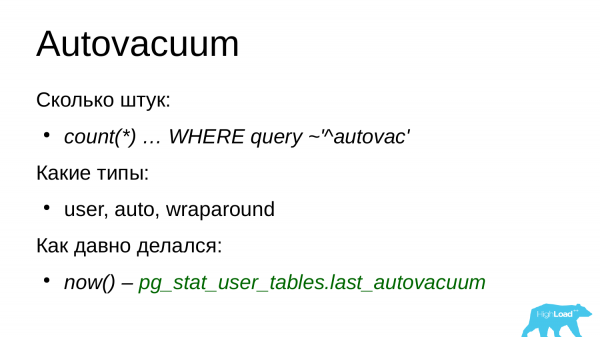
Ismét a vacuum automatizálásról beszélek, mert ez egy olyan dolog, amely, mint már említettem, könnyen befolyásolhatja a lemezek és a lekérések teljesítményét, ezért mindig fontos értékelni az autovacuum mennyiségét.
Az autovacuum munkásainak száma az adatbázisban korlátozott. Alapértelmezés szerint három van, tehát ha folyamatosan három munkás dolgozik az adatbázison, az azt jelenti, hogy az autovacuum nincs megfelelően beállítva, emelni kell a korlátokat, felül kell vizsgálni az autovacuum beállításait, és már bele kell nézni a konfigurációba.
Fontos értékelni, hogy mely autovacuum munkások működnek. Lehet, hogy egy felhasználó által indított vacuumról van szó, a DBA kézzel indította el azt, és ez terhelést okozott. Vagy az is lehet, hogy a tranzakciószámlálót visszatekert vacuumokkal van dolgunk. Néhány PostgreSQL verziónál ezek nagyon nehezek. Könnyen előidézhetik a teljesítmény csökkenését, mert az egész táblát át kell nézniük, és a táblázat összes blokkját be kell járniuk.
És természetesen a vákuumok időtartama. Ha hosszú vákuumaink vannak, amelyek nagyon sokáig működnek, akkor érdemes újra a vákuum konfigurációjára figyelni, és esetleg felülvizsgálni a beállításait. Mert előfordulhat olyan helyzet, amikor a vákuum hosszú ideig dolgozik egy táblán (3-4 óra), de a vákuum alatt a táblában újra nagy mennyiségű halott sor gyűlhet össze. És ahogy a vákuum befejeződik, újra vákuumozni kell ezt a táblát. És eljutunk a helyzethez - végtelen vákuum. Ilyen esetben a vákuum nem tud megbirkózni a feladatával, és a táblák fokozatosan növekednek, holott a hasznos adatok mennyisége változatlan marad. Ezért a hosszú vákuumok esetén mindig figyelünk a konfigurációra, és próbáljuk optimalizálni, de úgy, hogy a kliens lekérdezések teljesítménye ne szenvedjen.
Jelenleg szinte nincs olyan PostgreSQL telepítés, ahol ne lenne streamelt replikáció. A replikáció az adatok átvitelének folyamata a mesterből a replikába.
A replikáció PostgreSQL-ben a tranzakciós napló révén valósul meg. A mester tranzakciós naplót generál. A tranzakciós napló a hálózati kapcsolaton keresztül a replikába érkezik, majd a replikán újra megjelenik. Egyszerű.
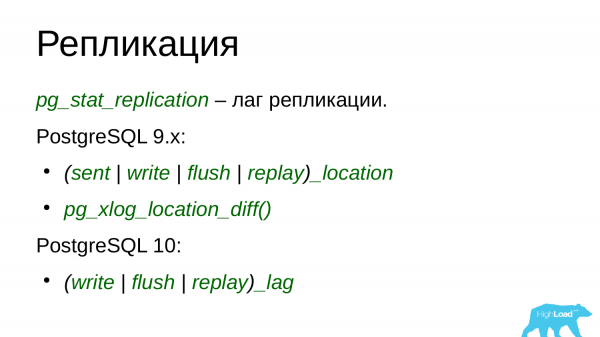
Ennek megfelelően a replikációs késés figyelésére a pg_stat_replication nézetet használják. De nem minden olyan egyszerű vele. A 10-es verzióban a nézet néhány változáson ment keresztül. Először is, néhány mezőt átneveztek. És néhány mező hozzá lett adva. A 10-es verzióban megjelentek olyan mezők, amelyek lehetővé teszik a replikációs késés másodpercekben való értékelését. Ez nagyon kényelmes. A 10-es verzió előtt a replikációs késés bájtokban való értékelésére volt lehetőség. Ez a lehetőség megmaradt a 10-es verzióban, tehát választhatja, mi a kényelmesebb - értékelni a késést bájtokban vagy másodpercekben. Sokan mindkettőt csinálják.
Mindazonáltal ahhoz, hogy értékelni tudjuk a replikációs késést, tudni kell a tranzakciós napló pozícióját. Ezek a tranzakciós napló pozíciók éppen a pg_stat_replication nézetben találhatók. Mondhatni, a pg_xlog_location_diff() függvény segítségével két pontot vehetünk a tranzakciós naplóban. Kiszámíthatjuk a delta közötti különbséget, és megkaphatjuk a replikációs késést bájtokban. Ez nagyon kényelmes és egyszerű.
A 10. verzióban ezt a funkciót pg_wal_lsn_diff()-ra keresztelték át. Általában minden olyan funkcióban, nézetben, eszközben, ahol az „xlog” szó előfordult, azt „wal”-ra cserélték. Ez érvényes a nézetekre és a funkciókra is. Ez egy új fejlesztés.
Ráadásul a 10. verzióban új sorok kerültek bevezetésre, amelyek konkrétan a késést mutatják. Ezek a write lag, flush lag, replay lag. Vagyis ezeket fontos figyelni. Ha azt látjuk, hogy a replikáció késlekedik, akkor meg kell vizsgálni, hogy mi okozta ezt, honnan származik, és meg kell szüntetni a problémát.
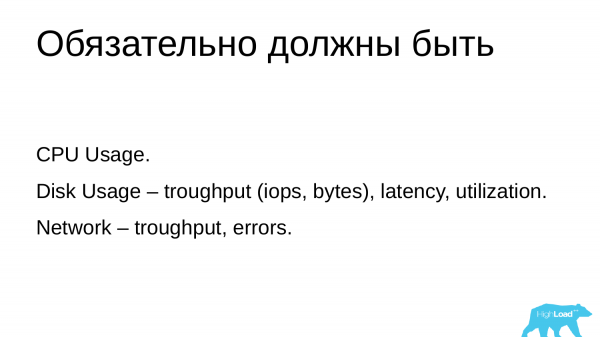
A rendszeres metrikák szinte minden rendben van. Amikor bármilyen felügyeleti rendszer létrejön, a rendszeres metrikák figyelésével kezdődik. Ez magában foglalja a processzorok, memória, swap, hálózat és lemez kihasználtságát. De számos paraméter alapértelmezés szerint hiányzik.
Ha a folyamat kihasználtsága rendben van, a lemez kihasználtságával problémák vannak. Általában a fejlesztők beépítik az átbocsátóképesség információit, ami lehet IOPS-ban vagy byte-okban. De elfelejtik a késleltetést és a lemez eszközök kihasználtságát. Ezek sokkal fontosabb paraméterek, amelyek lehetővé teszik, hogy felmérjük, mennyire terheltek a lemezek és mennyire lassítanak. Ha magas a késleltetés, az azt jelenti, hogy problémák vannak a lemezekkel. Ha magas a kihasználtság, akkor pedig azt, hogy a lemezek nem bírják a terhelést. Ezek jobb minőségű jellemzők, mint az átbocsátóképesség.
Bár ezt a statisztikát a fájlrendszerből is meg lehet szerezni a /proc útvonalon, ahogyan a processzorok kihasználtságát is mérik. Miért nem adják hozzá ezeket az információkat a felügyeleti rendszerekhez, azt nem tudom. De mindenesetre fontos, hogy ez is része legyen a felügyeletnek.
Ugyanez vonatkozik a hálózati interfészekre is. Van információ a hálózat átbocsátóképességéről csomagokban, byte-okban, de az zavaró, hogy nincs információ a késleltetésről és nincs információ a kihasználtságról, pedig ez hasznos információ lenne.
Bármelyik felügyeleti rendszernek vannak hátrányai. Bármilyen felügyeleti rendszert is nézünk, az mindig nem felel meg valamilyen kritériumnak. De mindenesetre fejlődnek, új funkciók, új dolgok kerülnek bevezetésre, ezért válasszon valamit, és fejlessze tovább.
És ahhoz, hogy fejleszthessünk, mindig tudni kell, hogy mit jelentenek a statisztikák, és hogyan segíthetnek a problémák megoldásában.
És néhány kulcsfontosságú pont:
- Mindig nyomon kell követni az elérhetőséget, be kell állítani a műszerfalakat, hogy gyorsan értékelhessük, hogy minden rendben van az adatbázissal.
- Mindig tudni kell, hogy mely ügyfelek dolgoznak az adatbázisával, hogy kiszűrjük a rossz ügyfeleket és ki tudjuk őket zárni.
- Fontos értékelni, hogy ezek az ügyfelek hogyan használják az adatokat. Tudnia kell a munkaterheléséről.
- Fontos értékelni, hogy hogyan alakul ez a munkaterhelés, milyen lekérdezésekkel. Értékelheti a lekérdezéseket, optimalizálhatja őket, lehetőség van indexek létrehozására is. Ez nagyon fontos.
- A háttérfolyamatok negatívan befolyásolhatják az ügyféllekérdezéseket, ezért fontos figyelemmel kísérni, hogy ne használjanak túl sok erőforrást.
- A rendszermetrikák lehetővé teszik, hogy terveket készítsen a méretezésre, a szerverei kapacitásának növelésére, ezért fontos őket is nyomon követni és értékelni.
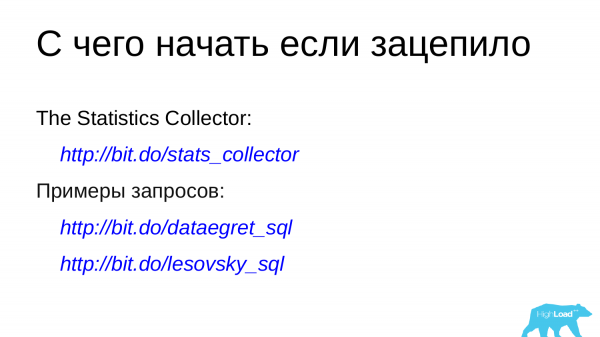
Ha érdekli ez a téma, akkor végigmehet ezeken a linkeken.
— ez a hivatalos dokumentáció a statisztikai gyűjtőkről. Itt találhatók minden statisztikai nézet leírásai és az összes mező leírása. Ezt elolvashatja, megértheti és elemezheti. Ezek alapján építheti a grafikonait, és hozzáadhatja a megfigyeléseihez.
Lekérdezések példái:
Ez a saját vállalati tárolónk és az én sajátom. Ezekben találhatóak lekérdezésminták. Nincs benne lekérdezés az alábbi típusú select* from valami. Ezek már készen álló lekérdezések, JOIN-okkal, érdekes funkciók alkalmazásával, amelyek lehetővé teszik, hogy a nyers számadatokból olvasható, könnyen használható értékeket nyerjünk, azaz byte-okat és időt. Ezeket elemezheti, nézegetheti, hozzáadhatja a megfigyeléseihez, és ezek alapján építheti a saját megfigyeléseit.
Kérdések
Kérdés: Azt mondta, hogy nem fogja reklámozni a márkákat, de mégis érdekelne – milyen műszerfalakat használ a projektjeiben?
Válasz: Különbözőképpen. Néha előfordul, hogy a megrendelőhöz megyünk, és már van saját megfigyelése. És tanácsot adunk a megrendelőnek, hogy mit kellene hozzáadnia a megfigyeléséhez. A legrosszabb helyzet a Zabbiх-szal van. Mert nem tud TopN grafikonokat építeni. Mi magunk , mert tanácsot adtunk ezeknek a srácoknak a megfigyelésben. Ők a mi műszaki leírásunk alapján készítették a PostgreSQL monitoringot. Én írok egy pet-projectet, ami az adatokat a Prometheusszal gyűjti és rajzolja ki. . Feladatunk, hogy a Prometheus-ban elkészítsük a saját exportálónkat, majd mindent megjelenítsünk a Grafanában.
Kérdés: Vannak-e analógjai az AWR-jelentéseknek vagy ... aggregációknak? Tud valamiről ilyesmiről?
Válasz: Igen, tudom, mi az AWR, ez egy nagyszerű dolog. Jelenleg sok különböző megoldás létezik, amelyek nagyjából a következő modellt valósítják meg. Bizonyos időközönként néhány baseline-t rögzítenek a PostgreSQL-be vagy egy külön tárolóba. Ezeket az interneten megtalálhatja, léteznek. Az egyik ilyen megoldás fejlesztője a sql.ru fórumon ül a PostgreSQL szálban. Ott el lehet érni. Igen, ilyen megoldások léteznek, használhatók. Ráadásul én is írok egy hasonlót, amely lehetővé teszi a hasonlót.
P.S.1 Ha postgres_exportert használ, akkor melyik műszerfalat használja? Több is létezik. Ezek már elavultak. Talán a közösség létrehozhatna egy frissített sablont?
P.S.2 Eltávolítottam a pganalyze-t, mivel egy saját SaaS ajánlat, amely a teljesítménymonitorozásra és az automatizált hangolási javaslatokra összpontosít.
Csak a regisztrált felhasználók vehetnek részt a szavazáson. , kérem.
Melyik self-hosted PostgreSQL monitorozónak (műszerfallal) tartja a legjobbnak?
30,0%Zabbix + kiegészítések Aleksey Lesovskytól vagy zabbix 4.4 vagy libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%a pganalyze egy saját SaaS -t nem tudom eltávolítani1
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
10 felhasználó szavazott. 26 felhasználó tartózkodott.
Forrás: habr.com
