

Helló, barátok. Mielőtt elindulnánk a májusi ünnepek második részére, megosztunk veletek egy anyagot, amelyet a kurzus új nyitási ajánlata előtt fordítottunk le. .
Az alkalmazásfejlesztők sok időt töltenek különböző operációs adatbázisok összehasonlításával, hogy megtalálják azt, amely a legjobban megfelel a tervezett munkaterhelésnek. Az igények közé tartozhat az adatok egyszerűsített modellezése, tranzakciós garanciák, olvasási/írási teljesítmény, vízszintes skálázhatóság és hibatűrés. Hagyományosan a választás a DBMS kategóriával kezdődik, SQL vagy NoSQL, mivel minden kategória világos kompromisszumkészletet biztosít. A magas teljesítmény, a kis késleltetés és a magas áteresztőképesség szempontjából jellemzően olyan elvárás, amely nem tűr kompromisszumot, ezért minden kiválasztott adatbázis számára szükséges.
Ennek a cikknek a célja, hogy segítsen az alkalmazásfejlesztőknek a helyes választásban az SQL és NoSQL között az alkalmazás adatmodellezése kapcsán. Megvizsgálunk egy SQL adatbázist, mégpedig a PostgreSQL-t, és két NoSQL adatbázist – a Cassandrát és a MongoDB-t –, hogy bemutassuk az adatbázisok tervezésének alapjait, például táblák létrehozását, azok feltöltését, adatok olvasását a táblából és azok törlését. A következő cikkben kötelezően foglalkozunk majd indexekkel, tranzakciókkal, JOIN-okkra, TTL direktívákkal és JSON-alapú adatbázis-tervezéssel.
Miben különbözik az SQL a NoSQL-tól?
Az SQL adatbázisok növelik az alkalmazás rugalmasságát az ACID tranzakciós garanciák révén, valamint a lehetőségeiknek köszönhetően, hogy a meglévő normalizált relációs adatbázis-modelleken felül váratlan módon kérjünk le adatokat JOIN-ok segítségével.
A monolitikus/single-node architektúrájuk és a master-slave replikációs modell használata miatt a hagyományos SQL adatbázisok nem rendelkeznek két fontos jellemzővel: az írás lineáris skálázhatóságával (azaz automatikus szétválasztás több csomópont között) és az automatikus/nulás adatveszteséggel. Ez azt jelenti, hogy a beérkező adatok mennyisége nem haladhatja meg egy csomópont maximális írási kapacitását. Ezenkívül a magas rendelkezésre állásnál figyelembe kell venni az esetleges időszakos adatveszteséget (az erőforrások elosztása nélküli architektúrában). Itt figyelembe kell venni, hogy a legutóbbi kötelező műveletek még nem tükröződnek a slave másolatban. A leállás nélküli frissítések szintén nehezen elérhetők az SQL adatbázisokban.
A NoSQL adatbázisok alapvetően elosztott rendszerek, azaz az adatok szekciókra oszlanak és több csomópont között oszlanak meg. Normalizálást igényelnek. Ez azt jelenti, hogy a beírt adatokat többször is másolni kell, hogy válaszolni tudjanak a konkrét lekérdezésekre, amelyeket küldesz. Az általános cél a magas teljesítmény elérése az olvasás közben rendelkezésre álló shardok számának csökkentésével. Ebből kifolyólag a NoSQL megköveteli, hogy a lekérdezéseidet modellezd, míg az SQL a data modellezését igényli.
A NoSQL arra összpontosít, hogy magas teljesítményt nyújtson egy elosztott klaszterben, ami a DB dizájn számos kompromisszumának fő indoklása, ami magában foglalja az ACID tranzakciós garanciák elvesztését, a JOIN-okat és a globálisan konzisztens másodlagos indexek elvesztését.
Vannak, akik úgy vélik, hogy bár a NoSQL adatbázisok lineárisan skálázható írást és magas hibátűrést biztosítanak, a tranzakciós garanciák elvesztése miatt nem alkalmasak kritikus adatok kezelésére.
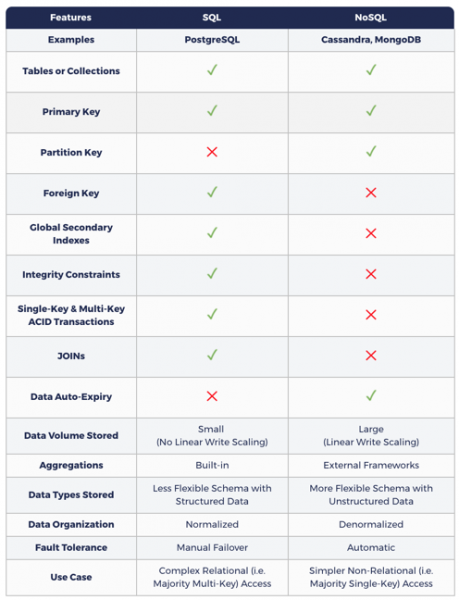
Az alábbi táblázat bemutatja, hogy a NoSQL adatok modellezése hogyan különbözik az SQL-től.
SQL és NoSQL: Miért szükséges mindkettő?
A valódi, nagyszámú felhasználóval rendelkező alkalmazások, mint az Amazon.com, Netflix, Uber és Airbnb, összetett, diverzifikált feladatok végrehajtására építenek. Például egy Amazon.com-hoz hasonló elektronikus kereskedelmi alkalmazásnak könnyű, magas prioritású adatokat, mint a felhasználói információk, termékek, rendelések, számlák, szükséges tárolnia, miközben nehéz, de kevésbé érzékeny adatokat is, mint a termékvélemények, ügyfélszolgálati üzenetek, felhasználói aktivitások, visszajelzések és ajánlások. Természetesen ezek az alkalmazások legalább egy SQL adatbázisra támaszkodnak, legalább egy NoSQL adatbázis mellett. A regionális és globális rendszerekben a NoSQL adatbázis georedundáns cache-ként működik, az adatok pedig egy megbízható forrásban, az SQL adatbázisban, amely egy adott régióban működik.
Hogyan egyesíti a YugaByte DB a SQL-t és a NoSQL-t?
A naplóorientált hibrid tárolómotorra, automatikus shardelésre, sharding elosztott konszenzus replikációra és elosztott ACID tranzakciókra (a Google Spanner által inspirálva) építve a YugaByte DB a világ első nyílt forráskódú adatbázisa, amely egyidejűleg kompatibilis a NoSQL (Cassandra & Redis) és a SQL (PostgreSQL) rendszerével. Ahogy az alábbi táblázatban látható, a YCQL, a YugaByte DB Cassandra-kompatibilis API-ja, bevezeti az egy- és többszólamú ACID tranzakciók és a globális másodlagos indexek fogalmát a NoSQL API-ba, ezzel megnyitva az utat a tranzakcionális NoSQL adatbázisok előtt. Továbbá, a YCQL, a YugaByte DB PostgreSQL-kompatibilis API-ja, bevezeti a lineáris írási skálázás és az automatikus hibajavítás fogalmát a SQL API-ba, bemutatva a világ számára az elosztott SQL adatbázisokat. Mivel a YugaByte DB alapvetően tranzakcionális, a NoSQL API most már kritikus fontosságú adatok esetén is felhasználható.
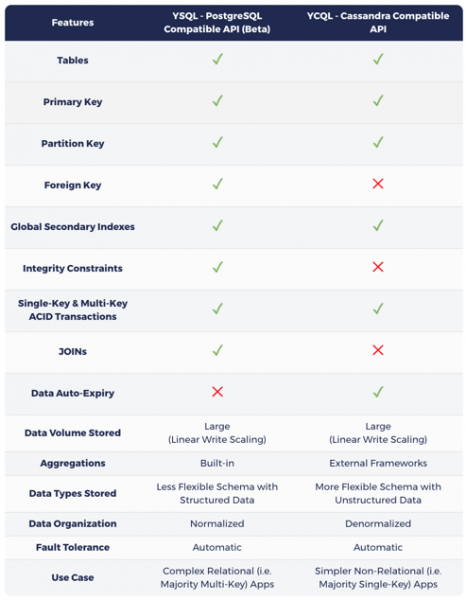
Ahogy azt a cikk korábban említette, , az SQL és a NoSQL közötti választás a YugaByte DB-ben teljes mértékben a munkahelyi terhelés alapvető jellemzőitől függ:
- Ha az alapvető munkaterhelés többszólamú JOIN műveletekkel dolgozik, legyen tudatában, hogy a kiválasztott YSQL esetén a kulcsok több csomóponton is eloszthatók, ami magasabb késleltetést és/vagy alacsonyabb áteresztőképességet eredményezhet, mint a NoSQL esetén.
- Ellentétben a többi lehetőséggel, válasszon bármelyik két NoSQL API közül, azt szem előtt tartva, hogy a teljesítmény javulására számíthat, mivel egyetlen csomópont által szolgáltatott lekérdezéseket kezelnek egyszerre. A YugaByte DB egy egységes adatbázis-platform lehet a valódi, komplex alkalmazások számára, ahol több munkaterhelést kell egyszerre kezelni.
A következő szakaszban a Data modeling lab alapja a PostgreSQL és Cassandra kompatibilis YugaByte DB adatbázisok, szemben az eredeti adatbázisokkal. Ez a megközelítés hangsúlyozza a két különböző API (két különböző porton) könnyű interakcióját ugyanazon az adatbázis klaszteren, ahelyett, hogy két teljesen független adatbázis klasztert használnánk.
A következő szakaszokban bemutatjuk az adatok modellezési laboratóriumát, hogy illusztráljuk az érintett adatbázisok közötti különbségeket és hasonlóságokat.
Adatok modellezése
Adatbázisok telepítése
Tekintettel az adatomodell tervezésére (nem a bonyolult telepítési architektúrákra), az adatbázisokat Docker tartályokba telepítjük a helyi gépen, majd ezekkel a megfelelő parancssori felületeken fogunk interakcióba lépni.
PostgreSQL & Cassandra kompatibilis YugaByte DB adatbázis
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestHozzáférés parancssorból
Csatlakozzunk az adatbázisokhoz a megfelelő API parancssori felületével.
PostgreSQL
— ez a parancssori felület a PostgreSQL-lal való interakcióhoz. A YugaByte DB a használhatóság érdekében beépített psql-t tartalmaz a bin mappájában.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— ez a parancssori felület a Cassandraval és annak kompatibilis adatbázisaival való interakcióhoz a CQL (Cassandra Query Language) használatával. A YugaByte DB a használhatóság érdekében tartalmazza a cqlsh a könyvtárban bin.
Vegye figyelembe, hogy a CQL az SQL-ből merített ihletet, és hasonló fogalmakkal rendelkezik, mint táblák, sorok, oszlopok és indexek. Azonban mint NoSQL nyelv, bizonyos korlátozásokat is hozzáad, amelyeket többségében más cikkekben is tárgyalunk.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– ez a parancssori felület a MongoDB-vel való interakcióra. A MongoDB telepítési könyvtárában található bin könyvtárban elérhető.
docker exec -it my-mongo bash
cd bin
mongo
Tábla létrehozása
Most már interakcióba léphetünk az adatbázissal különböző műveletek végrehajtására a parancssoron keresztül. Kezdjünk egy tábla létrehozásával, amely különböző előadók által írt dalok információit tárolja. Ezek a dalok album részei lehetnek. Az opcionális attribútumok közé tartozik a megjelenési év, az ár, a műfaj és az értékelés. Figyelembe kell vennünk a jövőben szükséges további attribútumokat is a „címkék” mezőn keresztül. Ez a mező kulcs-érték pár formájában tárolhat félig strukturált adatokat.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
A tábla létrehozása Cassandra-ban nagyon hasonló a PostgreSQL-hez. Az egyik fő különbség a külső integritási korlátozások (például NOT NULL) hiánya, ami a alkalmazás felelősségi körébe tartozik, nem pedig a NoSQL adatbázisoké.. Az elsődleges kulcs egy partíció kulcsból (az Artist oszlop az alábbi példában) és egy klaszterezési oszlopok halmazából (a SongTitle oszlop az alábbi példában) áll. A partíció kulcs határozza meg, hogy melyik partícióba/shardba kerül a sor, míg a klaszterezési oszlopok azt jelölik, hogyan kell a meglévő shardon belül strukturálni az adatokat.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
A MongoDB az adatokat adatbázisokba (Database) szervezi (ez a Cassandra-ban a Keyspace-nek felel meg), ahol gyűjtemények (Collections) találhatók (ezek felelnek meg a tábláknak), amelyekben dokumentumok (Documents) vannak (ezek felelnek meg a táblák soraival). A MongoDB-ben alapvetően nem szükséges az eredeti séma meghatározása. A "use database" parancs, «use database», amely alább látható, adatbázis példányt hoz létre az első híváskor, és megváltoztatja a kontextust az újonnan létrehozott adatbázishoz. Még a gyűjteményeket sem szükséges explicit létrehozni, azok automatikusan létrejönnek, amikor az első dokumentumot hozzáadják egy új gyűjteményhez. Ne feledje, hogy a MongoDB alapértelmezetten a tesztadatbázist használja, ezért bármilyen gyűjteménnyel kapcsolatos művelet konkrét adatbázis megadása nélkül alapértelmezetten ott fog végrehajtódni.
use myNewDatabase;Információ megszerzése a tábláról
PostgreSQL
d Zene
Tábla "public.music"
    Oszlop         |         Típus          | Collation | Nullable | Alapértelmezett
-----------------+-----------------------+-----------+----------+--------
 művész          | karakter változó(20)  |           | nem null  |
 dalcím         | karakter változó(30)  |           | nem null  |
 albumcím       | karakter változó(25)  |           |          |
 év             | egész szám            |           |          |
 ár             | dupla precízió       |           |          |
 műfaj         | karakter változó(10)  |           |          |
 kritikus értékelés | dupla precízió       |           |          |
 címkék         | szöveg               |           |          |
Indexek:
    "music_pkey" PRÍM KULCS, btree (művész, dalcím)
Cassandra
LEÍRÁS TÁBLA ZENE;
TÁBLÁT KÉSZÍTS MYAPP.ZENE (
    művész szöveg,
    dalcím szöveg,
    albumcím szöveg,
    év egész,
    ár lebegő,
    műfaj szöveg,
    címkék szöveg,
    PRÍM KULCS (művész, dalcím)
) CLUSTERING ORDER BY (dalcím ASC)
    ÉS alapértelmezett_idő_tartam_a_túléléshez = 0
    ÉS tranzakciók = {'enabled': 'false'};
MongoDB
használja az újAdatbázisomat;
mutasd a gyűjteményeket;
Adatok beillesztése a táblába
PostgreSQL
BEILLÉS ZENÉBE
    (Művész, DalCím, AlbumCím,
    Év, Ár, Műfaj, KritikusÉrtékelés,
    Címkék)
ÉRTÉKEK(
    'Senki, akit ismersz', 'Hívj Ma', 'Kissé Híres',
    2015, 2.14, 'Country', 7.8,
    '{"Zeneszerzők": ["Smith", "Jones", "Davis"],"HosszMásodpercben": 214}'
);
BEILLÉS ZENÉBE
    (Művész, DalCím, AlbumCím,
    Ár, Műfaj, KritikusÉrtékelés)
ÉRTÉKEK(
    'Senki, akit ismersz', 'A kutyám Spot', 'Hé Most',
    1.98, 'Country', 8.4
);
BEILLÉS ZENÉBE
    (Művész, DalCím, AlbumCím,
    Ár, Műfaj)
ÉRTÉKEK(
    'Az Acme Zenekar', 'Nézd Ki, Világ', 'A Középpont Itt Kezdődik',
    0.99, 'Rock'
);
BEILLÉS ZENÉBE
    (Művész, DalCím, AlbumCím,
    Ár, Műfaj,
    Címkék)
ÉRTÉKEK(
    'Az Acme Zenekar', 'Még Mindig Szerelmes', 'A Középpont Itt Kezdődik',
    2.47, 'Rock',
    '{"rádióállomásokAmikJátszanak": ["KHCR", "KBQX", "WTNR", "WJJH"], "turnéDátumok": { "Seattle": "20150625", "Cleveland": "20150630"}, "forgás": Nehéz}'
);
Cassandra
Általában a kifejezés INSERT Cassandra-ban nagyon hasonlóan néz ki, mint a PostgreSQL-ben. Azonban van egy jelentős eltérés a szemantikában. Cassandra INSERT tulajdonképpen egy művelet UPSERT, ahol az utolsó értékek kerülnek hozzáadásra a sorhoz, ha a sor már létezik.
A beviteli folyamat hasonlóan zajlik mint a PostgreSQL-ben
INSERTfentebb
.
MongoDB
Annak ellenére, hogy a MongoDB NoSQL adatbázis, akárcsak a Cassandra, az adatok beillesztése nem mutat semmiféle hasonlóságot a Cassandra viselkedésével. A MongoDB nem rendelkezik képességekkel UPSERT, ami a PostgreSQL-re hasonlít. Az alapértelmezett adatok hozzáadása _idspecified új dokumentum hozzáadását eredményezi a gyűjteményhez.
db.music.insert( {
 artist: "Senki, Akiket Nem Ismersz",
 songTitle: "Hívj Ma",
 albumTitle: "Valamennyire Híres",
 year: 2015,
 price: 2.14,
 genre: "Country",
 tags: {
 Composers: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "Senki, Akiket Nem Ismersz",
 songTitle: "A Kutyám Spot",
 albumTitle: "Hé Most",
 price: 1.98,
 genre: "Country",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "Az Acme Zenekar",
 songTitle: "Figyelj, Világ",
 albumTitle:"A Pénz Itt Kezdődik",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "Az Acme Zenekar",
 songTitle: "Még Mindig Szerelmes",
 albumTitle:"A Pénz Itt Kezdődik",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Heavy"
 }
 }
 );
Tábla lekérdezés
Valószínűleg a legszembetűnőbb különbség az SQL és a NoSQL között a lekérdezések megfogalmazása terén az, hogy FROM és AHOL. Az SQL lehetővé teszi a lekérdezés utáni kifejezések megfogalmazását FROM több tábla kiválasztására, míg a kifejezés a AHOL bármilyen összetettségű lehet (beleértve a műveleteket is JOIN táblák között). Azonban a NoSQL hajlamos szigorú korlátozásokat alkalmazni a FROMhasználatára, és csak egy megadott táblával működik. AHOL, mindig meg kell adni az elsődleges kulcsot. Ez összefügg a NoSQL teljesítményének növelésére irányuló törekvésekkel, amelyeket korábban említettünk. Ez a törekvés bármilyen kereszt-táblázati és kereszt-kulcsú interakció csökkentésére irányul. Ez nagy késést okozhat a csomópontok közötti kommunikációban a lekérdezés megválaszolásakor, ezért alapvetően érdemes elkerülni. Például a Cassandra megköveteli, hogy a lekérdezések korlátozottak legyenek bizonyos operátorokra (csak engedélyezett =, IN, , =>, <=) a partíciós kulcsokon, kivéve a másodlagos index lekérdezésének esetét (itt csak az = operátor engedélyezett).
PostgreSQL
Íme három példa lekérdezésre, amelyeket SQL adatbázis könnyedén végrehajthat.
- Listázza az összes dalt az előadótól;
- Listázza az összes dalt az előadótól, amelyek a cím első részével egyeznek;
- Listázza az összes dalt az előadótól, amelyek tartalmaznak egy adott szót a címükben, és az ára kevesebb mint 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
A fent említett lekérdezések közül PostgreSQL-ben csak az első fog működni a Cassandra-ban módosítás nélkül, mivel az operátor LIKE nem alkalmazható a klaszterezett oszlopokra, mint például a SongTitle.Ebben az esetben csak az = és IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Ahogy a korábbi példákban látható, a MongoDB lekérdezések létrehozásának alapvető módja . Ez a metódus kifejezetten tartalmazza a gyűjtemény nevét (zene az alábbi példában), ezért több gyűjteményen keresztüli lekérdezés tilos.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Az összes táblázatsor beolvasása
Az összes sor beolvasása csupán a korábban tárgyalt lekérdezési minta egy külön esete.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Hasonlóan a fenti PostgreSQL példához.
MongoDB
db.music.find( {} );Adatok szerkesztése a táblázatban
PostgreSQL
A PostgreSQL rendelkezik UPDATE utasítással az adatok módosítására. Ennek nincs lehetősége UPSERT, így ez az utasítás hibát okoz, ha a sor már nem létezik az adatbázisban.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
A Cassandra rendelkezik egy UPDATE hasonló PostgreSQL-hez. UPDATE ugyanazt a szemantikát tartalmazza UPSERT, hasonlóan az INSERT.
Hasonlóan a fenti PostgreSQL példához.
MongoDB
Művelet A MongoDB teljesen frissítheti a meglévő dokumentumot, vagy csak bizonyos mezőket frissíthet. Alapértelmezés szerint csak egy dokumentumot frissít, letiltott szemantikával. UPSERT. Több dokumentum frissítése és a viselkedés hasonló. UPSERT alkalmazható, ha további kapcsolókat állítunk be a művelethez. Ahogyan az alábbi példában a konkrét előadó műfajának frissítése történik a dalán keresztül.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Adatok eltávolítása a táblából
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Hasonlóan a fenti PostgreSQL példához.
MongoDB
A MongoDB-ben két típusú művelet létezik a dokumentumok törlésére — és . Mindkét típus törli a dokumentumokat, de eltérő eredményeket ad vissza.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Tábla törlése
PostgreSQL
DROP TABLE Music;Cassandra
Hasonlóan a fenti PostgreSQL példához.
MongoDB
db.music.drop();Zárás
A vita az SQL és NoSQL közötti választásról már több mint 10 éve folyik. Két fő aspektusa van ennek a vitának: az adatbázis magarchitektúrája (monolitikus, tranzakcionális SQL szemben elosztott, nem tranzakcionális NoSQL) és az adatbázis tervezési megközelítése (adatmodellezés SQL-ben szemben a lekérdezések modellezésével NoSQL-ben).
Egy elosztott tranzakcionális adatbázissal, mint például a YugaByte DB, az adatbázis architektúrával kapcsolatos viták könnyen eloszlathatók. Ahogy az adatmennyiségek meghaladják, amit egy csomópont képes rögzíteni, a teljesen elosztott architektúra, amely támogatja a lineáris írásbővítést automatikus shardinggal/újraelosztással, szükségessé válik.
Az egyik cikkben elmondottak szerint , a tranzakcionális, szigorúan konzisztens architektúrák most szélesebb körben alkalmazhatók a fejlesztés rugalmasságának biztosítására, mint a nem tranzakcionális, végső soron konzisztens architektúrák.
A database design discussion would be incomplete without acknowledging that both SQL and NoSQL design approaches are essential for any complex real-world application. The SQL approach of 'data modeling' enables developers to more easily meet changing business requirements, while the NoSQL 'query modeling' approach allows the same developers to handle large volumes of data with low latency and high throughput. This is why YugaByte DB offers both SQL and NoSQL APIs within a unified core, rather than promoting one approach over the other. Additionally, by providing compatibility with popular database languages, including PostgreSQL and Cassandra, YugaByte DB ensures that developers do not need to learn a new language to work with a distributed, strongly consistent database core.
In this article, we explored how the fundamentals of database design differ across PostgreSQL, Cassandra, and MongoDB. In upcoming articles, we will delve into advanced design concepts such as indexes, transactions, JOINs, TTL directives, and JSON documents.
We wish you a great rest of the weekend and invite you to , which will take place on May 14.
Forrás: habr.com
