

Bevezetés
 „Futni kell teljes erőből, hogy csak a helyén tartsuk magunkat,
míg ahhoz, hogy valahová eljussunk, legalább kétszer gyorsabban kell futnunk!”
(c) Alice Csodaországban
Néhány idővel ezelőtt megkértek, hogy tartsak előadást cégünk elemzőinek az adatmodellek tervezéséről, hiszen sokáig dolgozva a projekteken (néha akár évekig) elveszítjük a fonalat az IT-technológiai világban zajló eseményekről. Cégünknél (úgy alakult) sok projektben nem használnak NoSQL adatbázisokat (legalábbis egyelőre), ezért az előadásomban külön figyelmet szenteltem nekik, HBase példáján keresztül, és igyekeztem úgy bemutatni az anyagot, hogy azok is értsék, akik soha nem dolgoztak velük. Különösen az adatmodell tervezésének néhány aspektusát illusztráltam azzal a példával, amelyet néhány évvel ezelőtt olvastam Miközben különböző megoldási lehetőségeket hasonlítottam össze ugyanarra a feladatra, hogy a hallgatók jobban megértsék az alapvető ötleteket.
Nemrégiben, „mivel nem volt mit csinálni”, feltettem a kérdést (a hosszú májusi ünnepnapok a korlátozások közepette különösen kedvezőek ehhez), hogy mennyire felel meg a gyakorlatnak a elméleti megállapítások? Így született meg cikkem ötlete. Egy fejlesztő, aki már régóta dolgozik NoSQL-lal, valószínűleg nem fog új dolgot találni benne (ezért egyből át is ugorhatja a cikk felét). De az elemzőknek,akik még nem dolgoztak szorosan NoSQL-lal, úgy gondolom, hasznos lesz az HBase adatmodellek tervezésének jellemzőinek alapvető megértéséhez.
Példa elemzése
A véleményem szerint, mielőtt elkezdenénk a NoSQL adatbázisok használatát, alaposan meg kell fontolni az "előnyöket" és "hátrányokat". Gyakran a feladatot valószínűleg hagyományos relációs DBMS-ekkel is meg lehet oldani. Ezért jobb, ha nem használunk NoSQL-t, hacsak nincsenek erre ésszerű alapjaink. Ha azonban a NoSQL adatbázis használatáról döntés született, figyelembe kell venni, hogy itt a tervezési megközelítések némileg eltérnek. Különösen néhány közülük szokatlan lehet azok számára, akik eddig csak relációs DBMS-ekkel foglalkoztak (saját megfigyeléseim szerint). Tehát a "relációs" világban általában az alany területek modellezésével kezdünk, és csak utána végezzük el a modell denormalizálását, ha szükséges. A NoSQL-ban viszont azonnal figyelembe kell vennünk a várható adatkezelési forgatókönyveket és az adatokat kezdetben denormalizálni kell. Ezen kívül számos egyéb különbség is van, amelyeket később részletezünk.
Vizsgáljunk meg egy "szintetikus" feladatot, amelyen dolgozni fogunk:
Szükséges megtervezni egy absztrakt közösségi hálózat felhasználóinak barátlistájának tárolási struktúráját. Az egyszerűség kedvéért feltételezzük, hogy minden kapcsolat irányított (mint az Instagramon, és nem a LinkedIn-en). A struktúrának hatékonyan kell lehetővé tennie:
- Válaszolni arra a kérdésre, hogy A felhasználó olvassa-e B felhasználót (olvasási minta)
- Lehetővé tenni a kapcsolatok hozzáadását/eltávolítását, amennyiben A felhasználó feliratkozik/e lesz B felhasználóra (adatmódosítási minta)
Természetesen számos megoldási lehetőség kínálkozik. Egy szokásos relációs adatbázisban valószínűleg egyszerűen készítenénk egy kapcsolattáblát (esetleg típussal ellátva, ha például felhasználói csoportot kell tárolni: család, munka stb., amelybe az adott "barát" tartozik), és a hozzáférés sebességének optimalizálásához indexeket/particionálást adnánk hozzá. Valószínűleg a végső táblázat körülbelül így nézne ki:
user_id
friend_id
Vasila
Petya
Vasila
Olga
itt és később a jobb érthetőség érdekében ID helyett neveket fogok megadni
HBase esetében tudjuk, hogy:
- hatékony keresés, amely nem vezet teljes táblazárásra, lehetséges csak a kulcs alapján
- Ezért az is egy elég rossz ötlet, hogy a sokak által ismert SQL lekérdezéseket alkalmazzunk az ilyen típusú adatbázisokhoz; technikailag persze, ugyanúgy küldhet SQL lekérdezéseket Joinokkal és egyéb logikával az HBase-ből az Impalából, de mennyire lesz ez hatékony...
Ezért a felhasználó azonosítóját kénytelenek vagyunk kulcsként használni. Az első gondolat a barátok azonosítójának tárolásával kapcsolatban lehet, hogy a teljesítmény érdekében oszlopokban tároljuk őket. Ez a legnyilvánvalóbb és "naiv" megoldás körülbelül így nézne ki (nevezhetjük 1. lehetőség (default), hogy a későbbiekben hivatkozhassunk rájuk):
RowKey
Oszlopok
Vasila
1: Petya
2: Olya
3: Dasha
Petya
1: Masha
2: Vasya
Itt minden sor egy felhasználónak felel meg a hálózatban. Az oszlopok nevei: 1, 2, … — a barátok számával arányosan, és az oszlopokban a barátok azonosítói találhatók. Fontos megjegyezni, hogy minden sorban különböző számú oszlop lehet. A fentebbi példa alapján az egyik sor három oszloppal rendelkezik (1, 2 és 3), míg a másiknak csak kettője van (1 és 2) – itt a HBase két olyan jellemzőjét használjuk, amely a relációs adatbázisoknál nem áll rendelkezésre:
- az oszlopok dinamikus megváltoztatásának lehetősége (barát hozzáadása -> oszlop hozzáadása, barát törlése -> oszlop törlése)
- az eltérő sorok eltérő oszlopösszetételűek lehetnek.
Ellenőrizzük a struktúránkat az elvárásoknak való megfelelés szempontjából:
- Adatolvasás: ahhoz, hogy megértsük, hogy Vasya feliratkozott-e Olyára, ki kell olvasnunk az egész sort a RowKey = „Vasya” kulcs alapján, és végig kell néznünk a mezők értékeit, amíg találkozunk Olyával. Vagy átnézhetjük az összes oszlop értékét, ha „nem találkozhatunk” Olyával, és False választ adhatunk;
- Adatmódosítás: barát hozzáadása: ehhez a feladathoz is szükségünk van arra, hogy kiolvassuk az egész sort a RowKey = „Vasya” kulcs alapján, hogy meghatározzuk a barátai összesített számát. Ezt a barátok teljes számát arra használjuk, hogy meghatározzuk, melyik oszlopba kell beírni az új barát azonosítóját.
- Adatmódosítás: barát eltávolítása:
- Ki kell olvasnunk az egész sort a RowKey = „Vasya” kulcs alapján, és végig kell néznünk az oszlopokat, hogy megtaláljuk azt, amelyikbe a törlendő barát lett beírva;
- Ezután a barát eltávolítása után el kell "tolnunk" az összes adatot egy oszloppal, hogy ne legyenek "rések" a számok között.
Most értékeljük, mennyire lesznek hatékonyak azok az algoritmusok, amelyeket a „feltételes alkalmazás” oldalán kell megvalósítanunk, felhasználva Jelöljük meg a hipotetikus közösségi hálózatunk méretét n-el. Ekkor egy felhasználónak a maximális barátainak száma (n-1) lehet. Ezt az (-1)-et a továbbiakban figyelmen kívül hagyhatjuk, mivel az O-jelölés keretein belül lényegtelen.
- Adatolvasás: minden sort ki kell olvasni, és maximálisan végig kell nézni az összes oszlopát. Tehát a költségek felső becslése körülbelül O(n) lesz.
- Adatmódosítás: barát hozzáadása: a barátok számának meghatározásához minden oszlopot végig kell nézni, majd új oszlopot kell beszúrni => O(n)
- Adatmódosítás: barát eltávolítása:
- Hasonlóan a beszúráshoz – maximálisan végig kell nézni az összes oszlopot => O(n)
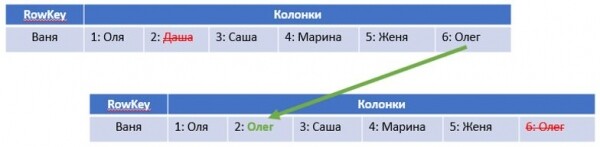
- Az oszlopok eltávolítása után „el kell tolni” őket. Ha ezt „rámenősen” valósítjuk meg, akkor maximálisan még (n-1) művelet szükséges. De itt és most a gyakorlati részben más megközelítést fogunk alkalmazni, amely „ál-elmozdítást” valósít meg rögzített számú művelet során – azaz ez állandó időt fog igényelni, függetlenül n-től. Ez az állandó idő (ha pontosak akarunk lenni, O(2)) O(n)-el összehasonlítva elhanyagolható. A megközelítést az alábbi ábra szemlélteti: egyszerűen átmásoljuk az adatokat az utolsó oszlopból abba, ahonnan el kell távolítanunk az adatokat, majd eltávolítjuk az utolsó oszlopot:

Összességében minden forgatókönyvben az aszimptotikus számítási összetettséget O(n)-nek kaptuk.
Valószínűleg már észrevetted, hogy szinte mindig az egész sort ki kell olvasnunk az adatbázisból, ráadásul a három esetből kettő csak azért, hogy végig nézzük az összes oszlopot és megszámoljuk a barátok összesített számát. Ezért egy optimalizálási kísérletként hozzáadhatunk egy "count" oszlopot, amelyben minden felhasználó barátainak számát tároljuk. Ebben az esetben nem kell az egész sort kiolvasnunk a barátok összesített számának kiszámításához, elegendő csak egy "count" oszlopot elolvasnunk. A legfontosabb, hogy ne felejtsük el frissíteni a "count"-ot az adatok manipulálásakor. Így egy javított változatot kapunk. 2. változat (count):
RowKey
Oszlopok
Vasila
1: Petya
2: Olya
3: Dasha
count: 3
Petya
1: Masha
2: Vasya
count: 2
Az első változathoz képest:
- Adatolvasás: a "Olvas-e Vasya Olyát?" kérdésre a válasz megszerzéséhez nem változott semmi => O(n)
- Adatmódosítás: barát hozzáadása: Egyszerűsítettük az új barát hozzáadását, mivel most már nem kell végigolvassuk az egész sort és végigpróbálni az oszlopait, hanem csak a "count" oszlop értékét tudjuk megkapni, és így azonnal meghatározhatjuk az új barát beszúrásának oszlopát. Ez a számítási komplexitás csökkenéséhez vezet O(1)-re.
- Adatmódosítás: barát eltávolítása: Barát eltávolításakor ugyanezt az oszlopot is felhasználhatjuk, hogy csökkentsük a bemeneti/kimeneti műveletek számát az adatok egy cellával balra történő "elmozdításánál". De az oszlopok átnézésének szükségessége a törlendő oszlop keresésére továbbra is fennáll, tehát => O(n)
- Másrészt, most adatfrissítéskor minden alkalommal frissítenünk kell a "count" oszlopot is, de ez állandó időt vesz igénybe, amit az O-notáció keretein belül figyelmen kívül lehet hagyni.
Összességében a 2. lehetőség egy kicsit optimálisabbnak tűnik, de inkább "evolúció a forradalom helyett". A "forradalom" végrehajtásához szükségünk lesz 3. lehetőség (col).
Felejtsük el mindent: rendeljük hozzá a felhasználói azonosítót az oszlop nevéhez! Ami az oszlopban fel lesz jegyezve – számunkra már nem számít, legyen az az 1-es szám (tulajdonképpen, hasznos lehet például a "család/barátok/stb." csoport tárolása is). Ez a megközelítés meglepheti a felkészületlen "civil" számára, aki korábban nem tapasztalt NoSQL adatbázisokkal, de éppen ez teszi lehetővé, hogy a HBase potenciálját sokkal hatékonyabban kiaknázzuk ebben a feladatban:
RowKey
Oszlopok
Vasila
Petya: 1
Olya: 1
Dasha: 1
Petya
Masha: 1
Vasya: 1
Itt azonnal több előnyt is tapasztalunk. Hogy ezeket megértsük, elemezzük az új struktúrát és értékeljük a számítási komplexitást:
- Adatolvasás: Ahhoz, hogy válaszoljunk arra a kérdésre, hogy Vasya feliratkozott-e Olyára, elegendő elolvasni egy "Olya" oszlopot: ha van, akkor a válasz True, ha nincs – False => O(1)
- Adatmódosítás: barát hozzáadása: Barát hozzáadása: elegendő csak egy új "Barát azonosító" oszlopot hozzáadni => O(1)
- Adatmódosítás: barát eltávolítása: elegendő csak a "Barát azonosító" oszlop eltávolítása => O(1)
Ahogy látjuk, ennek a tárolási modelnek a jelentős előnye az, hogy valamennyi szükséges forgatókönyvben csak egyetlen oszloppal dolgozunk, elkerülve a teljes sor adatbázisból való kiolvasását és különösen az ezen sor összes oszlopának végigpróbálását. Itt meg is állhatnánk, de...
Tovább léphetünk a teljesítmény optimalizálásában, és csökkenthetjük az adatbázis-hívások során végzett bemeneti/kimeneti műveleteket. Mi lenne, ha a kapcsolat teljes információját közvetlenül a sor kulcsában tárolnánk? Vagyis egy összetett kulcsot hoznánk létre, mint például userID.friendID? Ebben az esetben akár a sor oszlopait sem kellene beolvasnunk.4. változat (sor)):
RowKey
Oszlopok
Vitya.Petyá
Petya: 1
Vitya.Olga
Olya: 1
Vitya.Dávid
Dasha: 1
Petyá.Mása
Masha: 1
Petyá.Vitya
Vasya: 1
Nyilvánvaló, hogy az ilyen struktúrájú adatok manipulálásának összes forgatókönyvének értékelése is O(1) lesz, csakúgy, mint az előző változatban. A különbség a 3. változathoz képest kizárólag a bemeneti/kimeneti műveletek hatékonyságában rejlik az adatbázisban.
És most az utolsó „szalag”. Könnyen észrevehető, hogy a 4. változatban a sor kulcsának változó hosszúsága lesz, ami esetleg befolyásolhatja a teljesítményt (itt emlékezzünk arra, hogy az HBase byte készletként tárolja az adatokat, és a táblákban a sorok kulcs szerint vannak rendezve). Plusz van egy elválasztónk, amelyet bizonyos forgatókönyvekben feldolgozni kellhet. Az ilyen hatást elkerülendő használhatunk userID és friendID hash-okat, és mivel mindkét hash állandó hosszúságú lesz, egyszerűen össze lehet őket fűzni elválasztó nélkül. Akkor az adatok a táblában így fognak kinézni (5. változat (hash)):
RowKey
Oszlopok
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petya: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olya: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasya: 1
Nyilvánvaló, hogy a vizsgált forgatókönyvek alapján egy ilyen struktúrával dolgozó algoritmus komplexitása azonos lesz a 4. változathoz képest – tehát O(1).
Összegzésképpen, az összes számítási összetettségünket egy táblázatba foglalva:
Barát hozzáadása
Barát ellenőrzése
Barát eltávolítása
1. lehetőség (default)
O(n)
O(n)
O(n)
2. változat (count)
O(1)
O(n)
O(n)
3. változat (column)
O(1)
O(1)
O(1)
4. változat (row)
O(1)
O(1)
O(1)
5. változat (hash)
O(1)
O(1)
O(1)
Ahogy látható, a 3-5. lehetőségek tűnnek a legjobbnak, és elméletileg biztosítják az összes szükséges adatmanipulációs forgatókönyv végrehajtását állandó idő alatt. A feladatunk feltételei között nincs kifejezett követelmény, hogy megszerezzük a felhasználó összes barátjának listáját, de a valós projekti tevékenységek során, mint jó elemzők, célszerű lenne „előrelátni”, hogy egy ilyen feladat felmerülhet, és „takarékoskodni” érte. Ezért a 3. lehetőség felé húzok. Ugyanakkor valószínű, hogy egy valós projektben ezt a kérdést már más eszközökkel megoldották, ezért a teljes feladat ismerete nélkül jobb, ha nem vonunk le végső következtetéseket.
Kísérlet előkészítése
A fentebb említett elméleti megfontolásokat szeretnénk a gyakorlatban is kipróbálni – ez volt annak a hosszú hétvégének a célja, amelyen gondolkodtunk. Ehhez szükséges felmérni az „elméleti alkalmazásunk” teljesítményét az összes leírt használati forgatókönyvben, valamint az idő növekedését a közösségi hálózat méretének növekedésével (n). A célparaméter, amely minket érdekel, és amelyet az experimentum során meg fogunk mérni, az az idő, amelyet az „elméleti alkalmazás” egy „üzleti művelet” végrehajtására fordít. Az „üzleti művelet” alatt az alábbiak egyikét értjük:
- Egy új barát hozzáadása
- Ellenőrizni, hogy A felhasználó barátja-e B felhasználónak
- Egy barát eltávolítása
Így, figyelembe véve az eredeti követelményekben megfogalmazottakat, a befogadási forgatókönyv a következőképpen alakul:
- Adatok rögzítése. Generáljunk véletlenszerűen egy n méretű kiindulási hálózatot. A „valós világ” jobb megközelítése érdekében minden felhasználónak véletlenszerű mennyiségű barátja van. Mérjük meg azt az időt, ameddig az „elméleti alkalmazásunk” rögzíti az összes generált adatot az HBase-ben. Ezután az így kapott időt oszd el az összes hozzáadott barát számával – így megkapjuk az átlagos időt egy „üzleti műveletre”.
- Adatolvasás. Minden felhasználó számára készítsen egy listát azokról a "személyekről", akiknek a követésére választ kell kapnia, hogy követi-e őket a felhasználó vagy sem. A lista hossza = körülbelül a felhasználó barátainak száma, amelyből a vizsgált barátok fele esetében a válasznak "Igen"-nek, a másik felénél pedig "Nem"-nek kell lennie. A vizsgálat során a válaszok "Igen" és "Nem" váltakozzanak (tehát minden második esetben végig kell nézni minden oszlopot az 1-es és 2-es verziók esetén). A vizsgálat összidejét ezután ossza el a vizsgált barátok számával, hogy megkapja az átlagos időt egy téma ellenőrzésére.
- Adatok törlése. Törölje el a felhasználó összes barátját. A törlés sorrendje véletlenszerű (tehát "megkeverjük" az eredeti listát, amelyet az adatok rögzítésére használtunk). A vizsgálat összidejét ezután ossza el a törlendő barátok számával, hogy megkapja az átlagos időt egy ellenőrzésre.
A forgatókönyveket minden 5 adatmodell változat esetében és különböző társadalmi hálózatok méretéhez kell futtatni, hogy megnézzük, hogyan változik az idő a növekedésük során. Az egy adott n-kapcsolaton belül a hálózati kapcsolatok és a vizsgálandó felhasználók listája természetesen mind az 5 változatban azonos kell, hogy legyen.
A jobb megértés érdekében alább bemutatom a n=5-höz generált adatok példáját. Az írt "generátor" három szótárat ad vissza az ID-król:
- első – beszúrásra
- második – ellenőrzésre
- harmadik – törlésre
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # összesen 15 barát

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # összesen 18 ellenőrzendő alany

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # összesen 15 barát
Mint látható, minden 10 000-nél nagyobb ID az ellenőrzés szótárában éppen azok, amelyek biztosan hamis választ adnak. A "barátok" beszúrása, ellenőrzése és törlése a szótárban megadott sorrendben történik.
A kísérlet egy Windows 10 rendszert futtató laptopon zajlott, ahol az egyik Docker-konténerben egy HBase adatbázis, a másikban pedig Python a Jupyter Notebookkal futott. A Docker számára 2 CPU magot és 2 GB RAM-ot biztosítottak. Az egész logika, valamint a "feltételezett alkalmazás" működésének emulálása, a tesztadatok generálásához és az időméréshez írt "keret" Pythonban készült. Az HBase-hez való kapcsolathoz a , a hash (MD5) calculation for variant 5 — hashlib
Figyelembe véve a konkrét laptop számítási teljesítményét, kísérletileg a n = 10, 30, …. 170 indítást választottuk – amikor a teljes tesztciklus (minden forgatókönyv minden variánsa minden n-re) teljesítési ideje még többé-kevésbé ésszerűen belefért egy teázás időtartamába (átlagosan 15 perc).
Itt fontos megjegyezni, hogy ebben a kísérletben elsősorban nem az abszolút teljesítményadatokat értékeljük. Még a két különböző változat relatív összehasonlítása sem biztos, hogy teljesen pontos. Jelenleg az n függvényében változó idő jellemzője érdekel bennünket, mivel a fent említett 'tesztkörnyezet' konfigurációja mellett nagyon nehéz 'tisztán' időbecsléseket kapni, amelyek mentesek a véletlen és egyéb tényezők hatásától (ráadásul ilyen célkitűzés sem volt).
A kísérlet eredménye
Az első teszt – hogyan változik a barátok listájának kitöltéséhez szükséges idő. Eredmény – az alábbi grafikonon.
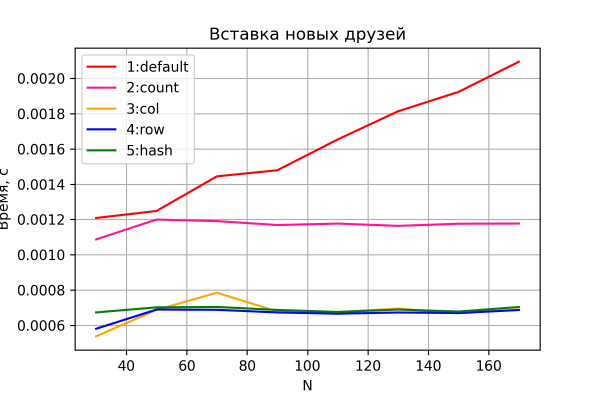
A 3-5. variánsok várhatóan szinte állandó 'üzleti műveleti' időt mutatnak, amely nem függ a hálózat méretének növekedésétől, és a teljesítményben szinte észlelhetetlen különbséget mutat.
A 2. variáns szintén állandó, de kissé gyengébb teljesítményt mutat, gyakorlatilag pontosan 2-szer annyit, mint a 3-5. variánsok. Ez nem lehet egy elég jó hír, mert összhangban van a teóriával – ebben a variánsban az HBase-ből a be- és kimenetek száma éppen 2-szer annyi. Ez közvetett bizonyítékul szolgálhat arra, hogy a tesztkörnyezetünk alapvetően jó pontosságot ad.
Az 1. variáns várhatóan a leglassabb, és a hálózat méretével arányosan növekvő időt mutat a barátok hozzáadására.
Most nézzük meg a második teszt eredményeit.
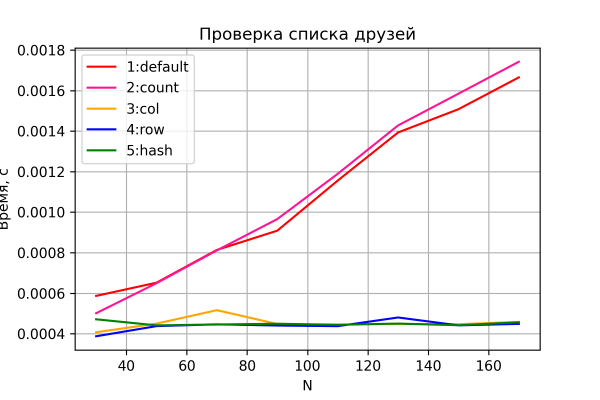
A 3-5 változatok ismét várt módon viselkednek – az idő konstans, függetlenül a hálózat méretétől. Az 1-es és 2-es változatok lineáris növekedést mutatnak az időben a hálózat méretének növekedésével, hasonló teljesítménnyel. Érdekes módon a 2-es változat egy kicsit lassabbnak bizonyul – valószínűleg a 'count' további oszlop kiolvasása és feldolgozása miatt, ami a n növekedésével egyre észlelhetőbbé válik. Azonban tartózkodom bármilyen következtetést levonni, mivel a pontos összehasonlítási eredmény viszonylag alacsony. Ezen kívül az arányok (melyik változat, 1 vagy 2, gyorsabb) futásról futásra eltértek (miközben a függőség jellege 'nyak-nyakban' megmaradt).
És az utolsó grafikon – a törlés tesztelésének eredménye.
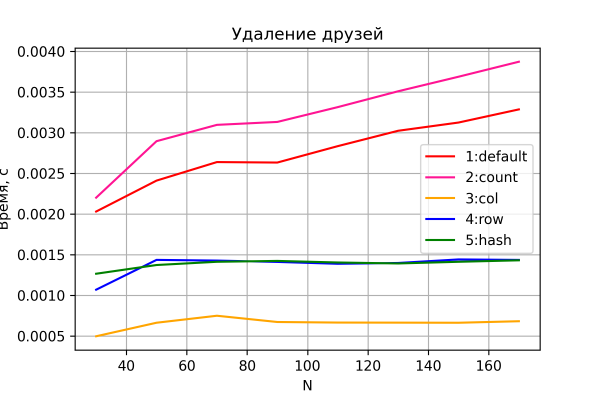
Itt ismét, meglepetések nélkül. A 3-5 változatok konstans idő alatt hajtják végre a törlést.
Ami érdekes, hogy a 4-es és 5-ös változatok, eltérően az előző forgatókönyvektől, észrevehetően rosszabb teljesítményt mutatnak, mint a 3-as változat. Valószínűleg a sortörlés művelete költségesebb, mint az oszloptörlés, ami összességében logikus.
Az 1-es és 2-es változatok, ahogy várható volt, lineáris növekedést mutatnak az időben. Ezen kívül a 2-es változat folyamatosan lassabb az 1-es verziónál – a 'count' oszloptartás miatt végrehajtott további I/O művelet következtében.
A kísérlet általános következtetései:
- A 3-5 változatok nagyobb hatékonyságot mutatnak, mivel kihasználják az HBase előnyeit; teljesítményük pedig eltér egymástól egy konstans értékben és független a hálózat méretétől.
- A 4-es és 5-ös változatok közötti különbség nem volt észlelhető. De ez nem jelenti azt, hogy az 5-ös változat ne lenne hasznos. Lehetséges, hogy a kísérlet forgatókönyve figyelembe véve a tesztelő állomás teljesítményadatait nem tette lehetővé ennek az észlelését.
- Az adatokkal végzett 'üzleti műveletek' végrehajtásához szükséges idő növekedésének jellege összességében megerősítette a korábban kapott elméleti megállapításokat minden változat esetében.
Epilógus
A durva kísérletek nem tekinthetők abszolút igazságnak. Számos olyan tényező van, amelyet nem vettek figyelembe, és amelyek torzították az eredményeket (különösen jól láthatók ezek a fluktuációk a grafikonokon, ha a hálózat mérete kicsi). Például a thrift működésének sebessége, amelyet a happybase használ, a logika megvalósításának volumene és módja, amelyet Pythonban írtam (nem állítom, hogy a kód optimálisan lett megírva és hatékonyan kihasználta az összes komponens lehetőségeit), valamint az HBase gyorsítótárazási sajátosságai, a Windows 10 háttértevékenysége a laptopomon stb. Összességében elmondható, hogy az összes elméleti megállapítás kísérletesen bizonyította érvényességét. Vagy legalábbis cáfolni őket egy ilyen „telitalálattal” nem sikerült.
Összegzésül — ajánlások mindenkinek, aki most kezd adatmodellek tervezésébe HBase-ban: vonja le a tapasztalatait relációs adatbázisokkal kapcsolatban, és tartsa észben a „parancsolatokat”:
- A tervezés során a feladattól és az adatok manipulációs mintáitól haladunk, nem pedig a tárgyi terület modelljétől.
- Hatékony hozzáférés (full table scan nélkül) – csak kulcs alapján.
- Denumeralizáció.
- Különböző sorok különböző oszlopokat tartalmazhatnak.
- Dinamikus oszlopszerkezet.
Forrás: habr.com
