

A Linuxban számos eszköz érhető el a kernel és alkalmazások hibakeresésére. A legtöbbjük negatívan befolyásolja az alkalmazások teljesítményét, és nem használható termelési környezetben.
Két évvel ezelőtt készült — eBPF. Lehetővé teszi a kernel és felhasználói alkalmazások nyomkövetését alacsony overhead mellett, anélkül, hogy programokat újra kellene fordítani, vagy külső modulokat kellene betölteni a kernelbe.
Jelenleg már számos alkalmazás létezik, ami eBPF-et használ, és ebben a cikkben megvizsgáljuk, hogyan írhatunk saját profilozó eszközt a alapján. A cikk valós eseményeken alapul. Végigmegyünk a problémák megjelenésétől a megoldásukig, hogy bemutathassuk, hogyan használhatók a már meglévő eszközök konkrét helyzetekben.
A Ceph lassú
Új hostot adtunk hozzá a Ceph klaszterhez. Miután áttelepítettük az adatok egy részét rá, észrevettük, hogy az írási kérések feldolgozási sebessége jelentősen alacsonyabb, mint más szervereken.
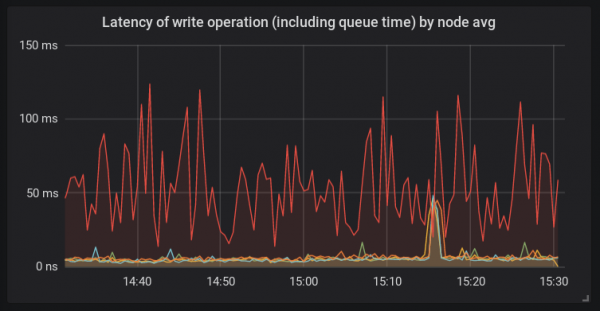
A többi platformtól eltérően ezen a hoszton bcache és az új 4.15-ös Linux kernel futott. Ilyen konfigurációval most használtuk először ezt a hostot. Abban a pillanatban világos volt, hogy a problémák gyökere elvben bármi lehetett.
A host vizsgálata
Kezdjük azzal, hogy megnézzük, mi történik a ceph-osd folyamat belsejében. Ehhez használjuk a és (többet olvashat erről ):
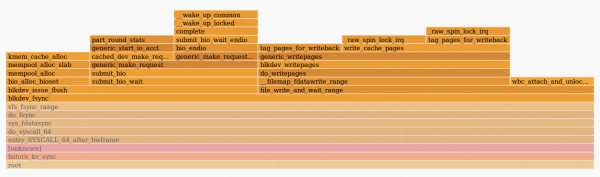
A kép azt mutatja, hogy a fdatasync() függvény sok időt töltött el a kérés elküldése közben a generic_make_request()függvényben. Ez azt jelenti, hogy valószínűleg a problémák forrása a démon osd-n kívül van. Ez lehet akár a kernel, akár a lemezek. Az iostat kimenet magas késleltetést mutatott a bcache lemezek kérelmeinek kezelésében.
A host ellenőrzése közben felfedeztük, hogy a systemd-udevd démon jelentős CPU időt fogyaszt — körülbelül 20%-ot több magon. Ez furcsa viselkedés, így meg kell vizsgálnunk az okát. Mivel a Systemd-udevd ueventekkel dolgozik, úgy döntöttünk, hogy megnézzük őket a udevadm monitorsegítségével. Kiderült, hogy rengeteg change esemény generálódik minden blokkkészülék számára a rendszeren. Ez elég szokatlan, ezért meg kell nézni, mi generálja ezeket az eseményeket.
A BCC Eszközkészlet használata
Ahogy már megállapítottuk, a kernel (és a ceph démon a rendszerhívás során) sok időt tölt el a generic_make_request(). Próbáljuk meg mérni ennek a függvénynek a sebességét. A már tartalmaz egy nagyszerű eszközt — funclatency. A PID alapján 1 másodpercenként követjük a démon kimenetét, és az eredményeket milliszekundumban jelenítjük meg.
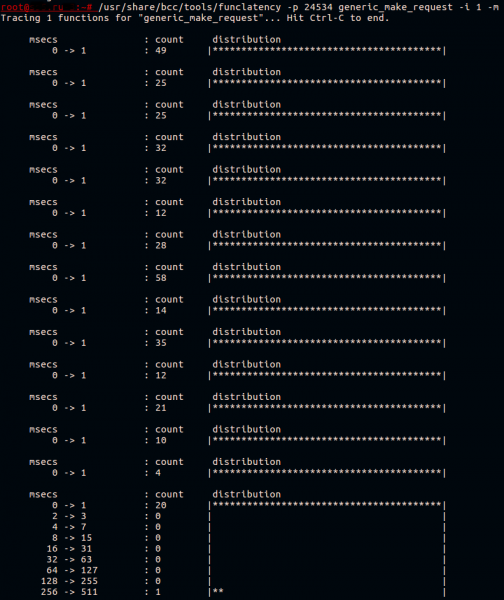
Általában ez a funkció gyorsan működik. Csak annyit tesz, hogy átadja a kérést az eszközmeghajtó sorának.
Bcache — ez egy összetett eszköz, amely valójában három lemezből áll:
- háttér eszköz (cache-elhető lemez), ebben az esetben ez egy lassú HDD;
- cache-elő eszköz (cache-elő lemez), itt ez egy NVMe eszköz partíció;
- a bcache virtuális eszköz, amellyel az alkalmazás dolgozik.
Tudjuk, hogy a kérés átvitele késlekedik, de melyik eszköz esetében? Ezzel később foglalkozunk.
Jelenleg tudjuk, hogy az uevent-ek valószínűleg problémákat okoznak. Nehéz meghatározni, mi pontosan okozza a generálásukat. Tegyük fel, hogy ez valamilyen szoftver, amelyet időnként futtatnak. Nézzük meg, milyen szoftver indul a rendszerben a execsnoop segítségével az ugyanabból Futtassuk és irányítsuk a kimenetet egy fájlba.
Például így:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nem fogjuk itt felsorolni az execsnoop teljes kimenetét, de egy érdekes sor így nézett ki:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
A harmadik oszlop a PPID (szülő PID) folyamata. Az 5802 PID-del rendelkező folyamat a mi monitorozó rendszerünk egyik szála volt. A monitorozó rendszer konfigurációjának ellenőrzése során hibásan beállított paramétereket találtunk. Az HBA-adapter hőmérsékletét 30 másodpercenként mérték, ami sokkal gyakrabban történt, mint ami szükséges. Miután meghosszabbítottuk a ellenőrzési intervallumot, észrevettük, hogy a kérések feldolgozási késlekedése ezen a hoszton már nem kiemelkedő a többi hoszthoz képest.
De még mindig nem világos, miért akadozott a bcache-eszköz. Készítettünk egy tesztplatformot azonos konfigurációval, és próbáltuk reprodukálni a problémát azzal, hogy fio-t futtattunk a bcache-en, időszakosan futtatva az udevadm trigger-t a ueventek generálására.
BCC Alapú Eszközök Írása
Próbáljunk írni egy egyszerű segédprogramot a lassú hívások nyomon követésére és megjelenítésére. generic_make_request()Az is érdekel minket, hogy melyik lemez esetében hívták meg ezt a funkciót.
A terv egyszerű:
- Regisztráljuk kprobe Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata generic_make_request():
- Megőrizzük a lemez nevét, amely az argumentumon keresztül elérhető;
- Megőrizzük az időbélyeget.
- Regisztráljuk kretprobe visszatéréskor generic_make_request():
- Megszerezzük a aktuális időbélyeget;
- Megkeressük a megőrzött időbélyeget és összehasonlítjuk a jelenlegivel;
- Ha az eredmény nagyobb, mint a megadott, akkor megtaláljuk a mentett lemez nevét és kiírjuk a terminálra.
Kprobes és kretprobes stopponozási mechanizmust használnak a funkciók kódjának futás közbeni módosítására. Olvashatsz és cikket erről a témáról. Ha megnézzük különböző eszközök kódját a , akkor észrevehetjük, hogy az azonos struktúrával rendelkezik. Így ebben a cikkben kihagyjuk a parancssori argumentumok elemzését, és áttérünk magára a BPF programra.
Az eBPF szöveg a python szkriptben a következőképpen néz ki:
bpf_text = """ # Itt lesz a bpf program kódja """
Az adatok funkciók közötti átvitelére az eBPF programok . Mi is így fogunk eljárni. Kulcsként a folyamat PID-ját fogjuk használni, értékként pedig a következő struktúrát határozzuk meg:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Itt regisztrálunk egy hash-táblát, amelynek neve p, a kulcs típusa u64 és az érték típusa struct data_t. A tábla elérhető lesz a BPF programunk kontextusában. A BPF_PERF_OUTPUT makró egy másik táblát regisztrál, amelynek neve events, és ezt az felhasználói térbe való átadására használják.
A funkció hívása és az ebből való visszatérés közötti késleltetések mérésénél, vagy különböző funkciók hívásai között figyelembe kell venni, hogy a kapott adatoknak egy kontextushoz kell tartozniuk. Más szavakkal, emlékeznünk kell a funkciók párhuzamos végrehajtásának lehetőségére. Van lehetőségünk mérni a késleltetést egy funkció hívása és az abból való visszatérés között egy folyamat kontextusában, és egy másik folyamat kontextusában, de ez valószínűleg haszontalan. Egy jó példa erre a , ahol a hash-tábla kulcsa egy mutató a struct request, amely egy lemezre irányuló kérést tükröz.
Ezután meg kell írni a kódot, amely a vizsgált funkció hívásakor fut:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Itt a második argumentum a hívott funkció első argumentumaként lesz beállítva . Ezt követően megkapjuk a folyamat PID-ját, amelynek kontextusában dolgozunk, és a jelenlegi időbélyeget nanomásodpercekben. Mindezt eltároljuk az újonnan allokált struct data_t dataA lemez nevét a struktúrából nyerjük ki bio, amelyet a híváskor adunk át generic_make_request(), és ugyanabba a struktúrába mentjük el data. Az utolsó lépésként bejegyzést adunk hozzá a korábban említett hash-táblához.
A következő funkció akkor kerül meghívásra, amikor visszatérünk generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Ez a funkció hasonló az előzőhöz: kinyerjük a folyamat PID-jét és az időbélyeget, de nem foglalunk memóriát új struktúrához. Ehelyett a hash-táblában keresünk egy létező struktúrát az aktuális PID szerint. Ha megtaláljuk a struktúrát, akkor megtudjuk a futó folyamat nevét, és hozzáadjuk azt.
A bináris eltolás, amelyet itt használunk, arra szolgál, hogy megkapjuk a szál GID-jét, azaz a fő folyamat PID-jét, amely indította a szálat, amelyen dolgozunk. A hívott funkció egy 64 bites értékben adja meg a szál GID-jét és PID-jét.
A terminál kimeneti szempontjából jelenleg nem érdekel minket a szál, de a fő folyamat érdekel. Miután összehasonlítottuk a megkapott késleltetést a megadott küszöbértékkel, átadjuk a struktúránkat data a felhasználói térnek a táblán keresztül events, majd eltávolítjuk a bejegyzést a p.
A python szkriptben, amely ezt a kódot betölti, szükségünk van a MIN_US és FACTOR helyettesítésére a késleltetési küszöbökkel és az időegységekkel, amelyeket az argumentumokkal adunk át:
bpf_text = bpf_text.replace('MIN_US', str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR', 'data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR', '')
	label = "usec"
Most fel kell készülnünk a BPF programra a és regisztrálnunk kell a mintákat:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request", fn_name="start")
b.attach_kretprobe(event="generic_make_request", fn_name="stop")
Azt is meg kell határoznunk struct data_t a szkriptünkben, különben semmit sem tudunk olvasni:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk", ct.c_char * DISK_NAME_LEN)]
Az utolsó lépés a adatok terminálra való kiírása:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
A script elérhető a . Próbáljuk ki a tesztplatformon, ahol a fio fut, írva a bcache-re, és hívjuk meg az udevadm monitor-t:
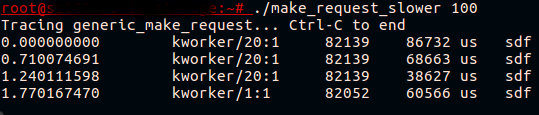
Végre! Most már látjuk, hogy ami a bcache eszköz lassulásának tűnt, valójában egy lassító hívás generic_make_request() a gyorsítótárazott lemezhez.
Fedezd fel a kernel működését
Mi lassítja a kérés átvitelét? A késleltetés még a kérés számontartásának megkezdése előtt jelentkezik, tehát a konkrét kérés nyilvántartása a statisztika további megjelenítése érdekében ( /proc/diskstats vagy iostat) még nem kezdődött el. Ezt könnyen ellenőrizhetjük, ha az iostat-ot futtatjuk a probléma reprodukálása közben, vagy , amely a kérési számontartás kezdetére és végére alapoz. Ezen eszközök egyike sem mutat problémát a gyorsítótárazott lemezhez intézett kérésekre.
Ha megnézzük a funkciót generic_make_request(), akkor látni fogjuk, hogy a kérés számontartásának megkezdése előtt még két funkciót hívnak meg. Az első: generic_make_request_checks(), amely ellenőrzi a kérés legitimitását a lemez beállításai alapján. A második: , amelyben egy érdekes hívás található: :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Ebben a kernél várakozik a sor felolvasztására. Mérjük a késleltetést blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Funkciók nyomozása az "blk_queue_enter"-hez... Nyomj Ctrl-C-t a leállításhoz.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Úgy tűnik, közel járunk a megoldáshoz. A "lefagyás/feloldás" sorokhoz használt funkciók: és . Ezeket akkor használják, amikor a kérés kezelési beállításait módosítani kell, amelyek potenciálisan kockázatosak a sorban lévő kérések számára. A hívásakor blk_mq_freeze_queue() a funkcióval a számláló növekszik: q->mq_freeze_depth. Ezután a kernel megvárja a sor kiürülését a .
A sor kiürülésének várakozási ideje megegyezik a lemezdelayel, mivel a kernel várja az összes sorba állított művelet befejezését. Amint a sor kiürül, alkalmazzák a beállítási változtatásokat. Ezután hívják meg a , amely csökkenti a freeze_depth.
Most már elegendő információnk van ahhoz, hogy megoldjuk a helyzetet. Az udevadm trigger paranccsal a beállítások alkalmazására kerül sor a blokk eszközök számára. Ezek a beállítások az udev szabályokban vannak leírva. Megkereshetjük, hogy mely beállítások "fagyasztják" a sort, megpróbálva módosítani azokat a sysfs-en, vagy a kernel forráskódjának megnézésével. Továbbá megpróbálhatjuk a BCC , amely a terminálra kiírja a kernel és felhasználói tér veremnyomait minden egyes híváshoz blk_freeze_queue, például:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Az udev szabályok viszonylag ritkán változnak, és ez általában ellenőrzött módon történik. Tehát láthatjuk, hogy még a már beállított értékek alkalmazása is késleltetést okoz a kérés átadása és a lemez között. Természetesen nem túl jó gyakorlat udev eseményeket generálni, amikor nincs változás a lemez konfigurációjában (például ha az eszköz nem csatlakozik/leválik). Ennek ellenére segíthetünk a kernelt abban, hogy ne végezzen felesleges munkát, és ne "fagyassza" meg a kérés sorát, ha erre nincs szükség. javítják a helyzetet.
Következtetés
Az eBPF egy rendkívül rugalmas és erős eszköz. A cikkben bemutattunk egy gyakorlati esetet és megmutattuk, hogy mi minden lehetséges. Ha érdeklik a BCC eszközök fejlesztése, érdemes megnézni az , amely jól leírja az alapokat.
Más érdekes hibakereső és profilozó eszköz is létezik, amelyek eBPF-re épülnek. Az egyik ilyen a , amely lehetővé teszi hatékony, egy soros parancsok és kis programok írását awk-szerű nyelven. A másik pedig a , amely lehetővé teszi a magas felbontású alacsony szintű metrikák gyűjtését egy prometheus szerverre, lehetővé téve későbbi szép vizualizációt és akár értesítéseket is.
Forrás: habr.com
