

A cikkben bemutatom, hogyan közelítettük meg a PostgreSQL redundanciájának kérdését, miért vált ez számunkra fontossá, és mi lett az eredménye.
Magas terhelésű szolgáltatásunk van: 2,5 millió felhasználó világszerte, napi 50K+ aktív felhasználó. A szerverek az Amazone-nál egy ír régióban találhatók: folyamatosan 100+ különböző szerver működik, ebből közel 50 adatbázisokkal.
Az egész backend egy nagy monolitikus, állapotmegőrző alkalmazás Java-ban, amely folyamatos websocket kapcsolatot tart fenn az ügyféllel. Amikor több felhasználó dolgozik egyszerre egy táblán, mindannyian valós időben látják a változásokat, mert minden változást rögzítünk az adatbázisban. Körülbelül 10K lekérdezésünk van másodpercenként az adatbázisainkra. Csúcsidőszakban a Redis-ben 80-100K lekérdezést írunk másodpercenként.
Miért váltottunk a Redis-ról PostgreSQL-ra
Kezdetben szolgáltatásunk Redis-szal működött, egy key-value tárolóval, amely minden adatot a RAM-ban tárol. a szerver.
A Redis előnyei:
- Magas válaszsebesség, mivel minden az memóriában tárolódik;
- Könnyű mentés és replikáció.
A Redis hátrányai számunkra:
- Nincsenek valódi tranzakciók. Próbáltuk ezeket az alkalmazásunk szintjén imitálni. Sajnos ez nem mindig működött jól, és rendkívül bonyolult kód írását igényelte.
- Az adatok mennyiségét a memória mennyisége korlátozza. Az adatok növekedésével a memória is növekedni fog, és végül beleütközünk a választott példány jellemzőibe, ami az AWS-nél megköveteli a szolgáltatásunk leállítását az példány típusa változtatása érdekében.
- Folyamatosan fenntartani kell az alacsony késleltetést, mert nagyon sok lekérdezésünk van. Az optimális késleltetési szintünk 17-20 ms. 30-40 ms késleltetési szinten hosszú válaszokat kapunk az alkalmazásunk lekérdezéseire, és a szolgáltatás degradációját tapasztaljuk. Sajnos ez 2018 szeptemberében történt, amikor az egyik Redis példány valamiért kétszer olyan késleltetést kapott, mint általában. A probléma megoldásához leállítottuk a szolgáltatást a munkanap közepén nem tervezett karbantartás céljából és kicseréltük a hibás Redis példányt.
- Könnyen előfordulhat az adatok konzisztenciájának elvesztése még kisebb kódhiba esetén is, és sok időt lehet eltölteni az adatok javítására készült kód írásával.
Figyelembe vettük a hátrányokat, és megértettük, hogy valami kényelmesebbre van szükségünk, normális tranzakciókkal és kisebb késleltetéssel. Kutatást végeztünk, elemeztünk számos lehetőséget, és a PostgreSQL-t választottuk.
Az új adatbázisra már másfél éve költözünk, és csak egy kis mennyiségű adatot vittünk át, ezért most párhuzamosan dolgozunk a Redis-szal és a PostgreSQL-vel. A költözés fázisairól és az adatok közötti váltásról az alábbi cikkben olvashat. a kollégám cikkében.
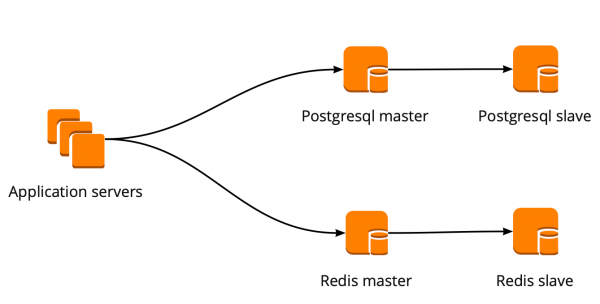
Amikor elkezdtük a költözést, az alkalmazásunk közvetlenül az adatbázissal dolgozott, a Redis és a PostgreSQL mesteréhez fordulva. A PostgreSQL klaszter egy mesterből és egy aszinkron replikából állt. Így nézett ki a munkafolyamat a bázisokkal:
PgBouncer bevezetése
Miközben költöztünk, a termék is fejlődött: nőtt a felhasználók száma és a PostgreSQL-t használó szerverek száma, ezért elfogytak a kapcsolatok. A PostgreSQL minden egyes kapcsolat esetén külön folyamatot hoz létre, és fogyasztja az erőforrásokat. A kapcsolatok számát egy bizonyos pontig lehet növelni, különben előfordulhat, hogy a BDB nem optimális módon működik. Ilyen helyzetben ideális lenne egy kapcsolattartó menedzsert választani, amely a bázis előtt áll.
Két lehetőségünk volt a kapcsolatkezelő számára: Pgpool és PgBouncer. Az első viszont nem támogatja az adatbázissal való tranzakciós módban való működést, ezért a PgBouncer-t választottuk.
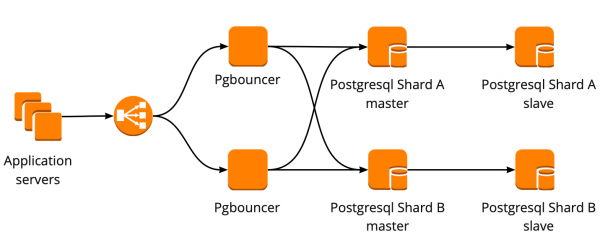
A következő munkasémát állítottuk be: az alkalmazásunk egy PgBouncerhez fordul, amely mögött a PostgreSQL mesterei állnak, és minden mester mögött egy aszinkron replikával rendelkező replikát találunk.
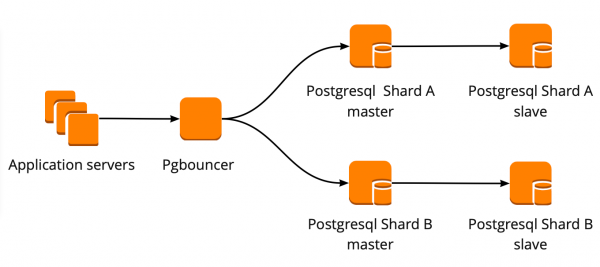
Ezen kívül nem tudtuk az összes adat mennyiségét a PostgreSQL-ben tárolni, és fontos volt számunkra az adatbázis sebessége, ezért elkezdtük a PostgreSQL sharding-elését az alkalmazási szinten. A fent leírt séma viszonylag kényelmes ehhez: új shard hozzáadásakor elegendő a PgBouncer konfigurációjának frissítése, és az alkalmazás azonnal képes lesz dolgozni az új sharddal.
PgBouncer hibatűrés
Ez a rendszer addig működött, amíg az egyetlen PgBouncer példány le nem állt. Az AWS-en vagyunk, ahol minden példány olyan hardveren fut, ami időnként leáll. Ilyen esetekben a példány egyszerűen átköltözik egy új hardverre, és ismét működik. Így történt a PgBouncer-rel is, azonban az elérhetetlenné vált. Ennek a leállásnak az eredményeként szolgáltatásunk 25 percig nem volt elérhető. Az AWS ilyen helyzetekre azt javasolja, hogy használjunk redundanciát a felhasználói oldalon, ami akkoriban nálunk nem volt megvalósítva.
Ezt követően komolyan elgondolkodtunk a PgBouncer és a PostgreSQL klaszterek hibakezelési lehetőségein, mert hasonló szituáció bármelyik példánnyal megismétlődhetett volna az AWS fiókunkban.
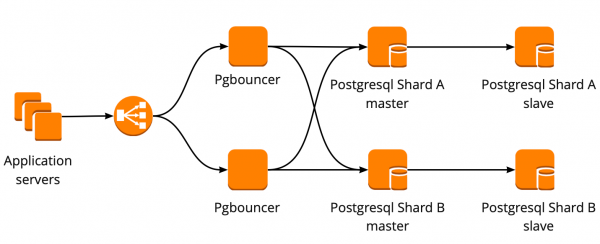
A PgBouncer hibakezelési struktúráját a következőképpen építettük fel: minden alkalmazásszerver a Network Load Balancer-hez fordul, amely mögött két PgBouncer áll. Mindkét PgBouncer ugyanazokat a master PostgreSQL adatbázisokat figyeli, minden shard esetén. Ha megismétlődik az AWS példány leállásának helyzete, az összes forgalom átirányításra kerül a másik PgBouncer-hez. A Network Load Balancer hibakezelését az AWS biztosítja.
Ez a rendszer lehetővé teszi új PgBouncer szerverek problémamentes hozzáadását.
Hibakezelő klaszter létrehozása PostgreSQL alatt
Ennek a problémának a megoldásakor különböző lehetőségeket vizsgáltunk: házilag írt failover, repmgr, AWS RDS, Patroni.
Saját írású szkriptek
Ezek képesek figyelni a master működését, és ha az leáll, a replikát masterré léptetik elő és frissítik a PgBouncer konfigurációt.
Ennek a megközelítésnek az előnye a maximális egyszerűség, mert saját magunk írunk scriptet, és pontosan értjük, hogyan működnek.
Hátrányok:
- Lehetséges, hogy a master nem is állt le, hanem hálózati hiba történt. A failover, nem tudva erről, előlépteti a replikát masterré, míg a régi master tovább működik. Ennek következtében két master szerverünk lesz, és nem tudjuk, melyiken vannak a legfrissebb adatok. Ezt a helyzetet split-brain helyzetnek hívják.
- Replika nélkül maradtunk. A mi konfigurációnkban van egy master és egy replika; a váltás után a replika előlép a masterré, és többé nincs replikánk, ezért manuálisan kell új replikát hozzáadnunk.
- További monitoring szükséges a failover működéséhez, miközben 12 PostgreSQL shardunk van, ami azt jelenti, hogy 12 klasztert kell figyelnünk. A shardok számának növelésénél ne felejtsük el frissíteni a failover-t.
A saját fejlesztésű failover nagyon bonyolultnak tűnik, és nem trivialis támogatást igényel. Egy PostgreSQL klaszter esetén ez a legegyszerűbb megoldás, de nem skálázható, így nem alkalmas számunkra.
Repmgr
Replication Manager PostgreSQL klaszterekhez, amely képes kezelni a PostgreSQL klaszter működését. Viszont nincs automatikus failover „dobozból”, ezért szükség van egy saját „wrapper” írására a kész megoldás fölé. Így lehet, hogy még bonyolultabbá válik, mint a saját szkriptek esetében, ezért a Repmgrt nem is próbáltuk ki.
AWS RDS
Támogat mindent, amire szükségünk van, képes biztonsági mentéseket készíteni, és kezeli a kapcsolati medencét. Van automatikus átváltás: ha a mester leáll, a replikáció új mesterként lép fel, és az AWS frissíti a DNS bejegyzést az új mesterre, miközben a replikák különböző AZ-okban lehetnek.
A hátrányok közé tartozik a finom beállítások hiánya. Például a finom beállítások közé tartozik: a mi példányainkon korlátozások vannak a tcp kapcsolatokra, amit sajnos nem lehet megtenni az RDS-ben:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Ezenkívül az AWS RDS ára majdnem kétszerese a szokásos példányárnak, ami a fő oka a döntésünk elvetésének.
Patroni
Ez egy python sablon a PostgreSQL kezelésére, jó dokumentációval, automatikus failoverrel és a GitHubon elérhető forráskóddal.
A Patroni előnyei:
- Minden konfigurációs paraméter egyértelműen le van írva, világos, hogyan működik minden;
- Az automatikus failover dobozból működik;
- Python nyelven íródott, és mivel mi is sokat írunk pythonban, nekünk könnyebb lesz a problémák megoldása, és lehet, hogy még a projekt fejlesztésében is tudunk segíteni;
- Teljes mértékben kezeli a PostgreSQL-t, lehetővé téve a konfiguráció azonnali megváltoztatását a klaszter összes csomópontján; ha pedig a új konfiguráció alkalmazásához a klaszter újraindítása szükséges, ezt ismét a Patronival lehet megtenni.
Hátrányok:
- A dokumentációból nem világos, hogyan kell helyesen dolgozni a PgBouncer-rel. Bár ezt nehéz hátrányként említeni, mert a Patroni feladata a PostgreSQL kezelése, hogy a csatlakozások hogyan mennek be a Patroniba, az már a mi problémánk;
- Kevés példa van a Patroni nagy terhelésű bevezetésére, ugyanakkor számos példa található a nulláról való bevezetésre.
Végül a hibamentes klaszter létrehozásához a Patroni mellett döntöttünk.
A Patroni bevezetési folyamata
A Patroni előtt 12 PostgreSQL shardunk volt egy mester és egy replikával, aszinkron replikációval. Az alkalmazás szerverek a Network Load Balancer-en keresztül értek el az adatbázisokat, amely mögött két PgBouncer példány állt, és mögöttük voltak az összes PostgreSQL szerver.
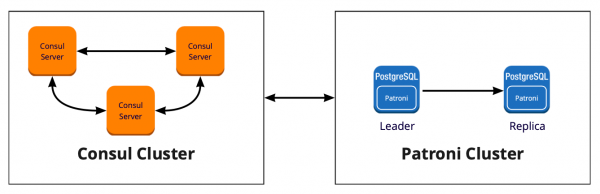
A Patroni bevezetéséhez el kellett választanunk egy elosztott konfigurációs tárolót a klaszter számára. A Patroni elosztott konfigurációs tárolórendszerekkel működik, mint az etcd, Zookeeper, Consul. A termelési környezetünkben van egy teljes Consul klaszterünk, amely együtt működik a Vault-tal, és egyébként nem használjuk. Kiváló lehetőség a Consul célzott használatára.
Hogyan működik a Patroni a Consul-lal
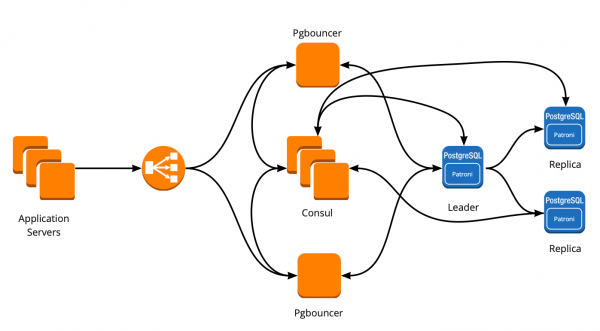
Van egy három node-ból álló Consul klaszterünk és egy Patroni klaszterünk, amely egy vezetőből és egy replikából áll (a Patroni-ban a mester a klaszter vezetője, a replikák pedig replikák). Minden Patroni klaszter példány folyamatosan küld információt a klaszter állapotáról a Consul-nak. Ezért a Consul-ból mindig meg lehet tudni a Patroni klaszter aktuális konfigurációját és azt, ki a vezető az adott pillanatban.
A Patroni Consul-hoz való csatlakozásához elegendő tanulmányozni a hivatalos dokumentációt, amelyben le van írva, hogy meg kell adni a hostot http vagy https formátumban, attól függően, hogyan dolgozunk a Consul-lal, és az opcionális csatlakozási sémát:
host: a Consul végpont host:port címe, formátumban: http(s)://host:port
scheme: (opcionális) http vagy https, alapértelmezés szerint http
Egyszerűnek tűnik, de itt kezdődnek a buktatók. A Consul-lal védett kapcsolatot használunk https-en keresztül, és a csatlakozási konfigurációnk a következőképpen néz ki:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
De így nem működik. A Patroni indításakor nem tud csatlakozni a Consul-hoz, mert továbbra is http-n próbálkozik.
A probléma megértésében segített a Patroni forráskódja. Jó, hogy Python nyelven írták. Kiderült, hogy a host paramétert nem elemzik, és a protokollt a scheme-ben kell megadni. Így néz ki a működő konfigurációs blokk a Consul-lal való kapcsolatunkhoz:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Tehát, kiválasztottuk a tárolót a konfigurációhoz. Most meg kell érteni, hogy a PgBouncer hogyan fogja váltani a konfigurációját, amikor a Patroni klaszterben vezetőt vált. E kérdésre a dokumentációban nincs válasz, mivel a PgBouncer működése nincs leírva.
Megoldás keresése közben találtunk egy cikket (a címét sajnos nem tudom), amelyben azt írták, hogy a Consul-template nagyon segített a PgBouncer és a Patroni összekapcsolásában. Ez arra ösztönzött minket, hogy kutassuk a Consul-template működését.
Kiderült, hogy a Consul-template folyamatosan figyelemmel kíséri a PostgreSQL klaszter konfigurációját a Consul-ban. Amikor a vezető vált, frissíti a PgBouncer konfigurációját és parancsot küld az újraindítására.
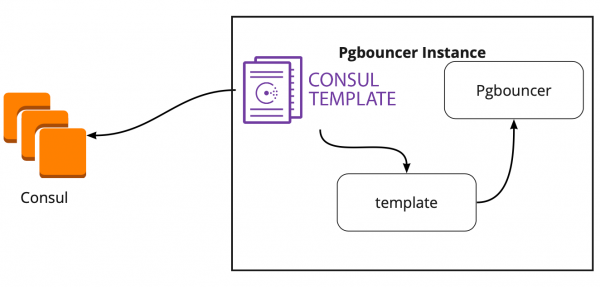
A template nagy előnye, hogy kódként van tárolva, tehát új shard hozzáadásakor elegendő egy új commitot végrehajtani és automatikusan frissíteni a template-t, ezzel fenntartva az Infrastructure as Code elvet.
Új architektúra Patroni-val
Ennek eredményeként a következő működési sémát kaptuk:
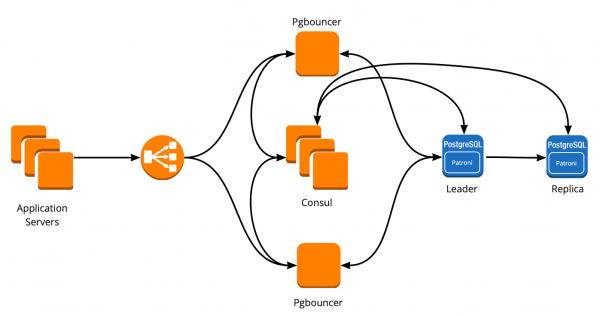
Minden alkalmazásszerver a terheléselosztóhoz fordul → mögötte két PgBouncer instance áll → mindkét instance-on a Consul-template fut, amely figyeli a Patroni klaszterek állapotát és nyomon követi a PgBouncer konfiguráció aktuális állapotát, amely a klaszterek aktuális vezetőjére irányítja a kéréseket.
Kézi tesztelés
Ezt a sémát éles környezetbe való kihelyezés előtt egy kis tesztkörnyezetben futtattuk, és ellenőriztük az automatikus váltás működését. Megnyitottuk a táblát, áthelyeztük a matricát, és ebben a pillanatban „megöltük” a klaszter vezetőjét. Az AWS-ben ehhez elegendő az instance leállítása a konzolon keresztül.
A matrica 10-20 másodperc múlva visszatért, majd újra elkezdte a normális mozgását. Ez azt jelenti, hogy a Patroni klaszter megfelelően működött: váltotta a vezetőt, elküldte az információt a Consulnak, és a Consul-template azonnal átvette ezt az információt, frissítette a PgBouncer konfigurációját és parancsot küldött a reload-ra.
Hogyan lehet túlélni a nagy terhelést és megőrizni a minimális leállást?
Minden nagyszerűen működik! De új kérdések merülnek fel: Hogyan működik ez nagy terhelés alatt? Hogyan lehet gyorsan és biztonságosan bevezetni mindent a produksi környezetbe?
Az első kérdésre a tesztkörnyezet segít válaszolni, ahol terheléses tesztelést végzünk. Ez teljesen azonos a production környezettel architektúrájában, és generált tesztadatokkal rendelkezik, amelyek mennyiségükben körülbelül egyenlőek a productionnal. Egyszerűen úgy döntünk, hogy 'megöljük' az egyik PostgreSQL mestert a teszt során, és megnézzük, mi történik. De ezt megelőzően fontos ellenőrizni az automatikus telepítést, hiszen ezen a környezeten több PostgreSQL shardunk van, így nagyszerű tesztelést kapunk a konfigurációs szkriptek előtt a production környezethez.
Mindkét feladat ambiciózusan hangzik, de nekünk PostgreSQL 9.6-unk van. Talán közvetlenül az 11.2-re frissítünk?
Úgy döntöttünk, hogy ezt két lépésben végezzük: először frissítjük a verziót 11.2-re, majd elindítjuk a Patroni-t.
PostgreSQL frissítése
A PostgreSQL verzió gyors frissítéséhez a következő opciót kell használni: -k, amely lehetővé teszi a hard linkek létrehozását a lemezen, így nincs szükség az adataid másolására. A 300-400 GB-os adatbázisok frissítése 1 másodpercet vesz igénybe.
Sok shardunk van, ezért a frissítést automatikusan kell végrehajtani. Ehhez írtunk egy Ansible playbookot, amely elvégzi a teljes frissítési folyamatot helyettünk:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--link </b>
--old-datadir='' --new-datadir=''
 --old-bindir=''  --new-bindir=''
 --old-options=' -c config_file='
 --new-options=' -c config_file='
Itt fontos megjegyezni, hogy a frissítés megkezdése előtt el kell végezni a frissítést a következő paraméterrel: —check, hogy biztosak legyünk a frissítés lehetőségében. Emellett a szkriptek a frissítés idejére felcserélik a konfigurációs fájlokat. A szkriptünk 30 másodperc alatt futott le, ami kiváló eredmény.
Patroni indítása
A második probléma megoldásához elegendő rátekinteni a Patroni konfigurációjára. A hivatalos repóban van egy példakonfiguráció initdb-vel, amely a új adatbázis inicializálásáért felelős a Patroni első indításakor. De mivel már van egy kész adatbázisunk, egyszerűen eltávolítottuk ezt a részt a konfigurációból.
Amikor elkezdtük a Patroni telepítését egy meglévő PostgreSQL klaszterre és elindítottuk azt, új problémával szembesültünk: mindkét szerver vezetőként indult. A Patroni nem tud a klaszter korábbi állapotáról, és megpróbálja mindkét szervert két külön klaszterként indítani ugyanazzal a névvel. E probléma megoldásához el kell távolítani az adatkönyvtárat a slave-en:
rm -rf /var/lib/postgresql/Ezt csak a slave-en szükséges megtenni!
A tiszta replikához csatlakozva a Patroni a leader-ből egy basebackup-ot készít, és visszaállítja azt a replikára, majd a wal-naplókon keresztül naprakésszé teszi.
Egy újabb nehézség, amellyel szembesültünk, hogy az összes PostgreSQL klaszter alapértelmezés szerint main néven ismert. Amikor minden klaszter nem tud a másikról, ez normális. De amikor Patronit szeretnél használni, akkor minden klaszternek egyedi névvel kell rendelkeznie. A megoldás az, hogy megváltoztatjuk a klaszter nevét a PostgreSQL konfigurációban.
Terhelési teszt
Futtattunk egy tesztet, amely szimulálta a felhasználók munkáját a táblákon. Amikor a terhelés elérte a napi átlagunkat, pontosan ugyanazt a tesztet ismételtük meg. Kihúztunk egy példányt a vezető PostgreSQL-ből. Az automatikus failover úgy működött, ahogy azt vártuk: Patroni megváltoztatta a vezetőt, a Consul-template frissítette a PgBouncer konfigurációt és kiadta a reload parancsot. Grafana grafikonjain látható volt, hogy 20-30 másodperces késések és egy kis mennyiségű hiba lépett fel a szervereknél, amelyek az adatbázishoz való kapcsolódással voltak összefüggésben. Ez normális helyzet, ilyen értékek elfogadhatók a failoverünknél, és mindenképpen jobb, mint a szolgáltatás leállása.
Patroni bevezetése a termelésbe
Összességében a következő tervet dolgoztuk ki:
- A Consul-template telepítése a PgBouncer szerverekre és beindítása;
- A PostgreSQL frissítése 11.2 verzióra;
- A klaszter nevének megváltoztatása;
- A Patroni klaszter indítása.
Eközben a sémánk lehetővé teszi, hogy az első pontot gyakorlatilag bármikor végrehajtsuk, sorban eltüntethetjük minden PgBouncer-t, és végrehajthatjuk rajta a Consul-template telepítést és indítást. Így is tettük.
Gyors bevezetéshez Ansible-t használtunk, mivel az összes playbook-ot már teszteltük a tesztkörnyezetben, és a teljes forgatókönyv végrehajtási ideje 1,5-2 perc volt minden shardra. Minden shard számára egymás után ki tudtuk vezetni anélkül, hogy le kellett volna állítanunk a szolgáltatásunkat, de néhány percre ki kellett volna kapcsolnunk minden PostgreSQL-t. Ebben az esetben azok a felhasználók, akiknek adatai ezen a shardon voltak, nem tudtak volna teljes mértékben dolgozni ebben az időben, ami számunkra elfogadhatatlan.
A helyzet megoldása a tervszerű karbantartás lett, ami nálunk háromhavonta zajlik. Ez az időszak a tervezett munkákra, amikor teljesen leállítjuk a szolgáltatásunkat és frissítjük az adatbázis példányait. Egy hét maradt a következő karbantartásig, és úgy döntöttünk, hogy egyszerűen megvárjuk és további előkészületeket teszünk. A várakozás időszakában további védelmet építettünk: minden PostgreSQL shard számára egy kiváltó másolatot állítottunk be, hogy megőrizzük a legfrissebb adatokat, és új példányt adtunk hozzá minden shardhoz, amely új replikává válik a Patroni klaszterben, hogy ne kelljen az adatokat eltávolító parancsot végrehajtanunk. Mindez segített minimálisra csökkenteni a hibázás kockázatát.
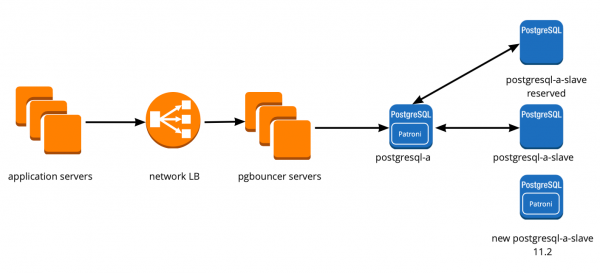
Újraindítottuk a szolgáltatásunkat, minden úgy működött, ahogy kellett, a felhasználók folytatták a munkát, de a grafikonokon rendkívül magas terhelést észleltünk a Consul szervereken.
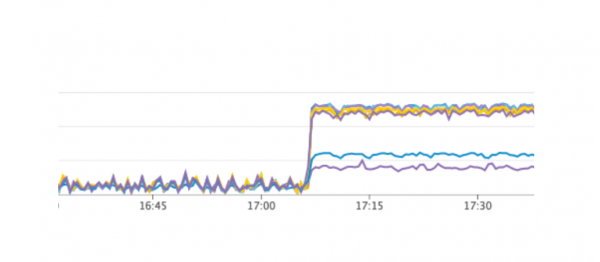
Miért nem észleltük ezt a tesztkörnyezetben? Ez a probléma nagyon jól szemlélteti, hogy követni kell az Infrastructure as code elvet, és fejleszteni kell az egész infrastruktúrát, kezdve a tesztkörnyezetektől egészen a production-ig. Különben nagyon könnyen olyan problémát kaphatunk, mint amit mi tapasztaltunk. Mi történt? A Consul először a production-ben jelent meg, majd a tesztkörnyezetekben, így a tesztkörnyezetekben a Consul verziója magasabb volt, mint a production-ben. Egyik kiadásban éppen a consul-template használata közben fellépő CPU szivárgást javították ki. Ezért egyszerűen frissítettük a Consult, így megoldva a problémát.
Patroni klaszter újraindítása
Aztán új problémával szembesültünk, amiről még csak nem is sejtettünk. Amikor frissítjük a Consult, egyszerűen eltávolítjuk a Consul csomópontot a klaszterből a consul leave parancs végrehajtásával → a Patroni csatlakozik egy másik Consul szerverhez → minden működik. De amikor eljutottunk a Consul klaszter utolsó példányához és elküldtük neki a consul leave parancsot, az összes Patroni klaszter egyszerűen újraindult, és a naplóinkban a következő hibát láttuk:
HIBÁZAT: get_cluster
Nyomkövetés (a legutolsó hívás legutolsó):
...
RetryFailedError: 'Túllépte a próbálkozás határidejét'
HIBÁZAT: Hiba a DCS-sel való kommunikációban
<b>NAPLÓ: az adatbázis rendszer leállt</b>
A Patroni klaszter nem tudta megszerezni a saját klaszteréről az információt, és újraindult.
A megoldás keresése érdekében felkerestük a Patroni szerzőit egy issue-on a github-on. Javasolták a konfigurációs fájlaink javítását:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Sikerült reprodukálni a problémát a tesztkörnyezetünkben, és ott teszteltük ezeket a paramétereket, de sajnos nem működtek.
A probléma továbbra is megoldatlan. Tervezett megoldási lehetőségeink a következők:
- Használjunk Consul-ügynököt a Patroni klaszter minden példányán;
- Javítsuk ki a problémát a kódban.
Megértettük a hiba jelentkezésének helyét: valószínűleg a probléma a default timeout használatában rejlik, amelyet nem lehet felülbírálni a konfigurációs fájlon keresztül. Amikor az utolsó Consul szerver eltávolításra kerül a klaszterből, az egész Consul-klaszter lefagy, ami több mint egy másodpercig tart, emiatt a Patroni nem tudja lekérdezni a klaszter állapotát, és teljesen újraindítja az egész klasztert.
Szerencsére további hibákat nem tapasztaltunk.
A Patroni használatának összegzése
A Patroni sikeres indítása után egy extra replikát adtunk hozzá minden klaszterhez. Most minden klaszterben van egyfajta kormányzás: egy vezető és két replikát, hogy biztosítsuk a biztonságot split-brain esetén a váltás során.
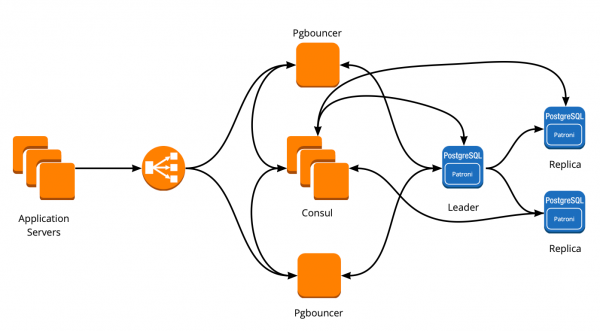
A produkciós környezetben a Patroni már több mint három hónapja működik. Ez idő alatt már több alkalommal segített nekünk. Nemrég az AWS-en az egyik klaszter vezetője meghalt, az automatikus failover működésbe lépett, és a felhasználók folytathatták a munkát. A Patroni betöltötte a legfontosabb szerepét.
Kis összegzés a Patroni használatáról:
- A konfiguráció változtatásának kényelme. Elegendő módosítani a konfigurációt egy példányon, és az az egész klaszterre érvényes lesz. Ha az új konfiguráció alkalmazásához újraindítás szükséges, akkor a Patroni értesít róla. A Patroni egyszeri parancs segítségével képes újraindítani az egész klasztert, ami szintén nagyon kényelmes.
- Az automatikus failover működik, és már segített nekünk.
- A PostgreSQL frissítése alkalmazás leállása nélkül. Először a replikákat kell frissíteni az új verzióra, majd meg kell változtatni a vezetőt a Patroni klaszterben, és frissíteni a régi vezetőt. Ekkor elvégezzük az automatikus failover tesztelését is.
Forrás: habr.com
