

Pár évvel ezelőtt a Kubernetes a GitHub hivatalos blogján. Azóta a szolgáltatások telepítésének standard technológiai eszközévé vált. A Kubernetes mostanra a belső és nyilvános szolgáltatások jelentős részét kezeli. Ahogy a klaszterjeink növekedtek, és a teljesítményre vonatkozó követelmények szigorúbbá váltak, észrevettük, hogy egyes Kubernetes-alapú szolgáltatásokban időnként késések lépnek fel, amelyeket nem lehet az alkalmazás terhelésével magyarázni.
Alapvetően az alkalmazásokban olyan véletlenszerű hálózati késések fordulnak elő, amelyek meghaladják a 100 ms-t, ami időtúllépéseket vagy újrapróbálkozásokat eredményez. Vártuk, hogy a szolgáltatások sokkal gyorsabban, 100 ms-on belül válaszoljanak. De ez lehetetlen, ha a kapcsolat önmagában ennyi időt vesz igénybe. Emellett megfigyeltük, hogy a MySQL nagyon gyors lekérdezéseket hajtott végre, amelyeknek milliszekundumokat kellett volna igénybe venniük, és a MySQL valóban milliszekundumok alatt elvégezte a feladatot, de a kérő alkalmazás szempontjából a válasz 100 ms-ot vagy annál többet vett igénybe.
Azonnal világossá vált, hogy a probléma csak a Kubernetes csomóponttal való kapcsolódáskor lép fel, még akkor is, ha a hívás kívülről érkezett a Kubernetesbe. A legegyszerűbb módja a probléma reprodukálásának egy teszt, amely bármely belső hosztról indítható, a Kubernetes szolgáltatását teszteli egy adott porton, és időnként nagy késleltetést rögzít. Ebben a cikkben megvizsgáljuk, hogyan sikerült nyomon követni a probléma okát.
Eltávolítjuk a felesleges bonyolultságot a hiba útvonalából
Azonos példa reprodukálásával a probléma fókuszálására és a felesleges bonyolultsági rétegek eltávolítására törekedünk. Kezdetben a Vegeta és a Kubernetes pod-ja között túl sok elem volt a folyamatban. A mélyebb hálózati probléma meghatározásához néhányat ki kell zárni.
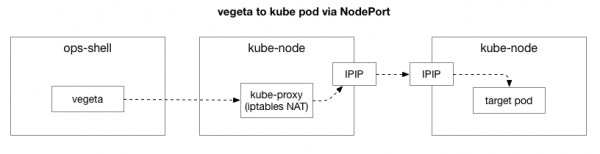
A kliens (Vegeta) TCP-kapcsolatot létesít a klaszter bármely csomópontjával. A Kubernetes egy felületi hálózatként működik (a meglévő adatközponti hálózaton), amely , azaz az IP-paketeket a felületi hálózatról a helyi adatközpont IP-packetjeibe burkolja. Az első csomóponthoz való csatlakozáskor végrehajtásra kerül a hálózati címek átkonvertálása. (NAT) állapotfigyeléssel, amely a Kubernetes csomópont IP-címét és portját egy IP-címre és portjára alakítja az overlay hálózatban (különösen az alkalmazás pod esetében). A beérkező csomagok esetében fordított művelet történik. Ez egy bonyolult rendszer, sok állapottal és elemmel, amelyek folyamatosan frissülnek és változnak a szolgáltatások telepítése és mozgatása során.
Eszköz tcpdump a Vegeta teszt során késlekedést okoz a TCP kézfogás során (a SYN és a SYN-ACK között). Ennek a felesleges bonyodalomnak a kiküszöbölése érdekében hping3 egyszerű "pingeléshez" SYN csomagok használatát javasoljuk. Ellenőrizzük, hogy van-e késlekedés a válaszcsomagban, majd megszakítjuk a kapcsolatot. Az adatokat szűrhetjük, ha csak a 100 ms-nál nagyobb csomagokat vesszük figyelembe, ezáltal egyszerűbb reprodukálási lehetőséget kapunk a problémára, mint a teljes 7-es szintű hálózati teszt a Vegeta használatával. Íme a Kubernetes csomópont pingjei TCP SYN/SYN-ACK használatával a szolgáltatás csomóponti portján (30927), 10 ms-os időközönként, a leglassabb válaszok alapján leszűrve:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Az első észlelés azonnal megtehető. A sorrendi számok és időzítések alapján látható, hogy ezek nem egyszeri torlódások. A késlekedés gyakran felhalmozódik, és végül feldolgozásra kerül.
Továbbiakban szeretnénk kideríteni, hogy mely összetevők lehetnek felelősek a torlódás megjelenéséért. Lehet, hogy ezek a NAT-ban lévő iptables szabályok százai közül valamik? Vagy esetleg valamilyen probléma áll fenn az IPIP alagútrendszerrel a hálózaton? Az egyik módja ennek ellenőrzésére az, hogy a rendszer minden lépését külön-külön ellenőrizzük, kizárva őket. Mi történik, ha eltávolítjuk a NAT-ot és a tűzfal logikáját, csak az IPIP részt hagyva:
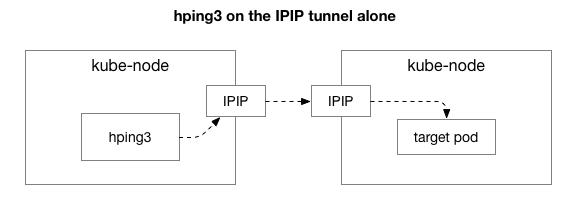
Szerencsére a Linux lehetővé teszi, hogy közvetlenül hozzáférjünk az IP overlay réteghez, ha a gép ugyanazon a hálózaton van:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
A teszt eredményei szerint a probléma még mindig fennáll! Ez kizárja az iptables-t és a NAT-ot. Tehát a probléma a TCP-ban keresendő? Nézzük meg, hogyan teljesít a szokásos ICMP ping:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Az eredmények azt mutatják, hogy a probléma nem szűnt meg. Lehet, hogy IPIP alagútról van szó? Egyszerűsítsük le a tesztet:
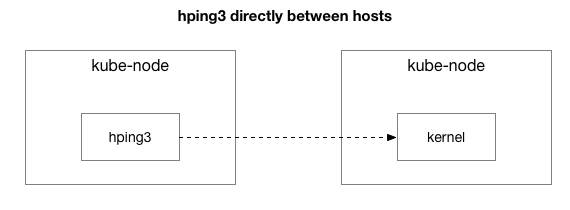
Minden csomagot elküldenek a két hoszt között?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Egyszerűsítettük a helyzetet arra, hogy két Kubernetes csomópont egymásnak bármilyen csomagot, még ICMP pinget küld. Még mindig késlekedést tapasztalnak, ha a cél hoszt "rossz" (néhány rosszabb, mint a másik).
Most az utolsó kérdés: miért csak a kube-node szervereken jelenik meg a késlekedés? Akkor is előfordul, amikor a kube-node a küldő vagy a fogadó? Szerencsére ezt is viszonylag könnyű kideríteni, ha egy csomagot küldünk a Kubernetesen kívüli hosztról, de ugyanazzal a "megismert rosszal" rendelkező fogadóról. Ahogy látjuk, a probléma nem szűnt meg:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Ezután ugyanazokat a lekérdezéseket végezzük a korábbi kiindulási kube-node-ból egy külső hosztra (ami kizárja a kiindulási hosztot, mivel a ping mind az RX, mind a TX komponenst tartalmaz):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping statisztika ---
 22352 csomag küldve, 22350 csomag fogadva, 1% csomagveszteség
 körutazás min / átlag / max = 0.2 / 7.6 / 1010.6 ms
A csomagok késleltetésével kapcsolatos megfigyelések alapján további információkhoz jutottunk. Különösen, hogy a küldő (lent) látja ezt az időtúllépést, míg a címzett (fent) nem — lásd a Delta oszlopot (másodpercben):
Ezenkívül, ha megnézzük a TCP és ICMP csomagok sorrendi különbségét (sorrendi számok alapján) a címzett oldalán, akkor az ICMP csomagok mindig abban a sorrendben érkeznek, ahogyan elküldték őket, de eltérő időzítéssel. Eközben a TCP csomagok néha keverednek, és egy részük elakad. Különösen, ha megvizsgáljuk a SYN csomagok portjait, akkor a küldő oldalán ezek sorrendben érkeznek, a címzett oldalán viszont nem.
Van egy finom különbség abban, hogy a modern szervereken (például a mi adatközpontunkban) hogyan kezelik a TCP vagy ICMP tartalmú csomagokat. Amikor egy csomag érkezik, a hálózati adapter „hash-eli a kapcsolat alapján”, azaz megpróbálja szétválasztani a kapcsolatokat sorokba és minden sort egy külön processzor magra küldeni. A TCP esetében ez a hash tartalmazza a forrás- és cél IP-címet, valamint a portot. Más szavakkal, minden kapcsolat (potenciálisan) különböző módon hash-elve van. Az ICMP esetében csak az IP-címek vannak hash-elve, mivel portok nincsenek.
Egy újabb megfigyelés: ebben az időszakban ICMP késleltetéseket látunk minden kommunikációban a két hoszt között, míg TCP esetén ez nem történt. Ez arra utal, hogy a probléma valószínűleg a RX sorok hash-álásához kapcsolódik: szinte biztos, hogy a torlódás a RX csomagok feldolgozásában keletkezik, nem pedig a válaszok küldésekor.
Ez kizárja a csomagok küldését lehetséges okok közül. Most már tudjuk, hogy a csomagok feldolgozási problémája a kube-node néhány szerverén a bejövő oldalon található.
A csomagok feldolgozása a Linux kernelben
Annak érdekében, hogy megértsük, miért merül fel a probléma a címzett oldalán a kube-node néhány szerverén, nézzük meg, hogyan kezeli a Linux kernel a csomagokat.
Visszatérve a legegyszerűbb hagyományos megvalósításhoz, a hálózati kártya megkap egy csomagot és elküldi a Linux kerneltől, hogy van egy csomag, amelyet feldolgozni kell. A kernel leállítja a többi feladatot, a kontextust a megszakításkezelőre váltja, feldolgozza a csomagot, majd visszatér az aktuális feladatokhoz.
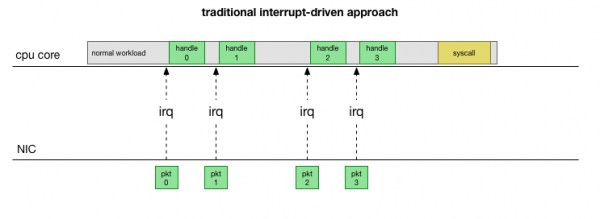
Ez a kontextusváltás lassan történik: lehet, hogy a késlekedés a 90-es évek 10 megabites hálózati kártyáinál észrevétlen maradt, de a modern 10G kártyákon, amelyek maximális teljesítménye 15 millió csomag másodpercenként, minden egyes kis nyolcmagos szervermag másodpercenként milliószor is megszakítható.
Annak érdekében, hogy ne kelljen folyamatosan megszakítást kezelni, több évvel ezelőtt a Linux bevezette : egy hálózati API-t, amelyet minden modern meghajtó használ a nagy sebességek teljesítményének növelésére. Alacsony sebességek mellett a kernel még mindig a régi módon kezeli a hálózati kártya megszakításait. Amint elegendő csomag érkezik, amely meghaladja a küszöböt, a kernel kikapcsolja a megszakításokat, és ehelyett elkezdi lekérdezni a hálózati adaptert, és csomagokat nagy mennyiségben gyűjt össze. A feldolgozás softirq-ben történik, azaz a rendszerhívások és hardveres megszakítások után, amikor a kernel (ellentétben a felhasználói térrel) már fut.
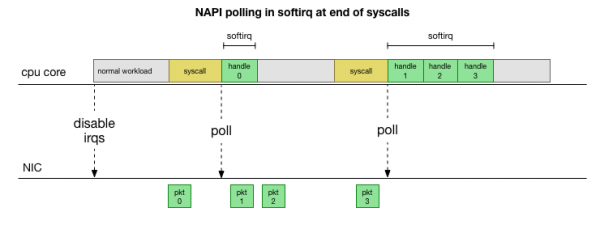
Ez sokkal gyorsabb, de egy másik problémát okoz. Ha túl sok csomag van, az idő szinte mindig a hálózati kártya csomagjainak feldolgozásával telik el, míg a felhasználói tér folyamatai nem tudják ténylegesen kiüríteni ezeket a sorokat (olvasás TCP-kapcsolatokból stb.). Végül a sorok megtelnek, és elkezdjük eldobni a csomagokat. A kipróbálva a kiegyensúlyozást, a kernel költségvetést állít fel a softirq kontextusában feldolgozott maximális csomagszámra. Amint ezt a költségvetést túllépik, külön szál ébred fel ksoftirqd (minden mag esetében láthat egyet a A folyamatok listájának megjelenítése. ), amely ezeket a softirq-ket a normál syscall/megszakítás útvonalon kívül kezeli. Ezt a szálat a szabványos folyamatütemező kezeli, amely megpróbálja igazságosan elosztani az erőforrásokat.
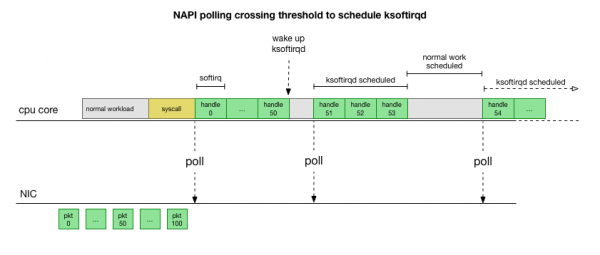
Ha megvizsgáljuk, hogyan kezeli a kernel a csomagokat, észlelhetjük, hogy itt van egy bizonyos valószínűség a dugók megjelenésére. Ha a softirq-k hívása ritkábban érkezik, a csomagok várni fognak a feldolgozásra a hálózati kártya RX sorában. Lehetséges, hogy ez annak köszönhető, hogy egy feladat blokkolja a processzormagot, vagy valami más megakadályozza a kernelt, hogy elindítsa a softirq-t.
Kicsinyítjük a feldolgozást a kernelre vagy a módszerre
A softirq késlekedések egyelőre csak feltételezések. De van értelme, és tudjuk, hogy valami nagyon hasonló történik velünk. Ezért a következő lépés az elmélet megerősítése. Ha ez megerősítést nyer, akkor meg kell találni a késleltetések okát.
Térjünk vissza a lassú csomagjainkhoz:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Ahogy korábban említettük, ezek az ICMP csomagok egy sorba kerülnek a NIC RX-ben és egy CPU mag kezeli őket. Ha meg akarjuk érteni a Linux működését, hasznos tudni, hogy hol (melyik CPU magon) és hogyan (softirq, ksoftirqd) kezelik ezeket a csomagokat, hogy nyomon követhessük a folyamatot.
Most elérkezett az idő, hogy olyan eszközöket használjunk, amelyek lehetővé teszik a Linux kernel működésének valós idejű nyomon követését. Itt használtuk . Ez az eszközkészlet lehetővé teszi, hogy kis C programokat írjunk, amelyek interceptálják a kernelben található tetszőleges funkciókat és eseményeket bufferelnek egy Python felhasználói térbeli programba, amely képes feldolgozni azokat, és visszaküldeni nekünk az eredményt. A kernelbeli tetszőleges funkciók horgonyzásának nehéz feladat, de az eszköz a maximális biztonság érdekében lett tervezve, hogy nyomon követhessük azokat a termelési problémákat, amelyeket nehéz reprodukálni a tesztelési vagy fejlesztési környezetben.
A terv egyszerű: tudjuk, hogy a kernel kezeli ezeket az ICMP pingegetéseket, ezért egy horgot állítunk be a kernel funkciójára, amely fogadja a bejövő ICMP „echo request” csomagot és kezdeményezi az ICMP „echo response” választ. Az icmp_seq növekedésével azonosíthatjuk a csomagot, amely megmutatja hping3 fent.
Kód bonyolultnak tűnik, de valójában nem olyan ijesztő, mint ahogy látszik. A icmp_echo jelenti struct sk_buff *skb: ez a „echo request” csomag. Nyomon tudjuk követni, ki tudjuk húzni a sorozatszámát echo.sequence (amely megfelel a icmp_seq a hping3-nál fentebb), és elküldhetjük a felhasználói térbe. Hasznos elkapni a folyamat aktuális nevét/azonosítóját is. Az alábbiakban láthatóak az eredmények, amelyeket közvetlenül a kernel csomagkezelése során látunk:
TGID    PID     FOLYAM NEVE    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Itt érdemes megjegyezni, hogy a kontextusban softirq a rendszerszóhívásokat végrehajtó folyamatok "folyamatok"-ként fognak megjelenni, bár valójában a mag biztonságosan kezeli a csomagokat a mag kontextusában.
Ezzel az eszközzel összekapcsolhatjuk a konkrét folyamatokat a késleltetést mutató konkrét csomagokkal, amelyek a hping3. Egyszerűsítjük grep ezen a felvételen bizonyos értékek számára icmp_seq. Az említett icmp_seq értékekhez tartozó csomagok együtt voltak megjelölve a fenti RTT-vel, amelyeket a fentiekben figyeltünk (zárójelben a megszűrt csomagok elvárt RTT értékei, amelyek kevesebb mint 50 ms értékek voltak):
TGID    PID     FOLYAM NEVE    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Az eredmények több dolgot elmondanak számunkra. Először is, az összes ilyen csomagot a következő kontextus kezel: ksoftirqd/11. Ez azt jelenti, hogy ennek a konkrét géppárnak az ICMP-csomagok a fogadó gép 11-es magjára voltak hash-elve. Azt is látjuk, hogy minden késedelem során vannak olyan csomagok, amelyeket a rendszerszóhívás kontextusában kezelnek: cadvisor. Ezután ksoftirqd átveszi a feladatot és kezeli a felhalmozott sort: pontosan azt a csomagszámot, amely felhalmozódott a cadvisor.
Az a tény, hogy közvetlenül ez előtt mindig működik cadvisor, a problémához való közreműködést implicál. Ironikus módon, a célja a "futó konténerek erőforrás-használatának és teljesítményjellemzőinek elemzése", nem pedig a teljesítményproblémák kiváltása.
Ahogy más konténeres munkafolyamatoknál is, ez egy rendkívül modern eszköz, amitől teljesen elvárható, hogy teljesítményproblémák adódjanak néhány váratlan körülmény között.
Mit csinál a cadvisor, ami lelassítja a csomagok sorát?
Most már elég jól értjük, hogyan következik be a hiba, mely folyamat okozza ezt, és melyik CPU-n. Látjuk, hogy a szigorú blokkolás miatt a Linux kernel nem tud időben ütemezni. ksoftirqd. És látjuk, hogy a csomagok a következő kontextusban kerülnek feldolgozásra. cadvisor. Logikus feltételezni, hogy cadvisor lassú syscall-t indít, ami után az összes addig felhalmozódott csomagot feldolgozzák:
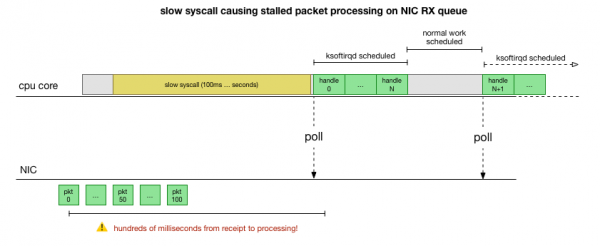
Ez egy elmélet, de hogyan lehet ezt ellenőrizni? Amit tehetünk, az az, hogy figyelemmel kísérjük a CPU kernel működését a folyamat során, megkeressük azt a pontot, ahol a csomagok számának költségkerete túllépődik és a ksoftirqd aktiválódik, majd pillantsunk meg egy kicsit korábban – mi működött a CPU kernel-en közvetlenül ez előtt. Olyan ez, mint egy röntgenfelvétel a CPU-ról néhány milliszekundumonként. Körülbelül így fog kinézni:
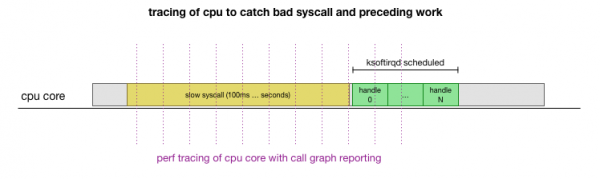
Kényelmes, hogy mindezt a meglévő eszközökkel meg lehet tenni. Például, megadott időközönként ellenőrzi a kijelölt CPU magot, és képes hívásgrafikonokat generálni az aktív rendszerről, beleértve a felhasználói teret és a Linux kernelt. Ezt a felvételt el lehet venni és feldolgozni egy kis forkjával a Brendan Gregg-től, ami megőrzi a stack trace sorrendjét. Egysoros stack trace-eket menthetünk 1 ms-ként, majd kiemelhetünk és elmenthetünk egy mintát 100 milliszekundummal azelőtt, hogy a trace-be kerüljön. ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Itt vannak az eredmények:
(százak, amelyek hasonlóan néznek ki)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Itt sok minden van, de a legfontosabb, hogy észrevettük a "cadvisor a ksoftirqd előtt" mintát, amit korábban láttunk az ICMP nyomozóban. Mit jelent ez?
Minden sor egy CPU nyomozás egy adott időpontban. Minden lefele hívás a veremben egy pontosvesszővel van elválasztva. A sorok közepén látjuk a hívott syscallt: read(): .... ;do_syscall_64;sys_read; .... Így a cadvisor sok időt tölt a rendszerhívással read(), kapcsolódóan a következő funkciókhoz mem_cgroup_* (a verem hívásainak teteje/sor vége).
A hívások nyomozásában nem kényelmes látni, hogy pontosan mi olvasodik, ezért fussunk strace és nézzük meg, mit csinál a cadvisor, és találjunk olyan rendszerhívásokat, amelyek hosszabbak 100 ms-nál:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Ahogyan várható volt, itt látjuk a lassú hívásokat read(). A műveletek olvasási és kontextuális tartalmából mem_cgroup látható, hogy ezek a hívások read() kapcsolódnak a fájlhoz memory.stat, amely a memóriahasználatot és a cgroup-korlátozásokat mutatja (a Docker erőforrás-izolációs technológiája). A cadvisor eszköz lekérdezi ezt a fájlt, hogy információkat szerezzen a konténerek erőforrás-használatáról. Ellenőrizzük, hogy ez a kernel vagy a cadvisor csinál-e valami váratlant:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Most meg tudjuk reprodukálni a hibát, és értjük, hogy a Linux kernel patológiával küzd.
Miért olyan lassú a leolvasási művelet?
Ezen a ponton sokkal könnyebb más felhasználók üzeneteit keresni hasonló problémákról. Kiderült, hogy a cadvisor nyomkövetőjében ezt a hibát a , de senki nem vette észre, hogy a késlekedés szintén véletlenszerűen tükröződik a hálózati veremben. Valójában észlelték, hogy a cadvisor több processzort időt fogyaszt, mint várták, de ezt nem vették komolyan, mert a szervereinknek sok processzora van, így a problémát alaposan nem vizsgálták meg.
A probléma az, hogy a csoportok (cgroups) a memóriahasználatot a névtér (konténer) belsejében számolják. Amikor az összes folyamat befejeződik ebben a cgroupban, a Docker felszabadítja a memória csoportot. Azonban a "memória" nem csupán a folyamat memóriája. Bár a folyamatok memóriája többé már nem használatos, kiderül, hogy a kernel még mindig kiosztja a gyorsítótárazott tartalom, például dentrixek és inode-ok (mappák és fájlok metaadatait), amelyek a memória cgroupban gyorsítótárazódnak. A probléma leírásából:
cgroups-zombik: olyan csoportok, amelyekben nincsenek folyamatok, és törölve lettek, de ahol még mindig van memória kiosztva (az én esetemben a dentry gyorsítótárból, de ez származhat a lapok gyorsítárából is vagy a tmpfs-ből).
A kernel gyorsítótárazott lapok ellenőrzése a cgroup felszabadításakor nagyon lassú lehet, ezért egy lustább folyamatot választottak: várni, amíg ezeket a lapokat újra kérik, és már akkor, amikor a memória valóban szükséges, végre tisztítani a cgroupot. Ezen a ponton a cgroup még mindig szerepel a statisztikai gyűjtés során.
Teljesítmény szempontjából áldoztak a memóriából a teljesítmény érdekében: a kezdeti tisztítás felgyorsítása miatt kicsit kevesebb gyorsítótár memória marad. Ez rendben van. Amikor a mag az utolsó részét használja a gyorsítótár memóriának, a cgroup végül tisztul, ezért ezt nem lehet "memória szivárgásnak" nevezni. Sajnos a keresési mechanizmus konkrét megvalósítása memory.stat ebben a kernel verzióban (4.9), együtt a szervereinken lévő hatalmas mennyiségű memóriával azt eredményezi, hogy a legutolsó gyorsítón kívüli adatok visszaállításához és a cgroup zombik tisztításához sokkal több idő szükséges.
Kiderült, hogy néhány node-on annyi cgroup zombival volt dolgunk, hogy az olvasási késedelem meghaladta az egy másodpercet.
A cadvisor probléma megkerülésének módja az, hogy azonnal felszabadítjuk a gyorsítótár dentries/inodes-okat az egész rendszeren, ami azonnal megszünteti az olvasási késedelmet, valamint a hálózati késedelmet a gazdagépen, mivel a gyorsítótár eltávolítása magában foglalja a cgroup zombik cache-elt oldalait, és ezek is felszabadulnak. Ez nem megoldás, de megerősíti a probléma okát.
Kiderült, hogy az újabb kernelvekben (4.19+) javult a hívás teljesítménye memory.stat, így a frissítés erre a kernelre megszüntette a problémát. Eközben rendelkezésünkre állt egy eszközkészlet a problémás node-ok észlelésére a Kubernetes klaszterekben, elegáns leállításukra és újraindításukra. Átvizsgáltuk az összes klasztert, megtaláltuk azokat a node-okat, amelyek elég magas késleltetéssel bírtak, és újraindítottuk őket. Ez lehetőséget adott az operációs rendszer frissítésére a többi szerveren.
Összefoglalva
Mivel ez a hiba megállította a NIC RX sorok feldolgozását több száz millisekundumra, egyszerre okozott nagy késedelmet a rövid kapcsolatain, illetve késedelmet a kapcsolat közepén, például a MySQL lekérések és a válaszcsomagok között.
A legfontosabb rendszerek, mint a Kubernetes, teljesítményének megértése és támogatása kulcsfontosságú minden, ezekre épülő szolgáltatás megbízhatósága és sebessége szempontjából. A Kubernetes teljesítményjavulása minden futó rendszert érint.
Forrás: habr.com
