

Hogyan olvassuk ezt a cikket: elnézést kérek, amiért a szöveg ilyen hosszúra és zűrzavarosra sikeredett. Az Ön időmegtakarítása érdekében minden fejezetet a "Mit tanultam" bevezetővel kezdek, amelyben egy-két mondatban összefoglalom a fejezet lényegét.
„Csak mutasd meg a megoldást!” Ha csak azt szeretné látni, hová jutottam, akkor ugorjon a "Találtam egy kreatívabb megoldást" fejezetre, de úgy gondolom, hogy érdekesebb és hasznosabb elolvasni a kudarcokról.
Nemrégiben kaptam megbízást arra, hogy beállítsam egy nagy mennyiségű DNS-szekvencia feldolgozásának folyamatát (technikai nevén SNP-chip). Gyorsan kellett adatokat nyernem egy adott genetikai helyről (amelyet SNP-nek hívnak) további modellezéshez és egyéb feladatokhoz. R és AWK segítségével természetes módon sikerült megtisztítanom és rendszereznem az adatokat, jelentősen felgyorsítva a lekérdezések feldolgozását. Ez nem volt könnyű feladat, és számos iterációt igényelt. Ez a cikk segít elkerülni néhány hibámat, és bemutatja, hogy végül mi született.
Kezdésként néhány bevezető magyarázat.
Adatok
Egyetemi genetikai információk feldolgozására szolgáló központunk 25 TB méretű TSV-formátumú adatokat szolgáltatott. Ezek 5 csomagra voltak bontva, Gzip tömörítéssel, és mindegyik körülbelül 240 négygigabájtos fájlt tartalmazott. Minden sor egy SNP-adatot tartalmazott egy személyről. Összesen körülbelül 2,5 millió SNP és ugyanennyi ember adatát adták át. Az SNP-információkon kívül a fájlokban számos oszlop létezett, amelyek különböző jellemzők, például olvasási intenzitás, különböző allélok gyakorisága stb. értékeit tükrözték. Összesen körülbelül 30 oszlop volt egyedi értékekkel.
Cél
Mint bármilyen adatkezelési projektben, a legfontosabb az volt, hogy meghatározzuk, hogyan fogják használni az adatokat. Ebben az esetben többnyire modelleket és munkafolyamatokat fogunk keresni az SNP-k alapján.. Tehát egyidejűleg csak egy SNP-re vonatkozó adatokra volt szükség. Meg kellett tanulnom, hogyan lehet a legegyszerűbben, leggyorsabban és legolcsóbban előhívni az összes nyilvántartást, amely a 2,5 millió SNP egyikéhez kapcsolódik.
Hogyan ne csináljuk
Idéznék egy megfelelő közhelyet:
Ezerszer nem sikerült, csupán ezer módot fedeztem fel arra, hogyan ne parse-oljunk rengeteg adatot a lekérdezésekhez megfelelő formátumban.
Első kísérlet
Mit mire tanultam?: nincs olcsó módja 25 TB egyszerre történő feldolgozásának.
Miután részt vettem a Vanderbilt Egyetem "Fejlett Nagy Adatok Feldolgozási Módszerei" tantárgyán, biztos voltam benne, hogy ez egyszerű lesz. Talán egy-két óra elmegy a Hive-szerver beállításával, hogy átfusson az összes adaton és beszámoljon az eredményről. Mivel az adataink az AWS S3-ban tárolódnak, az , amely lehetővé teszi, hogy Hive SQL lekérdezéseket végezzünk az S3 adatokon. Nem kell beállítani/hogalapítani Hive klasztert, és csak azokért az adatokért kell fizetni, amelyeket keresünk.
Miután megmutattam az Athénának az adataimat és a formátumukat, néhány tesztet futtattam hasonló lekérdezésekkel:
select * from intensityData limit 10;És gyorsan jól strukturált eredményeket kaptam. Kész.
Amíg meg nem próbáltuk felhasználni az adatokat a munkában...
Kértek, hogy húzzam ki az összes információt a SNP-ről, hogy teszteljem rajta a modellt. Futtattam a lekérdezést:
select * from intensityData
where snp = 'rs123456';
…és várnom kellett. Nyolc perc elteltével és több mint 4 TB kért adat után megkaptam az eredményeket. Az Athena az előkerült adatok mennyisége után számol fel díjat, 5 dollár terabájtja. Így ez az egyetlen lekérdezés 20 dollárba került és nyolc perc várakozást igényelt. Az összes adaton futtatni a modellt 38 évet és 50 millió dollárt jelentett volna. Nyilvánvaló, hogy ez nem volt megfelelő számunkra.
Használni kellett a Parquet formátumot...
Mit mire tanultam?: vigyázzon a Parquet fájlok méretével és szervezésével.
Először megpróbáltam javítani a helyzetet, és minden TSV-t átkonvertáltam . Ezek jól használhatók nagy adathalmazok kezelésére, mivel az információk oszlopos formában tárolódnak: minden oszlop saját memória/disk segmentben van, szemben a szöveges fájlokkal, amelyek sorokban tárolják az egyes oszlopok elemeit. És ha valamit meg akar keresni, elegendő, ha csak a szükséges oszlopot olvassa el. Ezen kívül minden fájlban az oszlopban tárolva van az értékek tartománya, így ha a keresett érték nem szerepel az oszlop tartományában, a Spark nem fog időt pazarolni az egész fájl átvizsgálására.
Futtattam egy egyszerű feladatot A TSV konvertálásához Parquet formátumba új fájlokat töltöttem fel az Athena rendszerébe. Ez körülbelül 5 órát vett igénybe. Amikor azonban elindítottam a lekérdezést, annak végrehajtása körülbelül ugyanannyi időt és valamivel kevesebb pénzt igényelt. A probléma az, hogy a Spark, próbálva optimalizálni a feladatot, egyszerűen kibővítette az egyik TSV darabot és elhelyezte a saját Parquet darabjában. Mivel minden darab elég nagy volt, és sok ember teljes feljegyzéseit tartalmazta, ezért minden fájlban minden SNP tárolódott, így a Spark-nak minden fájlt meg kellett nyitnia a szükséges információk kinyeréséhez.
Kíváncsi vagyok, hogy a Parquet alapértelmezett (és ajánlott) tömörítési típusa — a snappy — nem osztható (splitable). Ezért minden végrehajtó (executor) beragadt a teljes 3,5 GB-os adathalmazon történő kibővítési feladatba.
Ráérezve a problémára
Mit mire tanultam?: nehéz a sorba állítás, különösen, ha az adatok el vannak osztva.
Úgy tűnt, most már megértettem a probléma lényegét. Csak az SNP oszlop szerint kellett volna sorba állítanom az adatokat, nem az emberek szerint. Akkor egy külön adatrészben több SNP tárolódna, és ekkor a Parquet "intelligens" funkciója, amely "csak akkor nyitja meg, ha az érték a tartományba esik", valóban megmutatná a tudását. Sajnos, a milliárd sor sorba állítása, amelyek a klaszter körül voltak szétszórva, nehéz feladatnak bizonyult.
Én, amikor algoritmusokat tanulok az egyetemen: "Uhh, senkit sem érdekel a számítási bonyolultság minden egyes rendezési algoritmusnak"
Én, amikor próbálok rendezni egy 20 TB-os oszlopon táblázat: "Miért tart ilyen sokáig?" küzdelmek.
— Nick Strayer (@NicholasStrayer)
Az AWS biztosan nem akar visszatéríteni a pénzt az "én egy szétszórt diák vagyok" indokra. Miután elindítottam a rendezést az Amazon Glue-ban, az 2 napig futott, majd hibával végződött.
Mi a helyzet a partícionálással?
Mit mire tanultam?: a Spark partícióknak kiegyensúlyozottaknak kell lenniük.
Aztán eszembe jutott az ötlet, hogy a kromoszómákban partícionálom az adatokat. Összesen 23 darab van (és még néhány, ha figyelembe vesszük a mitokondriális DNS-t és a dekódolatlan (unmapped) területeket).
Ez lehetővé teszi az adatok kisebb részletekre bontását. Ha a Spark exportálási funkciójához a Glue scriptben csak egy sor hozzáadunk partition_by = "chr", akkor az adatoknak a vödörök (buckets) szerint kellene eloszlaniuk.
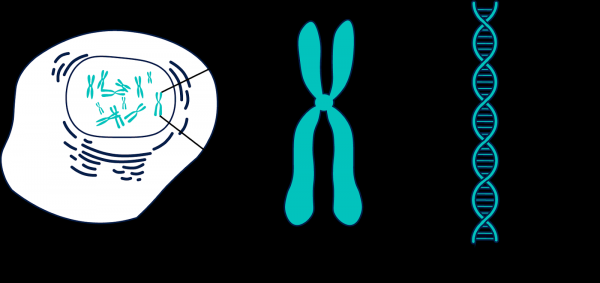
A genoma számos darabból áll, amelyeket kromoszómáknak nevezünk.
Sajnálom, nem működött. A kromoszómák különböző méretűek, tehát különböző mennyiségű információval rendelkeznek. Ez azt jelenti, hogy a Spark által a munkásoknak küldött feladatok nincsenek kiegyensúlyozva, és lassan hajtódnak végre, mert egyes csomópontok hamarabb befejezik, majd tétlenkednek. Azonban a feladatok végrehajtásra kerültek. De amikor egy SNP-t kértem, a kiegyensúlyozatlanság ismét problémákat okozott. Az SNP feldolgozási költsége a nagyobb kromoszómákban (azaz ott, ahonnan az adatokat szeretnénk megszerezni) mindössze körülbelül 10-szer csökkent. Sok, de nem elég.
Mi lenne, ha még kisebb partíciókra osztanánk?
Mit mire tanultam?: soha ne próbálj meg 2,5 millió partíciót létrehozni.
Úgy döntöttem, hogy teljesen szétbontom és minden SNP-t partikionálok. Ez biztosította az egyenlő méretű partíciókat. ROSSZ ÖTLET VOLT. Használtam a Glue-t és hozzáadtam egy ártatlan sort partition_by = 'snp'. A feladat elindult és futni kezdett. Egy nap múlva ellenőriztem, és láttam, hogy az S3-ban még mindig nincs semmi felírva, ezért leállítottam a feladatot. Úgy tűnik, a Glue köztes fájlokat írt egy rejtett helyre az S3-ban, és sok fájl volt, talán pár millió. Ennek eredményeként a hibám több mint ezer dollárba került, és nem örvendeztette meg a mentort.
Particionálás + rendezés
Mit mire tanultam?: a rendezés még mindig nehéz, akárcsak a Spark beállítása.
Az utolsó particionálási próbálkozásom az volt, hogy a kromoszómákat partikionáltam, majd minden partíciót rendeztünk. Elméletileg ez felgyorsította volna minden lekérdezést, mert a kívánt SNP-adatoknak néhány Parquet-darabkában kellett volna lennie a megadott tartományon belül. Sajnos a már partikionált adatok rendezése is nehéz feladatnak bizonyult. Ennek eredményeként EMR-re váltottam egy testreszabott klaszter számára, és nyolc erős példányt (C5.4xl) használtam a Sparklyr segítségével egy rugalmasabb munkafolyamat létrehozásához…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…azonban a feladat így sem fejeződött be. Mindenféle módon beállítottam: növeltem a memóriaallokációt minden lekérdezés-végrehajtóhoz, nagyobb memória mennyiségű csomópontokat használtam, széles körű változókat (broadcasting variable) alkalmaztam, de ez mindig csak félig sikerült, és fokozatosan a végrehajtók elkezdtek összeomlani, míg minden le nem állt.
Frissítés: elkezdődött.
— Nick Strayer (@NicholasStrayer)
Találékonyabbá válok
Mit mire tanultam?: néha a különleges adatok különleges megoldásokat igényelnek.
Minden SNP-nek van egy pozícióértéke. Ez a szám felel meg az alapok számának, amelyek a kromoszómáján helyezkednek el. Ez egy jó és természetes módja az adataink szervezésének. Először azt akartam, hogy a kromoszómák területei szerint particionáljak. Például az 1–2000 pozíciókat, a 2001–4000-et, stb. De a probléma az, hogy az SNP-k a kromoszómákon egyenetlenül oszlanak el, így a csoportok mérete jelentősen eltérő lesz.
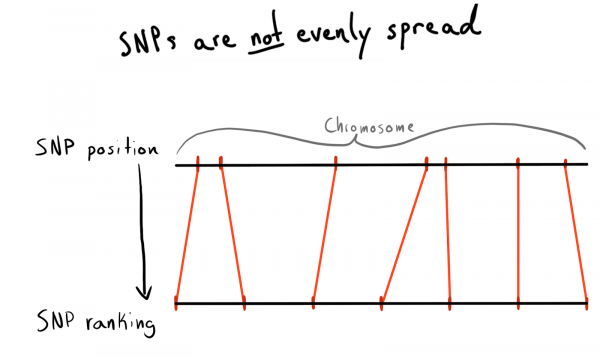
Ennek eredményeként a pozíciók kategóriák (rank) szerinti felosztásához jutottam. Az eddig betöltött adatokon futtattam egy lekérdezést, hogy megkapjam az egyedi SNP-k, azok pozíciói és kromoszómái listáját. Ezután az adatokat rendeztem minden kromoszómán belül, és az SNP-ket előre meghatározott méretű csoportokba (bin) gyűjtöttem. Mondjuk, 1000 SNP-t egy csoportba. Ez megadta nekem az SNP-k összefüggését a kromoszómában található csoportokkal.
Végül 75 SNP-ből álló csoportokat (bin) hoztam létre, az okot lentebb magyarázom.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Első kísérlet a Sparkkal
Mit mire tanultam?: a Sparkban végzett egyesítés gyors, de a partícionálás még mindig drága.
Olvasni akartam ezt a kis (2,5 millió soros) adatkeretet a Sparkban, egyesíteni a nyers adatokkal, majd partícionálni az újonnan hozzáadott oszlop szerint. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Használom sdf_broadcast(), így a Spark megtudja, hogy az adatkeretet minden csomópontnak el kell küldeni. Ez hasznos, ha az adatok kicsi méretűek és minden feladat számára szükségesek. Ellenkező esetben a Spark megpróbál okos lenni, és igény szerint osztja el az adatokat, ami lassulást okozhat.
És ismét a tervem nem működött: a feladatok egy ideig futottak, befejezték az egyesítést, majd, ahogy a partícionálás végrehajtói is, hibázni kezdtek.
Hozzáadom az AWK-t
Mit mire tanultam?: ne aludj, amikor az alapokat tanítják. Biztosan valaki már megoldotta a problémádat az 1980-as években.
Eddig minden Spark-al kapcsolatos kudarcom oka az adatok keveredése volt a klaszterben. Lehet, hogy a helyzet javítható az előfeldolgozással. Próbálkoztam azzal, hogy a nyers szöveges adatokat kromoszómák szerint oszlopokra bontom, így reméltem, hogy a Spark számára „előre partícionált” adatokat tudok biztosítani.
Keresgettem a StackOverflow-on, hogyan lehet oszlopértékek szerint felosztani, és találtam Az AWK segítségével oszthatja meg a szöveges fájlt az oszlopok értékei szerint, ha feljegyzést készít a szkripten, nem pedig a kimenetet küldi. stdout.
Kísérletként írtam egy Bash-szkriptet. Letöltöttem egy tömörített TSV fájlt, majd kicsomagoltam azt. gzip és elküldtem a. awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30" > "chunked/"$chr"_chr"$15".csv"}'
Ez működött!
Magok kitöltése
Mit mire tanultam?: gnu parallel — ez egy csodálatos dolog, mindenkinek használnia kell.
A felosztás elég lassan ment, és amikor elindítottam a glances, hogy ellenőrizzem egy erős (és drága) EC2 példány használatát, kiderült, hogy csak egy magot használok és körülbelül 200 MB memóriát. Ahhoz, hogy megoldjam a feladatot, és ne veszítsek el csomó pénzt, ki kellett találnom, hogyan párhuzamosítsam a munkát. Szerencsére egy teljesen lenyűgöző könyvben, Jeroen Janssens-től találtam egy fejezetet, amely a párhuzamosításról szólt. Ebből értesültem a gnu parallel, egy nagyon rugalmas módszer a több szálú végrehajtásra Unix alatt.
Amikor a felosztást az új folyamattal indítottam, minden csodás volt, de maradt egy szűk keresztmetszet — az S3 objektumok letöltése a lemezre nem volt túl gyors és nem volt teljesen párhuzamosítva. Ennek orvoslására a következőket tettem:
- Kiderítettem, hogy a S3 letöltési lépést közvetlenül a csővezetékbe integrálhatom, teljesen kizárva a köztes lemez tárolását. Ez azt jelenti, hogy elkerülhetem a nyers adatok lemezre írását, és még kisebb, tehát olcsóbb tárolót használhatok az AWS-on.
- A parancs
aws configure set default.s3.max_concurrent_requests 50nagyon megnövelte a szálak számát, amelyeket az AWS CLI használ (alapértelmezés szerint 10). - Gyorsabb hálózati példányra váltottam az EC2-n, névben az n betűvel. Megállapítottam, hogy a számítási kapacitás elvesztését az n példányok használatakor bőven kompenzálja a feltöltési sebesség növekedése. A legtöbb feladathoz c5n.4xl-t használtam.
- Kicseréltem a
gzipGyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata , ez egy gzip eszköz, amely elképesztő dolgokra képes az eredetileg nem párhuzamosított fájlok kicsomagolásának párhuzamosításában (ez segített a legkevésbé).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Ezeket a lépéseket összevonva mindez nagyon gyorsan működött. A letöltési sebesség növelésével és a lemezre írás elkerülésével most már 5 terabájtos csomagot tudtam feldolgozni mindössze néhány óra alatt.
Nincs édesebb annál, mint látni, hogy az AWS-en fizetett összes processzor mag használatban van. A gnu-parallel segítségével egy 19 gigabájtos csv fájlt olyan gyorsan tudok kibővíteni és felosztani, mint amilyen gyorsan letöltöm. Még a sparkot sem tudtam futtatni.
— Nick Strayer (@NicholasStrayer)
Ebben a tweetben említeni kellett volna a ‘TSV’-t. Sajnos.
Az újra feldolgozott adatok használata
Mit mire tanultam?: A Spark szereti a tömörítetlen adatokat, és nem szereti a partíciók kombinálását.
Most az adatok az S3-on tömörítetlen (értsd: elosztott) és félrendbe állított formátumban voltak, és újra visszatérhettem a Sparknak. Meglepetés ért: ismét nem sikerült elérni a kívántat! Nagyon nehéz volt pontosan megmondani a Sparknak, hogyan vannak particionálva az adatok. Még amikor ezt megtettem, kiderült, hogy túl sok partíció van (95 ezer), és amikor a coalesce segítségével csökkentettem őket ésszerű határokra, ez tönkretette a partícióimat. Biztos vagyok benne, hogy ez javítható, de néhány nap keresgélés után nem találtam megoldást. Végül mindent befejeztem a Sparkban, bár ez időbe telt, és az osztott Parquet fájljaim nem voltak túl kicsik (~200 Kb). Viszont az adatok ott voltak, ahol kellett.
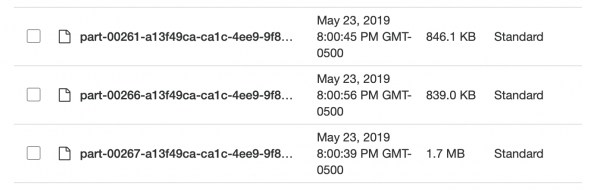
Túl kicsiek és eltérőek, csodás!
Helyi Spark lekérdezések tesztelése
Mit mire tanultam?: a Sparkban túl sok overhead van egyszerű feladatok megoldásakor.
Az adatok gondosan kidolgozott formátumba történő betöltésével tesztelhettem a sebességet. R-hez írtam egy szkriptet, hogy helyi Spark szervert indítsak, majd betöltöttem a Spark keretadatot a megadott Parquet csoport tárolóból (bin). Megpróbáltam betölteni az összes adatot, de nem tudtam rávenni a Sparklyr-t, hogy elismerje a partíciózást.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Időmérő indítása
start_time <- Sys.time()

# Betöltés a kívánt binbe a Sparkba
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Bin részhalmaz a snp és aztán gyűjtsük össze helyben
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
A végrehajtás 29,415 másodpercet vett igénybe. Sokkal jobb, de nem túl jó semmiféle tömeges teszteléshez. Ezen kívül nem tudtam felgyorsítani a munkát a gyorsítótárazással, mert amikor a keretadatokat próbáltam a memóriában gyorsítótárazni, a Spark mindig összeomlott, még akkor is, amikor több mint 50 Gb memóriát biztosítottam egy 15-nél kisebb adathalmazon.
Visszatérés az AWK-hoz
Mit mire tanultam?: az asszociatív tömbök az AWK-ban nagyon hatékonyak.
Tudtam, hogy gyorsabb sebességet érhetek el. Eszembe jutott, hogy a csodálatos Olvastam egy klassz funkcióról, ami "" néven ismert. Lényegében ez kulcs-érték párok, amelyeket valamiért az AWK másképpen nevezett, így túlságosan nem is gondoltam rájuk. emlékeztetett, hogy az "asszociatív tömbök" kifejezés jóval régebbi, mint a "kulcs-érték pár". Még ha , ezt a kifejezést nem fogja ott látni, viszont asszociatív tömböket talál! Ezenkívül a "kulcs-érték pár" általában az adatbázisokkal kapcsolatos, ezért logikusabb a hashmapre hasonlítani. Rájöttem, hogy ezeket az asszociatív tömböket fel tudom használni az SNP-m összekapcsolására a bin táblával és a nyers adatokkal, anélkül, hogy Sparkot használnék.
Ehhez az AWK-szkriptemben használtam a Kezdblokkot. Ez egy kód részlet, amely végrehajtódik, mielőtt az első adat sor a szkript fő részébe kerülne.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
A parancs while(getline...) betöltötte az összes sort a CSV csoportból (bin), az első oszlopot (SNP neve) kulcsként adta meg az asszociatív tömbhöz bin és a második értéket (csoport) az értékeként. Ezután a { }blokkban, amely minden fő fájl sorra vonatkozik, minden sor egy kimeneti fájlba kerül, amelynek egyedi neve a bin csoporttól függ: ..._bin_"bin[$1]"_....
Változók batch_num és chunk_id a csővezetéken benyújtott adatoknak megfelelően, ami elkerülte a versenyhelyzetet, és minden végrehajtási szál, amelyet parallel, saját egyedi fájljába írt.
Mivel az összes nyers adatot mappákba szórtam be, a kromoszómák szerint, amelyek a korábbi AWK-kísérletem után maradtak, most már tudtam írni egy másik Bash-szkriptet, amely kromoszómánként dolgozza fel, és S3-ba mélyebben partícionált adatokat szolgáltat.
DESIRED_CHR='13'

# Töltse le a kromoszóma adatokat az s3-ból és ossza fel bin-ekre
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'reading {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Kombinálja az összes párhuzamos feldolgozás töredékét egy fájlba, és töltsön fel az rds-be az R segítségével
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipping bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
A szkriptben két rész található parallel.
Az első szakaszban az összes fájlból, amely az adott kromoszóma információit tartalmazza, beolvassák az adatokat, majd ezeket a szálakra osztják, amelyek a fájlokat a megfelelő csoportokba (bin) helyezik. Annak érdekében, hogy elkerüljük a versenyhelyzetet, ahol több szál is egy fájlba ír, az AWK a fájlok nevével különböző helyekre biztosítja az adatok írását, például, chr_10_bin_52_batch_2_aa.csv. Ennek eredményeként a lemezen sok kis fájl jön létre (ehhez terabájtos EBS-meghajtókat használtam).
A második szakasz csővezetéke parallel csoportonként (bin) működik, és összegyűjti az elkülönített fájlokat egy közös CSV-be cat, majd exportálja őket.
Átkonvertálás R-be?
Mit mire tanultam?: lehetőség nyílik az . Ezek a 0, 1 és 2 számokat kapják. De most minket csak és stdout R-skripten keresztül való elérésére, tehát használható a csővezetékben is.
A Bash-szkriptedben észlelhetted a következő sort: ...cat chunked\*_bin_{}_*.csv | .\/upload_as_rds.R.... Ez az összes összefűzött fájlt a csoportból (bin) az alábbi R-skriptre irányítja. {} egy speciális technika parallel, amely bármely, általa adott adatszelektálást közvetlenül a parancsba szúrja be. Az opció {#} egyedi futási szálazonosítót biztosít, míg {%} a feladat slot számát képviseli (ismétlődik, de sosem egyszerre). Az összes opció listája megtalálható a
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Amikor a változó file("stdin") átadódik a readr::read_csv, az R-skripten keresztül átkonvertált adatok egy keretbe töltődnek be, amely később így .rds-fájlként az aws.s3 segítségével közvetlenül az S3-ba kerül.
Az RDS olyan, mint a Parquet egy egyszerűsített változata, a oszlopos tárolás finomságai nélkül.
Miután a Bash-szkript befejeződött, kaptam egy csomó .rds-fájlt az S3-ban, ami lehetővé tette számomra, hogy hatékony tömörítést és beépített típusokat használjak.
A lassú R ellenére minden nagyon gyorsan működött. Nem meglepő, hogy az R-re írt adatok olvasásáért és írásáért felelős darabok jól optimalizáltak. Egy közepes méretű kromoszómán végzett tesztelés után a feladat körülbelül két órán belül befejeződött a C5n.4xl példányon.
S3 korlátai
Mit mire tanultam?: a S3 intelligens útvonal-implementálásának köszönhetően sok fájlt tud kezelni.
Aggódtam, hogy a S3 képes lesz-e kezelni a neki átadott sok fájlt. Lehetett volna értelemmel elnevezni a fájlokat, de hogyan fog a S3 keresni rajtuk?
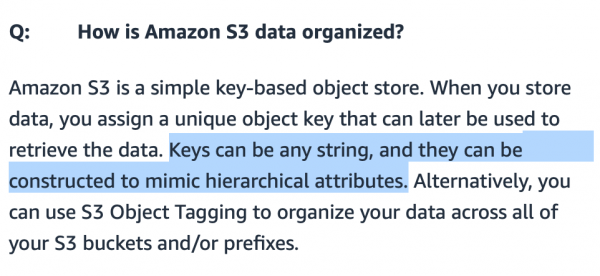
A mappák az S3-ban csupán díszítőelemek, a rendszer valójában nem érdekli a szimbólum. /.
Úgy tűnik, hogy az S3 egy egyszerű kulcsként képviseli a fájlok elérési útját egy egyfajta hash-táblában vagy dokumentumalapú adatbázisban. A bucket-et (tárolót) táblázatnak tekinthetjük, míg a fájlok a táblázat rekordjait jelentik.
Mivel a sebesség és a hatékonyság fontos a nyereség eléréséhez az Amazonnál, nem meglepő, hogy ez a „kulcs-út-fájlhoz” rendszer elképesztően optimalizált. Próbáltam megtalálni az egyensúlyt: úgy, hogy ne kelljen sok get-kérést küldeni, ugyanakkor a kérések gyorsan végrehajtódjanak. Kiderült, hogy a legjobb körülbelül 20 ezer bin fájl létrehozása. Úgy gondolom, ha tovább optimalizálom, akkor javítható a sebesség (például egy speciális tároló létrehozásával az adatokhoz, így csökkentve a keresési táblázat méretét). De már nem volt időm és pénzem a további kísérletekre.
Mi a helyzet a keresztkompatibilitással?
Amit megtanultam: a legfőbb időveszteséget okozó ok a tárolási módszeretek korai optimalizálása.
Ebben a pillanatban nagyon fontos megkérdezni magunktól: "Miért használjunk zárt fájlformátumot?" Az ok a betöltési sebességben rejlik (a tömörített gzip CSV fájlok 7-szer lassabban töltődtek be), és a munkafolyamatainkkal való kompatibilitásban. Meg tudom fontolni a döntésemet, ha az R könnyedén be tudja tölteni a Parquet (vagy Arrow) fájlokat Spark terhe nélkül. A laboratóriumunkban mindenki R-t használ, és ha az adataimat más formátumba kell átkonvertálnom, akkor még mindig megmaradnak az eredeti szöveges adataim, így egyszerűen újra futtathatom a csövet.
A munka megosztása
Mit mire tanultam?: ne próbáld meg kézzel optimalizálni a feladatokat, ezt hagyd a számítógépnek.
Egy kromoszóma munkafolyamatát hibakereséssel optimalizáltam, most mindegyik további adatot kell feldolgoznom.
Szerettem volna néhány EC2 példányt indítani a konvertáláshoz, de ugyanakkor féltem, hogy rendkívül kiegyensúlyozatlan terhelést kapok a különböző feldolgozó feladatokban (ahogyan a Spark is szenvedett a kiegyensúlyozatlan partícióktól). Ezen kívül nem akartam egyetlen példányt indítani minden kromoszómához, mert az AWS fiókoknak van egy alapértelmezett korlátja, amely 10 példányra vonatkozik.
Így aztán úgy döntöttem, hogy írok egy R szkriptet a feldolgozó feladatok optimalizálására.
Először azt kértem az S3-tól, hogy számolja ki, mennyi helyet foglal el a tárolóban minden kromoszóma.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9)


# A tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … with 17 more rows
Ezután írtam egy függvényt, amely megkapja a teljes méretet, megkeveri a kromoszómák sorrendjét, és csoportokba osztja őket. num_jobs és jelzi, mennyire eltérnek a feldolgozási feladatok méretei.
num_jobs <- 7
# Mekkora lenne minden feladat, ha tökéletesen szétosztanánk?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# A tibble: 1 x 2
     sd data

1  153.
Azután ezer keverést futtattam a purrr segítségével, és kiválasztottam a legjobbat.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Így kaptam egy nagyon hasonló méretű feladatkészletet. Aztán már csak annyit kellett tennem, hogy a korábbi Bash-scriptet egy nagy ciklusba csomagoltam. for. Erre az optimalizációra körülbelül 10 percet szántam. Ez sokkal kevesebb, mint amit a feladatok manuális létrehozására fordítottam volna, ha azok nem lennének kiegyensúlyozottak. Ezért úgy gondolom, hogy ezzel az előzetes optimalizálással nem hibáztam.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Kód egyetlen kromoszóma feldolgozására
fi
A végén hozzáadom a leállító parancsot:
sudo shutdown -h now … és minden működött! Az AWS CLI segítségével indítottam az instance-eket, és az user_data opcióval átadtam nekik a feldolgozási feladatok Bash-scriptjeit. Ezek végrehajtódtak és automatikusan leálltak, így nem kellett többletköltséget fizetnem a számítási teljesítményért.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Csomagoljuk!
Mit mire tanultam?: Az API-nak egyszerűnek kell lennie az egyszerűsítés és a használat rugalmassága érdekében.
Végre megkaptam az adatokat a megfelelő helyen és formában. Csak annyit kellett tennem, hogy maximálisan leegyszerűsítsem az adatok felhasználásának folyamatát, hogy a kollégáimnak könnyebb legyen. Egy egyszerű API-t szerettem volna létrehozni a lekérdezésekhez. Ha a jövőben úgy döntök, hogy áttérek a .rds A Parquet fájlok esetén ez nekem, nem pedig a kollégáimnak kellene problémát jelentenie. Éppen ezért úgy döntöttem, hogy készítek egy belső R csomagot.
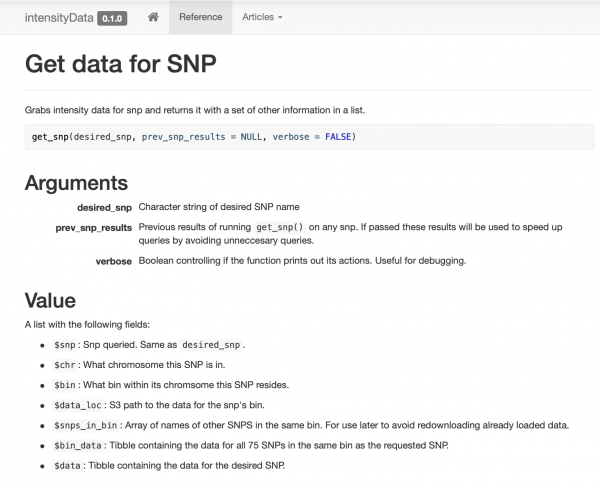
Összeállítottam és dokumentáltam egy nagyon egyszerű csomagot, amely néhány funkciót tartalmaz az adatok eléréséhez, középpontjában a funkcióval get_snp. Ezen kívül készítettem a kollégáimnak egy weboldalt , hogy könnyen megtekinthessék a példákat és a dokumentációt.
Intelligens gyorsítótárazás
Mit mire tanultam?: ha az adataid jól fel vannak készítve, a gyorsítótárazás könnyű lesz!
Mivel az egyik alapvető munkafolyamat ugyanazt az elemző modellt alkalmazta az SNP csomagon, úgy döntöttem, hogy a csoportosítást (binning) a saját hasznomra fordítom. Az SNP-n keresztül az adatok átadásakor a visszaadott objektumhoz csatolódik az egész csoport (bin) információja. Ez azt jelenti, hogy a régi lekérdezések elméletileg felgyorsíthatják az új lekérdezések feldolgozását.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
A csomag összeállítása során sok benchmarkot futtattam, hogy összehasonlítsam a sebességet különböző módszerek használatával. Javaslom, hogy ne hanyagoljátok el ezt, mert néha a végeredmények meglepőek lehetnek. Például, dplyr::filter sokkal gyorsabbnak bizonyult, mint a sorok indexelés alapú szűrése, és egy oszlop lekérése az szűrt adatkeretből sokkal gyorsabban működött, mint az indexelési szintaxis alkalmazása.
Ne feledd, hogy az objektum prev_snp_results tartalmaz egy kulcsot snps_in_bin. Ez egy összes egyedi SNP-t tartalmazó tömb a csoportban (bin), amely lehetővé teszi, hogy gyorsan ellenőrizzük, van-e már adat a korábbi lekérdezésből. Ez megkönnyíti az összes SNP ciklikus átfutását a csoportban (bin) ezzel a kóddal:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Eredmények
Most már komolyan indíthatjuk a modelleket és a forgatókönyveket, amelyek korábban elérhetetlenek voltak számunkra. A legjobb, hogy a laboratóriumi kollégáimnak nem kell a bonyodalmakon agyalniuk. Csak van egy működő funkciójuk.
Bár a csomag megkíméli őket a részletektől, igyekeztem a dátumformátumot elég egyszerűvé tenni, hogy értsenek hozzá, ha holnap hirtelen eltűnnék…
A sebesség jelentősen megnőtt. Általában funkcionálisan jelentős genomfragmentsorokat szkennelünk. Korábban ezt nem tudtuk megtenni (túl drága volt), de most, a csoportos (bin) struktúrának és a gyorsítótárazásnak köszönhetően egy SNP lekérdezésére átlagosan kevesebb mint 0,1 másodperc szükséges, és az adatok használata annyira alacsony, hogy az S3 költségei aprópénznek számítanak.
Nemrégiben felelős lettem több mint 25 TB nyers genotipizálási adat kezelése érdekében a laboromban. Amikor elkezdtem, a spark használata 8 percet vett igénybe és 20 dollárba került egy SNP lekérdezése. Miután AWK-t használtam + a feldolgozásra, most kevesebb mint 1 tized másodpercig tart és 0,00001 dollárba kerül. Személyes győzelem.
— Nick Strayer (@NicholasStrayer)
Zárás
Ez a cikk – nem egy útmutató. A megoldás egyedi lett, és szinte biztosan nem optimális. Inkább mesélni szeretnék az útról. Azt akarom, hogy mások megértsék, hogy az ilyen megoldások nem teljesen átgondoltan jönnek létre; ezek a próbák és hibák eredményei. Ezenkívül ha adat-elemző szakembert keres, vegye figyelembe, hogy ezen eszközök hatékony használatához tapasztalat szükséges, és a tapasztalat pénzt igényel. Boldog vagyok, hogy volt pénzem erre, de sok más ember, aki meg tudná csinálni ugyanezt jobban, sosem találhatna lehetőséget a pénzhiány miatt, hogy legalább a próbát megtehesse.
A nagyadatok eszközei univerzálisak. Ha van időd, szinte biztosan írhatsz egy gyorsabb megoldást, alkalmazva az 'okos' adat-tisztítást, tárhelyet és módszereket. Végső soron minden a költségek és az előnyök elemzésére redukálódik.
Amit tanultam:
- nincs olcsó módja 25 TB egyszerre történő feldolgozásának;
- legyél óvatos a Parquet fájljaid méretével és szervezésével;
- a Spark partícióinak egyensúlyban kell lenniük;
- soha ne próbálj meg 2,5 millió partíciót csinálni;
- a rendezés továbbra is nehézkes, akárcsak a Spark beállítása;
- néha a különleges adatok különleges megoldásokat igényelnek;
- a Sparkban a csatlakozás gyorsan működik, de a particionálás továbbra is drága;
- ne aludj, amikor az alapokat tanítják, valószínűleg valaki már megoldotta a problémádat az 1980-as években;
gnu parallelez egy varázslatos dolog, mindenkinek használni kellene;- a Spark szereti a tömörítetlen adatokat, és nem szereti a partíciók kombinálását;
- a Sparkban túl sok a költség a egyszerű feladatok megoldása során;
- az asszociatív tömbök az AWK-ban nagyon hatékonyak;
- lehetőség van arra, hogy
. Ezek a 0, 1 és 2 számokat kapják. De most minket csakésstdoutR-szkriptekből érjünk el, így felhasználhatjuk azt a folyamatban; - a S3 intelligens útvonalmegvalósítása miatt sok fájlt tud feldolgozni;
- a legfőbb időveszteség oka a tárolási módszered korai optimalizálása;
- ne próbáld manuálisan optimalizálni a feladatokat, bízd ezt a számítógépre;
- az API-nak egyszerűnek kell lennie az egyszerűség és a használat rugalmassága érdekében;
- ha az adataid jól elő vannak készítve, a gyorsítótárazás egyszerű lesz!
Forrás: habr.com
