

A Patroni fő célja a PostgreSQL magas rendelkezésre állásának biztosítása. De a Patroni csupán egy sablon, nem kész eszköz (ahogy azt a dokumentáció is mondja). Első pillantásra, ha a Patronit egy tesztlaborban beállítjuk, láthatjuk, hogy ez egy remek eszköz, és mennyire könnyedén kezeli a klaszterünk felbomlására tett kísérleteinket. Azonban a gyakorlatban, a termelési környezetben, nem mindig minden olyan szép és elegáns, mint a tesztlaborban.
Mesélek egy kicsit magamról. Rendszergazdaként kezdtem. Dolgoztam webfejlesztésben. 2014 óta a Data Egret-nél dolgozom. A cég a Postgres területén nyújt tanácsadást. Kizárólag Postgresszel foglalkozunk, és minden nap dolgozunk Postgresszel, így különféle tapasztalataink vannak az üzemeltetéssel kapcsolatban.
2018 végén lassan elkezdtük használni a Patronit. És felhalmozódott egy bizonyos tapasztalat. Valahogy diagnosztizáltuk, finomhangoltuk, formáltuk a legjobb gyakorlati eredményeinket. Erről a beszámolóban fogok beszélni.
A Postgres mellett szeretem a Linuxot. Szeretek benne turkálni és felfedezni, szeretek kernelt építeni. Érdekel a virtualizáció, a konténerek, a Docker, a Kubernetes. Mindez érdekel, mert a régi adminisztrátori szokások hatással vannak rám. Szeretek foglalkozni a monitorozással. És szeretem a Postgresszel kapcsolatos adminisztratív feladatokat, mint például a replikáció és a biztonsági másolat készítése. Szabadidőmben Go nyelven írok. Nem vagyok szoftverfejlesztő, csak saját magamnak írok Go-ban. Ez örömet okoz számomra.
- Azt hiszem, sokan tudjátok, hogy a Postgresben nincsenek alapértelmezett magas rendelkezésre állású (HA) megoldások. A magas rendelkezésre álláshoz valamit telepíteni, beállítani, erőfeszítéseket kell tenni.
- Számos eszköz létezik, és a Patroni ezek egyike, amely meglehetősen jól megoldja a magas rendelkezésre állás kérdését. De ha mindezt egy tesztlaborban telepítjük és elindítjuk, láthatjuk, hogy minden működik, reprodukálhatunk problémákat, és megnézhetjük, hogyan kezeli ezeket a Patroni. És látni fogjuk, hogy mindez remekül működik.
- De a gyakorlatban különböző problémákkal szembesültünk. Ezekről a problémákról fogok beszélni.
- Elmondom, hogyan diagnosztizáltuk ezeket, mit állítottunk be – segített-e nekünk ez vagy sem.
- Nem fogom elmondani, hogyan kell telepíteni a Patronit, mert ezt könnyen lehet guglizni az interneten, lehet nézni a konfigurációs fájlokat, hogy megértsük, hogyan indul el, hogyan állítható be. Ki lehet ismerni a sémákat, architektúrákat, információt találva róluk az interneten.
- Nem fogok mások tapasztalatairól beszélni. Csak azokról a problémákról fogok beszélni, amelyekkel kifejezetten mi szembesültünk.
- És nem fogok a Patronin és a PostgreSQL-en kívüli problémákról beszélni. Ha például olyan problémák merülnek fel, amelyek a terheléselosztással kapcsolatosak, amikor a klaszterünk szétesett, erről nem fogok beszélni.
És egy kis nyilatkozat azelőtt, hogy elkezdeném az előadásunkat.
Mindezek a problémák, amelyekkel szembesültünk, az első 6-7-8 hónapban jelentkeztek a használat során. Idővel eljutottunk a belső legjobb gyakorlati megoldásainkhoz, és a problémáink eltűntek. Így az előadás fél évvel ezelőtt került bejelentésre, amikor még frissek voltak az emlékek és jól emlékeztem mindenre.
Az előadás előkészítése során már néztem régi posztmortemeket, megvizsgáltam a naplókat. És előfordulhat, hogy egyes részletek elfelejtődtek, vagy bizonyos információs részletek nem lettek teljesen feltárva a problémák elemzése során, ezért egyes pontokban úgy tűnhet, hogy a problémák nem teljesen lettek átbeszélve, vagy hiányos az információ. Ezért elnézést kérek emiatt.
Mi az a Patroni?
- Ez egy sablon a HA kialakításához. Így van megfogalmazva a dokumentációban. És a véleményem szerint ez egy nagyon helyes pontosítás. A Patroni nem egy ezüst lövedék, amely megoldja az összes problémáját, tehát erőfeszítéseket kell tenni, hogy elkezdjen működni és hasznot hozzon.
- Ez egy ügynöki szolgáltatás, amelyet minden adatbázissal rendelkező szolgáltatásra telepítenek, és amely egyfajta init-rendszer a PostgreSQL-jéhez. Indítja a PostgreSQL-t, leállítja, újraindítja, módosítja a konfigurációt és megváltoztatja a klaszter topológiáját.
- Ezért a klaszter állapotának, aktuális megjelenítésének tárolásához szükség van egy tárolóra. És ebből a szempontból a Patroni a külső rendszerben történő állapotmegőrzés felé indult el. Ez egy konfigurációs tároló rendszer. Ez lehet Etcd, Consul, ZooKeeper, vagy akár a Kubernetes Etcd-je, tehát ezek közül valamelyik lehetőség.
- A Patroni egyik jellemzője, hogy az automatikus failover azonnal rendelkezésre áll, miután megfelelően konfiguráltuk. Ha összehasonlítjuk a Repmgr-t, ott a failover funkció benne van a csomagban. A Repmgr-rel átváltást kapunk, de ha automatikus failover-t szeretnénk, azt külön kell beállítanunk. A Patroni már eleve tartalmaz automatikus failover-t.
- És sok más dolog is van. Például a konfigurációk karbantartása, új replikák beállítása, biztonsági mentés stb. De ez már nem a téma része, erről nem fogok beszélni.
Összefoglalva, a Patroni fő feladata, hogy jól és megbízhatóan végezze el az automatikus failover-t, hogy a klaszterünk működőképes maradjon, és az alkalmazás ne érzékelje a klaszter topológiai változásait.
De amikor elkezdjük használni a Patroni-t, a rendszerünk kissé bonyolultabbá válik. Míg korábban csak a Postgres-szel dolgoztunk, a Patroni használatával megkapjuk magát a Patroni-t, és egy DCS-t, amely tárolja az állapotot. Mindezeknek valahogy működniük kell. Tehát mi rosszul működhet?
A következők hibásodhatnak meg:
- A Postgres meghibásodhat. Ez lehet a mester vagy a replika, bármelyikük cserbenhagyhat.
- Maga a Patroni is meghibásodhat.
- A DCS, ahol az állapotot tároljuk, is meghibásodhat.
- És a hálózat is meghibásodhat.
Ezeket a szempontokat fogom részletezni az előadásomban.
Az eseteket a bonyolultságuk szerint fogom tárgyalni, nemcsak abból a szempontból, hogy mennyi összetevőt érintenek, hanem abból a szempontból is, hogy személy szerint én mennyire éreztem nehéznek az egyes eseteket, és éppen ellenkezőleg, volt-e olyan eset, ami könnyű volt és könnyen elemezhető.
Az első eset a legegyszerűbb. Ez az a helyzet, amikor egy adatbázis klasztert vettünk, és ugyanazon a klaszteren telepítettük a DCS tárolónkat. Ez a leggyakoribb hiba. Ez az architektúrák építésének hibája, vagyis különböző összetevők összekapcsolása egy helyen.
Tehát, ha történt egy failover, nézzük meg, mi történt.
Itt az érdekel minket, mikor történt a failover. Vagyis azt a pillanatot figyeljük, amikor az állapotváltozás zajlott.
De a failover nem mindig egy pillanat alatt történik, vagyis nem tart egy egységnyi időt, elhúzódhat. Hosszú ideig eltarthat.
Ezért van kezdési és befejezési időpontja, tehát ez egy hosszú távú esemény. Az eseményeket három időszakra osztjuk: van időnk a failover előtt, a failover alatt és a failover után. Vagyis minden eseményt ezen az idővonalon vizsgálunk.
Az első lépés, amikor bekövetkezik a failover, az, hogy megkeressük az okot, mi történt, ami a failoverhez vezetett.
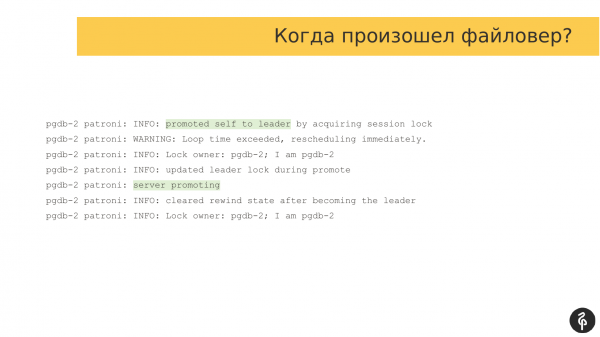
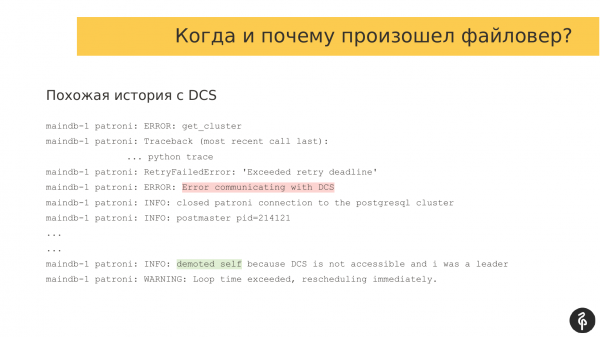
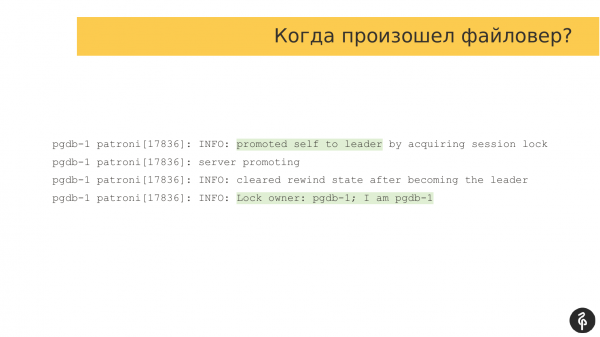
Ha megnézzük a naplókat, akkor tipikus Patroni naplókat látunk. Ezekben értesít minket, hogy a szerver mesterré vált, és a mester szerepe átkerült erre a csomóra. Ez ki van emelve.
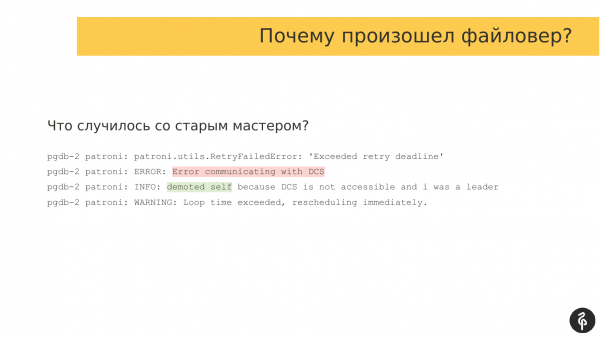
Továbbá meg kell értenünk, miért történt a failover, vagyis milyen események zajlottak, amelyek miatt a mester szerepe átkerült az egyik csomóról a másikra. És ebben az esetben minden egyszerű. Van egy kommunikációs hiba a tárolórendszerrel. A mester rájött, hogy nem tud együttműködni a DCS-sel, tehát valamilyen probléma merült fel a kommunikációval. Azt mondja, hogy nem lehet többé mester, és lemond a hatalmáról. Ez a "demoted self" sor pontosan erről szól.
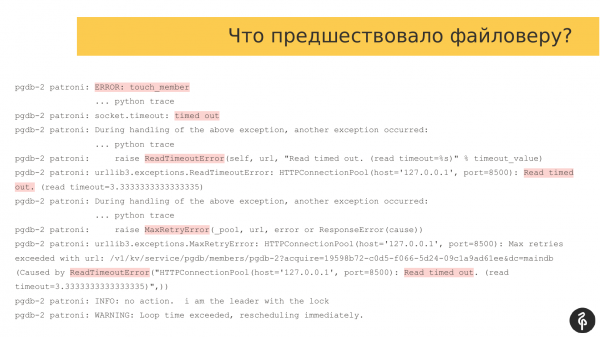
Ha megnézzük a failover előtti eseményeket, láthatjuk azokat az okokat, amelyek problémát okoztak a mester további működésében.
Ha megnézzük a Patroni naplókat, rengeteg különféle hibát, időtúllépést észlelünk, vagyis a Patroni ügynök nem tud együttműködni a DCS-sel. Ebben az esetben ez a Consul ügynök, amellyel a 8500-as porton kommunikálunk.
A probléma itt az, hogy a Patroni és az adatbázis ugyanazon a hoszton fut. Ezen a csomón Consul kiszolgálók is futottak. A szerveren lévő terhelés létrehozásával problémákat okoztunk a szerverek Consulnak. Nem tudtak normálisan kommunikálni.
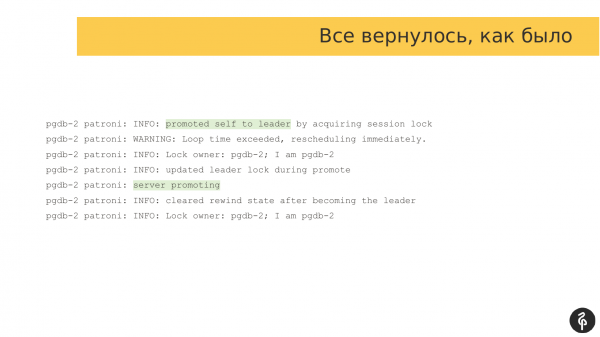
Egy idő után, amikor a terhelés csökkent, a Patroni újra tudott kommunikálni az ügynökökkel. A normális működés helyreállt. Ugyanaz a Pgdb-2 szerver ismét mester lett. Vagyis volt egy kis átlépés, ami miatt a csomó lemondott a mester jogköréről, majd visszavette azt, tehát minden úgy tért vissza, ahogyan volt.
Ez értelmezhető hamis riasztásként, vagy úgy is fel lehet fogni, hogy a Patroni mindent helyesen tett. Vagyis rájött, hogy nem tudja fenntartani a klaszter állapotát, és lemondott a hatalmáról.
És itt a probléma abból fakad, hogy a Consul szerverek azon a hardveren találhatók, amin az adatbázisok is futnak. Ennek következtében bármilyen terhelés: legyen az a lemezekre vagy a processzorokra vonatkozó terhelés, szintén hatással van a Consul klaszterre való interakcióra.
És úgy döntöttünk, hogy ennek nem szabad együtt élnie, létrehoztunk egy külön klasztert a Consul számára. A Patroni már egy külön Consul-lal működött, azaz volt egy külön Postgres klaszter, külön Consul klaszter. Ez egy alapvető útmutató, hogyan kell ezeket a dolgokat elkülöníteni és karbantartani, hogy ne éljenek együtt.
Alternatív megoldásként lehetőség van a ttl, loop_wait, retry_timeout paraméterek állítgatására, azaz megpróbálni a terhelési csúcsokat ezek növelésével átvészelni. De ez nem a legmegfelelőbb megoldás, mert a terhelés hosszú távú is lehet. Esetleg túlléphetünk ezeknek a paramétereknek a korlátain, és ez nem biztos, hogy segít.
Az első probléma, ahogy látjátok, egyszerű. Összevonva a DCS-t az adatbázissal, problémát kaptunk.
A második probléma hasonló az elsőhöz. Az a hasonlósága, hogy ismét problémák merülnek fel a DCS rendszerrel való interakció során.
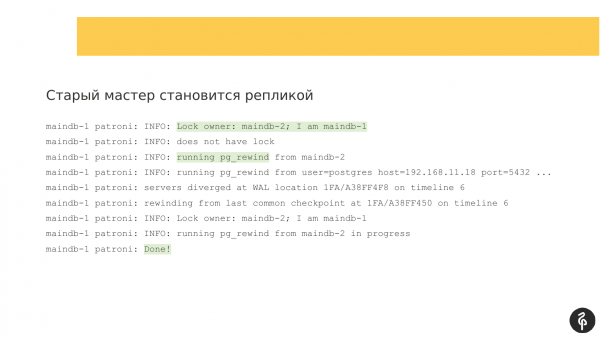
Ha megnézzük a naplókat, látni fogjuk, hogy újra kommunikációs hiba lépett fel. A Patroni azt mondja, hogy nem tud kapcsolatba lépni a DCS-sel, ezért a jelenlegi mester átvált replikáló üzemmódba.
A régi mester replikává válik, itt a Patroni úgy működik, ahogy kell. Elindítja a pg_rewind-ot, hogy visszatekerje a tranzakciós naplót, majd csatlakozik az új mesterhez, és felzárkózik az új mesterhez. Itt a Patroni úgy működik, ahogy elvárható tőle.
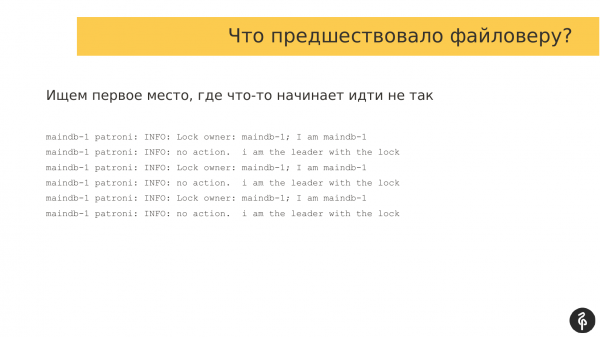
Itt meg kell találnunk azt a helyet, ami megelőzte a fájlleíró hibáját, azaz azokat a hibákat, amelyek oka volt a fájlleíró hiba bekövetkezésének. Ebben a vonatkozásban a Patroni naplóival viszonylag könnyű dolgozni. Egy meghatározott időközönként írja ugyanazokat az üzeneteket. Ha elkezdjük gyorsan görgetni ezeket a naplókat, akkor a naplók változása azt mutatja, hogy valamilyen probléma kezdődött. Gyorsan visszatérünk arra a pontra, és megnézzük, mi történik.
Normál esetben a naplók körülbelül így néznek ki. Ellenőrzésre kerül a zárolás tulajdonosa. És ha a tulajdonos, mondjuk, megváltozott, akkor olyan események következhetnek be, amelyekre a Patroninak reagálnia kell. De ebben az esetben minden rendben van. Megkeressük azt a helyet, ahol a hibák kezdődtek.
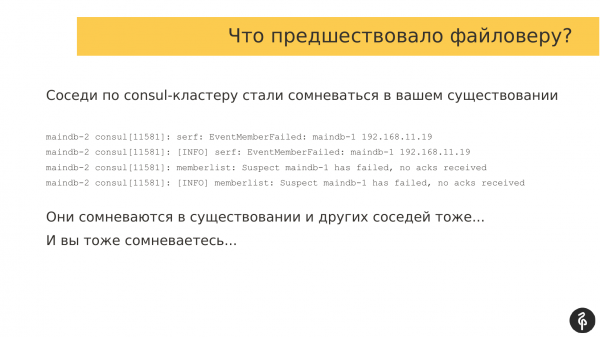
Ha a hibaüzenetek megjelenéséhez vezető helyre görgetünk, azt látjuk, hogy automatikus failover történt. Mivel a hibáink a DCS-sel kapcsolatos interakciókkal függtek össze, és mi Consul-t használtunk, a Consul naplóit is ellenőrizzük, hogy mi történt ott.
A failover időpontját és a Consul naplók időpontját összehasonlítva azt látjuk, hogy a Consul klaszterünk szomszédai elkezdtek kételkedni a többi Consul klaszter tagjának létezésében.
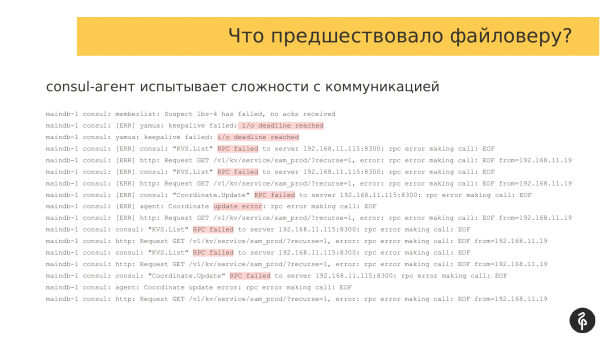
Ha megnézzük más Consul ügynökök naplóit, ott is látszik, hogy valamilyen hálózati összeomlás zajlik. Minden Consul klaszter tag kételkedik egymás létezésében, ami a failover kiváltó oka lett.
Ha megnézzük, mi történt a hibák előtt, láthatjuk, hogy különféle hibák, például határidő (deadline), RPC hiba merültek fel, ami világosan mutatja, hogy valamilyen probléma van a Consul klaszter tagjai közötti interakcióban.
A legegyszerűbb válasz az, hogy javítjuk a hálózatot. De számomra, állva a tribünön, könnyű erről beszélni. A körülmények úgy alakulnak, hogy nem mindig a megrendelő engedheti meg magának a hálózat javítását. Előfordulhat, hogy adatközpontban él, és nem rendelkezik a hálózat vagy berendezések javításához szükséges lehetőségekkel. Ezért szükség van más megoldásokra.
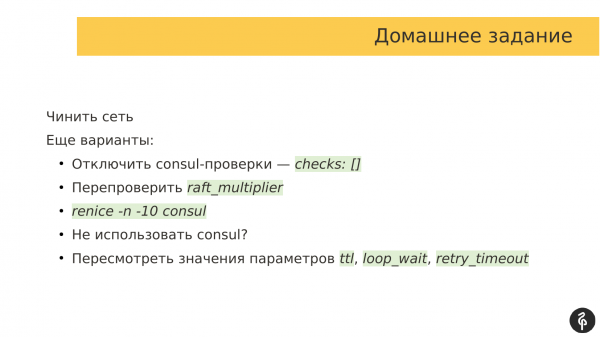
Vannak lehetőségek:
- A legegyszerűbb megoldás, amelyet a dokumentációban is írtak, az, hogy letiltjuk a Consul ellenőrzéseit, azaz egyszerűen egy üres tömböt adunk át. A Consul ügynöknek azt mondjuk, hogy ne használjon semmiféle ellenőrzést. Ezeknek az ellenőrzéseknek a kihagyásával figyelmen kívül hagyhatjuk ezeket a hálózati viharokat, és nem indítunk failovert.
- Egy másik lehetőség a raft_multiplier újraellenőrzése. Ez a Consul szerver saját paramétere. Alapértelmezés szerint 5 értékre van állítva. Ez az érték a dokumentáció szerint a staging környezetekre ajánlott. Valójában ez befolyásolja az üzenetek csere gyakoriságát a Consul hálózat tagjai között. E paraméter hatással van a szolgáltató közötti kommunikáció sebességére a Consul klaszter tagjaival. Termelési környezet esetén ajánlott csökkenteni ezt, hogy a csomópontok gyakrabban cseréljenek üzeneteket.
- Egy másik megoldás, amit elkezdtünk alkalmazni, az a Consul folyamatok prioritásának növelése a többi folyamat között az operációs rendszer folyamattervezője számára. Van egy "nice" nevű paraméter, amely pontosan meghatározza a folyamatok prioritását, amelyet az operációs rendszer tervezője figyelembe vesz a tervezés során. Mi csökkentettük a Consul-ügynökök nice értékét, tehát növeltük a prioritást, hogy az operációs rendszer több időt biztosítson a Consul folyamatok számára a munka végzésére és a kód végrehajtására. Esetünkben ez megoldotta a problémánkat.
- Egy másik lehetőség, hogy ne használjuk a Consult. Van egy ismerősöm, aki nagy támogatója az Etcd-nek. Rendszeresen vitatkozunk arról, hogy mi a jobb, az Etcd vagy a Consul. De abban a szempontból, hogy mi a jobb, általában abban az álláspontban osztozunk, hogy a Consulnak van egy ügynöke, amelynek minden egyes csomóponton futnia kell az adatbázissal. Ezért a Patroni és a Consul klaszter közötti interakció ezen az ügynökön keresztül történik. Ez az ügynök válik a szűk keresztmetszetté. Ha valami történik az ügynökkel, a Patroni már nem tud kapcsolatba lépni a Consul klaszterrel. Ez problémát jelent. Az Etcd-nek ezzel szemben nincs ügynöke. A Patroni közvetlenül tud dolgozni az Etcd szerverek listájával, és már kapcsolatba lépni velük. Ezért, ha az Ön cégénél az Etcd-t használja, akkor ez valószínűleg jobb választás, mint a Consul. De nálunk az ügyfelek által választott és használt megoldások korlátoznak minket. A legtöbb ügyfelünknél a Consul van.
- Az utolsó pont a paraméterek értékeinek felülvizsgálata. Növelhetjük ezeket az értékeket abban a reményben, hogy a rövid távú hálózati problémáink rövidek lesznek, és nem esnek az ezen paraméterek intervallumába. Így csökkenthetjük a Patroni agresszivitását az automatikus failover végrehajtásakor, ha valamilyen hálózati probléma merül fel.
Azt hiszem, sokan, akik használják a Patronit, ismerik ezt a parancsot.
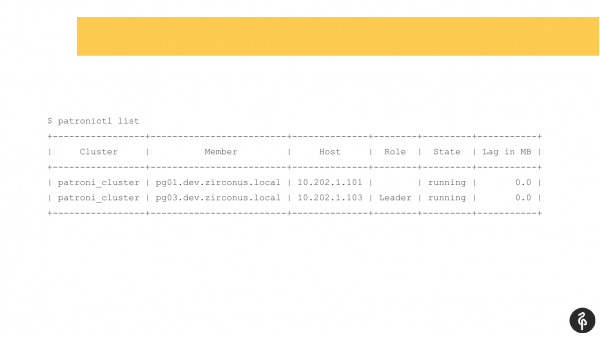
Ez a parancs megmutatja a klaszter aktuális állapotát. Első pillantásra ez a kép normálisnak tűnhet. Van egy mester, van egy replikánk, nincs replikációs késés. De ez a kép pontosan addig normális, amíg nem tudjuk, hogy ennek a klaszternek három csomópontnak kell lennie, nem kettőnek.
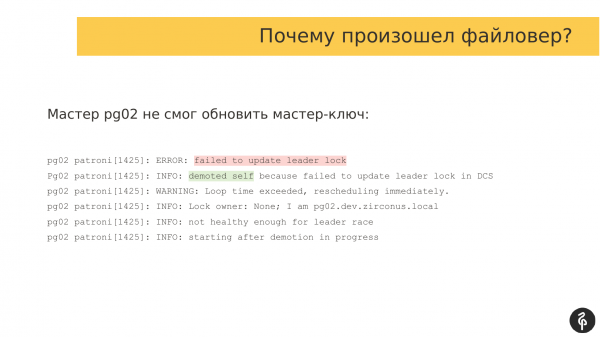
Ezért automatikus átváltás történt. Az automatikus átváltás után pedig a replikánk eltűnt. Meg kell állapítanunk, miért tűnt el, és vissza kell hoznunk. Ismét megnézzük a naplókat, hogy mi történt az automatikus átváltás során.
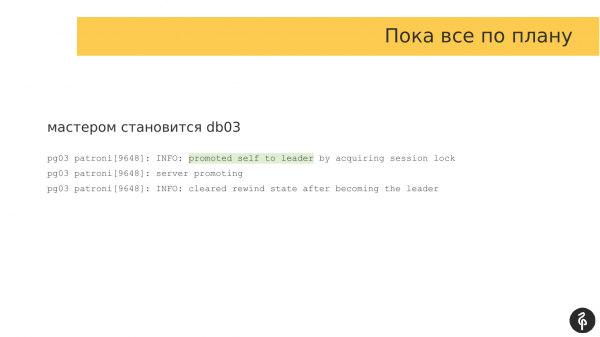
Ebben az esetben a második replikából lett a mester. Itt minden rendben van.
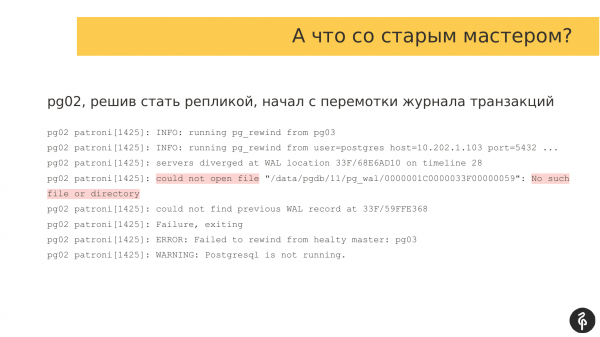
Már a replikával kell foglalkoznunk, amelyik kiesett, és amelyik nem része a klaszternek. Megnyitjuk a Patroni naplókat, és megnézzük, hogy a klaszterhez kapcsolódás során probléma lépett fel a pg_rewind szakaszában. A klaszterhez való csatlakozáshoz vissza kell tekernünk a tranzakciós naplót, a szükséges tranzakciós naplót a mestertől kérni, és az alapján utolérni a mestert.
Ebben az esetben nem áll rendelkezésre tranzakciós napló, és a replikát nem lehet elindítani. Ezért a Postgres leáll, hibával. És ezért nincs jelen a klaszterben.
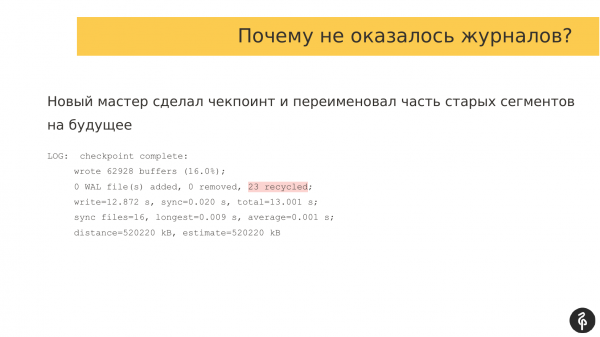
Meg kell értenünk, miért nincs jelen a klaszterben, és miért nem voltak naplók. Megyünk az új mesterhez, és megnézzük, mit látunk a naplókban. Kiderül, hogy amíg a pg_rewind-ot végezték, checkpoint történt. És a régi tranzakciós naplók egy része egyszerűen át lett nevezve. Amikor a régi mester megpróbált csatlakozni az új mesterhez, és kérni ezeket a naplókat, azok már át voltak nevezve, egyszerűen nem voltak ott.
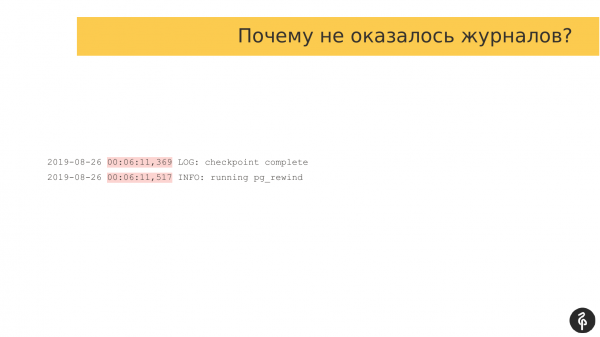
Összehasonlítottam az események időbélyegeit. És a különbség mindössze 150 milliszekundum, azaz a checkpoint 369 milliszekundum alatt befejeződött, a WAL-szegmensek átnevezésre kerültek. És mindössze 517 milliszekundummal később, 150 milliszekundum múlva elindult a rewind a régi replikán. Azaz mindössze 150 milliszekundum elegendő volt ahhoz, hogy a replika ne tudjon csatlakozni és működni.
Milyen lehetőségek vannak?
Kezdetben replikációs slotokat használtunk. Jónak tűnt. Bár az első üzemelési szakaszban a slotokat kikapcsoltuk. Úgy tűnt, ha a slotok sok WAL-szegmenst halmoznak fel, akkor a mestert le tudjuk állítani. Az összeomlik. Egy ideig szenvedtünk slotok nélkül. Majd rájöttünk, hogy a slotok szükségesek, így visszaállítottuk őket.
De van egy probléma, hogy amikor a mester átmegy egy replikára, törli a slotokat, és ezzel együtt a WAL-szegmenseket is. Annak érdekében, hogy elkerüljük ezt a problémát, úgy döntöttünk, hogy megemeljük a wal_keep_segments paramétert. Alapértelmezés szerint 8 szegmens. Ezt 1000-re emeltük, és megnéztük, mennyi szabad helyünk van. Így 16 gigabájt eltartalékot kaptunk a wal_keep_segments miatt. Tehát a váltáskor mindig van 16 gigabájtnyi tranzakciós naplónk az összes csomóponton.
Ráadásul ez aktuális a hosszabb karbantartási feladatokhoz is. Tegyük fel, hogy frissítenünk kell az egyik replikát. Ki kell kapcsolnunk. Frissítenünk kell a szoftvert, lehet, hogy az operációs rendszert, meg még valamit. És amikor kikapcsoljuk a replikát, az ehhez a replikához tartozó slot is törlődik. Ha kis wal_keep_segments-t használunk, akkor a replikán hosszabb távú hiányzáskor a tranzakciós naplók el fognak veszni. Ha felállítjuk a replikát, kérni fogja azokat a tranzakciós naplókat, ahol megállt, de a mesternél lehet, hogy nem lesznek ott. És a replika sem tud majd csatlakozni. Ezért nagy tartalékot tartunk a naplókból.
Van egy production adatbázisunk. Ott már működnek projektek.
Fájlhiba történt. Beléptünk és megnéztük – minden rendben, a replikák a helyükön, nincs replikációs késés. A naplókban sem volt hiba, minden a legnagyobb rendben.
A termékcsapat azt mondja, hogy bizonyos adatoknak létezniük kellene, de mi az egyik forráson látjuk ezeket, a databázisban viszont nem. Meg kell értenünk, mi történt velük.
Egyértelmű, hogy a pg_rewind felülírta őket. Ezt azonnal megértettük, de megnéztük, mi történt.
A naplókban mindig megtalálhatjuk, mikor történt a fájlhiba, ki lett a mester, és meg tudjuk határozni, ki volt a régi mester, és mikor akart replika lenni, tehát ezekre a naplókra van szükségünk, hogy kiderítsük, mennyi tranzakciós napló veszett el.
A régi mester újraindult. Az automatikus indításban a Patroni volt beírva. A Patroni elindult. Következő lépésként elindította a Postgres-t. Pontosabban a Postgres elindítása előtt, és mielőtt replikaként állítaná be, a Patroni elindította a pg_rewind folyamatot. Ennek megfelelően törölte a tranzakciós naplók egy részét, letöltötte az újat, és csatlakozott. Itt a Patroni kiválóan működött, tehát, ahogy kell. A klaszterünk helyreállt. Három node-unk volt, a fájlhiba után is három node-unk lett - minden klassz.
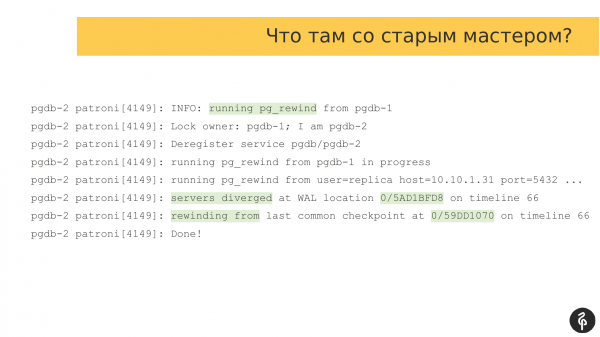
Elveszítettünk egy rész adatot. Meg kell értenünk, hogy pontosan mennyi adatot veszítettünk. Keressük azt az időpontot, amikor a rewind történt. Ezt a naplóbejegyzések alapján tudjuk megállapítani. Elindult a rewind, valamit végrehajtott, majd lezárult.
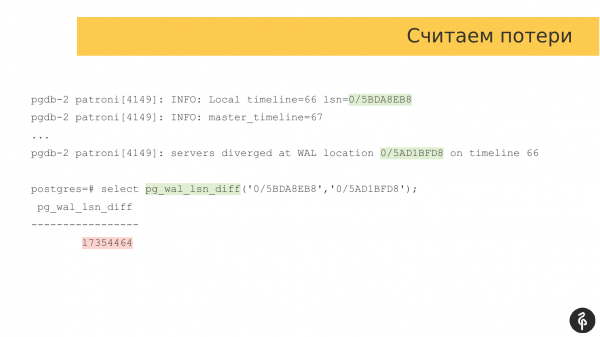
Meg kell találnunk azt a pozíciót a tranzakciós naplóban, ahol az öreg mester megállt. Ebből az esetből ez a bejegyzés az. Szükségünk van egy második bejegyzésre is, azaz arra a távolságra, amely az öreg mester és az új mester között van.
Használjuk a megszokott pg_wal_lsn_diff-et, és összehasonlítjuk ezt a két bejegyzést. Ebben az esetben 17 megabájtot kapunk. Hogy ez sok vagy kevés, azt mindenki saját maga döntheti el. Mert valakinek a 17 megabájt kevés, másoknak viszont túl sok és elfogadhatatlan. Itt már mindenki külön-külön határozza meg az üzleti igények alapján.
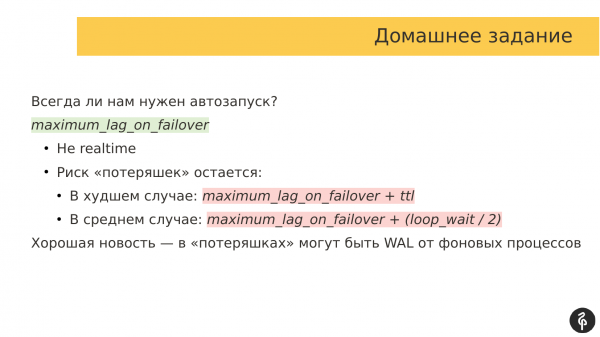
De mit állapítottunk meg magunknak?
Először is, el kell döntenünk, hogy mindig szükségünk van-e a Patroni automatikus indítására a rendszer újraindítása után? Gyakran az történik, hogy be kell lépnünk a régi mesterre, megnézni, mennyire jutott előre. Lehet, hogy ellenőriznünk kell a tranzakciós napló szegmenseit, hogy lássuk, mi történt, és megérteni, hogy elveszíthetjük-e ezeket az adatokat, vagy szükségünk van-e a régi mester standalon üzemmódú indítására, hogy visszanyerjük ezeket az adatokat.
Csak ezután kell döntenünk arról, hogy ezeket az adatokat eldobhatjuk-e, vagy vissza tudjuk-e állítani, és ezt az elágazást replikaként csatlakoztatni tudjuk a klaszterünkhöz.
Ezen kívül létezik a „maximum_lag_on_failover” paraméter. Alapértelmezés szerint, ha nem tévedek, ennek az értéke 1 megabájt.
Hogyan működik? Ha a replikánk 1 megabájt adatot késlekedik a replikációs hátrány miatt, akkor ez a replika nem vesz részt a választásokban. Ha váratlanul fájlalás történik, a Patroni megnézi, hogy mely replikák késlekednek. Ha nagy mennyiségű tranzakciós naplót késlekednek, nem tudnak mesterré válni. Ez egy nagyon jó védelmi funkció, amely megakadályozza, hogy sok adatot veszítsünk.
De itt van egy probléma, hogy a replikációs késés a Patroni klaszterben és a DCS-ben meghatározott időközönként frissül. Azt hiszem, a ttl alapértelmezett értéke 30 másodperc.
Előfordulhat olyan helyzet, amikor a DCS-replikák replikálási késleltetése egy, de valójában teljesen más késleltetés is előfordulhat, vagy akár meg sem jelentkezik, tehát ez nem valós idejű. És nem mindig tükrözi a valóságot. Nem érdemes erre bonyolult logikát építeni.
A veszteségek kockázata mindig fennáll. A legrosszabb esetben egy képlet, míg a közepes esetben egy másik képlet érvényes. Tehát amikor a Patroni bevezetését tervezzük és értékeljük, hogy mennyi adatot veszíthetünk el, figyelembe kell vennünk ezeket a képleteket, és nagyjából elképzelnünk, mennyi adatot veszthetünk.
Jó hír is van. Amikor a régi mester előre lép, előre léphet bizonyos háttérfolyamatok miatt. Tehát volt valamilyen autovákuum, ami adatokat írt, és ezeket elmentette a tranzakciós naplóba. Ezeket az adatokat könnyedén figyelmen kívül hagyhatjuk, és el is veszíthetjük. Ebben nincs semmi probléma.
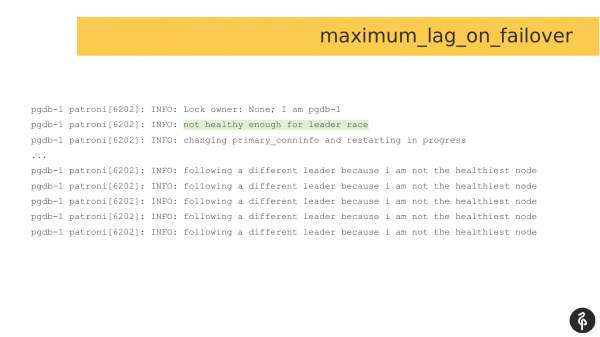
Így néznek ki a naplók, ha be van állítva a maximum_lag_on_failover és bekövetkezik a failover, és új mestert kell választani. A replikátor képtelennek ítéli meg magát, hogy részt vegyen a választásokban, és visszalép a vezető pozícióért folytatott versenyből. Várakozik, amíg új mestert választanak, hogy aztán csatlakozni tudjon hozzá. Ez egy további lépés az adatok elvesztésének megelőzésére.
Itt a termékcsapat azt írta, hogy a termékük problémákat tapasztal Postgres használata közben. Ugyanakkor a mesterhez nem lehet csatlakozni, mert SSH-n keresztül nem elérhető. Az automatikus failover sem következik be.
Ez a host kényszerített újraindítást kapott. Az újraindítás miatt automatikus failover következett be, bár úgy értem, hogy lett volna lehetőség manuális automatikus failoverre is. Az újraindítás után megnézzük, mi volt a jelenlegi mesternél.
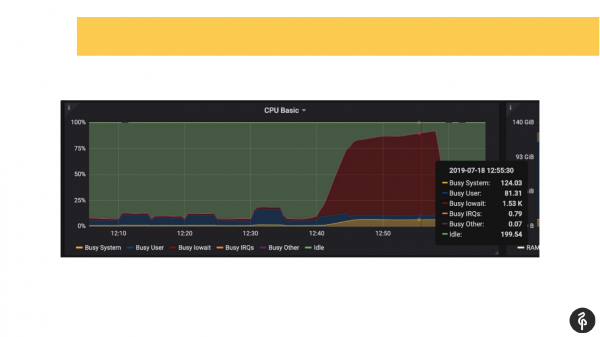
Eközben előre tudtuk, hogy problémáink voltak a lemezekkel, tehát már a megfigyelésből tudtuk, hogy hol kell kutatni és mit kell keresni.
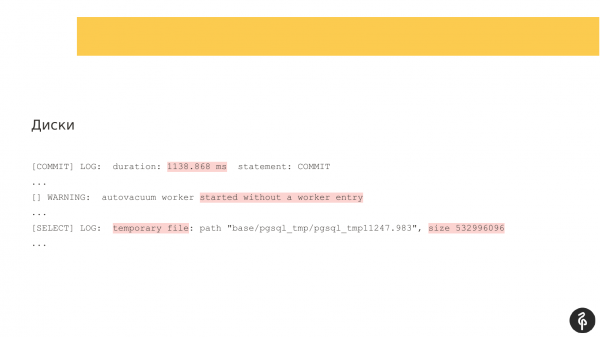
Beléptünk a postgres naplóba, és elkezdtük nézni, mi történik. Láttuk a tranzakciókat, amelyek egy-két-három másodpercig tartottak, ami teljesen normálisnak számít. Láttuk, hogy az autovákuum nagyon lassan és szokatlanul indult. Észrevettük a ideiglenes fájlokat a lemezen. Tehát ezek mind a lemezekkel kapcsolatos problémák jelei.
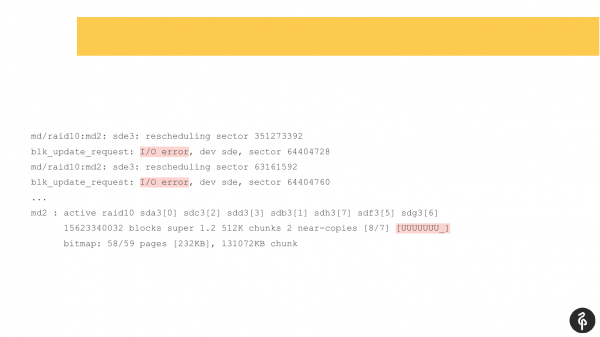
Megnéztük a rendszer dmesg-jét (a magüzenetek naplója). És láttuk, hogy van egy problémánk az egyik lemezzel. A lemezes alrendszer szoftveres Raid volt. Megnéztük a /proc/mdstat fájlt, és láttuk, hogy hiányzik egy lemez. Vagyis itt egy 8 lemezes Raid van, és az egyik hiányzik. Ha alaposan megnézzük a diát, láthatjuk, hogy a kimenetben a sde hiányzik. Szóval, mondhatni, egy lemez kiesett. Ez disk problémákat okozott, és az alkalmazások is problémákat tapasztaltak a Postgres klaszterrel való működés során.
Ebben az esetben a Patroni nem segítene nekünk, mert a Patroninak nincs feladata a szerver állapotának vagy a lemez állapotának figyelésére. Ezeket a helyzeteket külső monitoringgal kell nyomnunk. A külső monitoringhoz gyorsan hozzáadtuk a lemezek monitorozását.
Volt egy ötletünk – vajon segíthetne-e a fencing, vagy egy szoftveres watchdog? Gondoltuk, hogy valószínűleg nem segítene nekünk ebben az esetben, mert a problémák idején a Patroni folytatta az interakciót a DCS klaszterével, és nem észlelt semmilyen problémát. Vagyis a DCS és a Patroni szempontjából a klaszter jól működött, bár valójában lemezproblémák voltak, a használhatósággal kapcsolatos nehézségek.
Szerintem ez az egyik legfurcsább probléma, amit nagyon sokáig kutattam, rengeteg naplót átnéztem és átforgattam, és kluster-szimulánsnak neveztem el.
A probléma az volt, hogy a régi mester nem tudott normális replikává válni, vagyis a Patroni elindította, és a Patroni jelezte, hogy ez a csomópont replikaként van jelen, de ugyanakkor nem volt normális replika. Most látni fogja, miért. Ez megmaradt bennem a probléma elemzése során.
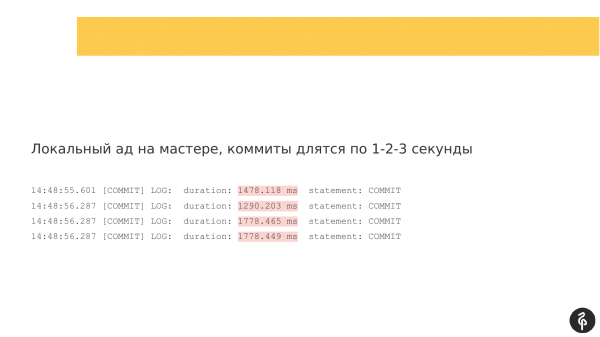
Mivel kezdődött minden? Ahogy a korábbi problémánál, lemezlassulásokkal. Másodpercenként egy-két elköteleződésünk volt.
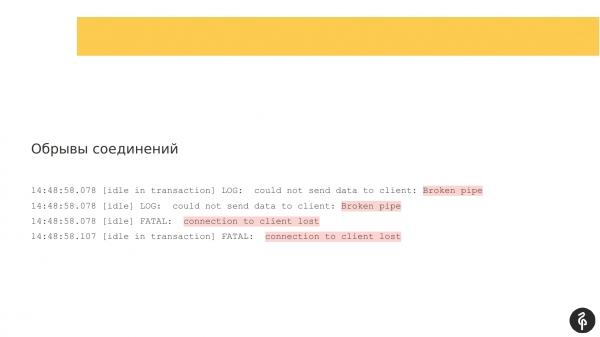
Kapcsolati megszakítások voltak, vagyis a kliensek szakadoztak.
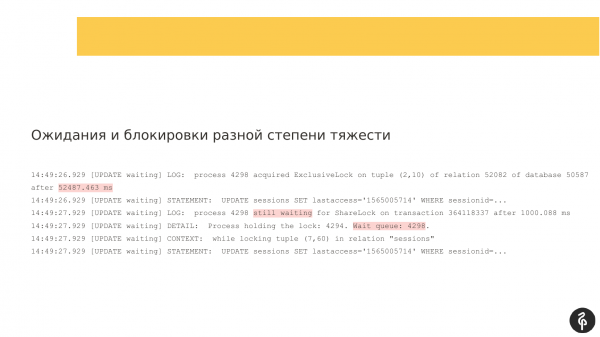
Különböző súlyosságú zárak voltak.
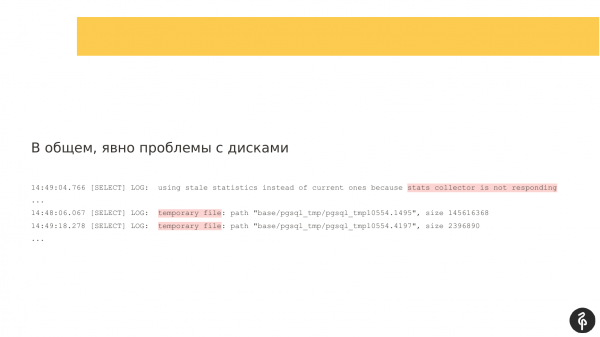
Ennek megfelelően a lemezes alrendszer nem volt túl reagálóképes.
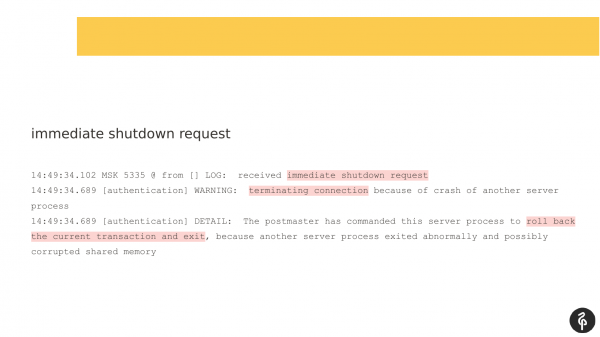
És a számomra legrejtélyesebb az az azonnali leállítási kérés, ami megérkezett. A Postgresnek három leállítási módja van:
- Ez a graceful, amikor várunk, hogy minden kliens önállóan lecsatlakozzon.
- Van fast, amikor arra kényszerítjük a klienseket, hogy csatlakozzanak le, mert leállni készülünk.
- Immediate. Ebben az esetben az immediate nem is tájékoztatja az ügyfeleket, hogy le kell állniuk, egyszerűen figyelmeztetés nélkül kikapcsol. Az összes ügyfél számára az operációs rendszer RST üzenetet küld (TCP-üzenetet, amely szerint a kapcsolat megszakadt, és az ügyfélnek már nincs mit keresnie).
Ki küldte ezt a jelet? A Postgres háttérfolyamatai nem küldenek egymásnak ilyen jeleket, tehát ez kill-9. Egymásnak nem küldenek ilyet, csak reagálnak rá, tehát ez a Postgres sürgősségi újraindítása. Ki küldte, nem tudom.
Megnéztem a 'last' parancsot, és láttam egy embert, aki szintén bejelentkezett erre a szerverre velünk, de szégyelltem megkérdezni. Lehet, hogy ez kill -9 volt. A naplókban látnám a kill -9-et, mert a Postgres írja, hogy fogadta a kill -9-et, de ezt nem láttam a naplókban.
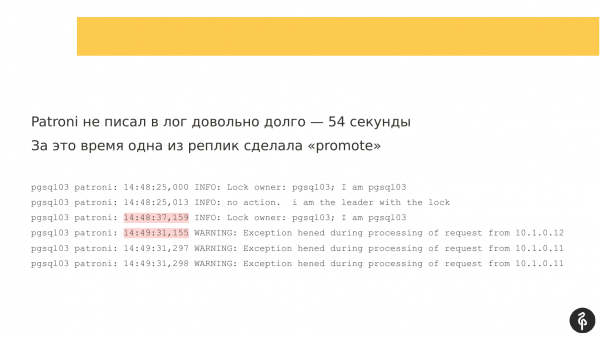
Tovább vizsgálva észrevettem, hogy a Patroni elég hosszú ideig nem írt a naplóba - 54 másodpercig. Ha összehasonlítjuk a két időbélyeget, itt körülbelül 54 másodpercig nem voltak üzenetek.
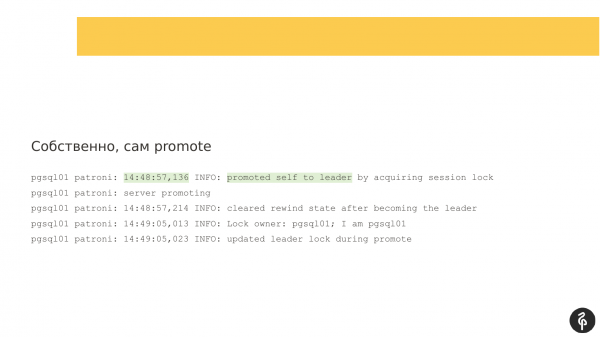
Ez idő alatt automatikus átkapcsolás történt. A Patroni itt ismét jól működött. A régi mester nem volt elérhető, valami történt vele. Elkezdődtek az új mester választásai. Itt minden jól működött. A pgsql01 lett az új vezető.
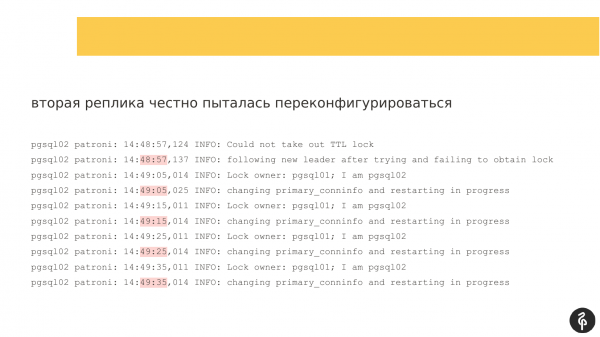
Van egy replikánk, amelyből mester lett. És van egy második replikánk. A második replikával éppen problémák voltak. Próbált újrakonfigurálódni. Amennyire megértem, próbálta megváltoztatni a recovery.conf-ot, újraindítani a Postgres-t és csatlakozni az új mesterhez. Minden 10 másodpercben írja az üzeneteket, hogy próbálkozik, de nem sikerül neki.
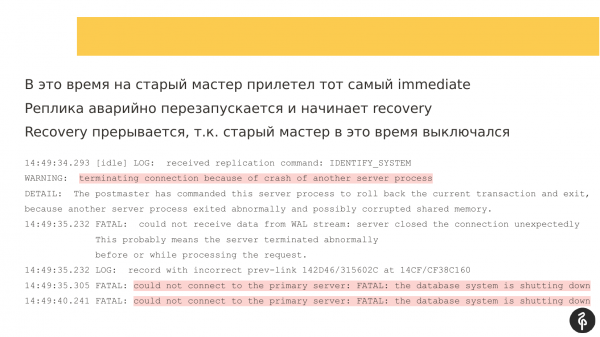
Ezek alatt a próbálkozások alatt a régi mesterhez megérkezik az immediate-shutdown jel. A mester újraindul. És a helyreállítás is leáll, mert a régi mester újraindul. Tehát a replikának nem lehet csatlakozni hozzá, mert kikapcsolási módban van.
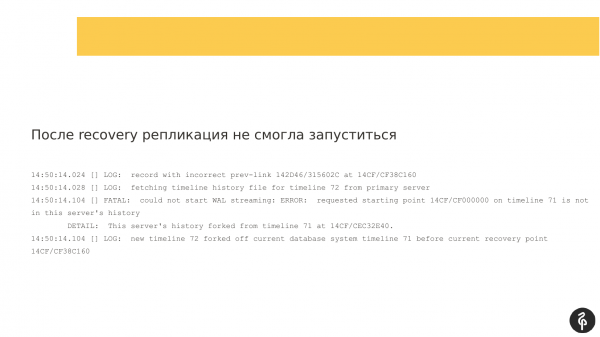
Egy pillanatban elindult, de a replikáció nem indult el.
Van egy egyetlen hipotézisem, hogy a recovery.conf-ban a régi mester címe volt. És amikor megjelent az új mester, a második replika még mindig a régi mesterhez próbált csatlakozni.
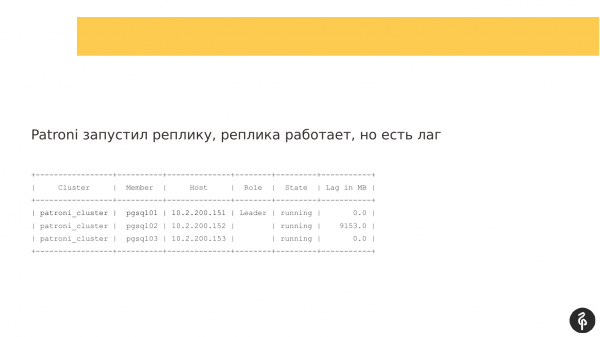
Amikor a Patroni elindult a második replikán, a csomópont elindult, de nem tudott csatlakozni a replikáción keresztül. És replikációs késés keletkezett, ami körülbelül így nézett ki. Tehát mindhárom csomópont a helyén volt, de a második csomópont lemaradt.
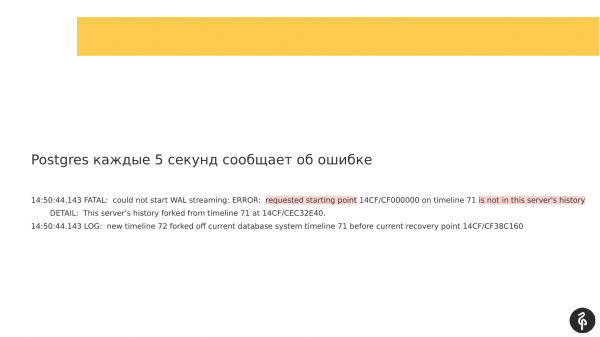
Ha megnézzük a naplókat, amelyek íródtak, láthatjuk, hogy a replikáció nem tud elindulni, mert a tranzakciós naplók eltérnek. Azok a tranzakciós naplók, amelyeket a mester ajánl, amelyek a recovery.conf-ban szerepelnek, egyszerűen nem felelnek meg a jelenlegi csomópontunknak.
És itt hibát követtem el. Meg kellett volna néznem, mi van a recovery.conf-ban, hogy ellenőrizzem a hipotézisem, hogy nem a megfelelő mesterhez csatlakozunk. De akkor csak most kezdtem megérteni ezt, és ez nem jutott eszembe, vagy észrevettem, hogy a replikáció elmarad, és azt át kell töltenem, tehát valahogy hanyagul végeztem el. Ez az én hibám volt.
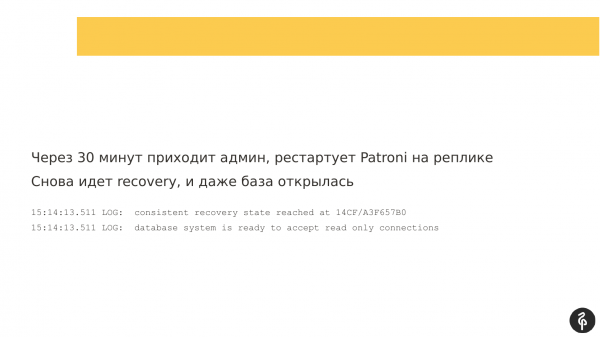
30 perc múlva már itt volt az admin, tehát újraindítottam a Patroni-t a replikán. Már lemondtam róla, azt hittem, át kell töltenem. És arra gondoltam – újraindítom a Patroni-t, lehet, hogy történik valami jó. A recovery elindult. És az adatbázis meg is nyílt, készen állt a kapcsolatok fogadására.
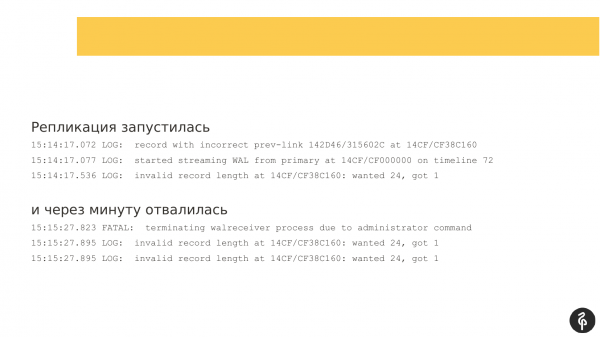
A replikáció elindult. De egy perccel később leállt egy hibával, miszerint nem megfelelők a tranzakciós naplók.
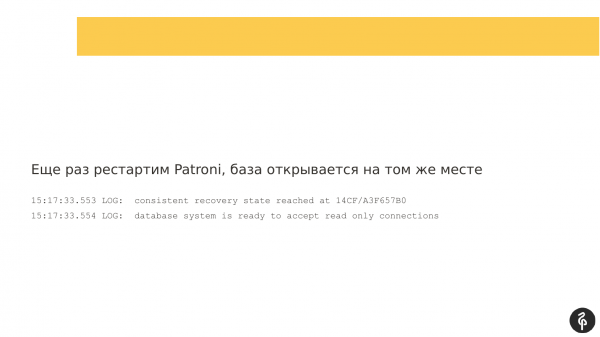
Arra gondoltam, hogy újra próbálom újraindítani. Ismét újraindítottam a Patroni-t, és nem a Postgres-t indítottam újra, hanem kifejezetten a Patroni-t, abban a reményben, hogy varázslatos módon elindítja az adatbázist.
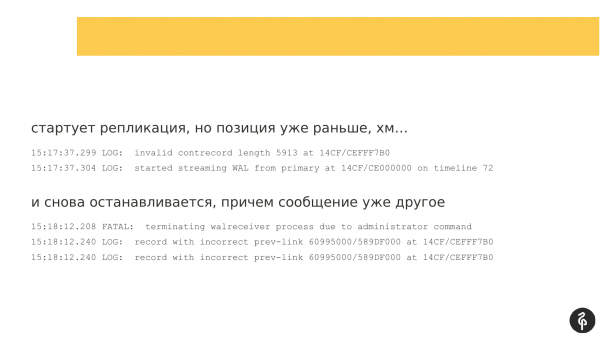
A replikáció ismét elindult, de a tranzakciós naplóbejegyzések eltértek, nem azok voltak, amelyek a korábbi próbálkozáskor voltak. A replikáció ismét leállt. És az üzenet egy kicsit más volt. Számomra nem volt nagyon informáló.
És akkor az jutott eszembe – mi lenne, ha újraindítanám a Postgres-t, és közben a jelenlegi mesternél csinálnék egy checkpoint-ot, hogy kicsit előbbre toljam a tranzakciós napló pontot, hogy a recovery egy másik pontból kezdődjön? Plusz még voltak WAL tartalékaink is.
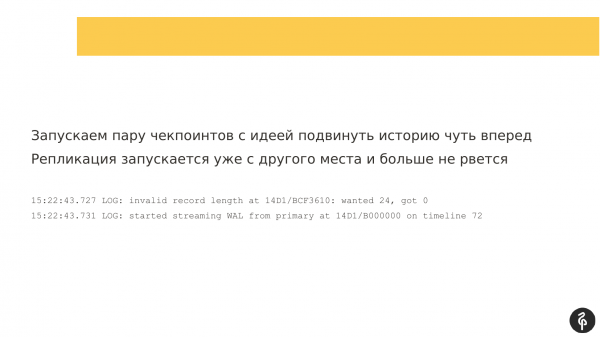
Újraindítottam a Patroni-t, csináltam pár checkpoint-ot a mesternél, pár restart-pontot a replikán, amikor az megnyílt. És ez segített. Hosszú ideig gondolkodtam, hogy miért segített ez és hogyan működött. És a replikáció elindult. A replikáció többé nem szakadt meg.
Ez a probléma számomra az egyik legrejtélyesebb, amin még mindig töprengek, hogy valójában mi történt.
Milyen következtetéseket lehet levonni? A Patroni működhet a tervek szerint, és hibák nélkül. De ez nem 100%-os garancia, hogy minden rendben van. A replika elindulhat, de lehet, hogy félig működő állapotban van, és az alkalmazás nem működhet ilyen replika esetén, mert ott régi adatok lesznek.
A fájlátadás után mindig ellenőriznünk kell, hogy rendben van a klaszter, vagyis van-e a szükséges számú replika és nincs-e replikációs késleltetés.
Ezeknek a problémáknak a megvizsgálása során ajánlásokat fogalmaztam meg. Megpróbáltam őket két diára összegyűjteni. Valószínűleg minden történetet össze lehetett volna foglalni két diára, és csak azokat mesélni.
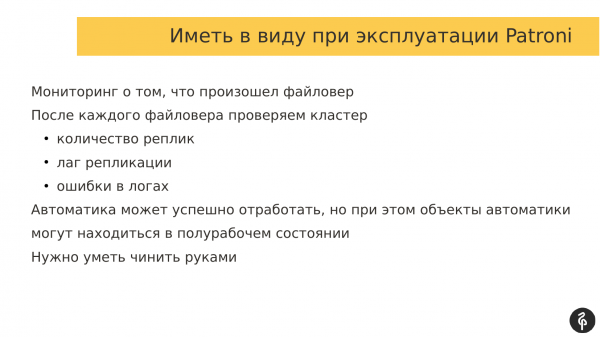
Amikor a Patronit használja, mindenképpen meg kell valósítani a monitoringot. Mindig tudnia kell, mikor történt autófájlátadás, mert ha nem tudja, hogy volt autófájlátadás, akkor nem ellenőrzi a klasztert. És ez rossz.
Minden fájlátadás után mindig kézzel kell ellenőriznünk a klasztert. Biztosítanunk kell, hogy mindig aktuális számú replika legyen, nincs replikációs késleltetés, és a naplókban nincsenek olyan hibák, amelyek az adatfolyam replikációval, a Patronival vagy a DCS rendszerrel kapcsolatosak.
Az automatika sikeresen működhet, a Patroni egy nagyon jó eszköz. Működhet, de ez nem fogja a klasztert a kívánt állapotba juttatni. És ha erről nem szerzünk tudomást, akkor problémáink lesznek.
A Patroni nem ezüst golyó. Továbbra is tudnunk kell, hogyan működik a Postgres, hogyan működik a replikáció, és hogy a Patroni hogyan működik a Postgresszal, valamint hogyan biztosítják a csomópontok közötti interakciót. Erre szükség van ahhoz, hogy képesek legyünk kézzel kijavítani a felmerülő problémákat.
Hogyan közelítem meg a diagnosztikai kérdést? Úgy alakult, hogy különböző ügyfelekkel dolgozunk, és senkinek sincs ELK stackje, és a naplókat 6 konzol és 2 fül megnyitásával kell áttekintenem. Az egyik lapon a Patroni naplói vannak minden csomópontra, a másik lapon pedig a Consul vagy a Postgres naplói szükség szerint. Ezt diagnosztizálni nagyon nehéz.
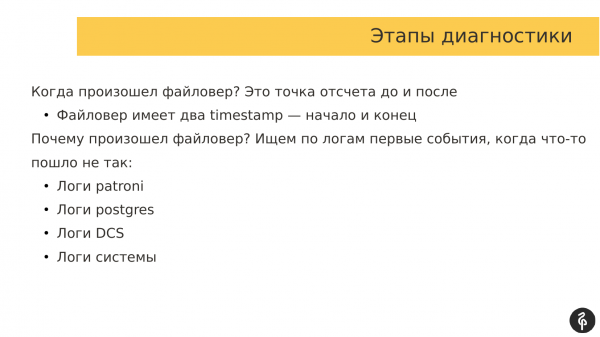
Milyen megközelítéseket dolgoztam ki? Először is mindig megnézem, mikor történt a fájlátadás. Számomra ez egyfajta vízválasztó. Megnézem, mi történt a fájlátadás előtt, alatt és után. A fájlátadásnak két időpontja van: a kezdő és a befejező idő.
A naplóban a fájlverzió előtt nézem az eseményeket, vagyis keresem az okokat, hogy miért történt a fájlverzió.
Ez pedig betekintést ad abba, hogy mi történt, és hogy mit tehetünk a jövőben azért, hogy ilyen körülmények ne forduljanak elő (és következésképpen ne történjen fájlverzió).
És hova nézünk általában? Én ezt nézem:
- Először is a Patroni naplókat.
- Aztán megnézem a Postgres naplókat, vagy a DCS naplókat attól függően, hogy mi volt a Patroni naplókban.
- A rendszernaplók néha szintén adnak betekintést abba, hogy mi okozta a fájlverziót.
Mit gondolok a Patroniról? Nagyon jól gondolkodom a Patroniról. Szerintem ez a legjobb dolog, ami ma létezik. Sok más terméket ismerek. Ez a Stolon, Repmgr, Pg_auto_failover, PAF. 4 eszköz. Mindet kipróbáltam. A Patroni tetszett a legjobban.
Ha megkérdeznének: "Ajánlom-e a Patronit?", azt mondanám, hogy igen, mivel a Patroni a kedvencem. És úgy érzem, megtanultam kezelni.
Ha érdeklik az egyéb problémák a Patronival kapcsolatban, a már említett problémákon kívül, mindig elmehet a GitHub oldalára. Ott sok különböző történetet talál, és sok érdekes problémát vitatnak meg. Végül pár hibát rögzítettek és megoldottak, tehát érdekes olvasmány.
Ott érdekes történetek vannak arról, hogyan lőhetnek magukra az emberek. Nagyon tanulságos. Olvasod és megérted, hogy ezt nem szabad csinálni. Pipa be.
Szeretném megköszönni a Zalando cégnek, hogy fejlesztik ezt a projektet, különösen Alexandr Kukuškinak és Aleksey Klyukinnek. Aleksey Klyukin – ő az egyik társszerző, már nem dolgozik a Zalandonál, de ők ketten kezdték el ezt a terméket.
Úgy vélem, hogy a Patroni egy nagyon klassz dolog. Örülök, hogy létezik, érdekes vele dolgozni. Nagy köszönet minden közreműködőnek, akik javításokat írnak a Patronihoz. Remélem, hogy a Patroni idővel egyre érettebbé, klasszabbá és működőképesebbé válik. Jelenleg is működőképes, de remélem, hogy még jobb lesz. Tehát ha tervezed a Patroni használatát, ne félj. Ez egy jó megoldás, implementálható és használható.
Ezzel vége. Ha vannak kérdéseid, tedd fel őket.
Kérdések
Köszönöm a bemutatót! Ha a fájlverzió után még mindig nagyon figyelmesen kell néznünk, akkor miért van szükségünk automatikus fájlverzióra?
Mert, hogy ez egy új dolog. Csak egy éve dolgozunk vele. Jobb elővigyázatosnak lenni. Szeretnénk bejönni és megnézni, hogy minden valóban úgy működik, ahogy kell. Ez egy felnőtt szintű bizalmatlanság – jobb újraellenőrizni és megnézni.
Például reggel bejöttünk és megnéztük, ugye?
Nem reggel, általában az auto-failoverről szinte azonnal értesülünk. Értesítéseket kapunk, látjuk, hogy bekövetkezett az auto-failover. Szinte azonnal belépünk és megnézzük. De az összes ellenőrzést a monitorozás szintjére kell emelni. Ha a Patroni-t REST API-n keresztül hívjuk, van history. A history alapján megnézhetjük az időbélyegeket, mikor történt a failover. Ebből lehet monitorozást végezni. A history-t nézve azt is megnézhetjük, hány esemény történt. Ha több eseményünk lett, az azt jelenti, hogy auto-failover történt. Akkor érdemes megnézni. Vagy a monitorozásunk automatikusan ellenőrizte, hogy minden replikánk rendben van, nincs késlekedés, és minden jól működik.
Köszönöm!
Nagyon köszönöm a nagyszerű beszámolót! Ha a DCS klasztert elmozdítjuk a Postgres klasztertől, akkor ezt a klasztert is időnként karban kell tartani? Milyen bevált gyakorlatok vannak abban, hogy a DCS klaszter egyes részeit ki kell kapcsolni, mit kell tenni velük stb.? Hogyan működik közben az egész struktúra? És ezeket a dolgokat hogyan lehet megcsinálni?
Egy cégnél szükség volt egy problémamatrix készítésére, hogy mi történik, ha valamelyik vagy több komponens meghibásodik. Ezen a mátrixon keresztül sorban végigmegyünk az összes komponensen és forgatókönyveket készítünk ezek leállása esetére. Ennek megfelelően minden leállási forgatókönyvhöz lehet egy cselekvési terv a helyreállításra. A DCS esetében ez a szabványos infrastruktúra részeként működik. Az adminisztrátor adminisztrálja, és mi már az ő képességeire támaszkodunk, hogy kijavítsa ezt vészhelyzet esetén. Ha a DCS egyáltalán nem létezik, akkor mi telepítjük, de különösebben nem figyelünk rá, mert nem vagyunk felelősek az infrastruktúráért, de ajánlásokat adunk arra, hogyan és mit kell monitorozni.
Tehát jól értettem, hogy a Patroni-t ki kell kapcsolni, a failovert ki kell kapcsolni, mindent ki kell kapcsolni, mielőtt bármit csinálnánk a hostokkal?
Ez attól függ, hány csomópont van a DCS klaszterben. Ha sok csomópont van, és ha csak egy csomópontot (replikát) állítunk le, akkor a klaszter megőrzi a kvórumot. Így a Patroni működőképes marad, és semmi nem aktiválódik. Ha bonyolultabb műveleteink vannak, amelyek több csomópontot érintenek, és azoknak hiánya a kvórum összeomlását okozhatja, akkor igen, talán érdemes lenne a Patronit szüneteltetni. Van egy megfelelő parancs – patronictl pause, patronictl resume. Csak szüneteltetjük, és a failover nem aktiválódik ez idő alatt. Karbantartást végzünk a DCS klaszteren, majd feloldjuk a szünetet, és folytatjuk az életünket.
Köszönöm szépen!
Nagy köszönet a bemutatóért! Hogyan viszonyul a termékcsapat ahhoz, hogy adatok veszhetnek el?
A termékcsapatokat nem érdekli, de a csapatvezetők aggódnak.
Milyen garanciák vannak?
A garanciákkal nagyon nehéz. Van egy előadás Alekszandr Kukuskin „Hogyan számítsuk ki az RPO-t és az RTO-t”, tehát a helyreállítási időt és azt, hogy mennyi adatot veszíthetünk el. Azt hiszem, meg kell találni ezeket a diákat és tanulmányozni őket. Amennyire emlékszem, konkrét lépések vannak arra, hogyan kell ezeket a dolgokat kiszámítani. Mennyi tranzakciót veszíthetünk el, mennyi adatot veszíthetünk el. Alternatívaként szinkron replikációt is használhatunk a Patroni szintjén, de ez kétséges: vagy megbízhatóságot nyerünk, vagy sebességet veszítünk. Van szinkron replikáció, de ez sem garantálja a 100%-os adatvédelmet.
Aleksey, köszönöm a kiváló bemutatót! Van tapasztalatotok a Patroni használatáról a nulladik szintű védelemhez? Azaz szinkron standby-val együttesen? Ez az első kérdés. A második kérdés. Különböző megoldásokat használtatok. Mi a Repmgr-t használtuk, de automatikus failover nélkül, és most tervezünk automatikus failover-t alkalmazni. A Patronit alternatív megoldásként fontolgatjuk. Mit mondhattok a Repmgr-rel való összehasonlítás előnyeiről?
Az első kérdés a szinkron replikákról szólt. Nálunk senki sem használ szinkron replikációt, mert mindenki fél tőle (Már több ügyfél használja, teljesítményproblémát alapvetően nem tapasztaltunk – A bemutató megjegyzése). De mi egy szabályt alkottunk, hogy a szinkron replikációs klaszterben legalább három csomópontnak kell lennie, mert ha csak két csomópont van, és a mester vagy a replikáció meghibásodik, akkor a Patroni az adott csomópontot Standalone üzemmódba állítja, hogy az alkalmazás továbbra is működhessen. Ebben az esetben van adatvesztés kockázata.
A második kérdéssel kapcsolatban azt kell mondanom, hogy a Repmgr-t használtuk, és még mindig használjuk néhány ügyfélnél történeti okokból. Mit is mondhatnék? A Patroni-ban az automatikus átkapcsolás alapértelmezett funkció, míg a Repmgr-ben az automatikus átkapcsolás egy további funkció, amelyet be kell kapcsolni. A Repmgr daemont minden csomóponton el kell indítani, és így beállíthatjuk az automatikus átkapcsolást.
A Repmgr ellenőrzi, hogy élnek-e a Postgres csomópontok. A Repmgr folyamatok ellenőrzik egymás létezését, ami nem a leghatékonyabb megoldás, mivel bonyolult hálózati izolációs esetek fordulhatnak elő, amelyek során egy nagy Repmgr klaszter több kisebbé bontható és folytathatja a működést. Régóta nem követem a Repmgr-t, lehet, hogy ezt már javították... vagy talán nem. Viszont az információk állapotának DCS-be történő kihelyezése, ahogy azt a Stolon és a Patroni is teszi, a legéletképesebb megoldás.
Alexey, van egy kérdésem, lehet, hogy kicsit amatőr. Az egyik első példában a DCS-t egy helyi gépről egy távoli csomópontra helyeztétek. Az érthető, hogy a hálózatnak megvannak a saját jellemzői, saját élete van. És mi történik, ha valamilyen okból a DCS klaszter elérhetetlenné válik? Nem részletezem az okokat, lehet sokféle: a hálózati szakemberek hibáitól kezdve a valós problémákig.
Nem mondtam ki hangosan, de a DCS klaszternek is hibamentesnek kell lennie, tehát páratlan számú csomópontból kell állnia, hogy a kvórum össze tudjon jönni. Mi történik, ha a DCS klaszter elérhetetlenné válik, vagy nem tud összeállni a kvórum, tehát valami hálózati szétválás vagy csomópont hibája lép fel? Ebben az esetben a Patroni klaszter read only üzemmódba vált. A Patroni klaszter nem tudja meghatározni a klaszter állapotát és mit tegyen. Nem tud kapcsolatba lépni a DCS-sel, és menteni az új klaszter állapotát, ezért az egész klaszter read only üzemmódba vált. És várja, vagy a kezelő manuális beavatkozását, vagy hogy a DCS helyreálljon.
Nagyjából véve a DCS nekünk ugyanolyan fontos szolgáltatássá válik, mint magának az adatbázisnak?
Igen-igen. A modern vállalatokban a Service Discovery alapvető része az infrastruktúrának. Az még a database megjelenése előtt bevezetésre kerül. Mondhatjuk, hogy elindítottuk az infrastruktúrát, felálltunk egy adatközpontban, és máris van Service Discovery-nk. Ha ez a Consul, akkor azon DNS is felépíthető. Ha ez az Etcd, akkor a Kubernetes klaszter egy része lehet, amelyben már mindent más egyéb kiépítünk. Úgy érzem, hogy a Service Discovery már nem választható el a modern infrastruktúráktól. Erről sokkal korábban kezdenek el gondolkodni, mint az adatbázisokról.
Köszönöm!
Forrás: habr.com
