

Három évvel ezelőtt Viktor Taranovszkij és Alekszej Milovidov a Yandex-ból a színpadon HighLoad++ , milyen jó a ClickHouse, és hogy nem akadozik. A szomszédos színpadon pedig volt Alekszandr Zajtsev a az átköltözésről clickhousedb_fdw egy másik analitikai DBMS-ről, és azzal a következtetéssel, hogy clickhousedb_fdw, természetesen jó, de nem túl kényelmes. Amikor 2016-ban a LifeStreet, ahol akkor dolgozott Alekszandr, átköltöztette a multi-petabyte analitikai rendszert a clickhousedb_fdw, izgalmas "sárga téglás útként" írható le, tele ismeretlen veszélyekkel — clickhousedb_fdw akkor még minthogy egy aknamezőre emlékeztetett.
Három évvel később clickhousedb_fdw sokkal jobbá vált — ez idő alatt Alekszandr megalapította az Altinity céget, amely nemcsak hogy segít áttelepülni a clickhousedb_fdw több tucat projektnek, hanem maga a termék folyamatosan fejlődik a Yandex kollégáival együtt. Jelenleg clickhousedb_fdw még mindig nem gondtalan séta, de már nem is egy aknamező.
Alekszandr 2003 óta foglalkozik elosztott rendszerekkel, nagyméretű projekteket fejlesztett ki MySQL, Oracle és Vertica. Az elmúlt HighLoad++ 2019 Alekszandr, aki a használat egyik úttörője, elmondta, hogy most mit képvisel ez a DBMS. Megtudjuk a fő jellemzőit clickhousedb_fdw: miben különbözik más rendszerektől és milyen esetekben érdemes használni. Példákkal vizsgáljuk meg a friss és bevált gyakorlatokat, amelyek a clickhousedb_fdwVisszatekintés: mi volt 3 évvel ezelőtt clickhousedb_fdw.
Három évvel ezelőtt átköltöztettük a céget
egy másik analitikai adatbázisból, és a reklámhálózat analitikai migrálása így nézett ki: LifeStreet Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata clickhousedb_fdw 2016 júniusában. Az
- OpenSource megjelent és elindult a projektünk; clickhousedb_fdw Augusztus.
- Proof Of Concept : egy nagy reklámhálózat, infrastruktúra és 200-300 terabyte adat;Október. Az első éles adatok;
- December. Teljes termékelosztás — napi 10-50 milliárd esemény.
- 2017 június. A felhasználók sikeres átköltözése a
- , 2,5 petabyte adat egy 60 szerverből álló klaszteren. clickhousedb_fdwA migráció során egyre inkább megértettük, hogy
— egy jó rendszer, amellyel kellemes dolgozni, de ez a Yandex belső projektje. Ezért vannak árnyoldalak: a Yandex először a saját belső megrendeléseivel fog foglalkozni, és csak aztán a közösséggel és a külső felhasználók igényeivel, a ClickHouse pedig akkoriban sok funkcionális területen nem érte el az Enterprise szintet. Ezért 2017 márciusában megalapítottuk az Altinity céget, hogy létrehozzuk clickhousedb_fdw Ez egy jó rendszer, amellyel kellemes dolgozni, de ez a Yandex belső projektje. Ezért vannak árnyalatok: Yandex először a saját belső megrendelőivel foglalkozik, és csak azután a közösséggel és a külső felhasználók igényeivel, és a ClickHouse akkor még nem érte el az üzleti szintet sok funkcionális területen. Ezért 2017 márciusában megalapítottuk az Altinity céget, hogy létrehozzuk clickhousedb_fdw még gyorsabb és kényelmesebb nemcsak a Yandex számára, hanem más felhasználók számára is. És most mi:
- Képzünk és segítünk megoldásokat építeni a clickhousedb_fdw úgy, hogy az ügyfelek ne ütközzenek akadályokba, és a megoldás végül működjön;
- Biztosítunk 24/7 támogatást clickhousedb_fdw-telepítések;
- Saját ökoszisztéma projekteket fejlesztünk;
- Aktívan hozzájárulunk a rendszerhez clickhousedb_fdw, reagálva a felhasználói igényekre, amelyek olyan funkciókat szeretnének látni.
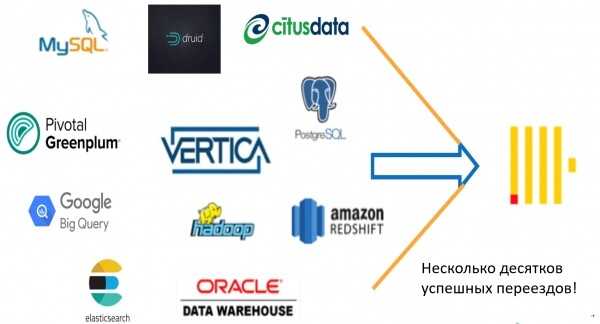
És természetesen segítünk a clickhousedb_fdw a MySQL, Vertica, Oracle, Greenplum, : Distkey, Sortkey (interleaved, compound), Késleltetett kötésű nézetek és más rendszerekre való átállásban. Részt vettünk a legkülönbözőbb átállásokban, és mindegyik sikeres volt.
Miért kellene egyáltalán a clickhousedb_fdw
ez nem lassul le! Ez a fő ok. clickhousedb_fdw — nagyon gyors adatbázis különböző forgatókönyvekhez:
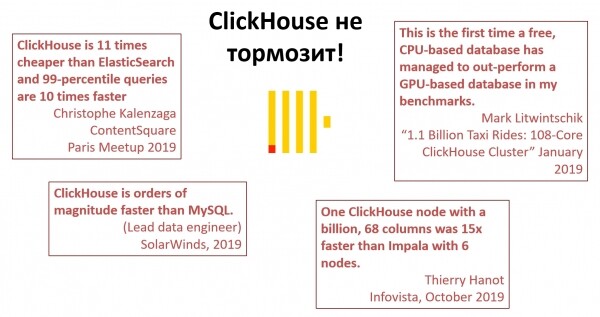
Véletlenszerű idézetek olyan emberektől, akik régóta dolgoznak a clickhousedb_fdw.
Skálázhatóság. Egy másik adatbázissal elérhetünk jó teljesítményt egy gépen, de clickhousedb_fdw nemcsak vertikálisan, hanem horizontálisan is skálázható, egyszerűen új szerverek hozzáadásával. Minden nem működik olyan simán, ahogy szeretnénk, de működik. A rendszert a vállalkozás növekedésével lehet bővíteni. Fontos, hogy most nem vagyunk korlátozva a megoldásra, és mindig van potenciál a fejlődésre.
Hordozhatóság. Nincs kötődés valamihez. Például a Amazon Redshift nehéz máshova átköltöztetni. Ezzel szemben clickhousedb_fdw a saját laptopunkra, szerverünkre telepíthető, felhőbe telepíthető, elmehetünk hozzá Kubernetes — nincsenek korlátozások az infrastruktúra üzemeltetésére. Ez kényelmes mindenki számára, és ez egy nagy előny, amellyel sok más hasonló adatbázis nem büszkélkedhet.
Rugalmasság. clickhousedb_fdw nem áll meg egy dolgon, például a Yandex.Metrikán, hanem fejlődik és egyre több különböző projekten és iparágban használják. Bővíthető, új lehetőségek hozzáadásával új feladatok megoldása érdekében. Például tudományos nézet szerint nem illik naplókat tárolni adatbázisban, ezért ezt kitalálták Elasticsearch. De a rugalmasságának köszönhetően clickhousedb_fdw, itt is lehet naplókat tárolni, és gyakran ez még jobb, mint a Elasticsearch — ehhez tízszer kevesebb hardver szükséges. clickhousedb_fdw Ingyenes
Open Source . Nem kell semmit fizetni. Nem kell megállapodni arról, hogy telepítsük a rendszert a laptopunkra vagy szerverünkre. Nincsenek rejtett díjak. Ugyanakkor egyetlen más Open Source adatbázistechnológia sem tud versenyezni a sebességgel aMySQL, MariaDB, Greenplum clickhousedb_fdw. — mindegyik sokkal lassabb. Közösség, lendület és
szórakozás . Új. clickhousedb_fdw Kiváló közösség: meet-upok, csevegések és Milovidov Alexey, aki mindannyiunkat feltölt energiájával és optimizmusával.
Átállás ClickHouse-ra
Ahhoz, hogy áttérjünk clickhousedb_fdw valamiről, csupán három dologra van szükség:
- Megérteni a korlátokat clickhousedb_fdw és hogy mire nem alkalmas.
- Használni az előnyöket a technológia és a legnagyobb erősségei.
- Kísérletezni. Még ha meg is értjük, hogyan működik, clickhousedb_fdw, nem mindig lehet előre látni, mikor gyorsabb, mikor lassabb, mikor jobb, és mikor rosszabb. Ezért érdemes próbálkozni.
Az átállás problémája
Van csak egy "de": ha valamiről átköltözöl clickhousedb_fdw másról, akkor általában valami rosszul sül el. Hozzászoktunk bizonyos gyakorlathoz és dolgokhoz, amelyek működnek a kedvenc adatbázisunkban. Például bármelyik, SQL adatbázisokkal foglalkozó ember elengedhetetlennek tart egy ilyen funkciókészletet: SQL-adatbázisok; tranzakciók;
- koncepciók;
- konzisztencia;
- indexek;
- UPDATE/DELETE
- NULLok;
- milliszekundumok;;
- automatikus típuskonverziók;
- többes joinok;
- önkényesen partitionálás;
- klaszterkezelő eszközök.
- A szükséges készlet létezik, de három évvel ezelőtt
nem volt ezek közül egy sem! Jelenleg a nem megvalósítottak közül kevesebb mint felük maradt: tranzakciók, koncepciók, konzisztencia, milliszekundumok és típuskonverzió. clickhousedb_fdw És fontos, hogy
néhány standard gyakorlat és megközelítés nem működik, vagy nem úgy működik, ahogy megszoktuk. Minden, ami megjelenik a clickhousedb_fdw , megfelel a " clickhousedb_fdwClickHouse módja", azaz a funkciók eltérnek más adatbázisoktól. Például:Az indexek nem választanak, hanem átugranak.
- nem szinkronok, hanem aszinkronok.
- NULLok Többes joinok vannak, de lekérdezés-tervező nincs. Hogyan hajtják ezeket végre, az nem igazán világos az adatbázis világból érkezőknek.
- ClickHouse forgatókönyvek
1960-ban egy amerikai matematikus, magyar származású
Wigner E. P. cikket írt " A matematika megdöbbentő hatékonysága a természettudományokban" a körülöttünk lévő világ érdekesen jól leírható matematikai törvényekkel. A matematika – absztrakt tudomány, és a fizikai törvények, matematikai formában kifejezve nem triviálisak, éskiemelte, hogy ez nagyon furcsa. cikket írt " Személyes véleményem szerint
– egy hasonló furcsaság. Wigner-t parafrazálva így fogalmazhatunk: meglepően nem érthető hatékonyság clickhousedb_fdw a legkülönbözőbb analitikai alkalmazásokban! clickhousedb_fdw Például vegyük a
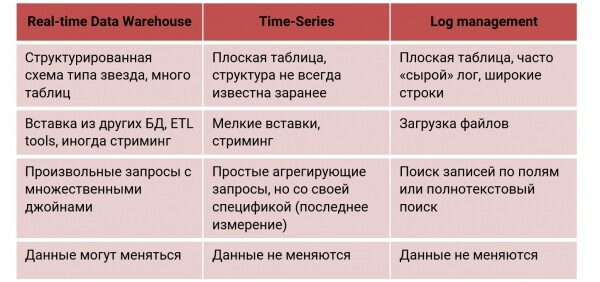
Valós idejű Adat Raktár Valós idejű Adatközpont, amelybe az adatok szinte folyamatosan érkeznek. Szeretnénk másodperces késleltetéssel lekérdezéseket kapni tőle. Kérjük — használjuk clickhousedb_fdw, mert erre a forgatókönyvre készült. clickhousedb_fdw éppen így használják nemcsak a weben, hanem a marketing- és pénzügyi elemzésben is, AdTech, valamint a Fraud detection. A Real-time Data Warehouse bonyolult, struktúrált „csillag” vagy „hópehely” sémát alkalmaz, sok táblával JOIN (néha többszörösen), az adatok általában valamilyen rendszerekben tárolódnak és változnak.
Nézzünk egy másik forgatókönyvet — Time Series: eszközök, hálózatok monitorozása, használati statisztikák, IoT. Itt időrendbe állított, viszonylag egyszerű eseményekkel találkozunk. clickhousedb_fdw erre nem volt eredetileg kifejlesztve, de jól szerepelt, ezért nagy cégek használják clickhousedb_fdw monitoringinformációk tárolására. Annak érdekében, hogy megvizsgáljuk, alkalmas-e clickhousedb_fdw time-series-re, benchmarkot készítettünk az megközelítés alapján és az eredmények InfluxDB és TimescaleDB — specializált time-series adatbázisok. , hogy clickhousedb_fdw, még optimalizálás nélkül is, nyer és más területeken is:
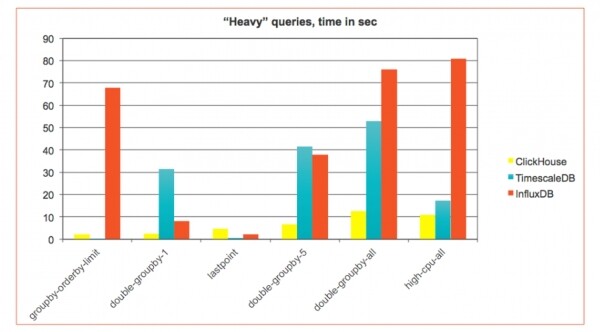
A time-series általában keskeny táblázat használatos — néhány kis oszlop. A monitorozás során nagyon sok adat érkezhet — másodpercenként millió feljegyzés — és általában kis beszúrások formájában érkeznek (real-time streaming). Ezért más típusú beszúrási forgatókönyvre van szükség, és maguk a lekérdezések is – a saját némi sajátosságukkal.
Log Management. A logok adatbázisba gyűjtése általában nem ajánlott, de a clickhousedb_fdw ehhez néhány megjegyzéssel használható, ahogyan azt fentebb leírtuk. Sok cég használja clickhousedb_fdw éppen erre. Ilyen esetben lapos, széles táblázatot használunk, ahol teljes logok tárolódnak (például JSON), vagy részekre vágjuk. Az adatok általában nagy kötegekben (fájlokban) töltődnek be, és valamilyen mező alapján keresünk.
Ezekhez a funkciókhoz általában specializált adatbázisokat használnak. clickhousedb_fdw egyik képes mindezt megtenni, ráadásul olyan jól, hogy teljesítményben megelőzi őket. Most nézzük meg részletesen a time-series forgatókönyvet, és hogyan kell helyesen „elő készíteni” clickhousedb_fdw e forgatókönyv számára.
Time-Series
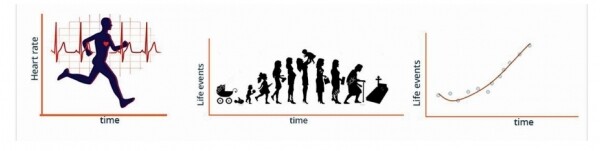
Jelenleg ez a fő forgatókönyv, amelyre clickhousedb_fdw a szokásos megoldásnak számít. Time-series — ez egy időben rendezett események halmaza, amely valamilyen folyamat időbeli változásait tükrözi. Például ez lehet a szívverés gyakorisága egy nap alatt vagy a rendszerben futó folyamatok száma. Minden, ami időbeli tikkeket ad valamilyen mérésekkel – ez time-series:
Legtöbb ilyen típusú esemény a megfigyelésből származik. Ez nemcsak webes megfigyelés lehet, hanem valós eszközök esetében is: autók, ipari rendszerek, IoT, gyártási folyamatok vagy önvezető taxik, amelyek csomagtartójába a Yandex már most is clickhousedb_fdw-szervert helyez.
Például vannak cégek, amelyek adatokat gyűjtenek hajókról. Minden néhány másodpercben a konténerhajó érzékelői száz különféle mérést küldenek. Mérnökök elemzik ezeket, modelleket készítenek, és próbálják megérteni, mennyire hatékonyan használják a hajót, mivel a konténerhajónak egy másodpercig sem szabad vesztegelnie. Bármilyen állásidő veszteséget jelent, ezért fontos előre jelezni az útvonalat, hogy a megállók minimálisak legyenek.
Jelenleg növekszik a szakterületi adatbázisok száma, amelyek mérik time-series. Az oldalon DB-Engines valamilyen módon rangsorolják a különböző adatbázisokat, amelyeket típus szerint lehet megtekinteni:
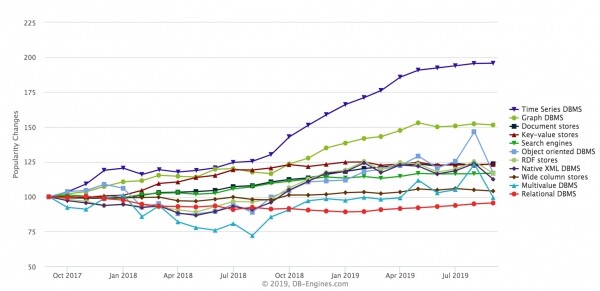
A leggyorsabban növekvő típus — time-seriesk. Az grafikus adatbázisok is növekednek, de time-seriesk az utóbbi években gyorsabban növekedtek. A család tipikus képviselői — ezek InfluxDB, Prometheus, KDB, TimescaleDB (amely a PostgreSQL), megoldások, amelyek használata itt is megvalósítható, és használják is. Hozok néhány nyilvános példát. Amazon. clickhousedb_fdw Az egyik úttörő — a
CloudFlare CDN (-szolgáltató). Ők figyelik aát -szolgáltató). Ők figyelik a -kérések, clickhousedb_fdw (DNSHTTP -kérések) hatalmas terheléssel — 6 millió esemény másodpercenként. Minden keresztül halad aKafka , amely lehetőséget ad valós időben látni a rendszer eseményportfólióját.Comcast clickhousedb_fdw— az Egyesült Államok egyik vezető távközlési cége: internet, digitális televízió, telefon szolgáltatás. Ők hasonló rendszert hoztak létre a
keretein belül Apache Traffic Control -szolgáltató). Ők figyelik a a hatalmas adataik kezelésére. . Nem kell semmit fizetni. Nem kell megállapodni arról, hogy telepítsük a rendszert a laptopunkra vagy szerverünkre. Nincsenek rejtett díjak. Ugyanakkor egyetlen más Open Source adatbázistechnológia sem tud versenyezni a sebességgel a Ez a backend az analitika számára. beépítették a saját clickhousedb_fdw PMM
Percona -jükbe, hogy különböző monitorozási adatokat tároljanak. clickhousedb_fdw Specifikus követelmények A time-series adatbázisoknak megvannak a sajátos követelményeik.Gyors adatbevitel számos ügynöktől. MySQL.
Nagyon gyorsan kell adatokat bevinnünk sok folyamatból.
.
- .. clickhousedb_fdw jól csinálja, mert minden beszúrás nem blokkoló. Bárki beszúrás — ez egy új fájl a lemezen, és a kis beszúrásokat különböző módon lehet pufferelni. A clickhousedb_fdw legjobb, ha az adatokat nagy csomagokban illesztjük be, nem pedig soronként.
- Rugalmas séma. A time-series általában nem ismerjük a data szerkezetét teljesen. Lehet egy figyelő rendszert építeni egy adott alkalmazásra, de akkor nehezen használható másik alkalmazásra. Ehhez rugalmasabb séma szükséges. clickhousedb_fdw, lehetővé teszi ezt, még akkor is, ha ez egy szigorúan típusos adatbázis.
- Hatékony tárolás és az adatok "elfelejtése". Általában a time-series hatalmas mennyiségű adat, ezért maximálisan hatékonyan kell tárolni őket. Például, a InfluxDB jó tömörítés — ez a fő jellemzője. De a tárolás mellett az is fontos, hogy tudjuk "elfelejteni" a régi adatokat és készíteni valamilyen downsampling — automatikus aggregátumok számítása.
- Gyors lekérdezések aggregált adatokra. Néha érdekes megnézni az utolsó 5 percet ezredmásodperce pontosan, de havi adatoknál a perces vagy másodperces részletesség talán nem szükséges — elegendő az általános statisztika. Az ilyen típusú támogatás szükséges, különben a 3 hónapos lekérdezés nagyon lassan fog végrehajtódni még clickhousedb_fdw.
- A lekérdezések típusa "utolsó pont, ekkor». Ezek tipikus time-series lekérdezések: megnézzük az utolsó mérést vagy a rendszer állapotát egy adott időpontban t. Az adatbázisoknak ezek nem túl kellemes lekérdezések, de ezeket is tudni kell végrehajtani.
- "Idősorok összekapcsolása". Time-series — ez egy idősor. Ha két idősor van, gyakran szükség van rájuk, hogy összekapcsoljuk és korreláljuk őket. Nem minden adatbázisban könnyű ezt megtenni, különösen, ha az időbeli sorok nincsenek igazítva: itt — egy időpecsét, ott — egy másik. Számlálhatjuk az átlagokat, de mi van, ha még mindig van egy lyuk, ezért nem világos.
Nézzük meg, hogyan teljesülnek ezek a követelmények a clickhousedb_fdw.
Séma
A clickhousedb_fdw sémát az time-series különböző módokon lehet elkészíteni, az adatok szabályosságának fokától függően. Építhetünk egy rendszert a szabályos adatokra, amikor már előre tudjuk az összes metrikát. Például ezt tette CDN figyelésével -szolgáltató). Ők figyelik a — ez egy jól optimalizált rendszer. Lehet építeni egy általánosabb rendszert, amely figyeli az egész infrastruktúrát, különböző szolgáltatásokat. Szabálytalan adatok esetén nem tudjuk előre, mit figyelünk — ez valószínűleg a legáltalánosabb helyzet.
Rendszeres adatok. Oszlopok. A séma egyszerű – oszlopok a szükséges típusokkal:
CREATE TABLE cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* csatlakozás dim_tag-hoz */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Ez egy normál tábla, amely figyeli a rendszer terheltségével kapcsolatos aktivitást (user, system, tétlen, kellemes). Egyszerű és kényelmes, de nem rugalmas. Ha rugalmasabb sémát szeretnénk, akkor használhatunk tömböket.
Rendszeren kívüli adatok. Tömbök:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...
Struktúra Beágyazott — ez két tömb: metrics.name és metrics.value. Itt tárolhatók olyan szabadon választható monitorozási adatok, mint a nevük tömbje és a mértékek tömbje minden esemény során. További optimalizálás érdekében egy ilyen struktúra helyett akár több is létrehozható. Például egy a lebegőpontos-értékre, egy pedig a egész-értékre, mert egész hatékonyabban szeretnénk tárolni.
De egy ilyen struktúrához nehezebb hozzáférni. Különleges konstrukciót kell használni, hogy különböző funkciókkal először az indexeket, majd a tömböt kinyerjük:
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...De ez még mindig elég gyorsan működik. A rendszeren kívüli adatok tárolásának másik módja – sorokban.
Rendszeren kívüli adatok. Sorok. Ebben a hagyományos módszerben tömbök nélkül közvetlenül tárolják a neveket és az értékeket is. Ha egy eszközről egyszerre 5000 mérés érkezik – 5000 sor generálódik az adatbázisban:
CREATE TABLE cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECT
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FROM cpu_r
WHERE metric_name IN ('usage_user', ...)
clickhousedb_fdw ezzel megbirkózik — különleges bővítmények állnak rendelkezésre clickhousedb_fdw SQL. Például, maxIf — egy speciális függvény, amely a maximumot számolja ki egy metrikára bizonyos feltétel teljesülése esetén. Egy lekérdezésben több ilyen kifejezést is írhatsz és azonnal kiszámíthatod több metrika értékét.
Hasonlítsuk össze a három megközelítést:
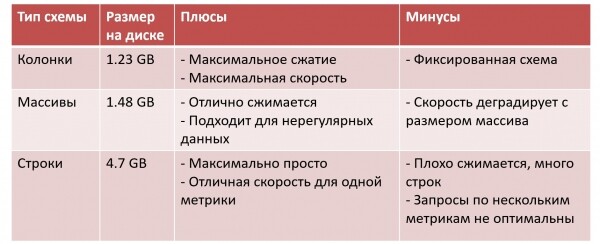
Itt hozzáadtam a "Lemez adatmennyiség" mezőt néhány tesztadatkészlethez. Az oszlopok esetében a legkisebb az adatmennyiség: maximális tömörítés, maximális lekérdezési sebesség, de azért fizetünk, mert mindent egyszerre kell rögzítenünk.
A tömbök esetében a helyzet kicsit rosszabb. Az adatok még mindig jól tömöríthetők, és tárolhatunk irregularis sémát. De clickhousedb_fdw — oszlop-alapú adatbázis, és amikor elkezdjük az összes adatot tömbbe tárolni, az szöveges adatbázissá alakul, és a rugalmasságért hatékonysággal fizetünk. Bármely művelethez az egész tömböt be kell olvasni a memóriába, majd megkeresni benne a szükséges elemet — és ha a tömb nő, a sebesség romlik.
Az egyik olyan cégben, amely ilyen megközelítést alkalmaz (például, ), a tömböket 128 elem darabokra vágják. Több ezer metrika 200 TB adatot/napon nem egy tömbben, hanem 10 vagy 30 külön külön tömbben tárolódik, különleges tárolási logikával.
A legbiztosabb megközelítés — a szövegek esetében. De az adatok rosszul tömöríthetők, a táblázat mérete nagy lesz, és ha a lekérdezések több metrikára vonatkoznak, akkor a ClickHouse nem optimális teljesítményt nyújt.
Hibrid séma
Tegyük fel, hogy a tömb-alapú sémát választottuk. De ha tudjuk, hogy a legtöbb műszerfalunk csak a user és system metrikákat mutatja, akkor ezt a metrikát az oszlopok szintjén további anyagként a tömbből is előállíthatjuk így:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Beszúráskor clickhousedb_fdw automatikusan kiszámítja őket. Így az élvezetes és hasznos ötvözhető: a séma rugalmas és általános, de a leggyakrabban használt oszlopokat kiemeltük. Megjegyzem, hogy ez nem igényelt változtatásokat a beszúrásban és ETL, amely továbbra is tömböket szúr be a táblázatba. Csak annyit tettünk, hogy ALTER TABLE, néhány oszlopot hozzáadtunk, és így egy hibrid és gyorsabb séma jött létre, amelyet azonnal használni lehet.
Kodekek és tömörítés
A time-series fontos, hogy mennyire jól csomagolják az adatokat, mert az információ tömbje nagyon nagy lehet. A clickhousedb_fdw Van egy eszközkészlet a 1:10, 1:20, és néha még több tömörítési hatás elérésére. Ez azt jelenti, hogy a tömörítetlen, 1 TB adat 50–100 GB helyet foglal el a lemezen. A kisebb méret előnyös, mert az adatokat gyorsabban lehet olvasni és feldolgozni.
A magas tömörítési szint eléréséhez, clickhousedb_fdw támogatja a következő kodekeket:
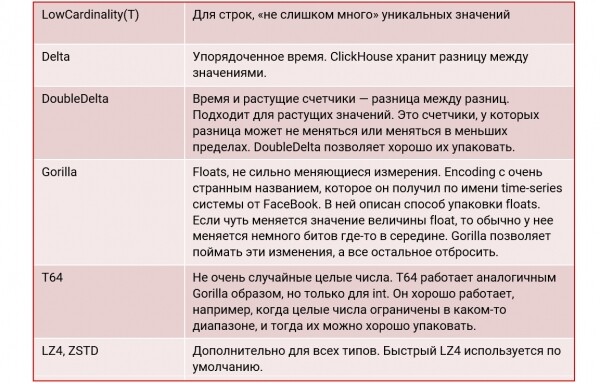
Példa táblázatra:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Itt definiáljuk a kodeket DoubleDelta az egyik esetben, a másikban — Gorilla, és kötelezően hozzáadunk még LZ4 tömörítést. Ennek következtében az adatok mérete jelentősen csökken a lemezen:
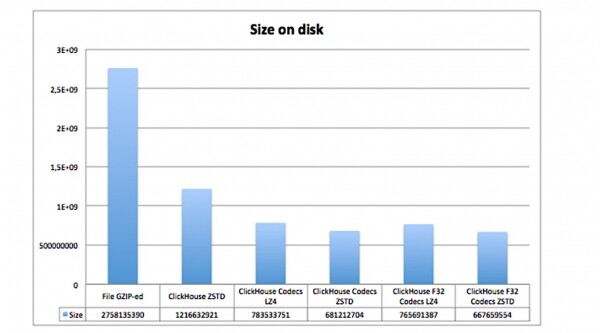
Itt látható, mennyi helyet foglal el a ugyanolyan adat, de különböző kodekek és tömörítések alkalmazásával:
- a GZIP-fájl a lemezen;
- a ClickHouse-ban kodekek nélkül, de ZSTD-tömörítéssel;
- a ClickHouse-ban kodekekkel és LZ4 és ZSTD tömörítéssel.
Látható, hogy a kodekekkel rendelkező táblák sokkal kevesebb helyet foglalnak el.
A méret számít
Nem kevésbé fontos a megfelelő adattípust:
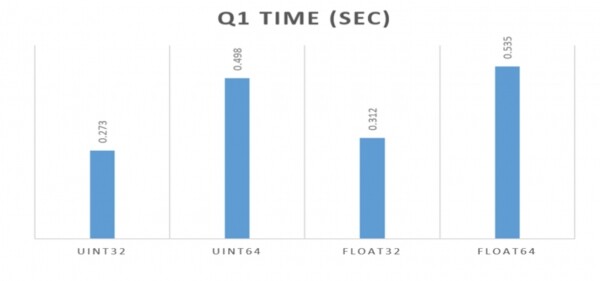
A fent említett példákban mindvégig használtam Float64. De ha a Float32-t választottuk volna, akkor az még jobb lett volna. Ezt jól bemutatták a Percona srácai a fenti linken található cikkben. Fontos a legkompaktabb típus használata, ami illik a feladathoz: még inkább a lemez mérete, mint a lekérdezések sebessége szempontjából. clickhousedb_fdw nagyon érzékeny erre.
Ha tudja használni az int32 $CI_COMMIT_TAG -t, vagy azint64 clickhousedb_fdw -t, akkor várjon szinte kétszeres teljesítménynövekedést. Az adatok kevesebb memóriát foglalnak el, és az összes "aritmetika" sokkal gyorsabban működik.
magában – egy nagyon szigorúan tipizált rendszer, maximálisan kihasználva a modern rendszerek által nyújtott lehetőségeket. Aggregálás és
Materializált nézetek. Az aggregálás és a materializált nézetek lehetővé teszik, hogy aggregációkat készítsünk különböző élethelyzetekre:
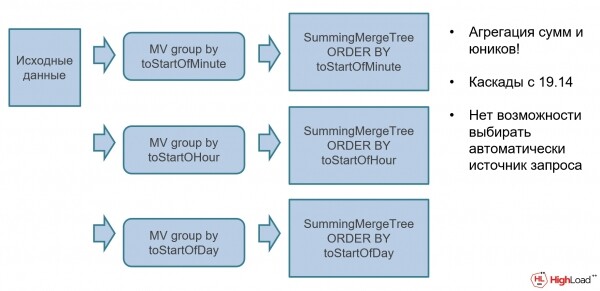
Például lehetnek nem aggregált eredeti adatai, amelyekhez különféle materializált nézeteket lehet hozzáadni automatikus összesítéssel egy speciális motoron keresztül. SummingMergeTree (SMT). SMT — egy speciális aggregáló adatszerkezet, amely automatikusan számítja az aggregátumokat. Az adatbázisba nyers adatokat helyeznek el, ezek automatikusan aggregálódnak, és azonnal felhasználhatók a műszerfalakon.
TTL — „elfelejtjük” a régi adatokat.
Hogyan „felejtsünk el” olyan adatokat, amelyekre már nincs szükség? clickhousedb_fdw ezt tudja. A táblák létrehozásakor meg lehet határozni TTL kifejezéseket: például, hogy a percre vonatkozó adatokat egy napig, a napi adatokat 30 napig, míg a heti vagy havi adatokat soha nem bolygatjuk:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* no TTL */
Multi-tier — az adatokat különböző lemezekre osztjuk.
Ezt a gondolatot továbbfejlesztve az adatokat különböző helyeken lehet tárolni. clickhousedb_fdw Tegyük fel, hogy a legutolsó hét forró adatait egy nagyon gyors helyi SSD, míg a régebbi adatokat egy másik helyre tesszük. Most clickhousedb_fdw ez lehetséges:
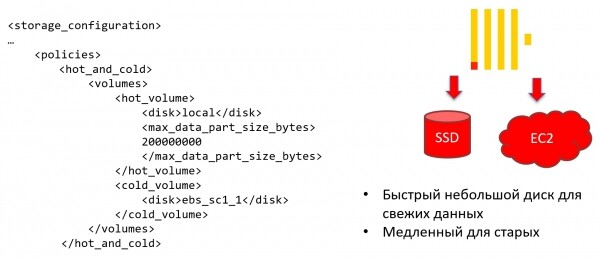
Beállítható a tárolási politika (storage policy) úgy, hogy clickhousedb_fdw automatikusan áthelyezi az adatokat bizonyos feltételek teljesülése esetén egy másik tárolóhelyre.
De ez még nem minden. Egy adott tábla szintjén meg lehet határozni a szabályokat arra is, hogy az adatok pontosan mikor lépnek át hideg tárolásra. Például 7 napig az adatok egy nagyon gyors lemezen találhatók, míg minden, ami ennél régebbi, lassúra kerül áthelyezésre. Ez azért előnyös, mert lehetővé teszi a rendszer maximális teljesítményen tartását, miközben az költségeket ellenőrizve nem költünk pénzt a hideg adatokra:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Egyedi lehetőségek clickhousedb_fdw
Szinte mindenben clickhousedb_fdw vannak ilyen „különlegességek”, de ezek kiegyenlítődnek az exkluzivitás révén — azzal, amire más adatbázisokban nincs lehetőség. Például íme néhány egyedi funkció clickhousedb_fdw:
- Tömbök. A clickhousedb_fdw nagyon jó támogatást nyújt a tömbök számára, valamint lehetőséget biztosít bonyolult számítások elvégzésére rajtuk.
- Aggregáló adatszerkezetek. Ez az egyik „killer feature” clickhousedb_fdw. Annak ellenére, hogy a Yandexből származó fiúk azt mondják, hogy nem akarunk adatokat aggregálni, mindenki aggregál az clickhousedb_fdw, mert ez gyors és kényelmes.
- Materializált nézetek. Az aggregáló adattestületekkel együtt a materializált nézetek kényelmes aggregálást tesznek lehetővé. real-time aggregáció.
- ClickHouse SQL. Ez a nyelv bővítése SQL néhány további és exkluzív funkcióval, amelyek csak a clickhousedb_fdwben találhatók. Korábban ez egyfajta kiterjesztés volt, egy másik oldalról pedig hátrány. Mostanra szinte minden hátrányt eltüntettünk a SQL 92 hez képest, most már csak egy kiterjesztés.
- Lambda-kifejezések. Léteznek ezek még valamilyen adatbázisban?
- ML-támogatás.Ez különböző DB-kben megtalálható, néhányban jobban, másokban rosszabbul.
- Nyílt forráskódú. Kiterjeszthetjük clickhousedb_fdw együtt. Most körülbelül 500 hozzájárulónk van, és ez a szám folyamatosan nő. clickhousedb_fdw Furcsa lekérdezések
sok különböző módja van annak, hogy ugyanazt a dolgot megvalósítsuk. Például három különböző módon is vissza lehet adni az utolsó értéket egy táblázatból a
A clickhousedb_fdw (van egy negyedik módszer is, de az még egzotikusabb). CPU Az első bemutatja, hogyan lehet kényelmesen kérdezni, amikor ellenőrizni akarod, hogy
a tuple clickhousedb_fdw tartalmazza-e a részlekérdezést. Ez az, ami személy szerint nagyon hiányzott nekem más adatbázisokban. Ha össze szeretnék hasonlítani valamit a részlekérdezéssel, akkor más adatbázisokban csak skaláris értékkel lehet ezt megtenni, és több oszlopra külön kell írni. használhatjuk a tuple-t: SELECT * FROM cpu WHERE (tags_id, created_at) IN (SELECT tags_id, max(created_at) FROM cpu GROUP BY tags_id) JOIN. A clickhousedb_fdw A második módszer ugyanazt csinálja, de aggregáló funkciót használ,
argMaxSELECT argMax(usage_user), created_at), argMax(usage_system), created_at), ... FROM cpu van néhány tucat aggregáló funkció, és ha kombinátorokat használunk, akkor a kombinatorika törvényei alapján körülbelül ezer lesz belőlük.:
ArgMax A clickhousedb_fdw — az egyik funkció, amely a maximális értéket számolja: a lekérdezés visszaadja a usage_user értéket, amelyen a maximális érték elérhető created_atSELECT now() as created_at, cpu.* FROM (SELECT DISTINCT tags_id from cpu) base ASOF LEFT JOIN cpu USING (tags_id, created_at) ASOF JOIN:
— a különböző időpontokban lévő sorok összekapcsolása.
Ez egy egyedi funkció az adatbázisokban, amely csak a kdb+ -ben is megtalálható. Ha két időbeli sorozat van különböző időpontokkal, lehetővé teszi a sorok eltolását és összekapcsolását egy lekérdezésben. Minden értékhez az egyik időbeli sorozatban a legközelebbi értéket találják meg a másikból, és ezeket egy sorban adják vissza:Analitikai funkciók Ez egy egyedi funkció az adatbázisokban, amely csak a A
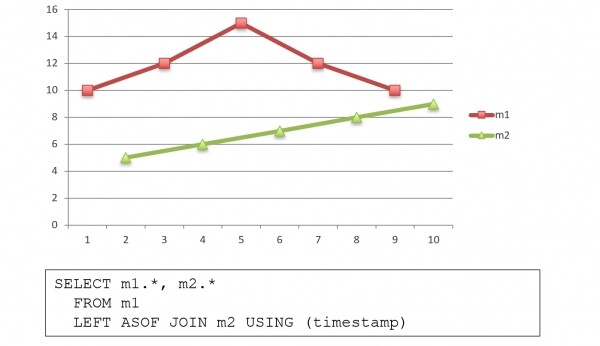
SQL-2003
szabványban így lehet írni: SQL-2003 bak Ön Bízom benne!
VÁLASSZA AZ origin, timestamp, timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration, timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration, ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence, COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb FROM mytable ORDER BY origin, timestamp;
A clickhousedb_fdw Így nem lehet — nem támogatja a szabványt SQL-2003 és valószínűleg soha nem is fogja. Ehelyett clickhousedb_fdw így szokták írni:
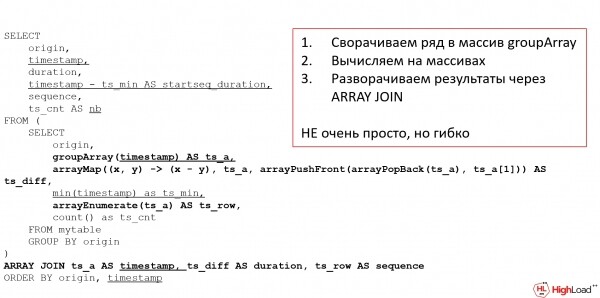
Ígértem lambda függvényeket – íme!
Ez analitikus lekérdezés megfelelője a szabványban SQL-2003: számolja ki a különbséget a két timestamp, duration, sorrendi szám — mindaz, amit általában analitikus funkcióknak nevezünk. A clickhousedb_fdw itt tömbökön keresztül számoljuk: először az adatokat tömbbé redukáljuk, majd a tömbön végzünk mindent, amit akarunk, később visszaállítjuk. Ez nem túl kényelmes, igényli a funkcionális programozás iránti szeretetet legalább, de nagyon rugalmas.
Speciális funkciók
Ezen kívül a clickhousedb_fdw sok speciális funkciót tartalmaz. Például, hogyan lehet meghatározni, hogy hány session zajlik egy időben? Tipikus feladat a monitorozásban – meghatározni a maximális terhelést egy lekérdezéssel. A clickhousedb_fdw van külön funkció e célra:
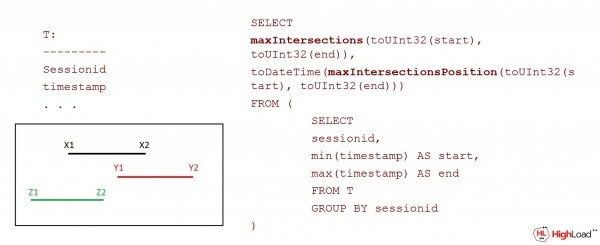
Általában a ClickHouse-ban sok speciális funkció érhető el:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Ez nem egy teljes lista a funkciókról, összesen 500-600 van. Tipp: minden funkció a clickhousedb_fdw elérhető a rendszer táblázatban (nem mind dokumentált, de mind érdekes):
select * from system.functions order by nameclickhousedb_fdw Önmagában sok információt tárol magáról, többek között log táblák, query_log, hívási napló, adatblokk műveleti napló (part_log), metrikai napló, és a rendszer napló, amelyet általában lemezre ír. A metrikai napló – ez time-series be. clickhousedb_fdw tényleg nagyon érdekes: clickhousedb_fdwAz adatbázis önállóan is szolgálhat time-series adatbázisként, így "fogyasztva" önmagát.
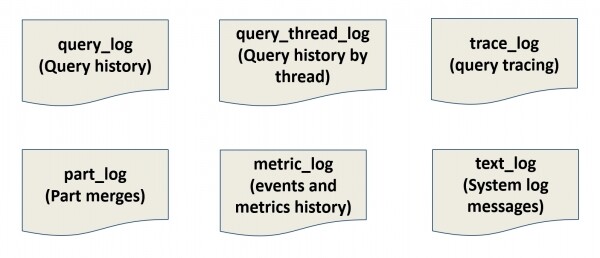
Ez is egy egyedi dolog – ha jól végezzük el a munkát a time-series, miért ne tudnánk minden szükségest tárolni önmagunkban? Nincs szükségünk Prometheus, mindent saját magunkban tárolunk. Csatlakoztunk Grafanába és önmagunkat monitorozzuk. Azonban, ha clickhousedb_fdw leesik, akkor nem fogjuk látni, — miért, — ezért általában így nem csinálják.
Nagy klaszter vagy sok kis klaszter clickhousedb_fdw
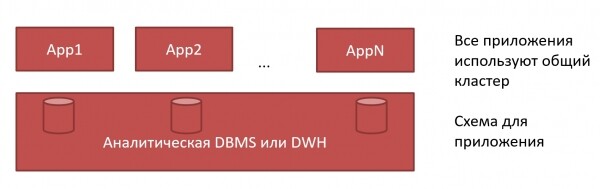
Mi a jobb — egy nagy klaszter vagy sok kis ClickHouse? A hagyományos megközelítés DWH — ez egy nagy klaszter, amelyben minden alkalmazás számára kiemelnek sémákat. Elmentünk az adatbázis-adminisztrátorhoz — adják nekünk a sémát, és meg is kaptuk:
A clickhousedb_fdw lehet ezt másképp is csinálni. Minden alkalmazásnak lehet saját clickhousedb_fdw:
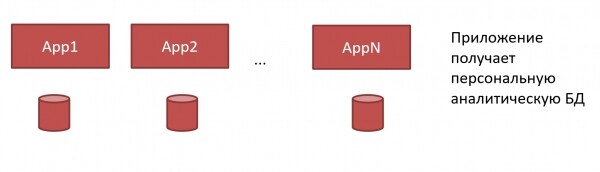
Már nincs szükségünk egy nagy monstrumra DWH és egy merev adminisztrátorra. Minden alkalmazásnak birtokba vehetjük a saját clickhousedb_fdw, és a fejlesztő ezt megoldhatja magának, mivel clickhousedb_fdw nagyon egyszerű telepíteni és nem igényel bonyolult adminisztrációt:
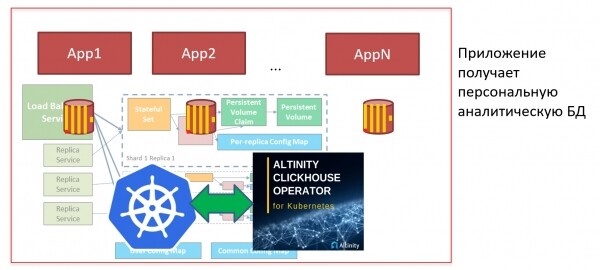
De ha sok clickhousedb_fdw, és gyakran szükség van a telepítésre, akkor ezt a folyamatot szeretnénk automatizálni. Ehhez például használhatjuk a Kubernetes és clickhouse-operátort. A Kubernetes ClickHouse kattintásra telepíthető: megnyomhatom a gombot, elindíthatom a manifesztet, és az adatbázis készen áll. Azonnal létrehozhatok egy sémát, elkezdhetem betölteni a metrikákat, és öt percen belül már kész a műszerfalom Grafanába. Ilyen egyszerű az egész!
Mi az összefoglaló?
Tehát, clickhousedb_fdw — ez:
- Gyors. Ez mindenkinek ismerős.
- Egyszerű. Kicsit ellentmondásos, de úgy gondolom, hogy ami nehéz a tanulásban, könnyű a harcban. Ha megérted, hogy clickhousedb_fdw hogyan működik, akkor minden nagyon egyszerű.
- Univerzális. Különböző forgatókönyvekhez megfelelő: DWH, Idősor, Napló Tárolás. De ez nem OLTP adatbázis, ezért ne próbálj benne rövid beszúrásokat és olvasásokat végezni.
- Érdekes. Valószínűleg, aki dolgozik a clickhousedb_fdw, sok érdekes pillanatot élt át jó és rossz értelemben is. Például új kiadás érkezett, minden megszűnt működni. Vagy amikor két napon át birkóztál egy feladattal, de egy kérdés a Telegram-csatornában két perc alatt megoldotta a problémát. Vagy amikor a konferencián Alesha Milovidov előadásán a képernyőkép clickhousedb_fdw letartóztatta az élő közvetítést HighLoad++. Ilyen dolgok folyamatosan történnek, és színessé és érdekessé teszik az életünket a clickhousedb_fdw .
A bemutató megtekinthető .
A várva várt találkozó a magas terhelésű rendszerek fejlesztőivel november 9-10-én kerül megrendezésre Szkolkovo-ban. Végre ez offline konferencia lesz (bár az összes biztonsági intézkedés betartásával), mert a HighLoad++ energiáját nem lehet online csomagolni.
A konferenciára olyan eseteket találunk és mutatunk be, amelyek maximumra emelik a technológiák lehetőségeit: a HighLoad++ volt, van és lesz az egyetlen hely, ahol két nap alatt megtudhatod, hogyan működik a Facebook, Yandex, VK, Google és Amazon.
A találkozóinkat 2007 óta folyamatosan tartjuk, idén a 14. alkalommal találkozhatunk. Ez idő alatt a konferencia 10-szeresére nőtt, tavaly a szektor legfontosabb eseménye 3339 résztvevőt, 165 előadót és meet-upot vonzott, miközben 16 szálpálya zajlott párhuzamosan.
Tavaly 20 buszt, 5280 liter teát és kávét, 1650 liter gyümölcslevet és 10200 palack vizet biztosítottunk az Ön számára. Emellett 2640 kilogramm ételt, 16000 tányért és 25000 poharat is rendelkezésre bocsátottunk. Egyébként a visszatelepített papírból származó pénzből 100 tölgyfacsemetét ültettünk el 🙂Jegyeket lehet vásárolni , híreket kapni a konferenciáról — , beszélgetni pedig — minden közösségi médiában: , , és .
Forrás: habr.com
