

Mindenki helló! Én backend fejlesztő vagyok, Java + Spring mikroservízeket írok. A Tinkoff cégnél belső termékek fejlesztésére összpontosító csapat egyikében dolgozom.
A csapatunkban gyakran felmerül a kérdés a DB lekérdezések optimalizálásával kapcsolatban. Mindig szeretnénk egy kicsit gyorsabb lenni, de nem mindig lehet elérni jól megtervezett indexekkel — néha alternatív megoldásokat kell keresnünk. Egyik ilyen keresés közben a rendelkezésre álló ésszerű optimalizálásokról találtam rá , az SQL Performance Explained könyv szerzőjére. Ez az a ritka blogfajta, ahol az összes írást folyamatosan lehet olvasni.
Szeretném lefordítani nektek Markus egy rövid írását. Ezt egyfajta kiáltványként is lehet nevezni, amely arra törekszik, hogy felhívja a figyelmet a régi, de még mindig aktuális problémára, az SQL offset művelet teljesítményére.
Néhány helyen kiegészítem az írót magyarázatokkal és megjegyzésekkel. Minden ilyen helyet a „jegyzet” szóval fogok jelölni a tisztánlátás érdekében.
Rövid bevezetés
Gondolom, sokan tudják, mennyire problémás és lassú tud lenni a lapozós selectek használata offsettel. Tudjátok, hogy ez viszonylag egyszerűen helyettesíthető egy hatékonyabb konstrukcióval?
Tehát az offset kulcsszó azt jelzi az adatbázisnak, hogy hagyja figyelmen kívül az első n rekordot a lekérdezésben. Az adatbázisnak azonban még mindig el kell olvasnia ezeket az első n rekordot a lemezen, ráadásul a megadott sorrendben (jegyzet: alkalmazni kell a rendezést, ha van), és csak ezután lehetséges visszaadni a n+1-től kezdődő rekordokat. A legérdekesebb, hogy a probléma nem a konkrét DBMS implementációjában rejlik, hanem az eredeti standard definíciójában:
…a sorokat elsőként a <order by záradék> szerint rendezik, majd a <result offset záradék> elejéről elhagyott rekordok számát korlátozzák...
-SQL:2016, 2. rész, 4.15.3 Származtatott táblák (jegyzet: jelenleg a legelterjedtebb standard)
Itt a kulcsszó az, hogy az offset egyetlen paramétert fogad — a figyelmen kívül hagyott rekordok számát. Ennek megfelelően a DBMS-nek csak az összes rekordot kell beszereznie, majd elvetnie a feleslegeseket. Nyilvánvaló, hogy ez a definíció az offsetről felesleges munkát okoz. Itt még az sem számít, hogy SQL-ez, vagy NoSQL.
Még egy kis fájdalom
Az offset problémák itt nem érnek véget, és itt van, miért. Ha a lemezről két adatlap között egy másik művelet új bejegyzést helyez el, mi történik ebben az esetben?
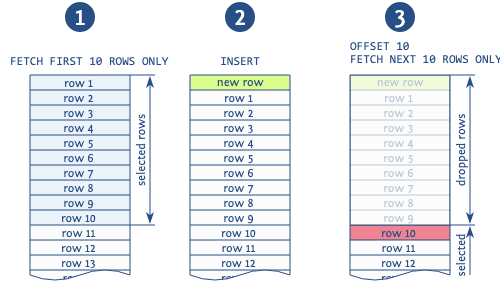
Amikor offsetet használunk a korábbi lapokról való bejegyzések kihagyására, új bejegyzés hozzáadása esetén, valószínűleg duplikáltakat kapunk (megjegyzés: ez akkor lehetséges, amikor lapozva olvasunk az order by kifejezést használva, akkor az új bejegyzés a kimenetünk közepébe is bekerülhet).
A kép szemléletesen ábrázolja ezt a helyzetet. Az adatbázis az első 10 bejegyzést olvassa, majd egy új bejegyzés kerül be, ami eltolja az összes olvasott bejegyzést 1-el. Ezt követően az adatbázis a következő 10 bejegyzésből néz egy új lapot, és nem a 11.-től folytatja, ahogyan kellene, hanem a 10.-től, így megduplázva ezt a bejegyzést. Vannak más anomáliák is, amelyek ezen kifejezés használatához kapcsolódnak, de ez a legelterjedtebb.
Ahogyan már kiderült, ez nem önálló DBMS vagy annak megvalósításainak problémája. A probléma a SQL szabvány szerinti lapozás meghatározásában rejlik. Megmondjuk az adatbázisnak, melyik oldalt kell lekérnie, vagy mennyi bejegyzést kell kihagynia. Az adatbázis egyszerűen nem képes optimalizálni egy ilyen lekérdezést, mivel túl kevés információ áll rendelkezésre hozzá.
Érdemes megjegyezni, hogy ez nem egy adott kulcsszó problémája, hanem inkább a lekérdezés szemantikája. Van még néhány azonos problémákat okozó szintaxis:
- Az offset kulcsszó, ahogyan korábban említettük.
- A két kulcsszóból álló limit [offset] szerkezet (bár a limit önmagában nem is olyan rossz).
- Szűrés alsó határok mentén, amely sorok számozásán alapul (például row_number(), rownum stb.).
Ezek a kifejezések egyszerűen azt mondják, hány sort kell kihagyni, nincs további információ vagy kontextus.
A cikk további részében az offset kulcsszó mindezek a változatok általános kifejezésére szolgál.
Élet OFFSET nélkül
Most pedig képzeljük el, milyen lenne a világunk ezek a problémák nélkül. Kiderül, hogy az offset nélküli élet nem is olyan nehéz: a select használatával csak azokat a sorokat választhatjuk ki, amelyeket még nem láttunk (megjegyzés: tehát azokat, amelyek nem voltak az előző oldalon), a where feltétel segítségével.
Ebben az esetben az a tény szolgál alapul, hogy a szelektálások egy rendezett halmazon hajtódnak végre (a régi jó order by). Mivel rendezett halmazunk van, igazán egyszerű szűrőt alkalmazhatunk, hogy csak azokat az adatokat hozzuk el, amelyek az előző oldal utolsó rekordja mögött találhatók:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
Ez az egész megközelítés lényege. Természetesen, amikor sok oszlop szerint történik a rendezés, minden szórakoztatóbb, de az ötlet ugyanaz. Fontos megjegyezni, hogy ez a konstrukció sok esetben alkalmazható -megoldások.
Ez a megközelítés seek method vagy keyset pagination néven ismert. Az adatokat olvasó problémát (megjegyzés: rekord létrejötte az oldalak között, amelyről korábban szó volt) megoldja, és persze, amit mindannyian szeretünk, gyorsabban és stabilabban működik, mint a klasszikus offset. A stabilitás abban rejlik, hogy a kérés feldolgozási ideje nem nő arányosan a lekért táblázat számával (megjegyzés: ha szeretnél többet megtudni a különböző paginációs megközelítések működéséről, érdemes . Ott hasonló összehasonlító benchmarkokat találhatsz a különböző módszerekről.
Az egyik dián , hogy a kulcsok szerinti pagináció természetesen nem mindentudó — vannak korlátai. A legjelentősebb az, hogy nincs lehetősége véletlenszerű oldalak olvasására (megjegyzés: nem sorrendben). Azonban a végtelen görgetés korában (megjegyzés: a frontend-en) ez nem nagy probléma. Az oldal számának megadása a kattintáshoz — bármilyen esetben rossz megoldás a UI fejlesztésénél (megjegyzés: a cikk szerzőjének véleménye).
De mi a helyzet az eszközökkel?
A kulcsok szerinti pagináció sok esetben nem alkalmas, mivel a módszerhez nincsen eszközi támogatás. A fejlesztési eszközök többsége, beleértve a különböző keretrendszereket, nem ad lehetőséget arra, hogy pontosan melyik módon történjék a pagináció.
A helyzetet súlyosbítja, hogy az említett módszer folyamatos támogatást igényel a használt technológiákban — kezdve az adatbázis-kezelő rendszertől, egészen az AJAX-kérések végrehajtásáig a böngészőben a végtelen görgetés során. Ahelyett, hogy csak az oldal számát kellene megadni, most már a kulcsok halmazát kell megadni minden oldalra egyszerre.
A kulcsszavas lapozást támogató keretrendszerek száma fokozatosan növekszik. Íme, ami jelenleg elérhető:
- Java-hoz;
- Ruby-hoz;
- és Django-hoz;
- Python-hoz;
- — kriterium API JPA megvalósításokhoz;
- Perl-hez;
- , мапер для Node.js .
(Megjegyzés: bizonyos linkek eltávolításra kerültek, mivel a fordítás időpontjában egyes könyvtárak 2017–2018 óta nem frissültek. Ha érdekli, nézzen utána az eredeti forrásnak.)
Ezen a ponton van szükség a segítségére. Ha olyan keretrendszert fejleszt vagy tart fenn, amely bármilyen szempontból használja a lapozást, kérem, sürgetem, hogy biztosítson natív támogatást a kulcsszavas lapozáshoz. Ha kérdése van, vagy segítségre van szüksége, szívesen segítek (, , ) (megjegyzés: tapasztalataim szerint Markus valóban lelkesedik a téma terjesztéséért).
Ha viszont olyan kész megoldásokat használ, amelyek, véleménye szerint, érdemesek a kulcsszavas lapozás támogatására, készítsen egy kérdést, vagy akár javasoljon egy kész megoldást, ha lehetséges. A linkben ezt a cikket is megemlítheti.
Zárás
Az egyszerű és hasznos kulcsszavas lapozás ritkaságának oka nem a technikai megvalósítás nehézsége vagy komolyabb erőfeszítések szükségessége. A fő ok az, hogy sokan hozzászoktak az offset alapú megközelítéshez — ezt a megközelítést maga a szabvány diktálja.
Ennek következtében kevesen gondolkodnak el a lapozási megközelítések megváltoztatásán, és emiatt az eszközszintű támogatás a keretrendszerek és könyvtárak részéről gyengén fejlődik. Tehát, ha önnek is fontos a nem offset alapú lapozás ötlete és célja, — segítse ennek terjesztését!
Forrás:
Szerző: Markus Winand
Forrás: habr.com
