

Helló, Habr! Örömmel mutatom be az írás fordítását. Burak Yavuz, Brenner Heintz és Denny Lee szerzőitől, amelyet a kurzus indítását megelőzően készítettek. az OTUS-tól.
Az adatok, akárcsak tapasztalataink, folyamatosan gyűlnek és fejlődnek. Ahhoz, hogy lépést tartsunk, mentális modelljeinknek alkalmazkodnia kell az új adatokhoz, amelyek között új dimenziók találhatóak - új módok, amelyekkel azokra a dolgokra figyelhetünk, amelyekről korábban nem volt tudomásunk. Ezek a mentális modellek alig különböznek a táblák sémáitól, amelyek meghatározzák, hogyan osztályozzuk és dolgozzuk fel az új információkat.
Ez elvezet minket a séma kezelésének kérdéséhez. Ahogy az üzleti feladatok és követelmények idővel változnak, a data struktúrája is változik. A Delta Lake lehetővé teszi új dimenziók egyszerű bevezetését az adatok változásakor. A felhasználóknak egyszerű szemantikához van hozzáférésük a tábláik sémájának kezeléséhez. Ezek az eszközök közé tartozik a séma kényszerítése (Schema Enforcement), amely megvédi a felhasználókat a tábláik véletlen szennyezésétől hibás vagy felesleges adatokkal, valamint a séma fejlődése (Schema Evolution), amely lehetővé teszi új oszlopok automatikus hozzáadását értékes adatokkal a megfelelő helyekre. Ebben a cikkben mélyebben megvizsgáljuk ezeket az eszközöket.
A táblák séma megértése
Minden DataFrame az Apache Sparkban egy sémát tartalmaz, amely meghatározza az adatok formáját, például az adattípusokat, oszlopokat és metainformációkat. A Delta Lake segítségével a táblázat sémája JSON formátumban kerül mentésre a tranzakciós naplóban.
Mi az a séma kényszerítése?
A séma kényszerítése (Schema Enforcement), más néven séma érvényesítés (Schema Validation), egy védelmi mechanizmus a Delta Lake-ben, amely garantálja az adatok minőségét azáltal, hogy elutasítja azokat a rekordokat, amelyek nem felelnek meg a táblázat sémájának. Akárcsak egy népszerű étterem recepción lévő hostesz, aki csak előre foglalt asztalokat fogad, ellenőrzi, hogy az adatbevitelnél minden oszlop szerepel-e a várt oszlopok listáján (más szavakkal, van-e minden egyes oszlopra „foglalás”), és elutasít minden olyan rekordot, amely olyan oszlopokat tartalmaz, amelyek nincsenek a listán.
Hogyan működik a séma kényszerítése?
A Delta Lake sémaellenőrzést alkalmaz íráskor, ami azt jelenti, hogy minden új bejegyzés a táblába össze van vetve a cél-tábla sémájával írás közben. Ha a séma nem kompatibilis, a Delta Lake teljesen visszavonja a tranzakciót (az adatok nem íródnak be), és kivételt generál, hogy értesítse a felhasználót az eltérésről.
A Delta Lake az alábbi szabályokat használja a bejegyzések táblához való kompatibilitásának meghatározására. Írható DataFrame:
- nem tartalmazhat olyan további oszlopokat, amelyek nincsenek a cél-tábla sémájában. És fordítva, rendben van, ha a bemeneti adatok nem tartalmazzák az összes oszlopot a táblából - ezeknek az oszlopoknak egyszerűen null értékeket fognak adni.
- nem lehetnek olyan oszlopok adatainak típusa, amelyek eltérnek a cél-tábla oszlopainak adatainak típusától. Ha a cél-táblában egy oszlop StringType adatokat tartalmaz, de a DataFrame megfelelő oszlopa IntegerType adatokat tartalmaz, a séma kényszerített alkalmazása kivételt generál, és megakadályozza az írási művelet végrehajtását.
- nem lehetnek olyan oszlopnevek, amelyek csak a kis- és nagybetűk különbségén alapulnak. Ez azt jelenti, hogy nem lehetnek ‘Foo’ és ‘foo’ nevű oszlopok egy táblán belül. Bár a Sparkt használhatjuk érzékeny vagy érzéketlen (alapértelmezés szerint) módon a kis- és nagybetűkre, a Delta Lake megőrzi a kis- és nagybetűk érzékenységét, de érzéketlen a séma tárolásának keretében. A Parquet érzékeny a kis- és nagybetűkre az oszlopinformáció tárolása és visszaadása során. Az esetleges hibák, adatkárosodás vagy adatvesztés elkerülése érdekében (amellyel személyesen találkoztunk a Databricks-nél) úgy döntöttünk, hogy hozzáadjuk ezt a korlátozást.
Ennek szemléltetésére nézzük meg, mi történik az alábbi kódban, amikor megpróbálunk néhány újonnan generált oszlopot hozzáadni egy Delta Lake táblához, amelyet még nem állítottak be ezek fogadására.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
A Delta Lake nem automatizálja az új oszlopok hozzáadását, hanem érvényesíti a sémát, és megállítja az írást. A párhuzamok összehasonlításához a Spark kiadja mindkét séma stack trace-jét.
Mi az előnye a séma kényszerített alkalmazásának?
Mivel a séma kényszerített alkalmazása egy meglehetősen szigorú ellenőrzés, kiváló eszköz a tiszta, teljesen átalakított, gyártásra vagy felhasználásra kész adathalmazon való kapuőrként való alkalmazásra. Általában azokra a táblákra vonatkozik, amelyek közvetlenül adatokat szolgáltatnak:
- Gépi tanulási algoritmusok
- BI irányítópultok
- Adat-elemzés és vizualizáló eszközök
- Bármely olyan gyártási rendszeren, amely szigorúan struktúrált, szigorúan típusos szemantikai sémákat igényel.
Az adatok eddig a végső akadályig való előkészítéséhez sok felhasználó egyszerű 'multi-hop' architektúrát használ, amely fokozatosan strukturálja a táblaadataikat. Ennek részleteiről többet olvashat a cikkben
Természetesen a séma kényszerített alkalmazása bárhol felhasználható a folyamatban, de ne feledje, hogy az adatfolyam írása a táblába így frusztráló lehet, mivel például elfelejtheti, hogy egy további oszlopot adott hozzá a bejövő adatokhoz.
Az adatszivárgás megakadályozása
Eddig talán azon tűnődött, miért van akkora felhajtás? Végül is, néha egy váratlan 'séma nem egyezés' hiba akadályozhatja a munkafolyamatát, különösen, ha új a Delta Lake-ben. Miért ne engedhetném meg a sémának, hogy úgy változzon, ahogy szükséges, hogy bármilyen módon fel tudjam írni a DataFrame-met?
Ahogy a régi mondás tartja, 'egy uncia megelőzés többet ér, mint egy font gyógyítás'. Valamikor, ha nem figyel a séma alkalmazására, adatok kompatibilitási problémái bukkannak fel - a látszólag homogén nyersadat-források határeseteket, sérült oszlopokat, helytelenül kialakított leképezéseket vagy más szörnyűségeket rejthetnek, amelyek rémálmainkban jelennek meg. A legjobb megközelítés az, ha megállítja ezeket az ellenségeket a kapu előtt - a séma kényszerített alkalmazásával - és szembenéz velük a fényben, nem pedig később, amikor elkezdenek ólálkodni a kódja sötét mélységeiben.
A séma kényszerített alkalmazása biztosítja, hogy az adatbázis sémája nem változik, hacsak nem erősíti meg a változtatást. Ez megakadályozza az adatok "dilúcióját", amely akkor következhet be, amikor új oszlopokat adnak hozzá olyan gyakran, hogy a korábban értékes, tömör táblázatok elveszítik jelentőségüket és hasznosságukat az adatok áradása miatt. Arra ösztönözve, hogy szándékos legyen, magas sztenderdeket állítson fel és a magas minőséget várja el, a séma kényszerített alkalmazása pontosan azt teszi, amire szánták – segít Önnek megőrizni a lelkiismeretességet, a táblázatai pedig tiszták maradnak.
Ha további megfontolás után úgy dönt, hogy valójában a készülék helyének ismeretére. Ha új oszlopot szeretne hozzáadni – semmi probléma, itt egy egysoros javítás. A megoldás a séma evolúciója!
Mi az a séma evolúció?
A séma evolúciója egy olyan funkció, amely lehetővé teszi a felhasználók számára, hogy könnyedén módosítsák a táblázat aktuális sémáját a folyamatosan változó adatoknak megfelelően. Leggyakrabban a hozzáadás vagy felülírás műveleteknél használják, hogy automatikusan alkalmazkodjon a séma új oszlopok egy vagy több új oszlop beillesztéséhez.
Hogyan működik a séma evolúció?
A korábbi rész példáját követve a fejlesztők könnyedén használhatják a séma evolúcióját új oszlopok hozzáadására, amelyeket korábban az sémával való összhang hiánya miatt elutasítottak. A séma evolúcióját az alábbiak hozzáadásával aktiválják: .option('mergeSchema', 'true') az Ön Spark parancsához. .write vagy .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
A diagram megtekintéséhez végezze el az alábbi Spark SQL lekérdezést:
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 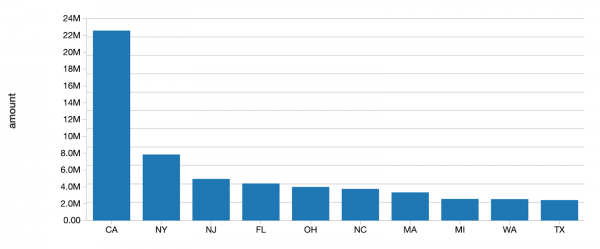
Alternatívaként beállíthatja ezt az opciót az egész Spark munkamenetre, ha hozzáadja spark.databricks.delta.schema.autoMerge = True a Spark konfigurációjához. De óvatosan használja, mivel a séma kényszerített alkalmazása már nem figyelmeztet Önt a nem szándékos sémák eltéréseire.
Ha a lekérdezésben szerepel a mergeSchemaparaméter, minden DataFrame-ben jelen lévő, de a cél táblázatban hiányzó oszlop automatikusan hozzáadódik a séma végéhez a tranzakciós írás keretein belül. Beágyazott mezők is hozzáadhatók, és ezek is hozzá lesznek adva a megfelelő oszlopok végéhez.
A dátumot a mérnökök és tudósok arra használhatják, hogy új oszlopokat (például egy újonnan nyomon követett metrikát vagy az adott hónap értékesítési mutatóit) adjanak hozzá a meglévő gépi tanulási gyártási tábláikhoz anélkül, hogy megszakítanák a régi oszlopokra épülő modelleket.
A következő séma változtatási típusok megengedettek a séma evolúció során a táblák hozzáadása vagy felülírása során:
- Új oszlopok hozzáadása (ez a leggyakoribb forgatókönyv)
- Adat típusok megváltoztatása NullType -> bármilyen más típusra vagy ByteType -> ShortType -> IntegerType-ra történő felemelés
Egyéb változtatások, amelyek nem megengedettek a séma evolúció keretein belül, megkövetelik, hogy a séma és az adatok felülírásra kerüljenek a kiegészítő hozzárendeléssel .option("overwriteSchema", "true"). Például, ha a „Foo” oszlop kezdetben egész szám volt, és az új séma szöveges típusú lenne, akkor az összes Parquet fájlt (adat) felül kell írni. Ilyen változások például:
- oszlop eltávolítása
- létező oszlop adat típusának megváltoztatása (helyben)
- oszlopok átnevezése, amelyek csak a kis- és nagybetűkben különböznek (például „Foo” és „foo”)
Végül a következő Spark 3.0 kiadással teljes mértékben támogatni fogják a világos DDL-t (ALTER TABLE használatával), amely lehetővé teszi a felhasználók számára, hogy a táblák sémáival a következő műveleteket végezzék el:
- oszlopok hozzáadása
- oszlopok megjegyzéseinek megváltoztatása
- a táblázat viselkedését meghatározó tulajdonságok beállítása, például a tranzakciós napló megőrzési időtartamának beállítása.
Mi az előnye a séma evolúciónak?
A séma evolúciót mindig lehet használni, amikor szándékozott megváltoztatni a táblája sémáját (szemben azzal az esettel, amikor véletlenül olyan oszlopokat adtak a DataFrame-hez, amelyeknek ott nem kellett volna lenniük). Ez a legegyszerűbb módja a séma migrálásának, mert automatikusan hozzáadja a megfelelő oszlopneveket és adat típusokat anélkül, hogy azokat kifejezetten meg kellene határozni.
Zárás
A séma kényszerű alkalmazása elveti azokat az új oszlopokat vagy egyéb séma-módosításokat, amelyek nem kompatibilisek a táblázatával. Ezeknek a magas normáknak a beállítása és fenntartása mellett az elemzők és mérnökök biztosak lehetnek abban, hogy adataik a lehető legmagasabb integritással rendelkeznek, ami lehetővé teszi számukra, hogy tisztán és világosan érveljenek, és hatékonyabb üzleti döntéseket hozzanak.
Másrészt a séma evolúciója kiegészíti a kényszerű alkalmazást, egyszerűsítve az előrejelzett automatikus séma-módosításokat. Végül is ez nem lenne bonyodalom — egy oszlop hozzáadása.
A séma kényszerű alkalmazása a jáng, míg a séma evolúciója az in. Együttműködve ezek a funkciók soha nem könnyítik meg a zaj eltávolítását és a jel beállítását.
Szeretnénk megköszönni Mukul Murti-nak és Pranav Anand-nak az írás részévé tett hozzájárulásukat.
Egyéb cikkek ebből a sorozatból:
Témához kapcsolódó cikkek
Forrás: habr.com
