

Fél évvel ezelőtt — nyilvános PostgreSQL-hez.
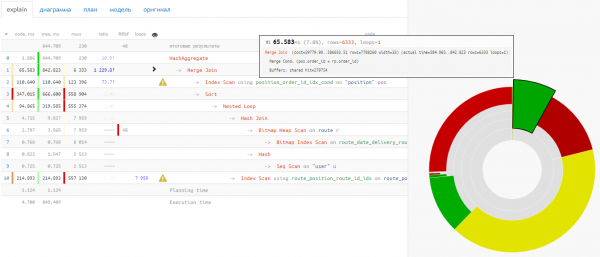
Az eltelt hónapok alatt készítettünk róla , elkészítettünk egy összefoglaló azoknak az ajánlásoknak az alapján, amelyeket kibocsát… de ami a legfontosabb — gyűjtöttük a visszajelzéseiteket és figyeltük a valós felhasználási eseteket.
És most készen állunk, hogy beszámoljunk az új lehetőségekről, amelyeket használhattok.
Különböző tervek formátumának támogatása
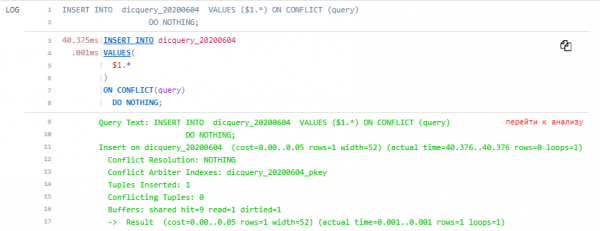
A naplóban található terv, a lekérdezéssel együtt
Közvetlenül a konzolból kiemeljük az egész blokkot, kezdve a Query Textsorral, minden vezető szóközzel:
        Query Text: INSERT INTO  dicquery_20200604  VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
… és az összes másolt tartalmat egyenesen a terv mezőjébe illesztjük, semmit sem elválasztva:
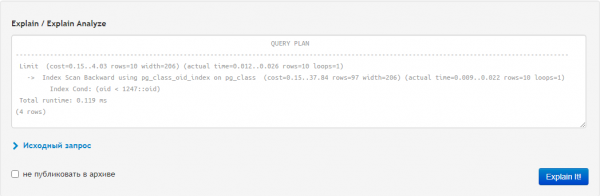
A kimeneten bónuszként a feldolgozott tervhez még egy »környezet«, ahol a lekérdezésünk minden szépségében van bemutatva:
JSON és YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
]"Akár a pgAdmin által másolt külső idézőjelekkel, akár anélkül — betesszük ugyanabba a mezőbe, a kimenet — gyönyörű:
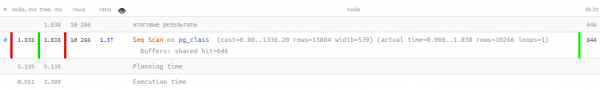
Kiterjesztett vizualizáció
Tervezési idő / Végrehajtási idő
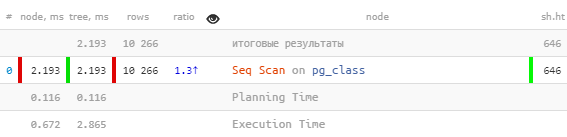
Most már jobban látszik, hova ment el a plusz idő a lekérdezés végrehajtása során:
I/O időzítés
Néha olyan helyzetekkel találkozunk, amikor úgy tűnik, hogy az erőforrások nem voltak túlterhelve az olvasási-írási műveletek során, de a végrehajtási idő valamiért mégis indokolatlanul hosszú.
Itt azt kell mondani: "Ó, valószínűleg abban a pillanatban a szerver lemeze túlterhelt volt, ezért olvasott olyan sokáig!" De ez nem túl pontos…
De ezt teljesen megbízhatóan meg lehet határozni. Az a helyzet, hogy a PG-szerver konfigurációs opciói között szerepel :
Belefoglalja a bemeneti/kimeneti műveletek időmérését. Ez a beállítás alapértelmezés szerint ki van kapcsolva, mivel állandóan lekérdezni kell az aktuális időt az operációs rendszertől, ami jelentősen lelassíthatja a működést egyes platformokon. Az időmérés költségeinek felmérésére az Ön platformján használhatja a pg_test_timing segédprogramot. A bemeneti/kimeneti statisztikákat a pg_stat_database nézeten keresztül kaphatja meg. az EXPLAIN kimenetében (amikor a BUFFERS paraméter használatban van) és a pg_stat_statements nézeten keresztül.
Ez a paraméter egy helyi munkameneten belül is aktiválható:
SET track_io_timing = TRUE;Most jön a legérdekesebb rész — megtanultuk megérteni és megjeleníteni ezeket az adatokat a végrehajtási fa minden transzformációja figyelembevételével:
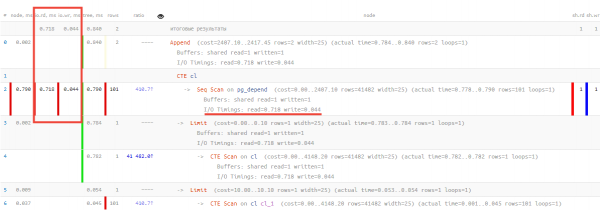
Itt észrevehetjük, hogy a 0.790 ms végrehajtási időből 0.718 ms egy adatlap elolvasására, 0.044 ms az írására, míg a többi hasznos tevékenységre csak 0.028 ms-t fordítottunk!
A jövő a PostgreSQL 13-mal
A teljes újdonságok áttekintéséről tájékozódhat , mi pedig konkrétan a tervekben bekövetkező változásokról beszélünk.
Tervezési puffer
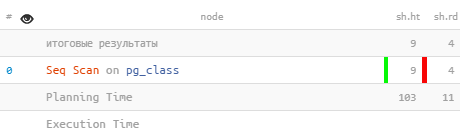
A tervező számára kiosztott erőforrások figyelembevétele megjelenik egy másik javításban is, amely nem kapcsolódik a pg_stat_statements-hez. Az EXPLAIN BUFFERS opcióval a tervezés során felhasznált pufferek számát fogja jelezni:
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
Inkrementális rendezés
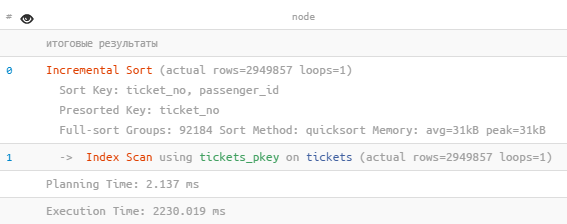
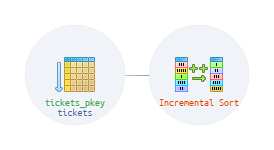
Olyan esetekben, amikor több kulcs alapján kell rendezni (k1, k2, k3...), a tervező mostantól kihasználhatja, hogy az adatok már több kezdeti kulcs szerint rendezve vannak (például k1 és k2). Ebben az esetben nem szükséges az összes adat újra rendezése, hanem azokat azonos k1 és k2 értékek szerint egymás után csoportokra lehet osztani, és "k3" kulcs alapján "további rendezést" végezni.
Így az egész rendezés több kisebb méretű egymás utáni rendezésre esik szét. Ez csökkenti a szükséges memória mennyiségét, és lehetővé teszi, hogy az első adatokat korábban szolgáltassuk, mint ahogy a teljes rendezés befejeződik.
 Incremental Sort (actual rows=2949857 loops=1)
   Sort Key: ticket_no, passenger_id
   Presorted Key: ticket_no
   Full-sort Groups: 92184 Sort Method: quicksort Memory: avg=31kB peak=31kB
   ->  Index Scan using tickets_pkey on tickets (actual rows=2949857 loops=1)
 Planning Time: 2.137 ms
 Execution Time: 2230.019 ms
UI/UX fejlesztések.
Képernyőképek, mindenhol ott vannak!
Most már minden fülön gyorsan lehetőség nyílt képernyőképet készíteni a fülről a vágólapra a fül teljes szélességében és mélységében — a jobb felső sarokban levő „célpont”:
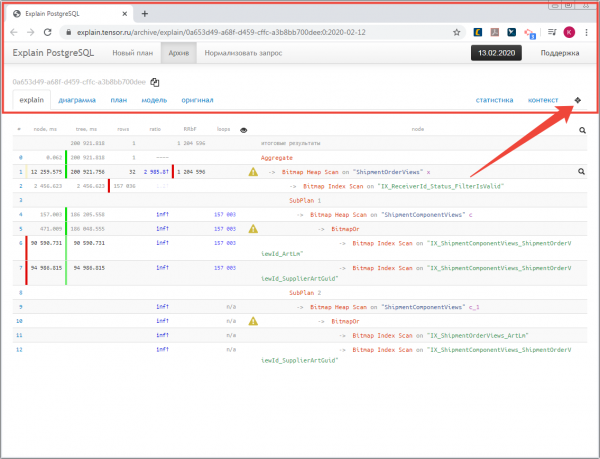
Tulajdonképpen, a legtöbb kép ehhez a publikációhoz így készült.
Ajánlások a csomópontokon
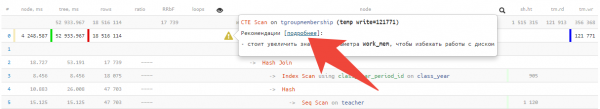
Nemcsak több dolog lett, hanem mindegyikről , az alábbi linken átkattintva:
Törlés az archívumból
Többen kértek minket, hogy adjuk hozzá a lehetőséget a „teljes” törléshez még az archívumban nem közzétett tervek esetén is — kérem, elég csak rákattintani a megfelelő ikonra:
Nos, és ne feledjük, hogy van , ahová lehet írni a megjegyzéseket és javaslatokat.
Forrás: habr.com
