

A könyv fordításának folytatása:
«Message Brokers megértése»
szerző: Jakub Korab, kiadó: O’Reilly Media, Inc., kiadás dátuma: 2017 június, ISBN: 9781492049296.
Az előző fordított rész:
3. FEJEZET
, amely lehetőséget ad valós időben látni a rendszer eseményportfólióját.
A Kafka-t a LinkedIn fejlesztette ki, hogy megkerülje a hagyományos üzenetbrókerek bizonyos korlátait, és elkerülje, hogy több üzenetbrókert kelljen beállítani különböző "pont-pont" interakciókhoz, amit a könyv "Vertikális és vízszintes skálázás" című fejezetében 28. oldalon részletezünk. A LinkedIn használati forgatókönyvei elsősorban egyirányú, nagyon nagy adatmennyiség bevitelén alapultak, például az oldalon végzett kattintások és a hozzáférési naplók, lehetővé téve ezzel, hogy ezeket az adatokat több rendszer használja anélkül, hogy a termelők vagy más fogyasztók teljesítményét befolyásolná. Valójában a Kafka létrejöttének oka egy olyan üzenetcsere architektúra megvalósítása, amelyet az Universal Data Pipeline leír.
Figyelembe véve ezt a végső célt, természetesen más követelmények is felmerültek. A Kafkának:
- Nagyon gyorsnak kell lennie
- Nagy átbocsátóképességet kell biztosítania az üzenetek kezelésekor
- Támogatnia kell a "Kibocsátó-Előfizető" és "Pont-Pont" modelleket
- Nem szabad lelassulnia a fogyasztók hozzáadásával. Például az ActiveMQ-ban a teljesítmény és a sorok, valamint a téma a fogyasztók számának növekedésével romlik a címzettben
- Vízszintesen skálázhatónak kell lennie; ha egy bróker, amely megőrzi az üzeneteket, csak a lemez maximális sebességén tudja ezt megtenni, akkor érdemes egy bróker példányon túlmenni a teljesítmény növelése érdekében
- Különböző hozzáférést kell biztosítania az üzenetek tárolásához és újraeléréséhez
Ahhoz, hogy mindezt elérjük, a Kafka egy olyan architektúrát alkalmazott, amely újradefiniálta az ügyfelek és az üzenetbroker feladatait és felelősségeit. A JMS modell nagyon broker-orientált, ahol a broker felelős az üzenetek terjesztéséért, míg az ügyfeleknek csak az üzenetek küldésével és fogadásával kell foglalkozniuk. Ezzel szemben a Kafka ügyfélorientált, így az ügyfél számos tradicionális broker funkciót átvállal, mint például a megfelelő üzenetek tisztességes elosztása a fogyasztók között, cserébe egy rendkívül gyors és skálázható brokeren keresztül. Azok számára, akik hagyományos üzenetküldő rendszerekkel dolgoztak, a Kafka használatakor alapvető változásokat kell végrehajtaniuk a nézeteikben.
Ez a mérnöki irányzat lehetővé tette egy olyan üzenetküldő infrastruktúra megépítését, amely nagyságrendekkel képes megnövelni a teljesítményt a hagyományos brókerekhez képest. Ahogy látni fogjuk, ez a megközelítés kompromisszumokkal jár, amelyek azt jelentik, hogy a Kafka nem alkalmas bizonyos típusú terhelésekre és bejárati szoftverekre.
Egységesített címzési modell
A fent említett követelmények teljesítéséhez a Kafka egyesítette a 'közzététel-feliratkozás' és a 'pont-pont' üzenetküldést egyetlen címzési típusként - a téma. Ez zavaró lehet azok számára, akik üzenet forgalmazó rendszerekkel dolgoztak, ahol a 'téma' a széleskörű mechanizmusra utal, ahonnan (a témából) a leolvasás nem megbízható (is nondurable). A Kafka témákat hibrid címzési típusként kell kezelni, a könyv bevezetőjében megadott meghatározásnak megfelelően.
A fejezet hátralévő részében, hacsak mást kifejezetten nem jelölünk meg, a 'téma' kifejezés a Kafka témára fog vonatkozni.
A témák működésének és a biztosított garanciáik teljes megértéséhez először is meg kell vizsgálnunk, hogyan valósulnak meg a Kafka rendszerében.
Minden Kafka témának saját naplója van.
A Kafka-hoz üzeneteket küldő producerek az üzeneteket egy naplóba írják, míg a fogyasztók a naplóból olvasnak azzal, hogy folyamatosan előre mozgó mutatókat használnak. Időnként a Kafka eltávolítja a legrégebbi naplórészeket, függetlenül attól, hogy az ott található üzeneteket elolvasták-e már vagy sem. A Kafka tervezésének középpontjában az áll, hogy a broker nem foglalkozik azzal, hogy az üzeneteket elolvasták-e vagy sem — ez a kliens felelőssége.
A 'napló' és a 'mutató' kifejezések nem találhatóak meg Ezek a jól ismert kifejezések itt azért használatosak, hogy segítsenek a megértésben.
Ez a modell teljesen eltér az ActiveMQ-tól, ahol az összes sorból származó üzenetek egy közös naplóban tárolódnak, és a broker az üzeneteket azután jelöli meg eltávolítottnak, hogy el lettek olvasva.
Most nézzük meg kicsit mélyebben a téma naplóját.
A Kafka naplója több partícióból áll (). A Kafka szigorú sorrendet garantál minden partícióban. Ez azt jelenti, hogy a partícióba egy adott sorrendben írt üzeneteket ugyanabban a sorrendben fogják elolvasni. Minden partíció ciklikus (rolling) naplófájlként van megvalósítva, amely tartalmazza az üzenetek egy részhalmazát (subset) amelyek a témába a producerei által lettek küldve. Az alapértelmezett beállítással létrehozott téma egy partíciót tartalmaz. A partíciók ötlete a Kafka központi gondolata a horizontális skálázás szempontjából.
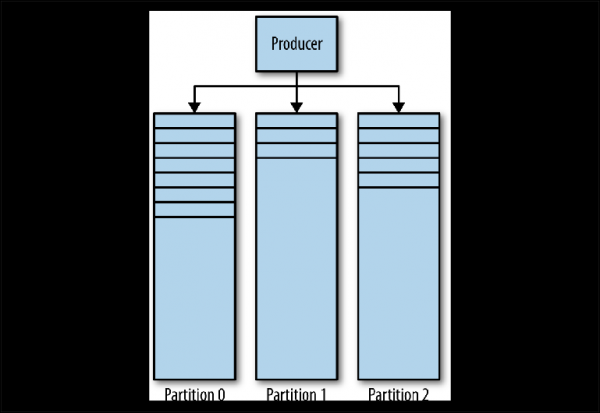
3-1. ábra. Kafka partíciók
Amikor a producer üzenetet küld a Kafka témába, eldönti, hogy melyik partícióba küldje az üzenetet. Ezt később részletesebben is megvizsgáljuk.
Üzenetek olvasása
A kliens, aki szeretné elolvasni az üzeneteket, egy névvel ellátott mutatót kezel, amelyet fogyasztói csoportnak (consumer group) neveznek, amely az üzenetek offset pozíciójára mutat a partícióban. Az offset egy növekvő számú pozíció, amely 0-tól kezdődik a partíció elején. Ez a fogyasztói csoport, amelyre az API-n keresztül a felhasználó által meghatározott group_id azonosítóval hivatkoznak, egy logikai fogyasztót vagy rendszert képvisel. A legtöbb üzenetküldő rendszerek párhuzamos feldolgozás érdekében több példányon és szálon keresztül olvassa az adatokat a címzettből. Így általában sok fogyasztói példány fog közös fogyasztói csoportot használni..
A legtöbb üzenetkezelő rendszer az adatokat a címzettől több példány és szál segítségével olvassa el az üzenetek párhuzamos feldolgozásához. Ennek eredményeként általában sok consumerek példány osztozik az ugyanazon a fogyasztói csoporton.
A probléma olvasásának megértése a következőképpen lehetséges:
- A téma több partícióval rendelkezik
- A témát egyszerre több fogyasztói csoport is használhatja
- A fogyasztói csoportnak lehet több különböző példánya
Ez nem trivális „sokaz-egyhez” probléma. Ahhoz, hogy megértsük, hogyan kezeli a Kafka a kapcsolatokat a fogyasztói csoportok, a fogyasztói példányok és a partíciók között, vizsgáljuk meg néhány fokozatosan bonyolultabb olvasási forgatókönyvet.
Fogyasztók és fogyasztói csoportok
Vegyünk kiindulásként egy témát egy partícióval ().
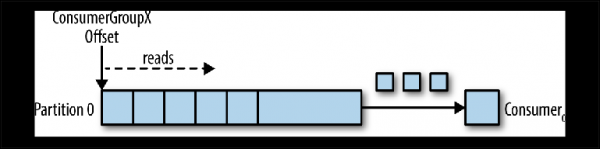
Ábra 3-2. A fogyasztó olvas a partícióból
Amikor egy fogyasztói példány a saját group_id-jával csatlakozik ehhez a témához, egy partíciót kap az olvasásra és egy offsetet a partícióban. Ennek az offsetnek a pozíciója a kliensben van konfigurálva, mint mutató a legutolsó pozícióra (legújabb üzenetre) vagy a legkorábbi pozícióra (legöregebb üzenetre). A fogyasztó üzeneteket kér le a témából, ami a naplóból történő sorozatos olvasását eredményezi.
Az offset pozícióját rendszeresen komitálják vissza a Kafka-ba, és eltárolják, mint üzeneteket a belső témában _consumer_offsets. A kiolvasott üzenetek nem törlődnek, ellentétben a hagyományos brokerrel, és a kliens visszaforgathatja (rewind) az offsetet, hogy újra feldolgozhassa a már megtekintett üzeneteket.
Amikor egy második logikai fogyasztó csatlakozik, másik group_id használatával, egy második mutatót kezel, amely független az elsőtől (). Így a Kafka téma úgy működik, mint egy sor, ahol egy fogyasztó van, és mint egy szokásos téma, amely kiadott és feliratkozó (pub-sub) modell, amelyre több fogyasztó feliratkozik, azzal a kiegészítő előnnyel, hogy minden üzenet megmarad és többször feldolgozható.
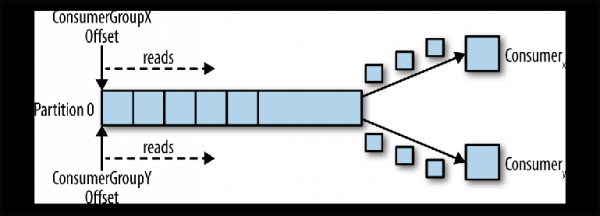
Ábra 3-3. Két fogyasztó különböző fogyasztói csoportokból olvas egy partícióból
Fogyasztók a fogyasztói csoportban
Amikor egy fogyasztó példány olvas adatokat a partícióból, teljes mértékben ellenőrzi a mutatót és feldolgozza az üzeneteket, ahogyan azt az előző részben leírtuk.
Ha több fogyasztó példány csatlakozik ugyanazzal a group_id-vel egy olyan topikhoz, amely egy partícióval rendelkezik, akkor az utoljára csatlakozó példány kapja meg az irányítást a mutató felett, és innentől kezdve ő fogja megkapni az összes üzenetet ().
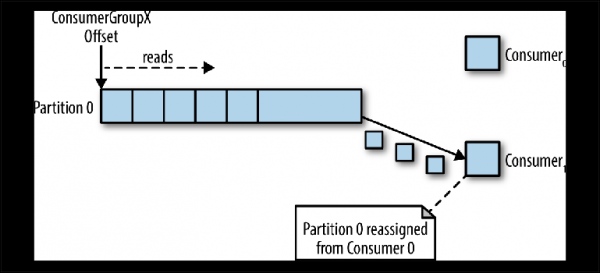
3-4. ábra. Két fogyasztó ugyanabban a fogyasztói csoportban olvas egy partícióból
Ez a feldolgozási mód, amelyben a fogyasztói példányok száma meghaladja a partíciók számát, monopolisztikus fogyasztóként is felfogható. Hasznos lehet, ha aktív-passzív (vagy „forró-meleg”) klaszterezésre van szüksége a fogyasztói példányai között, habár több fogyasztó párhuzamos működése („aktív-aktív” vagy „forró-forró”) sokkal jellemzőbb, mint a várakozó fogyasztók.
A fenti üzeneti elosztási viselkedés, amelyet leírtunk, meglepő lehet a hagyományos JMS sorhoz képest. Ebben a modellben a sorba küldött üzenetek egyenletesen oszlanak el a két fogyasztó között.
Legtöbbször, amikor több fogyasztó példányt hozunk létre, ezt vagy üzenetek párhuzamos feldolgozása érdekében tesszük, vagy az olvasási sebesség növelésére, vagy az olvasási folyamat megbízhatóságának fokozására. Mivel egy partícióból csak egy fogyasztó példány olvashat egy időben, hogyan valósul ez meg a Kafka-ban?
Az egyik módja ennek az, hogy egy fogyasztó példány olvassa az összes üzenetet, és átadja azokat egy szálpoolnak. Bár ez a megközelítés növeli a feldolgozás áteresztőképességét, növeli a fogyasztók logikájának bonyolultságát, és semmit sem tesz a rendszer olvasásának megbízhatósága érdekében. Ha egy fogyasztó példány áramkimaradás vagy hasonló esemény miatt leáll, akkor az olvasás is leáll.
A probléma klasszikus megoldása a Kafka-ban a bAzs több partíció használata.
Particionálás
A partíciók a topik olvasásának párhuzamosításának és a skálázásának alapvető mechanizmusai egy broker példány áteresztőképességén túl. Annak érdekében, hogy ezt jobban megértsük, vegyünk egy olyan helyzetet, amikor egy topik két partícióval rendelkezik, és egy fogyasztó feliratkozik erre a topikra ().
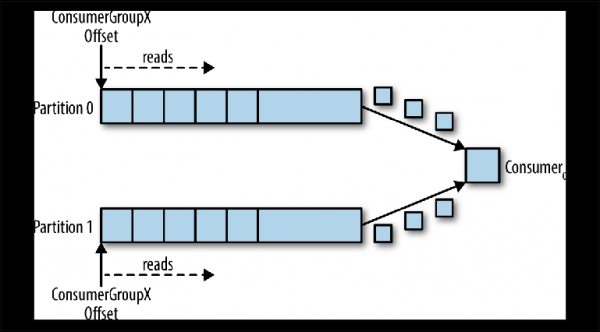
3-5. Egy fogyasztó olvas több partícióból
Ebben a forgatókönyvben a fogyasztó ellenőrzést kap az ő group_id-hoz tartozó mutatók felett mindkét partícióban, és elkezdi az üzenetek olvasását mindkét partícióból.
Amikor egy további fogyasztó kerül hozzáadásra ugyanahhoz a group_id-hoz, a Kafka újraallokálja az egyik partíciót az elsőről a másodikra. Ezután minden fogyasztó példány egy partícióból fog olvasni a témában ().
Ahhoz, hogy párhuzamosan 20 szálon dolgozzon fel üzeneteket, legalább 20 partícióra van szükség. Ha kevesebb partíció van, maradnak olyan fogyasztók, akiknek nincs mit csinálniuk, amint az a monopol fogyasztók vitájában már említésre került.
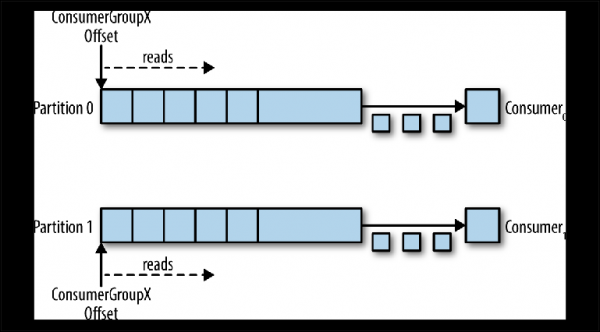
3-6. ábra. Két fogyasztó ugyanazon fogyasztói csoportban különböző partíciókból olvas
Ez a séma jelentősen csökkenti a Kafka broker működésének bonyolultságát a JMS sorok támogatásához szükséges üzenetmegosztáshoz képest. Itt nem kell figyelni a következőkre:
- Melyik fogyasztónak kell megkapnia a következő üzenetet a körkörös (round-robin) megosztás, a jelenlegi előtöltő pufferek kapacitása vagy a korábbi üzenetek alapján (a JMS üzenet csoportokhoz hasonlóan).
- Mely üzeneteket küldtek el milyen fogyasztóknak, és újra kell-e őket küldeni hiba esetén.
A Kafka brokernek annyit kell tennie, hogy sorban továbbítja az üzeneteket a fogyasztónak, amikor az utolsó kéri őket.
A kérés a párhuzamos olvasásra és a hibás üzenetek újraküldésére egyáltalán nem tűnik el — a felelősség egyszerűen átkerül a brokertől az ügyfélhez. Ez azt jelenti, hogy figyelembe kell venni a kódodban.
Üzenetek küldése
Az a döntés, hogy melyik partícióba küldjük az üzenetet, a mező üzenetének készítőjének felelőssége. Az, hogy megértsük a mechanizmust, amellyel ez történik, először meg kell vizsgálni, hogy valójában mit küldünk.
Míg a JMS esetében üzenetstruktúrát használunk metadatával (fejlécekkel és tulajdonságokkal) és egy hasznos teherrel (payload) rendelkező testtel, a Kafka üzenete egy "kulcs-érték" párA payload of the message is sent as a value. The key, on the other hand, is mainly used for partitioning and must contain a business logic specific key, to place related messages in the same partition.
In Chapter 2, we discussed the online betting scenario where related events need to be processed in order by a single consumer:
- The user account is set up.
- Money is credited to the account.
- A bet is placed, which withdraws money from the account.
If each event represents a message sent to the topic, then in this case, the natural key would be the account identifier.
When a message is sent using the Kafka Producer API, it is passed to the partitioning function, which, taking into account the message and the current state of the Kafka cluster, returns the partition ID to which the message should be sent. This function is implemented in Java through the Partitioner interface.
This interface looks as follows:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
The Partitioner implementation for determining the partition uses a default key hashing algorithm (general-purpose hashing algorithm over the key) or round-robin if the key is not specified. This default value works well in most cases. However, in the future, you may want to write your own.
Writing your own partitioning strategy
Let's consider an example where you want to send metadata along with the message payload. The payload in our example is an instruction to deposit funds into a gaming account. The instruction is something we would like to guarantee is not modified during transmission and we want to ensure that only a trusted higher-level system can initiate this instruction. In this case, both the sending and receiving systems agree to use a signature for message authentication.
In regular JMS, we simply define the property 'message signature' and add it to the message. However, Kafka does not provide us with a mechanism for transferring metadata — only key and value.
Mivel az érték a banki átutalás terhelése (bank transfer payload), amelynek integritását meg szeretnénk őrizni, nincs más választásunk, mint hogy meghatározzuk az adatszerkezetet, amelyet a kulcsban használunk. Feltételezve, hogy szükségünk van egy fiókazonosítóra a partícionáláshoz, mivel az összes, a fiókhoz kapcsolódó üzenetet sorrendben kell feldolgozni, a következő JSON szerkezetet alkotjuk meg:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Mivel a aláírás értéke változni fog a terhelés függvényében, a Partitioner interfész alapértelmezett hash-stratégiája nem fog megbízhatóan csoportosítani a kapcsolódó üzeneteket. Ezért saját stratégiát kell írnunk, amely elemzi ezt a kulcsot, és szétválasztja (partition) a fiókazonosító értékét.
A Kafka ellenőrző összegeket tartalmaz az üzenetek sérülésének észlelésére a tárolóban, és teljes biztonsági funkciókkal bír. Még ebben az esetben is néha megjelennek iparágspecifikus követelmények, mint például az előbbiekben említett.
A felhasználói partícionálási stratégiának biztosítania kell, hogy az összes kapcsolódó üzenet ugyanabban a partícióban legyen. Bár ez egyszerűnek tűnik, a követelmény bonyolultabbá válhat a kapcsolódó üzenetek sorrendjének fontossága és a partíciók számának rögzítettsége miatt a témában.
A témában a partíciók száma idővel változhat, mivel új partíciókat lehet hozzáadni, ha a forgalom túllépi az eredeti várakozásokat. Így az üzenetek kulcsai a partícióhoz kapcsolhatók, amelybe eredetileg elküldték őket, ami a producer példányok között elosztandó állapot egy részét jelenti.
Egy másik tényező, amelyet figyelembe kell venni, az üzenetek egyenletes eloszlása a partíciók között. Általában a kulcsok nem oszlanak el egyenletesen az üzenetek között, és a hash-funkciók nem garantálják az üzenetek tisztességes eloszlását kis kulcskészletek esetén.
Fontos megjegyezni, hogy bármilyen módon is dönt, hogy megossza az üzeneteket, magát a megosztót esetleg újra kell használnia.
Vizsgáljuk meg az adat replikációs követelményét a különböző földrajzi elhelyezkedésű Kafka klaszterek között. E célból a Kafka egy MirrorMaker nevű parancssori eszközt biztosít, amelyet arra használnak, hogy üzeneteket olvassanak ki egy klaszterből, és továbbítsák azokat egy másikba.
A MirrorMaker-nek meg kell értenie a replikált téma kulcsait, hogy fenntartsa az üzenetek viszonylagos sorrendjét a klaszterek közötti replikáció során, mivel a téma számára a particionálások száma nem biztos, hogy egyezik a két klaszterben.
A felhasználói particionálási stratégiák viszonylag ritkák, mivel az alapértelmezett hash vagy körkörös másolás a legtöbb forgatókönyvben sikeresen működik. Azonban, ha szigorú sorrendbeli garanciákra van szüksége, vagy ha metaadatokat kell kinyerni a hasznos terhekből, akkor a particionálás az, amire érdemes jobban odafigyelnie.
A Kafka skálázhatóságának és teljesítményének előnyei azzal magyarázhatók, hogy a hagyományos közvetítő néhány feladatát a kliensre hárítják. Ebben az esetben döntés születik arról, hogy a potenciálisan kapcsolódó üzeneteket párhuzamosan működő több fogyasztón osztják el.
A JMS közvetítőknek is foglalkozniuk kell az ilyen követelményekkel. Érdekes, hogy a kapcsolódó üzenetek ugyanannak a fogyasztónak való elküldésének mechanizmusa, amelyet a JMS Üzenetcsoportok (sticky load balancing - SLB stratégia) révén valósítanak meg, szintén megköveteli, hogy a küldő megjelölje az üzeneteket, mint összekapcsoltakat. JMS esetében a közvetítő felelős azért, hogy egy sok közül egy fogyasztónak küldje el ezt a csoportot, és átadja a tulajdonjogot a csoport felett, ha a fogyasztó elromlik.
Kibocsátói megállapodások
A particionálás nem az egyetlen dolog, amire figyelni kell az üzenetek küldésekor. Nézzük meg a Java API Producer osztály send() módszereit:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Azonnal meg kell jegyezni, hogy mindkét módszer Future-t ad vissza, ami arra utal, hogy a küldési művelet nem hajtódik végre azonnal. Ennek eredményeként a ProducerRecord üzenet a küldési pufferbe kerül minden aktív partíció számára, és háttérfolyamatban a Kafka klienskönyvtár átadja a brokernek. Bár ez rendkívül gyorsan végzi a munkát, azt jelenti, hogy egy tapasztalatlanul írt alkalmazás veszthet üzeneteket, ha folyamata leáll.
Mint mindig, van mód a küldés megbízhatóbbá tételére a teljesítmény rovására. Ezt a puffer méretét 0-ra állítva elérhetjük, és a küldő alkalmazás folyamatának meg kell várnia, amíg az üzenet brokerhez való átadása befejeződik, a következőképpen:
RecordMetadata metadata = producer.send(record).get();Ismét a üzenetek olvasásáról
Az üzenetek olvasása további nehézségekkel jár, amelyeket meg kell vitatni. A JMS API-tól eltérően, amely képes üzenetfigyelőt (message listener) indítani egy beérkezett üzenetre, a Consumer Kafka interfész csupán polling-alapú. Vizsgáljuk meg részletesebben a poll()módszert, amelyet ezen célra használnak:
ConsumerRecords poll(long timeout);A metódus visszatérési értéke egy konténer struktúra, amely több ConsumerRecord objektumot tartalmazhat több partícióból. ConsumerRecord Ez önálló kulcs-érték párt tartalmaz, a megfelelő metaadatokkal, mint például a partíció, ahonnan származik.
Amint azt a 2. fejezetben megvitattuk, folyamatosan emlékeznünk kell arra, hogy mi történik az üzenetekkel a sikeres vagy sikertelen feldolgozás után, például ha a kliens nem képes feldolgozni az üzenetet vagy ha megszakítja a munkát. A JMS ezt a visszaigazolási mód (acknowledgement mode) révén kezelte. A broker vagy törli a sikeresen feldolgozott üzeneteket, vagy újra átadja a feldolgozandó vagy meghiúsult üzeneteket (feltéve, hogy tranzakciókat használtak).
A Kafka egészen másképpen működik. Az üzenetek nem törlődnek a brokerben a beolvasás után, és a hiba esetén fellépő felelősség a beolvasó kódkódra hárul.
Ahogy már említettük, a fogyasztók csoportja a napló eltolódásához van társítva. A naplóban található eltolódás pozíciója megfelel a következő üzenetnek, amely a válaszként kiadásra kerül. poll()A döntő jelentőségű az olvasás során az az időpont, amikor ez az elmozdulás növekszik.
Visszatérve az előzőleg tárgyalt olvasási modellhez, az üzenet feldolgozása három lépésből áll:
- Az üzenet kiemelése az olvasáshoz.
- Az üzenet feldolgozása.
- Az üzenet megerősítése.
A Kafka fogyasztó konfigurálási lehetőséget kínál enable.auto.commit. Ez gyakran használt alapértelmezett beállítás, ahogyan az a "auto" szót tartalmazó beállításoknál szokás.
A Kafka 0.10 előtt a kliens, amely ezt a paramétert használta, az utolsó olvasott üzenet elmozdulását küldte a következő híváskor poll() feldolgozás után. Ez azt jelentette, hogy bármely üzenet, amelyet már kiemeltek (fetched), újra feldolgozható maradt, ha a kliens már feldolgozta, de váratlanul leállt a hívás előtt. poll()Mivel a broker nem tárolja, hány alkalommal olvasták el az üzenetet, a következő fogyasztó, aki ezt az üzenetet kiemeli, nem fog tudni arról, hogy valami rossz történt. Ez a viselkedés pszeudo-tranzakcionális volt. Az elmozdulás csak az üzenet sikeres feldolgozása esetén került elkötelezésre, de ha a kliens leállt, a broker ugyanazt az üzenetet újra elküldte egy másik kliensnek. Ez a viselkedés megfelelt az üzenetküldési garanciáknak, hogy "legalább egyszer«.
A Kafka 0.10 verziójában a kliens kódját úgy módosították, hogy az elkötelezés időszakosan elindult a kliens könyvtár révén, a beállításnak megfelelően auto.commit.interval.ms. Ez a viselkedés valahol a JMS AUTO_ACKNOWLEDGE és DUPS_OK_ACKNOWLEDGE módjai között helyezkedik el. Az automatikus elkötelezés használatakor az üzenetek akkor is megerősíthetők voltak, ha ténylegesen nem dolgozták fel őket - ez előfordulhatott lassú fogyasztó esetén. Ha a fogyasztó leállt, az üzeneteket a következő fogyasztó az elkötelezett pozíciótól kezdve emelte ki, ami üzenetek kihagyásához vezethetett. Ilyen esetekben a Kafka nem veszített üzeneteket, a leolvasó kód egyszerűen nem dolgozta fel azokat.
Ez a mód ugyanazokat a kilátásokat kínálja, mint a 0.9-es verzióban: az üzenetek feldolgozhatók, de hiba esetén az elmozdulás előfordulhat, hogy nem került elkötelezésre, ami potenciálisan duplázott küldést eredményezhet. Minél több üzenetet emelsz ki végrehajtás közben poll(), annál nagyobb ez a probléma.
Ahogy azt a "Üzenetek olvasása a sorból" című részben a 21. oldalon tárgyaltuk, a üzenetküldő rendszerben nincs olyan fogalom, mint az üzenet egyszeri kézbesítése, ha figyelembe vesszük a hibaáramlás módjait.
A Kafka-ban két módszer létezik az eltolódás (offset) rögzítésére (committálására): automatikusan és manuálisan. Mindkét esetben az üzenetek többször is feldolgozhatók, ha az üzenet már feldolgozásra került, de a commit előtt hiba történt. Azt is megteheti, hogy egyáltalán nem dolgozza fel az üzenetet, ha a commit a háttérben megtörtént, és a kódja befejeződött, mielőtt elkezdte volna a feldolgozást (valószínűleg a Kafka 0.9-es és korábbi verzióiban).
A commit eltolódás folyamatának manuális kezelésére a Kafka fogyasztó API-jában állítsa be a paramétert enable.auto.commit hamisra, és egyértelműen hívja meg az alábbi módszerek egyikét:
void commitSync();
void commitAsync();
Ha arra törekszik, hogy az üzenetet "bár legalább egyszer" feldolgozza, manuálisan kell elköteleznie az eltolódást a commitSync (), ezt a parancsot közvetlenül az üzenetek feldolgozása után kell végrehajtani.
Ezek a módszerek nem teszik lehetővé az üzenetek megerősítését (acknowledged) a feldolgozás előtt, de nem tesznek semmit a potenciális feldolgozási duplikációk megszüntetése érdekében, miközben tranzakciós látszatot teremtenek. A Kafka-ban nincsenek tranzakciók. A kliensnek nincs lehetősége arra, hogy a következőket tegye:
- Automatikusan visszagörgesse (roll back) a sikertelen üzenetet. A fogyasztóknak maguknak kell kezelniük a hibákat, amelyek problémás payload-okból és háttérkiadásokból származnak, mivel nem támaszkodhatnak arra, hogy a broker újra kézbesíti az üzeneteket.
- Üzeneteket küldeni több topik számára egyetlen atomikus műveleten belül. Ahogy hamarosan látni fogjuk, a különböző topikok és partíciók fölötti ellenőrzés a Kafka klaszter különböző gépein lehet, amelyek nem koordinálják a tranzakciókat a küldés során. Az írás időpontjában bizonyos lépéseket tettek ennek lehetővé tételére a KIP-98 segítségével.
- Összekapcsolni egy üzenet olvasását egy topikból egy másik üzenet küldésével egy másik topikba. Ismét, a Kafka architektúrája számos független gépre támaszkodik, amelyek egy buszként működnek, és nem tesznek semmilyen kísérletet erre a rejtett feldolgozásra. Például nem léteznek API komponensek, amelyek lehetővé tennék a Fogyasztó és Termelő a tranzakcióban. A JMS-ben ezt az objektum biztosítja Session, amelyből készülnek MessageProducers és MessageConsumers.
Ha nem támaszkodhatunk a tranzakciókra, hogyan biztosíthatjuk a szemantikát, amely közelebb áll ahhoz, amit a hagyományos üzenetküldő rendszerek nyújtanak?
Ha fennáll a lehetősége annak, hogy a fogyasztó eltolódása nő, mielőtt az üzenetet feldolgozták, például a fogyasztó meghibásodása során, akkor a fogyasztónak nincs módja arra, hogy megtudja, hogy a fogyasztói csoport kihagyott-e üzeneteket, amikor a partíciót hozzárendelik neki. Tehát az egyik stratégia a visszatekintés (rewind) az eltolás korábbi pozíciójára. A Kafka fogyasztó API-ja a következő módszereket biztosít erre:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Módszer seek () használható a következő módszerrel
offsetsForTimes (Map timestampsToSearch) egy adott múltbeli időpontba való visszatekeréshez.
Implicit módon ennek a megközelítésnek a használata azt jelenti, hogy valószínűleg néhány korábban feldolgozott üzenetet újraolvasnak és feldolgoznak. Ennek elkerülése érdekében használhatjuk az idempotens olvasást, ahogy a 4. fejezetben ismertetjük, hogy nyomon követhessük a korábban megtekintett üzeneteket és kizárhassuk a duplikátumokat.
Alternatívaként a fogyasztó kódja egyszerű lehet, ha megengedett az üzenetek elvesztése vagy duplikálása. Amikor azokra a felhasználási forgatókönyvekre gondolunk, amelyeket a Kafka jellemzően használ, például naplózás, metrikák, kattintáskövetés stb., megértjük, hogy egyes üzenetek elvesztése valószínűleg nem jelentős hatással lesz a környező alkalmazásokra. Ilyen esetekben az alapértékek teljesen elfogadhatók. Másrészt, ha az alkalmazásának szüksége van a kifizetések továbbítására, akkor gondosan kell bánni minden egyes üzenettel. Mindez a kontextus kérdése.
Személyes megfigyelések azt mutatják, hogy az üzenetek intenzitásának növekedésével minden egyes üzenet értéke csökken. A nagy mennyiségű üzenetek általában értékesebbek aggregált formában történő vizsgálat során.
Magas rendelkezésre állás (High Availability)
A Kafka megközelítése a magas rendelkezésre állással szemben lényegesen eltér az ActiveMQ-tól. A Kafka vízszintesen skálázható klaszterekre épül, amelyben minden egyes bróker példány egyszerre fogad és küld üzeneteket.
A Kafka klaszter több bróker példányból áll, amelyek különböző szervereken működnek. A Kafka úgy lett tervezve, hogy általános fémhardvereken fusson, ahol minden egyes csomópontnak saját dedikált tárolója van. Hálózati tárolók (SAN) használata nem ajánlott, mivel a több számítási csomópont párhuzamosan küzdhet az tárolási időintervallumokért és konfliktusokat okozhat.Atárolási intervallumok és konfliktusok keletkezhetnek.
A Kafka egy folyamatosan működő rendszer. Számos nagy felhasználó soha nem kapcsolja ki a klasztereiket, és a szoftver mindig folyamatos frissítéseket biztosít soros újraindítással. Ez a korábbi verziók kompatibilitásának garantálásával érthető el az üzenetek és a brókerek közötti interakciók esetén.
A brókerek a , amely a konfigurációs adatok nyilvántartásaként működik, csatlakoznak, és az egyes brókerek szerepeinek koordinálására szolgál. A ZooKeeper maga is egy elosztott rendszer, amely biztosítja a magas rendelkezésre állást az információk replikálásával a kvorum.
megalapításával.
- Alapértelmezett esetben a téma létrejön a Kafka klaszterben a következő tulajdonságokkal:
- A partíciók száma. Ahogy korábban is beszéltünk róla, az itt használt pontos érték a kívánt párhuzamos olvasási szinttől függ.
A replikációs tényező meghatározza, hogy a klaszterben hány bróker példánynak kell tartalmaznia a naplókat a partíció számára.
A ZooKeeper koordinációjával a Kafka próbálja igazságosan elosztani az új partíciókat a klaszter brókerei között. Ezt egy példány végzi, amely a Kontroller szerepét tölti be. Futásidőben Irányító a téma minden partíciójához bróker szerepeket vezetőnek (leader, master) és számos nyelven. És most megpróbáljuk alkalmazni a hasonló filozófiát a SQL-kód elkülönítésére az összes többitől, messze az ORM-en túl. (követők, rabszolgák, alárendelt személyek). A bróker, aki vezetőként működik az adott particiónál, felelős minden producer által küldött üzenet fogadásáért és az üzenetek elosztásáért a fogyasztók számára. Amikor üzeneteket küldenek a téma particiójába, azokat reprodukálják az összes bróker csomóponton, amelyek követőkként működnek ezen partició számára. Minden csomópont, amely naplókat tartalmaz a particióhoz, reprodukciónaknevezik. A bróker lehet vezető egyes particiók esetében és követő mások esetében.
A követő, amely minden üzenetet tartalmaz, amely a vezetőnél van, szinkronizált replikának (szinkronizált állapotú replikának, in-sync replica). Ha a bróker, aki vezetőként működik a partició számára, leáll, bármely bróker, amely aktuálisan vagy szinkronizált állapotban van ezen partició számára, átveheti a vezető szerepét. Ez egy rendkívül ellenálló dizájn.
A producer konfigurációjának része a acksparaméter, amely meghatározza, hogy hány replikának kell megerősítenie (acknowledge) az üzenet fogadását, mielőtt az alkalmazás folytatja az üzenetek küldését: 0, 1 vagy mind. Ha a mindérték van megadva, akkor amikor az üzenetet megkapja, a vezető megerősítést (confirmation) küld vissza a producernek, amint megkapja a rögzített replikáktól (beleértve saját magát) a megnyugtatásokat (acknowledgements), amelyeket a téma beállítása határoz meg min.insync.replicas (alapértelmezett 1). Ha az üzenetet nem sikerül megfelelően reprodukálni, akkor a producer kivált egy kivételt az alkalmazás számára (NotEnoughReplicas vagy NotEnoughReplicasAfterAppend).
A tipikus konfigurációban egy téma van létrehozva 3-as replikációs aránnyal (1 vezető, 2 követő minden partició számára) és a min.insync.replicas paraméter 2-re van beállítva. Ebben az esetben a klaszter lehetővé teszi, hogy az egyik bróker, aki a téma particióját irányítja, leálljon anélkül, hogy hatással lenne az ügyfélalkalmazásokra.
Ez visszavisz minket az ismert kompromisszához a teljesítmény és a megbízhatóság között. A replikáció a követők megerősítései (acknowledgments) fogadásához szükséges plusz várakozási idő révén történik. Bár mivel párhuzamosan zajlik, legalább három csomóponton történő replikálás ugyanúgy teljesít, mint kettő (figyelmen kívül hagyva a további hálózati sávszélességhasználatot).
Ezen a replikációs sémán keresztül a Kafka ügyesen elkerüli, hogy minden üzenetet fizikailag le kellene írnia a lemezen a sync (). Minden üzenet, amelyet a producer elküld, a partíció naplójába lesz írva, de ahogy azt a 2. fejezetben tárgyaltuk, a fájlba történő írás kezdetben a rendszeroperációs memória pufferében történik. Ha ez az üzenet átkerül egy másik Kafka példányra és az annak memóriájában található, a vezető elvesztése nem jelenti azt, hogy maga az üzenet is elveszett — azt egy szinkronizált replikának átadhatják.
A művelet elvégzésének szükségessége sync () azt jelenti, hogy a Kafka olyan sebességgel képes fogadni az üzeneteket, ahogyan azokat a memóriában rögzíteni tudja. És fordítva, minél tovább lehet elkerülni a memória lemezre írását, annál jobb. Emiatt nem ritka, hogy a Kafka broker-ek 64 GB memóriát vagy annál többet kapnak. Ez a memóriahasználat lehetővé teszi, hogy egy Kafka példány könnyedén működjön több ezer alkalommal gyorsabban, mint a hagyományos üzenetbrókerek.
A Kafka beállítható úgy is, hogy a sync () üzenetcsomagokra alkalmazza a műveletet. Mivel a Kafka minden az üzenetcsomagok köré épül, ez valójában elég jól működik számos felhasználási szcenárióban, és hasznos eszköz azok számára, akik erős garanciákat igényelnek. A Kafka tiszta teljesítményének nagy része a brokerhez csomagokban küldött üzenetekhez kapcsolódik, és azok olvasásához a brokerből folyamatos blokkokban műveletek (olyan műveletek, amelyek során nem történik adatmásolás az egyik memóriahelyről a másikra). Az utóbbi tekintetében jelentős teljesítmény- és erőforrásnyereséget jelent, és csak a partíciós sémát meghatározó alapul szolgáló naplószerkezet használatának köszönhető.
A Kafka klaszterben sokkal magasabb teljesítmény érhető el, mint egyetlen Kafka broker használatával, mivel a téma partíciói vízszintesen skálázhatók számos különálló gépen.
Összegzés
Ebben a fejezetben azt vizsgáltuk, hogy a Kafka architektúrája hogyan gondolja újra a kapcsolatok kezelését az ügyfelek és a brókerek között, hogy rendkívül megbízható üzenetváltási csatornát biztosítson, amelynek áteresztőképessége sokszorosa a hagyományos üzenetbrókerének. Megbeszéltük azokat a funkciókat, amelyeket ehhez a célhoz használ, és röviden áttekintettük azokat az alkalmazásarchitektúrákat, amelyek biztosítják ezeket a funkciókat. A következő fejezetben a létező üzenetkezelő alapú alkalmazásokat érintő általános problémákat fogjuk megvizsgálni, és megvitatjuk a megoldási stratégiákat. A fejezetet azzal zárjuk, hogy vázoljuk, hogyan lehet az üzenetküldő technológiákról általában gondolkodni, hogy felmérhesse azok megfelelőségét az Ön felhasználási forgatókönyveihez.
Az előző fordított rész:
Fordítás befejezve:
Folytatás következik…
Csak a regisztrált felhasználók vehetnek részt a szavazáson. , kérem.
Használja a Kafkát a szervezetében?
Igen
Nem
Régebben használtuk, de most nem
Tervezünk használni
38 felhasználó szavazott. 8 felhasználó tartózkodott.
Forrás: habr.com
