

A táblák és indexek (bloat) felfúvódásának hatása széles körben ismert, és nemcsak a Postgres esetében jelentkezik. Vannak módszerek a megoldására, mint például a VACUUM FULL vagy a CLUSTER, de ezek blokkolják a táblákat a működés közben, és ezért nem mindig alkalmazhatók.
A cikkben lesz egy kis elmélet arról, hogy miként keletkezik a bloat, hogyan lehet ellene fellépni, a deferred constraintsről, és azokról a problémákról, amelyeket a pg_repack kiterjesztés használata során okoznak.
Ez a cikk a PgConf.Russia 2020 alapján készült.
Miért keletkezik a bloat
A Postgres alapja a többverziós modell (). Lényege, hogy egy táblába tartozó soroknak több verziója is lehet, a tranzakciók pedig ezek közül nem láthatnak többet egyidejűleg, de nem feltétlenül ugyanazt a verziót. Ez lehetővé teszi, hogy több tranzakció párhuzamosan működjön, anélkül hogy jelentős hatással lennének egymásra.
Nyilvánvaló, hogy az összes verziót tárolni kell. A Postgres lapkás memóriakezeléssel dolgozik, és egy lap a legkisebb adatmennyiség, amelyet a lemezről be lehet olvasni vagy rögzíteni. Nézzünk meg egy kis példát, hogy megértsük, hogyan történik ez.
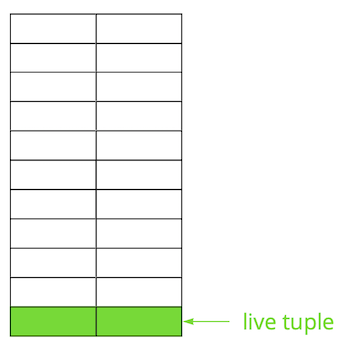
Tegyük fel, hogy van egy táblánk, amelyhez néhány bejegyzést adtunk hozzá. A fájl első lapján, ahol a tábla tárolva van, új adatok jelentek meg. Ezek aktív verziói a soroknak, amelyek más tranzakciók számára hozzáférhetőek a commit után (az egyszerűség kedvéért tegyük fel, hogy a Read Committed elszigeteltségi szintet alkalmazzuk).
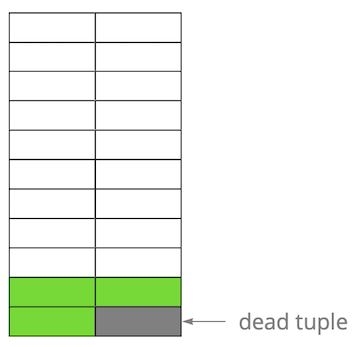
Ezután frissítettük az egyik bejegyzést, ezzel a régi verziót érvénytelenítettük.
Lépésről lépésre, a sorverziók frissítésével és törlésével egy olyan lapot kaptunk, amelyen körülbelül az adatok fele „szemetet” jelent. Ezek az adatok egyetlen tranzakció számára sem láthatók.
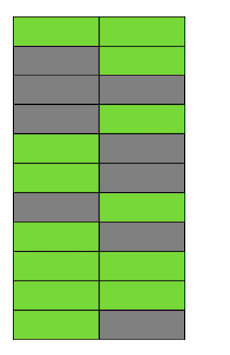
A Postgresben létezik egy mechanizmus, , amely eltávolítja az érvénytelen verziókat, és helyet szabadít fel az új adatok számára. De ha nem elég agresszíven van beállítva, vagy más táblákon dolgozik, akkor a „szemétadatok” ott maradnak, és nekünk kell plusz lapokat használnunk az új adatokhoz.
Így a példánkban egy adott pillanatban a tábla négy lapból fog állni, de csak a felében lesznek élő adatok. Ennek következtében, amikor a táblához fordulunk, sokkal több adatot fogunk beolvasni, mint amennyire valóban szükség van.
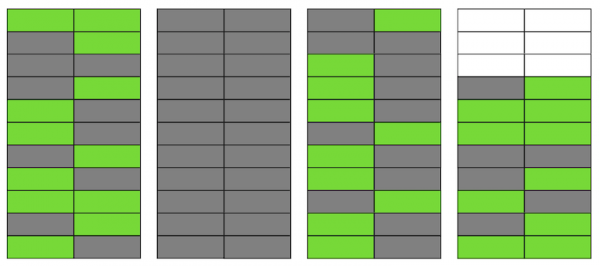
Még ha a VACUUM most minden elavult sort eltávolít is, a helyzet nem fog drámaian javulni. Lesz szabad hely az oldalon vagy akár teljes oldalak az új sorok számára, de még mindig több adatot fogunk olvasni, mint amennyire szükség van.
Egyébként, ha egy teljesen üres oldal (a második a példánkban) a fájl végén lenne, a VACUUM le tudná vágni. De most középen van, ezért nem tudunk vele mit kezdeni.
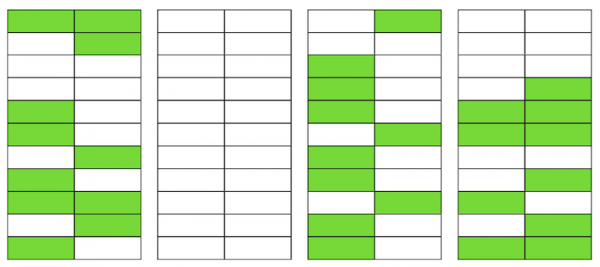
Amikor az ilyen üres vagy erősen megosztott oldalak száma megnő, amit bloatnak hívnak, ez kezd hatni a teljesítményre.
A fent leírtak a bloat keletkezésének mechanikája a táblákban. Az indexeknél is hasonlóan történik.
Van nekem bloatom?
Több módszer is létezik annak meghatározására, hogy van-e bloat. Az első elképzelés az, hogy a Postgres belső statisztikáit használjuk, amelyek körübelüli információt tartalmaznak a táblákban lévő sorok számáról, a "létező" sorok számáról stb. Az interneten számos előre megírt szkript változata elérhető. Mi a PostgreSQL Experts alapján vettük, amely értékelheti a táblák, a toast és a bloat btree-indexek bloatját. Tapasztalataink szerint a hibahatára 10-20%.
A másik módszer az, hogy használjuk a , ami lehetővé teszi a lapok belsejébe való betekintést és a bloat körüli becsült és pontos értékek megszerzését. De a második esetben az egész táblát be kell szkennelni.
A kis bloat értéket, akár 20%-ig, elfogadhatónak tartjuk. Ez hasonlít a fillfactor-hoz a és . 50%-nál és afelett teljesítménybeli problémák kezdődhetnek.
Bloat ellenes intézkedések
A Postgres-ben több bloat ellenes megoldás létezik, amelyek "készen" érkeznek, azonban ezek nem mindig és nem mindenki számára megfelelőek.
Állítsuk be az AUTOVACUUM-ot, hogy a bloat ne alakuljon ki.. Pontosabban, hogy ez egy elfogadható szinten maradjon az Ön számára. Úgy tűnik, hogy ez egy „kapitányi” tanács, de a valóságban ezt nem mindig könnyű elérni. Például, ha aktívan fejleszt, és rendszeresen változik az adatstruktúra, vagy adatvándorlás történik. Ennek következtében a terhelési profilja gyakran változhat, és általában eltérő a különböző táblák esetében. Ezért folyamatosan egy lépéssel előrébb kell dolgoznia, és az AUTOVACUUM-ot a különböző táblák változó profiljához kell igazítania. Nyilvánvaló, hogy ez nem egyszerű feladat.
Egy másik gyakori oka annak, hogy az AUTOVACUUM nem tudja feldolgozni a táblákat, a hosszú tranzakciók megléte, amelyek nem teszik lehetővé az adatok tisztítását, mert azok már ezekhez a tranzakciókhoz elérhetők. A javaslat itt is nyilvánvaló - megszabadulni a „függőben levő” tranzakcióktól, és minimalizálni az aktív tranzakciók idejét. De ha az Ön alkalmazásának terhelése OLAP és OLTP hibridje, akkor egyszerre lehet sok gyakori frissítés és rövid lekérdezés, valamint hosszú műveletek - például egy jelentés készítése. Ilyen helyzetben érdemes elgondolkodni a terhelés eltérő adatbázisokra történő elosztásán, ami lehetővé teszi, hogy egyesek finomhangoltabb beállításokat végezzenek.
Még egy példa - még ha a profil homogén is, de az adatbázis nagyon magas terhelés alatt áll, akkor még a legagresszívabb AUTOVACUUM sem képes megbirkózni, és a bloat fel fog halmozódni. A skálázás (vertikális vagy horizontális) az egyetlen megoldás.
Mi a teendő abban az esetben, amikor beállította az AUTOVACUUM-ot, de a bloat továbbra is nő.
A parancs VACUUM FULL újraépíti a táblázatok és indexek tartalmát, és csak az aktuális adatokat hagyja bennük. A bloat megszüntetésére tökéletesen működik, de végrehajtása során kizárólagos zárolást foglal le a táblán (AccessExclusiveLock), ami megakadályozza a lekérdezések, akár a select-ek végrehajtását is ezen a táblán. Ha megengedheti magának, hogy a szolgáltatását vagy annak egy részét egy időre leállítsa (tíztől órákig terjedően, az adatbázis méretétől és a hardverétől függően), akkor ez a lehetőség a legjobb. Sajnos nem tudjuk befejezni a VACUUM FULL-t a tervezett karbantartás ideje alatt, ezért ez a módszer nem megfelelő számunkra.
A parancs CLUSTER A táblák tartalmát is átrendezi, akárcsak a VACUUM FULL, de lehetővé teszi egy index megadását, amely szerint az adatok fizikailag rendezve lesznek a lemezen (bár a jövőbeli új soroknál a sorrend nem garantált). Bizonyos helyzetekben ez nem rossz optimalizálás egyes lekérdezésekhez – több rekord olvasásánál index alapján. A parancs hátránya ugyanaz, mint a VACUUM FULL esetében – a parancs a művelet idejére zárolja a táblát.
A parancs REINDEX Hasonlít az előző kettőhöz, de egy adott index vagy a tábla összes indexének újjáépítését végzi. A zárolások kicsit enyhébbek: ShareLock a táblán (megakadályozza a módosításokat, de engedi a select végrehajtást) és AccessExclusiveLock az újjáépített indexen (blokkolja az ezen indexet használó lekérdezéseket). Azonban a Postgres 12-es verziójában megjelent egy paraméter , amely lehetővé teszi az index újjáépítését anélkül, hogy megakadályozná a párhuzamos rekordok hozzáadását, módosítását vagy törlését.
Korábbi Postgres verziókban a REINDEX CONCURRENTLY-hoz hasonló eredményt érhetünk el a következőképpen: . Ez lehetővé teszi, hogy indexet hozzunk létre szigorú blokkolás nélkül (ShareUpdateExclusiveLock, amely nem akadályozza a párhuzamos lekérdezéseket), majd cseréljük ki a régi indexet újra, és távolítsuk el a régi indexet. Ez lehetővé teszi az indexek bloat-jának megszüntetését anélkül, hogy megzavarnánk az alkalmazás működését. Fontos figyelembe venni, hogy az indexek újjáépítése extra terhelést jelent a lemezes alrendszerre.
Tehát, ha az indexek esetében léteznek módszerek a bloat „forró” eltávolítására, a táblák esetében ez nem áll rendelkezésre. Itt különböző külső kiterjesztések lépnek a képbe: (korábban pg_reorg), , és mások. Jelen cikk keretein belül nem fogom ezeket összehasonlítani, csak a pg_repack-ről fogok beszélni, amelyet némi finomítás után mi is használunk.
Hogyan működik a pg_repack
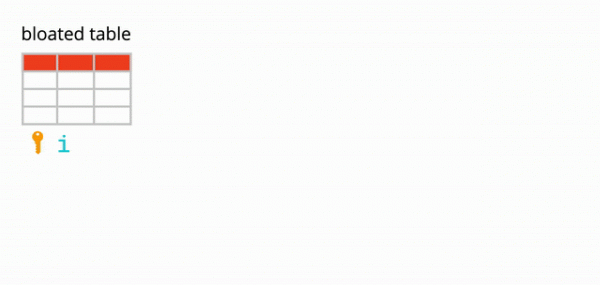
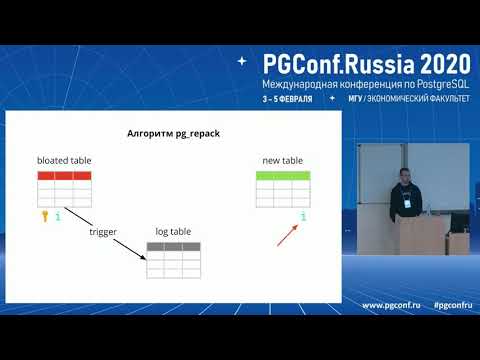
Tegyük fel, hogy van egy teljesen normális táblánk – indexekkel, korlátozásokkal és sajnos bloat-tal. A pg_repack első lépéseként létrehoz egy log-táblát, hogy tárolja az összes módosítás adatait a működés során. A trigger replikálja ezeket a változásokat minden insert, update és delete során. Ezután létrejön egy táblázat, amely szerkezetében hasonló az eredetire, de indexek és korlátozások nélkül, hogy ne lassítsa le az adatok beszúrásának folyamatát.
Ezután a pg_repack egy új táblába helyezi át a régi táblából származó adatokat, automatikusan kiszűrve minden elavult sort, majd indexeket hoz létre az új táblához. Az összes művelet végrehajtása során a napló táblában változások halmozódnak fel.
A következő lépés az, hogy az összes változást át kell helyezni az új táblába. Az átvitel több iteráción keresztül történik, és amikor a napló táblában kevesebb mint 20 rekord marad, a pg_repack szigorú zárolást von le, átvitele az utolsó adatokat, és a régi táblát újra cseréli a PostgreSQL rendszer tábláiban. Ez az egyedüli és nagyon rövid időszak, amikor nem tud dolgozni a táblával. Ezt követően a régi tábla és a napló táblák törlésre kerülnek, és felszabadul a hely a fájlrendszerben. A folyamat befejeződött.
Elméletben minden jól néz ki, de mi a helyzet a gyakorlatban? Teszteltük a pg_repack-ot terhelés nélkül és terhelés alatt, ellenőriztük a működését a korai leállítás esetén (egyszerűen fogalmazva, Ctrl+C-nél). Minden teszt pozitív volt.
Elmentünk a produkcióba - és itt minden úgy alakult, ahogy nem vártuk.
Első nehézségek a produkcióban
Az első klaszternél kaptunk egy egyedi megkötés megsértéséről szóló hibát:
$ ./pg_repack -t tablename -o id
INFO: táblázat "tablename" újrakonfigurálása
ERROR: a lekérdezés meghiúsult:
    ERROR: a duplikált kulcsérték megsérti az egyedi megszorítást "index_16508"
RÉSZLET: Kulcs (id, index)=(100500, 42) már létezik.
Ez a megszorítás automatikusan generált névvel rendelkezett, index_16508 -at a pg_repack hozta létre. Az alkotó elemek alapján meghatároztuk, hogy ez a mi megszorításunknak felel meg. A probléma az volt, hogy ez nem teljesen szokványos megszorítás, hanem késleltetett (), azaz az ellenőrzése később történik, mint az SQL parancs, ami váratlan következményekhez vezet.
Késleltetett megszorítások: mire van szükség és hogyan működnek
Egy kis elmélet a késleltetett megszorításokról.
Nézzünk egy egyszerű példát: van egy autókról szóló referenciatáblánk, amelynek két attribútuma van - a név és a referencia szám a táblázatban.
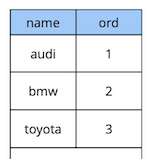
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Tegyük fel, hogy meg akarjuk cserélni az első és második autót. A "kapásból" megoldás: frissíteni az első értéket a másodikra, a másodikat pedig az elsőre:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
De amikor ezt a kódot végrehajtjuk, várhatóan eltérést kapunk, mert az értékek sorrendje egyedülálló a táblázatban:
[23305] HIBA: a duplikált kulcsérték megsérti az egyedi korlátozást „uk_cars”
Részletek: Kulcs (ord)=(2) már létezik.
Hogyan lehet másképp csinálni? Első lehetőség: hozzáadni egy további cserét egy olyan értékre, amely garantáltan nem létezik a táblázatban, például „-1”. A programozásban ezt „két változó értékének cseréjének egy harmadik változón keresztüli” nevezik. Ennek az módszernek az egyetlen hátránya a további frissítés.
Második lehetőség: áttervezni a táblázatot, hogy a sorrendet lebegőpontos adattípussal használja az egész számok helyett. Így, ha az értéket például 1-ről 2,5-re frissítjük, az első bejegyzés automatikusan „a második és a harmadik közé” kerül. Ez a megoldás működik, de két korlátozása van. Először is, nem fog megfelelni, ha az értéket valahol a felületen használják. Másodszor, az adatok típusának pontosságától függően korlátozott számú lehetséges behelyettesítés lesz a bejegyzések összes értékének újraszámítása előtt.
Harmadik lehetőség: az alapértelmezett korlátozás elhalasztása, hogy csak a commit pillanatában ellenőrizze:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Mivel a kezdeti lekérdezés logikája garantálja, hogy a commit pillanatában minden érték egyedi, ezért a művelet sikeres lesz.
A fenti példa természetesen nagyon szintetikus, de az ötletet megmutatja. Az alkalmazásunkban elhalasztott korlátozásokat használunk a logika megvalósítására, amely a felhasználók egyidejű munkájával kapcsolatos konfliktusokat kezeli közös objektum-widgeteken a táblán. Az ilyen korlátozások használata lehetővé teszi számunkra, hogy a nyelvi kódot egy kicsit egyszerűbbé tegyük.
Összességében a Postgres korlátozások ellenőrzésének három granularitási szintje van a korlátozás típusa szerint: sor, tranzakció és kifejezés szintjén.
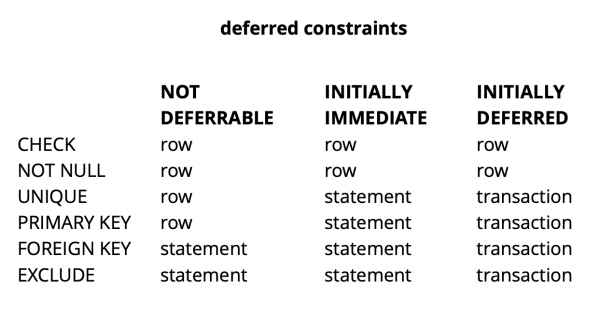
Forrás:
A CHECK és a NOT NULL mindig a sor szintjén kerülnek ellenőrzésre, míg a többi korlátozás, ahogy a táblázatból látható, különböző lehetőségekkel rendelkezik. Bővebben olvashat erről. .
Röviden összefoglalva, a késleltetett korlátozások számos helyzetben érthetőbb kódot és kevesebb parancsot eredményeznek. Azonban az ár, amit ezért fizetünk, a hibakeresési folyamat bonyolultabbá válása, mivel a hiba fellépésének pillanata és az, amikor megtudja róla, időben elkülönül. Egy másik lehetséges probléma az, hogy a ütemező nem mindig tud optimális tervet készíteni, ha a kérésben késleltetett korlátozás szerepel.
pg_repack továbbfejlesztése
Megértettük, mi is az a késleltetett korlátozás, de hogyan kapcsolódik ez a problémánkhoz? Emlékezzünk az előzőleg kapott hibára:
$ ./pg_repack -t tablename -o id
INFO: táblázat "tablename" újrakonfigurálása
ERROR: a lekérdezés meghiúsult:
    ERROR: a duplikált kulcsérték megsérti az egyedi megszorítást "index_16508"
RÉSZLET: Kulcs (id, index)=(100500, 42) már létezik.
Ez a hiba akkor lép fel, amikor az adatokat a napló táblából átmásolják egy új táblába. Ez furcsának tűnik, mivel a napló táblában lévő adatok a forrástábla adataival együtt kerülnek elkövetésre. Ha ezek megfelelnek a forrástábla korlátozásának, akkor hogyan sérthetik meg ugyanazokat a korlátozásokat az új táblában?
Úgy tűnik, a probléma gyökere a pg_repack korábbi lépésében rejlik, ahol csak indexek készülnek, de nem korlátozások: a régi táblában volt egy egyedi korlátozás, míg az újban ennek helyett egy egyedi index jött létre.
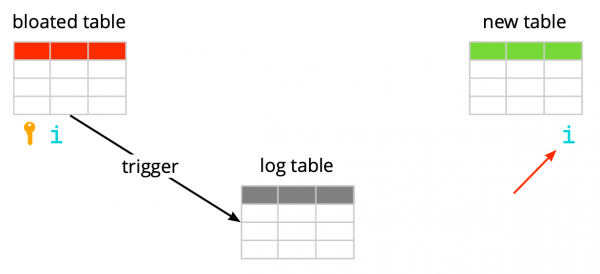
Fontos megjegyezni, hogy ha a korlátozás normális, és nem késleltetett, akkor az általa helyettesített egyedi index egyenértékű ezzel a korlátozással, mivel az egyedi korlátozások a Postgres-ben egyedi index létrehozásával valósulnak meg. De a késleltetett korlátozás esetében a viselkedés nem azonos, mivel az index nem lehet késleltetett és mindig ellenőrzésre kerül az sql-parancs végrehajtásának pillanatában.
Tehát a probléma lényege a „késleltetettség” ellenőrzésében rejlik: a forrástáblában ez az elkövetés pillanatában történik, míg az új táblában az sql-parancs végrehajtásának pillanatában. Ezért azt kell elérnünk, hogy az ellenőrzések mindkét esetben azonos módon történjenek: vagy mindig késleltetett formában, vagy mindig azonnal.
Tehát, mik voltak az ötleteink?
Hozzunk létre egy indexet, amely hasonló a deferred-hez.
Az első ötlet az, hogy mindkét ellenőrzést azonnali módban hajtsuk végre. Ez néhány hamis pozitív hatást okozhat a megszorításoknál, de ha ezek száma kicsi, nem kell, hogy befolyásolja a felhasználók munkáját, mivel az ilyen konfliktusok normális helyzetek számítanak számukra. Ilyenkor például amikor két felhasználó egyszerre kezd egyazon widgetet szerkeszteni, a második felhasználó kliensének nem jut el időben az információ, hogy a widget már blokkolva van az első felhasználó által. Ilyen helyzetben a szerver a második felhasználónak elutasítja a kérelmét, és a kliens visszaállítja a változtatásokat, valamint blokkolja a widgetet. Később, amikor az első felhasználó befejezi a szerkesztést, a második információt kap arról, hogy a widget már nem blokkolt, és újra megpróbálhatja a műveletet.
Annak érdekében, hogy az ellenőrzések mindig sürgősségi módban működjenek, létrehoztunk egy új indexet, amely hasonló az eredeti késleltetett megszorításhoz:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- futtasd a pg_repack-et
DROP INDEX CONCURRENTLY uk_tablename__immediate;
A tesztkörnyezetben mindössze néhány várható hibát tapasztaltunk. Siker! Újra futtattuk a pg_repack-et a termelési környezetben, és egy óra alatt 5 hibát kaptunk az első klaszteren. Ez elfogadható eredmény. Azonban a második klaszternél a hibák száma többszörösére növekedett, ezért le kellett állítanunk a pg_repack-et.
Miért történt ez? A hiba előfordulásának valószínűsége attól függ, hogy hány felhasználó dolgozik párhuzamosan ugyanazon widgetekkel. Úgy tűnik, hogy abban a pillanatban, amikor az első klaszter adatain dolgoztunk, sokkal kevesebb versenyképes változtatás történt, mint a többi klaszteren, tehát egyszerűen csak "szerencsénk" volt.
Az ötlet nem működött. Abban a pillanatban két másik megoldási lehetőséget láttunk: átírni az alkalmazásunk kódját, hogy elhagyjuk a késleltetett megszorításokat, vagy "megtanítani" a pg_repack-et, hogy tudja kezelni őket. Mi a másodikat választottuk.
A késleltetett megszorításokat az eredeti táblából az új táblában tartsuk nyilván.
A módosítás célja nyilvánvaló volt – ha az eredeti táblának késleltetett megszorítása van, akkor az újhoz ilyen megszorítást kell létrehozni, nem indexet.
A változtatásaink ellenőrzésére írtunk egy egyszerű tesztet:
- tábla késleltetett megszorítással és egy bejegyzéssel;
- adatok ciklikus beszúrása, amelyek konfliktálnak a meglévő bejegyzéssel;
- frissítjük – az adatok már nem ütköznek;
- kommittáljuk a változásokat.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
A pg_repack eredeti verziója mindig az első insertnél meghalt, a módosított verzió hibák nélkül futott. Kiváló.
Kimegyünk a prod-ra, és újra ugyanabba a hiba állapotába ütközünk az adatok log táblából az új táblába másolásakor:
$ ./pg_repack -t tablename -o id
INFO: táblázat "tablename" újrakonfigurálása
ERROR: a lekérdezés meghiúsult:
    ERROR: a duplikált kulcsérték megsérti az egyedi megszorítást "index_16508"
RÉSZLET: Kulcs (id, index)=(100500, 42) már létezik.
Klasszikus helyzet: a tesztkörnyezetekben minden működik, de a prod-on nem?!
APPLY_COUNT és a két batch határa
Elkezdte elemezni a kódot szavasan, és felfedeztük a fontos dolgot: az adatok átvitele a log táblából az új táblába batch-ekben történik, az APPLY_COUNT konstanta a batch méretét jelölte:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* lehet, hogy még van néhány tuple, ismételjük. */
...
}
A probléma az, hogy az eredeti tranzakció adatai, amelyekben több művelet is potenciálisan megsértheti a korlátozást, batch-ek határára kerülhetnek – az első batch-en a műveletek fele el lesz kötelezve, a másik fele pedig a második batch-en. Itt jön a szerencse: ha az első batch műveletei nem sértenek semmit, akkor minden rendben van, ha viszont sértenek – hiba lép fel.
Az APPLY_COUNT 1000 rekordot jelent, ami megmagyarázza, miért futottak a tesztjeink sikeresen – nem fedték le a "batch-ek határának" esetét. Két parancsot használtunk – insert és update, így pontosan 500 tranzakció, kettő parancs mindig belefért a batch-be, és nem tapasztaltunk problémát. A második update hozzáadásával a módosításunk megszűnt működni:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- még egy update
    COMMIT;
  END;
END LOOP;
Tehát a következő feladat az, hogy az eredeti táblából az adatok, amelyek egy tranzakción belül változtak, szintén egy tranzakción belül kerüljenek az új táblába.
A batch-elésről való lemondás
És ismét két megoldási lehetőségünk volt. Az első: mondjunk le a batch-ekre való felosztásról, és végezzük el az adatátvitelt egy tranzakcióban. Ennek a megoldásnak az előnye a ritkaságában rejlik – a kód módosítása minimális (egyébként a régebbi verziókban a pg_reorg pontosan így működött). De van egy probléma – hosszú tranzakciót hozunk létre, ami, ahogy azt korábban említettük, újabb bloat keletkezésének fenyegetése.
A második megoldás – bonyolultabb, de valószínűleg helyesebb: hozzunk létre a log táblában egy oszlopot, amely az adatokat a táblába felvevő tranzakció azonosítóját tartalmazza. Ez lehetővé teszi a másolt adatok csoportosítását ezen jellemző szerint, garantálva, hogy a kapcsolódó módosítások együtt kerülnek átvitelre. A batch több tranzakcióból (vagy egy nagyobbból) fog állni, és a mérete a tranzakciók során végrehajtott módosítások mennyiségétől függ. Fontos megjegyezni, hogy mivel a különböző tranzakciók adatai véletlenszerű sorrendben kerülnek be a log táblába, már nem olvashatók vissza sorozatosan, mint korábban. A tx_id alapján történő seqscan minden lekérdezésnél túl drága, szükség van indexre, de az viszont lassítja a módszert a frissítési költségek miatt. Összességében mindig kell valamiről lemondani.
Tehát úgy döntöttünk, hogy az első megoldással kezdjük, mivel ez egyszerűbb. Először is meg kellett értenünk, hogy a hosszú tranzakció valódi problémát jelent-e. Mivel az alapvető adatátvitel a régi táblából az új táblába szintén egy hosszú tranzakcióban történik, a kérdés átalakult arra, hogy “mennyi időt fogunk megnövelni ezzel a tranzakcióval?” Az első tranzakció időtartama főként a tábla méretétől függ. Az új tranzakció időtartama attól függ, hogy mennyi módosítás halmozódik fel a táblában az adatkapcsolás ideje alatt, tehát a terhelés intenzitásától. A pg_repack futtatása minimális terhelés mellett történt, és a módosítások mennyisége összehasonlíthatatlanul kicsi volt az eredeti tábla méretéhez képest. Úgy döntöttünk, hogy figyelmen kívül hagyjuk az új tranzakció időtartamát (átlagosan ez 1 óra és 2-3 perc).
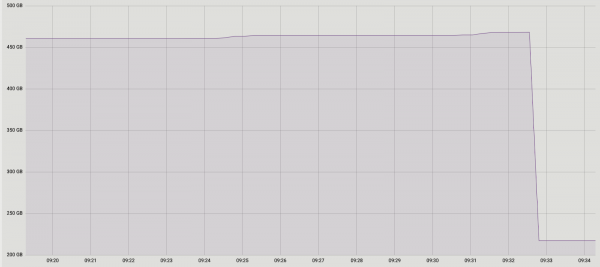
A kísérletek kedvezően alakultak. A produkciós környezetbe való bevezetés is. Az áttekinthetőség kedvéért – itt van egy képen az egyik adatbázis mérete a futtatás után:
Mivel ez a megoldás teljesen megfelelt számunkra, nem próbáltuk megvalósítani a másodikat, de fontolóra vesszük a lehetőséget, hogy megbeszéljük a fejlesztőkkel a bővítményt. Jelenlegi fejlesztésünk sajnos még nem készült el a közzétételre, mivel csak az egyedi késleltetett korlátozásokkal sikerült megoldani a problémát, míg a teljes javításhoz más típusok támogatását is meg kell valósítani. Reméljük, hogy a jövőben sikerül ezt megvalósítani.
Talán felmerült a kérdés, hogy miért fogtunk neki ebbe a pg_repack fejlesztésbe, miért nem használtunk inkább alternatívákat? Mi is gondolkodtunk ezen egy ideig, de a korábbi pozitív tapasztalataink a késleltetett korlátozások nélküli táblázatokkal motiváltak arra, hogy próbáljunk megérteni a probléma lényegét és kijavítani azt. Ezen kívül más megoldások használata is időt igényel a teszteléshez, ezért úgy döntöttünk, hogy először próbáljuk meg javítani a problémát benne, és ha rájövünk, hogy ezt ésszerű időn belül nem tudjuk megoldani, akkor elkezdjük fontolóra venni az alternatívákat.
Következtetések
A saját tapasztalatunk alapján mit tudunk ajánlani:
- Figyeld a bloat-ot. A monitorozási adatok alapján megértheted, mennyire jól van beállítva az autovacuum.
- Állítsd be az AUTOVACUUM-ot, hogy a bloat a megengedett szinten maradjon.
- Ha a bloat mégis nő, és nem tudod kezelni a "dobozból" származó eszközökkel, ne félj külső bővítményeket használni. A legfontosabb, hogy mindent jól tesztelj.
- Ne félj testre szabni a külső megoldásokat a szükségleteidhez – néha ez hatékonyabb és még egyszerűbb is lehet, mint a saját kódod módosítása.
Forrás: habr.com
