

A tevékenységek során előfordul, hogy a fejlesztő lekérdezést ír, és azt gondolja, hogy „az adatbázis okos, majd maga megoldja!«
Bizonyos esetekben (részben az adatbázis funkcióinak ismeretének hiánya, részben pedig a korai optimalizálás miatt) ez a hozzáállás "frankenstein" megoldásokhoz vezet.
Először egy ilyen lekérdezés példáját fogom bemutatni:
-- minden kulcspárhoz megkeressük a kapcsolódó mezők értékeit
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- megkeressük az első kulcshoz tartozó min/max értékeket
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- összekapcsoljuk az első kulcs szerint a kulcspárokat és a min/max értékeket
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
A lekérdezés minőségének tárgyilagos értékeléséhez hozzunk létre egy önkényes adattartalmat:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
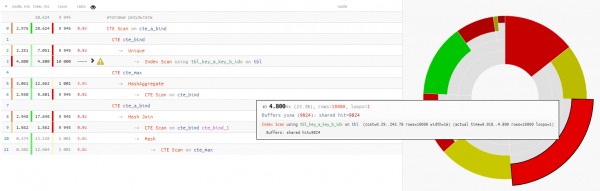
Kiderül, hogy az adatok olvasása kevesebb mint negyedét tette ki a lekérdezés teljes idejének végrehajtásakor:
Bontsuk le apróra
Nézzük meg közelebbről a lekérdezést, és gondolkodjunk el rajta:
- Miért van itt WITH RECURSIVE, ha nincsenek rekurrens CTE-k?
- Miért csoportosítják a min/max értékeket külön CTE-ben, ha ezek így is úgyis a eredeti lekérdezéshez kapcsolódnak?
+25% idő - Miért használunk a végén újbóli olvasást az előző CTE-ből egy feltétel nélküli ‘SELECT * FROM’-on keresztül?
+14% idő
Ebben az esetben még szerencsénk volt, hogy a kapcsolódáshoz Hash Join-t választottunk, nem Nested Loop-ot, mert akkor nem egyetlen CTE Scan-t, hanem 10K-t kaptunk volna!
kicsit a CTE Scan-rólItt emlékeznünk kell arra, hogy a CTE Scan a Seq Scan megfelelője — tehát semmilyen indexelés nem történik, csak teljes átvizsgálás, ami megkövetelné 10K x 0.3ms = 3000ms a cte_max-ra vonatkozó ciklusoknál vagy 1K x 1.5ms = 1500ms a cte_bind-ra vonatkozó ciklusoknál!
Valójában mit akartunk elérni eredményként? Igen, általában egy ilyen kérdés merül fel körülbelül az ötödik percben, amikor „háromszintes” lekérdezéseket elemezünk.
Azt szerettük volna, hogy minden egyedi kulcspárhoz megjelenjen a key_a szerint csoportosított min/max.
Ezért használjunk :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 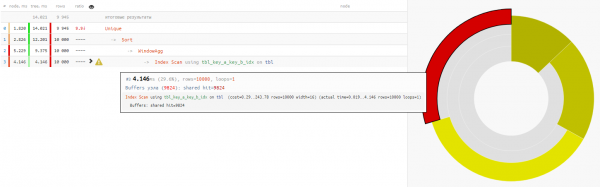
Mivel az adatok olvasása mindkét esetben körülbelül 4-5 ms-t vesz igénybe, így az összes időnyereményünk -32% — tisztán a CPU bázisról levett terhelés., ha egy ilyen lekérdezést elegendő gyakorisággal végrehajtanak.
Általánosságban nem érdemes a bázist arra kényszeríteni, hogy a "kereket hordja és a négyzetet gurítsa".
Forrás: habr.com
