

Komplex ERP rendszerekben sok entitás hierarchikus jelleggel bír, amikor az azonos típusú objektumok szerkezetbe rendeződnek a „szülő-gyermek” kapcsolatok fájában — ez magában foglalja a vállalat szervezetét (mindezek a fiókok, osztályok és munkacsoportok), a termékek katalógusát, a munkaterületeket és az értékesítési pontok földrajzát,…
Valójában nincs egyetlen , ahol valamilyen hierarchia ne lenne jelen. De még ha nem is üzleti területen dolgozik, akkor is könnyen szembesülhet hierarchikus kapcsolatokkal. Egyszerűen, még a családfája vagy a bevásárlóközpont emeleteinek terve is egy hasonló struktúra.
Számos módja van ennek a fáj struktúrának az adatbázisban történő tárolására, de ma csak egy lehetőséget veszünk szemügyre:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- ne feledje, hogy a FK nem feltételezi az index automatikus létrehozását, ellentétben a PK-val
És amíg mélyen a hierarchiába merül, a figyelem várakozik, hogy mennyire lesznek [nem] hatékonyak az Ön "naiv" módszerei az ilyen struktúrával való munkához.
Nézzük meg a tipikus felmerülő feladatokat, megvalósításukat SQL-ben, és próbáljuk meg javítani teljesítményüket.
#1. Насколько глубока кроличья нора?
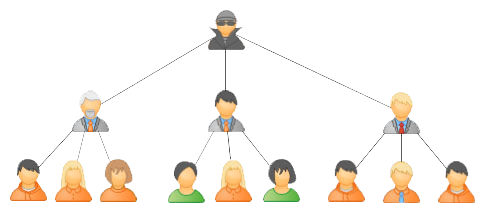
Tartsuk megvilágított dologként, hogy ez a struktúra az osztályok alárendeltségét tükrözze a szervezet felépítésében: osztályok, divíziók, szektorok, fiókok, munkacsoportok,… — ahogy csak hívhatjuk őket.
Először generáljuk le a 'fánkat' 10K elemre
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Kezdjük a legegyszerűbb feladattal — megtalálni az összes munkatársat, aki egy adott szektorban dolgozik, vagy hierarchiai kifejezésekkel élve — minden utódot megkeresni a csomópontból. Egyúttal jól jöhet a leszármazott mélységének megismerése is… Mindez szükséges lehet például valamilyen .
Minden rendben lenne, ha ezek a leszármazottak csak pár szinten keresztül és tízes nagyságrendben állnának rendelkezésre, de ha a szintek száma meghaladja az 5-öt, és a leszármazottak már több tucatnyiak — problémák léphetnek fel. Nézzük meg, hogyan működnek a hagyományos módszerek a „fákon lefelé történő” kereséshez. De először határozzuk meg, hogy mely csomópontok lesznek a legtöbbet érdekelt a kutatásunkban.
A legnagyobb „mély” alfaágak:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...A legnagyobb „széles” alfaágak:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
Ezekhez a lekérdezésekhez egy tipikus rekurzív JOIN-t:
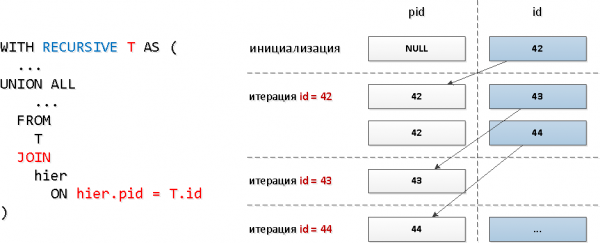
Nyilvánvaló, hogy ebben a lekérdezési modellben az iterációk száma megegyezik a leszármazottak számával (és ezek biztosan tucatnyian vannak), és ez elegendő erőforrást és időt vehet igénybe.
Nézzük meg a „legszélesebb” alfát:
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 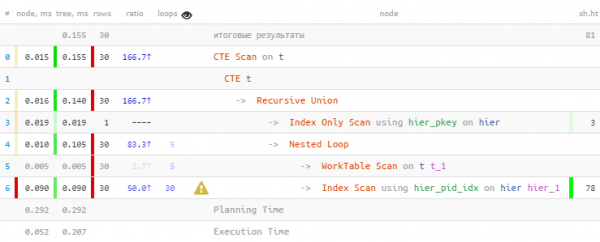
Ahogy vártuk, megtaláltuk az összes 30 bejegyzést. De 60%-át a teljes időnek elhasználtuk rá — mert ezen a műveleten keresztül 30 index-keresést is végrehajtottunk. De lehetne ezt kevesebb idő alatt is?
Tömeges index-leolvasás
De vajon minden egyes csomóponthoz szükséges külön lekérdezést végrehajtani az indexen? Kiderül, hogy nem — az indexből több kulcs alapján is olvashatunk egy hívás során segítségével = ANY(array).
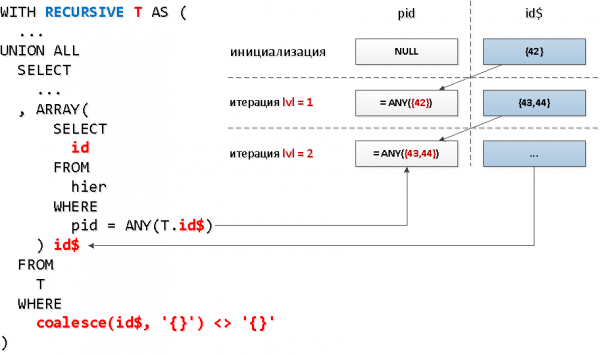
Minden ilyen azonosító csoporthoz felvehetjük az előző lépésben talált összes ID-t a „csomópontok” szerint. Tehát az egyes következő lépésekben az összes leszármazottat kereshetjük egy adott szinten. Csak az a probléma, hogy.
a rekurzív lekérdezésnél nem hivatkozhatunk a saját magunkra egy belső lekérdezésben , de szükségünk van rá, hogy csak azokat a találatokat szűrjük, amelyeket az előző szinten kaptunk… Kiderül, hogy nem lehet belső lekérdezést végezni az összes kiválasztott elemre — viszont a konkrét mezőire lehet. Ráadásul ez a mező lehet tömb is — amire szükségünk van az ANY használatához.ANY Ez kissé furcsán hangzik, de a sémán — minden egyszerű..
Először furcsának tűnhet, de a diagramon minden egyszerű.
REKURZÍV T KÉRDÉSSEL (
  VÁLASZTHATÓ
    ARRAY[id] id$
  BŐL
    hier
  HOL
    id = 5300
UNIO MINDENNEL
  VÁLASZTHATÓ
    ARRAY(
      VÁLASZTHATÓ
        id
      BŐL
        hier
      HOL
        pid = ANY(T.id$)
    ) id$
  BŐL
    T
  HOL
    coalesce(id$, '{}') <> '{}' -- a ciklus kilépési feltétele - üres tömb
)
VÁLASZTHATÓ
  unnest(id$) id
BŐL
T; 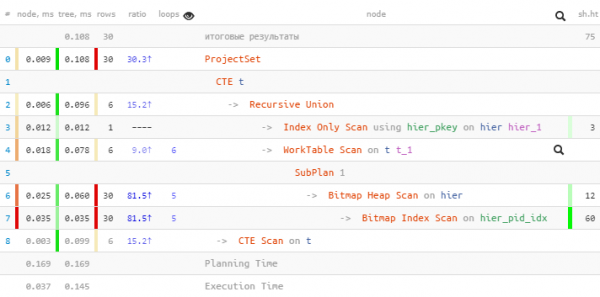
És itt a legfontosabb nem is az, hogy 1,5-szeres időnyereség, hanem hogy kevesebb buffert vontunk le, mivel az indexelésünkre mindössze 5 alkalommal hivatkozunk a 30 helyett!
További bónusz, hogy a végső unnest után a azonosítók a „szintek” szerint rendezettek maradnak.
A csomópont jellemzője
A következő megfontolás, amely segíthet a teljesítmény javításában — a „leveleknek” nem lehet gyermekük, tehát ennek megfelelően nem szükséges „lefelé” keresni. A feladatunk megfogalmazásában ez azt jelenti, hogy ha végigmentünk a részleg láncolaton, és eljutottunk egy alkalmazotthoz, akkor nem érdemes tovább keresni ezen az ágon.
Vezessünk be a táblánkba további boolean-mezőt, amely azonnal megmutatja nekünk, hogy ez a konkrét bejegyzés a fában „csomópont”-e — azaz létezhetnek-e utódai.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
HOL
  EXISTS(
    VÁLASZTHATÓ
      NULL
    BŐL
      hier
    HOL
      pid = T.id
    LIMIT 1
);
-- A lekérdezés sikeresen végrehajtva: 3033 sor módosítva 42 ms alatt.
Remek! Kiderült, hogy a fában lévő elemek csak kicsit több mint 30%-a rendelkezik utódokkal.
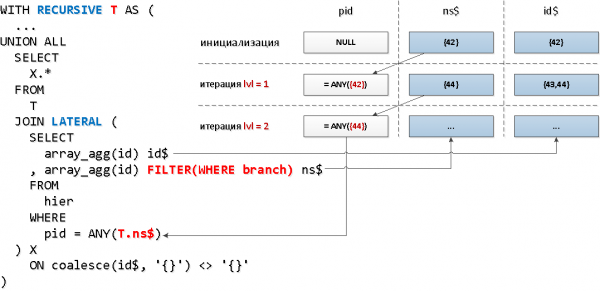
Most alkalmazzunk egy kissé eltérő mechanikát — csatlakozás a rekurzív részhez LATERAL, ami lehetővé teszi, hogy azonnal hivatkozzunk a rekurzív „tábla” mezőire, és a csomópont jellemzője szerinti szűréshez aggregáló funkciót használunk a kulcsok készletének csökkentésére:
REKURZÍV T KÉRDÉSSEL (
  VÁLASZTHATÓ
    array_agg(id) id$
  , array_agg(id) FILTER(WHERE branch) ns$
  BŐL
    hier
  HOL
    id = 5300
UNIO MINDENNEL
  VÁLASZTHATÓ
    X.*
  BŐL
    T
  Csatlakozás LATERÁLIS (
    VÁLASZTHATÓ
      array_agg(id) id$
    , array_agg(id) FILTER(WHERE branch) ns$
    BŐL
      hier
    HOL
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}') <> '{}'
)
VÁLASZTHATÓ
  unnest(id$) id
BŐL
T; 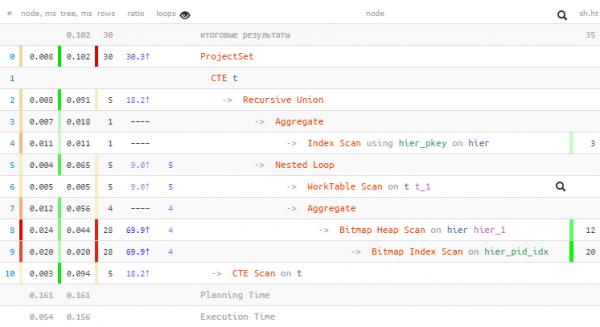
Sikerült csökkentenünk egy újabb indexelési hívást, és több mint kétszeres nyereséget értünk el a volume leolvasott számában.
#2. Вернемся к корням
Ez az algoritmus hasznos lehet, ha az összes elem nyilvántartását fel akarja gyűjteni „felfelé a fában”, miközben megőrzi az információt, hogy melyik eredeti levél (és milyen mutatókkal) váltotta ki a kiválasztást — például egy aggregáló jelentés készítéséhez a csomópontokra.
A továbbiakat kizárólag proof-of-conceptként érdemes szemlélnünk, mivel a lekérdezés túl terjedelmes. De ha vezérszerepet játszik az adatbázisában, érdemes elgondolkodni hasonló módszerek alkalmazásán.
Kezdjük néhány egyszerű állítással:
- Ugyanazt az bejegyzést az adatbázisból jobban olvasni egyszer.
- Az adatbázisból származó bejegyzések hatékonyabban olvashatók "csomagban", mint egyesével.
Most próbáljuk meg megkonstruálni a szükséges lekérdezést.
1. lépés
Nyilvánvaló, hogy a rekurzió inicializálásánál (hova is máshová!) nekünk le kell olvasnunk maguknak a leveleknek a bejegyzéseit a megadott azonosítók halmazából:
WITH RECURSIVE tree AS (
  SELECT
    rec -- ez a teljes bejegyzés a táblázatból
  , id::text chld -- ez a "halmaz" amely az ide vezető leveleket tartalmazza
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Ha valakinek furcsának tűnik, hogy a „halmaz” karakterláncként van tárolva, nem pedig tömbként, annak egyszerű magyarázata van. A karakterláncokhoz létezik beépített aggregáló „összefűző” függvény string_agg, míg a tömböknél — nem. Bár ez könnyen megvalósítható önállóan .
2. lépés
csoportosítanunk őket , megőrizve közben a forráslevelekkel kapcsolatos információt.De itt három kellemetlenség vár ránk:
A "fordított rekurzív" lekérdezés nem tartalmazhat aggregáló függvényeket
- GROUP BY
A rekurzív „táblázás” nem található egy beágyazott lekérdezésben.. - A rekurzív rész lekérdezése nem tartalmazhat CTE-t.
- Szerencsére ezeket a problémákat elég könnyen megkerülhetjük. Kezdjük a végével.
CTE a rekurzív részben
Így
működik: nem WITH RECURSIVE tree AS ( ... UNION ALL WITH T (...) SELECT ... )
Ez pedig — működik, a zárójelek megoldják!WITH RECURSIVE tree AS ( ... UNION ALL ( WITH T (...) SELECT ... ) )
Beágyazott lekérdezés a rekurzív "táblázásra"Hmph... A rekurzív CTE-hez való hozzáférés nem lehet beágyazott lekérdezésben. De lehet CTE-n belül! És a beágyazott lekérdezés már hivatkozhat erre a CTE-re!
GROUP BY a rekurzióban
Kellemetlen, de... Van egy egyszerű módszerünk, amellyel szimulálhatjuk a GROUP BY-t a
DISTINCT ON és ablakfüggvények segítségével! SELECT (rec).pid id , string_agg(chld::text, ',') chld FROM tree WHERE (rec).pid IS NOT NULL GROUP BY 1 -- nem működik!
De így — működik!SELECT DISTINCT ON((rec).pid) (rec).pid id , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld FROM tree WHERE (rec).pid IS NOT NULL
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Most már látjuk, miért változott a szám ID szöveggé — hogy vesszővel lehessen őket összekapcsolni!
3. lépés
A végére már csak egy kis dolog maradt:
- ellenőrizzük a "szakaszok" bejegyzéseit a csoportosított ID-k alapján
- összevetjük az ellenőrzött szakaszokat az "alaplapok" készleteivel
- a sort készletet "meghosszabbítjuk" a következővel
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 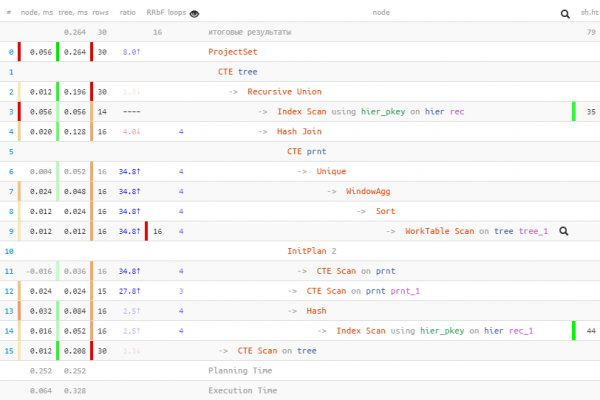
Forrás: habr.com
