

A fejlesztő időnként szükségét érzi paraméterek halmazának vagy akár egy teljes válogatásnak a kérésbe való átadására »bemenetként«. Néha nagyon furcsa megoldásokra bukkanhatunk e feladat kapcsán.
Kezdjük „fordított irányból”, és nézzük meg, hogyan nem szabad ezt csinálni, miért, és hogyan lehet jobban megoldani.
Az értékek közvetlen „beillesztése” a kérés törzsében
Általában így néz ki:
query = "SELECT * FROM tbl WHERE id = " + value… vagy így:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Erről a módszerről elég sokat írtak és bőven:
Csaknem mindig ez — közvetlen utat jelent a SQL-injekciókhoz és a felesleges terhet a vállalati logikára, amely kénytelen „összeragasztani” a kérésed szövegét.
Ez a megközelítés részben csak akkor indokolt, ha szükség van particionálásra PostgreSQL 10-es és régebbi verzióiban a hatékonyabb terv elérése érdekében. Ezekben a verziókban a bejárandó szakaszok listáját még a közvetített paraméterek figyelembevételével határozzák meg, csupán a kérés törzse alapján.
$n-argumentumok
Használat paraméterei — ez jó, lehetővé teszi a , csökkentve a terhelést a vállalati logikán (a kérés szövegét csak egyszer alakítják ki és továbbítják) és az adatbázisszerveren (nem szükséges a kérés minden példányához újraelemzést és tervet készíteni).
Változó számú argumentumok
Problémák várnak ránk, amikor előre ismeretlen számú argumentumot akarunk átadni:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Ha a kérdést így hagyjuk, az ugyan megvéd minket a potenciális injekcióktól, de még mindig szükség lesz a kérdés összerakására/elemzésére minden variációhoz az argumentumok számától függően.. Már jobb, mint minden alkalommal megcsinálni, de elkerülhetjük ezt is.
Elég egyetlen paramétert átadni, amely tartalmazza a tömb sorosított nézetét:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Az egyetlen különbség — szükséges explicit módon átkonvertálni az argumentumot a megfelelő tömptípusra. De ez nem okoz problémát, mivel így is előre tudjuk, hová irányítunk.
Kiválasztás (mátrix) átadása
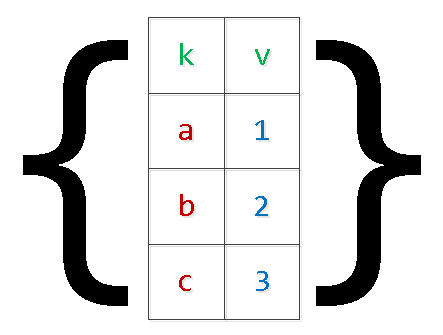
Általában ez mindenféle adatcsomag átadására vonatkozik, amiket egy kérésen belül be szeretnénk illeszteni az adatbázisba:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...A fent ismertetett „összeragasztási” problémákon kívül ez még további memóriahiányhoz is vezethet. és a szerver leállásához. Az oka egyszerű — a PG az argumentumoknál plusz memóriát foglal le, a rekordok száma pedig csak az alkalmazás üzleti logikájának kívánalmaitól függ. Különösen szélsőséges esetekben figyelemmel találkoztunk "numerikus" argumentumok több mint 9000 dollárt. — nem kell így.
Írjuk át a lekérdezést, alkalmazva már a "két szintű" sorozatolást:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Igen, ha "bonyolult" értékek vannak a tömbben, akkor őket idézőjelek közé kell zárni.
Kétségtelen, hogy ezzel a módszerrel a tetszőleges számú mezőt "kibővíthetjük".
unnest, unnest, …
Időszakosan találkozunk olyan változatokkal, amelyeknél a "tömbök tömbje" helyett több "oszlop tömböt" adunk meg, amiről már említést tettem. :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Ezzel a módszerrel, ha hibázunk az értékek listáinak generálásában különböző oszlopokhoz, nagyon könnyen teljesen váratlan eredményeket kaphatunk., amelyek még a szerver verziójától is függenek:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Már a 9.3-as verziótól kezdődően a PostgreSQL-ben teljes értékű funkciók jelentek meg a json típus kezelésére. Ezért, ha a belépési paraméterek definiálása a böngészőben történik, akkor ott közvetlenül létrehozhatja a JSON objektumot SQL lekérdezéshez.:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Az előző verziókban ugyanígy használható each(hstore), de a helyes "összehúzás" a bonyolult objektumok hstore-ban való escaped-nél problémákat okozhat.
json_populate_recordset
Ha előre tudja, hogy az "belső" json-tömbből származó adatok egy tábla kitöltésére szolgálnak, akkor jelentősen megtakaríthat a mezők dereferálásában és típusokká alakításában a json_populate_recordset függvény használatával:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Ez a függvény egyszerűen "kibővíti" a megadott objektumok tömbjét egy lekérdezésre, anélkül, hogy a táblázat formátumára támaszkodna:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
IDEIGLENES TÁBLA
De ha a továbbított lekérdezésben az adatok volumene nagyon nagy, akkor azokat egyetlen sorozatparaméterbe beilleszteni — nehéz, és néha lehetetlen, mivel egyszeri nagy mennyiségű memória lefoglalását igényli.Például, ha hosszú időn át egy nagy adatcsomagot kell gyűjtened egy külső rendszerből, majd egyszerre szeretnéd feldolgozni az adatbázis oldalán.
Ebben az esetben a legjobb megoldás :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- ismételd sok-sok alkalommal
...
-- itt valami hasznosat csinálunk az egész táblával
Ez a módszer kifejezetten jó nagy mennyiségű adat ritka továbbításához adatok.
A struktúrád leírásának szempontjából az ideiglenes tábla csupán egy jellemzőben különbözik a "normál" táblától a rendszertáblában pg_class, míg a pg_type, pg_depend, pg_attribute, pg_attrdef, … — így valójában semmiben.
Ezért a webes rendszerekben, ahol sok rövid életű kapcsolat van, minden alkalommal új rendszeres bejegyzéseket generál ez a tábla, amelyeket a kapcsolatok lezárásával törölnek az adatbázissal. Végül a TEMP TABLE ellenőrizetlen használata a pg_catalog táblák "megnövekedését" eredményezi és sok olyan művelet lelassul, amelyek ezeket használják.
Természetesen ezzel lehet küzdeni a VACUUM FULL időszakos futtatásával a rendszertárban található táblákon.
Session változók
Tegyük fel, hogy a fenti esetből származó adatok feldolgozása túl bonyolult egy SQL lekérdezéshez, de elég gyakran szeretnénk végrehajtani. Tehát eljárásos feldolgozást szeretnénk használni de az ideiglenes táblákon keresztüli adatátadás túl költséges lenne.
A $n paramétereket sem használhatjuk az anoním blokkba történő átadásra. A megoldásban a session változóink és a current_setting.
9.2-es verzió előtt külön konfigurálni kellett custom_variable_classes a „saját” session változóink számára. A jelenlegi verziókban viszont nagyjából így lehet írni:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- ÉSZREVÉTEL:  id : 1
-- ÉSZREVÉTEL:  id : 2
-- ÉSZREVÉTEL:  id : 3
Más támogatott eljárási nyelvekben további megoldásokat találhatunk.
Ismersz más módszereket? Oszd meg a véleményed kommentben!
Forrás: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish