

Folytatjuk egy sor cikket, amelyek az ismeretlen módszerek teljesítményjavítására összpontosítanak a "látszólag egyszerű" PostgreSQL lekérdezések esetében:
Ne gondolja, hogy annyira nem szeretem a JOIN-t... 🙂
De sokszor a lekérdezés jelentősen teljesítményesebb, ha elkerüljük. Ezért ma megpróbáljuk egyáltalán megszabadulni a nagy erőforrást igénylő JOIN-tól — egy szótár segítségével.
A PostgreSQL 12-től kezdődően a lenti szituációk egy része kissé másképp jelentkezhet . Ez a viselkedés visszaállítható a korábbi állapotba a kulcs megadásával
MATERIALIZED.
Sok "tény" egy korlátozott szótár miatt
Nézzünk egy teljesen valós alkalmazási feladatot — ki kell listáznunk vagy aktív feladatokat a küldőkkel:
25.01 | Ivanov I.I. | Új algoritmus leírásának előkészítése.
22.01 | Ivanov I.I. | Cikk írása a Habr-ra: élet JOIN nélkül.
20.01 | Petrov P.P. | Segítség a lekérdezés optimalizálásában.
18.01 | Ivanov I.I. | Cikk írása a Habr-ra: JOIN a dátumok eloszlásának figyelembevételével.
16.01 | Petrov P.P. | Segítség a lekérdezés optimalizálásában.
Absztrakt világban a feladatok íróinak egyenletesen kellene eloszlaniuk a szervezet összes munkatársa között, de a valóságban a feladatok általában egy meglehetősen korlátozott számú embertől érkeznek — "a főnökségtől" felfelé a hierarchiában, vagy "a szomszédos bokor" munkatársaitól (elemzők, tervezők, marketing, …).
Tegyük fel, hogy a szervezetünkben 1000 ember közül csak 20 író (általában még kevesebb) ad feladatokat minden egyes konkrét végrehajtónak és , hogy felgyorsítsuk a "hagyományos" lekérdezést.
Script-generátor
-- munkatársak
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- feladatok a megadott eloszlással
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Mutassuk meg az utolsó 100 feladatot egy adott végrehajtónak:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 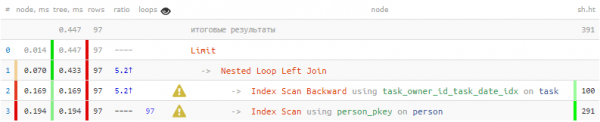
Ezért a 1/3 az egész időből és 3/4 az olvasott adatokból az adatlapok csak azért készültek el, hogy 100 alkalommal keressük meg a szerzőt — minden megjelenített feladathoz. De tudjuk, hogy ebből a százból csak 20 különböző — nem lehetne ezt a tudást kihasználni?
hstore-szótár
Használjuk ki kulcs-érték "szótár" generálásához:
CREATE EXTENSION hstoreA szótárba elegendő lesz beletenni a szerző ID-ját és a nevét, így meg tudjuk majd keresni ezen a kulcson:
-- a célzott kiválasztás kialakítása
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- a szótár kialakítása az egyedi értékekhez
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- a szótár kapcsolt értékeinek lekérdezése
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> key
FROM
T; 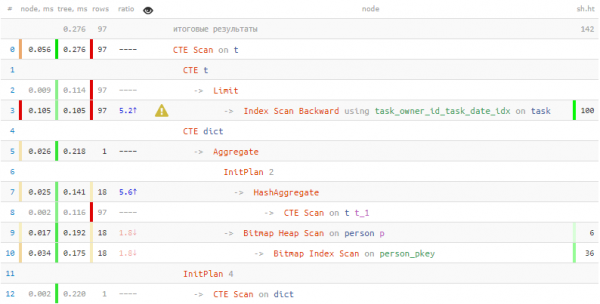
Az információk megszerzése a személyekről két alkalommal kevesebb időt és hét alkalommal kevesebb adatot igényelt! Az "szótárazás" mellett ezeket az eredményeket a tömeges rekordlekérdezés segítségével is elértük egyetlen áthaladás alatt = ANY(ARRAY(...)).
A táblázat bejegyzései: sorozatosítás és desorozás
De mi a teendő, ha nem csak egy szövegmezőt, hanem egy teljes bejegyzést kell megőriznünk a szótárban? Ekkor PostgreSQL képessége segít, hogy a táblázat bejegyzését egy egységes értékként kezeljük:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- mágia #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- mágia #2
FROM
  T;
Nézzük meg, hogy itt tulajdonképpen mi történik:
- Vettük p-t, mint alias a person táblázat teljes bejegyzésére és összegyűjtöttük őket egy tömbbé.
- Ez a tömb a rekordokat átkonvertáltuk szövegsorok tömbjévé (person[]::text[]), hogy elhelyezzük őket egy hstore szótárban értékek tömbjeként.
- Kapcsolt rekord nyerésekor azt kihúztuk a szótárból a kulcs alapján mint szövegsort.
- A szöveget táblázattípusú értékké kell alakítanunk a person (minden táblázathoz automatikusan létrejön ugyanaz a nevű típus).
- A típusú rekordokat „kiterjesztettük” az oszlopokra
(...).*.
json szótár
De az a trükk, amit fent alkalmaztunk, nem működik, ha nincs megfelelő táblázatos típus a „dekódoláshoz”. Ugyanez a helyzet akkor is, ha adatforrásként CTE sort próbálunk használni, nem pedig „valódi” táblát. Ebben az esetben segítenek nekünk.
a json kezelő funkciók :
Meg kell jegyeznünk, hogy a célstruktúra leírásakor nem szükséges minden mezőt felsorolnunk az eredeti sorból, csak azokat, amelyek valóban szükségesek. Ha azonban van „bennszülött” táblánk, akkor jobb, ha a json_populate_record funkciót használjuk..
A szótárhoz való hozzáférés továbbra is egyszeri, de a json-[de]szerializálás költségei eléggé jelentősek, ezért ilyen módon érdemes csak bizonyos esetekben használni, amikor a „civilebb” CTE Scan gyengébben teljesít.
A teljesítmény tesztelése
Tehát két módot kaptunk az adatok szótárba történő szerializálására — hstore / json_object. Ezen kívül magukat a kulcsok és értékek tömbjeit is két módon lehet előállítani, belső vagy külső szöveggé alakítással: array_agg(i::text) / array_agg(i)::text[].
Ellenőrizzük a különféle típusú szerializációk hatékonyságát egy teljesen szintetikus példával — különböző mennyiségű kulcsot szerializálva:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Értékelő script: szerializálás
A T AS (
  KIVÁLASZTÁS
    *
  , (
      KIVÁLASZTÁS
        regexp_replace(ea[array_length(ea, 1)], '^Végrehajtási idő: (d+.d+) ms$', '1')::real et
      BŐVÍTÉS
        (
          KIVÁLASZTÁS
            array_agg(el) ea
          BŐVÍTÉS
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              A SZÓTÁRNÁL (
                KIVÁLASZTÁS
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                BŐVÍTÉS
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TÁBLÁZAT dict
            $$) T(el text)
        ) T
    ) et
  BŐVÍTÉS
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  RENDSZER SZERINT
    1, 2
)
KIVÁLASZTÁS
  v
, avg(et)::numeric(32,3)
BŐVÍTÉS
  T
GROUP BY
  1
RENDSZER SZERINT
1; 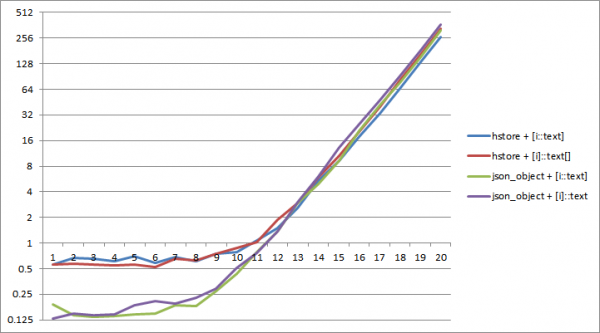
A PostgreSQL 11 körül a szótár méretéig 2^12 kulcsig a json-be való sorosítás kevesebb időt igényel. A legnagyobb hatékonyságot a json_object és az „belső” típuskonverzió kombinációja képviseli array_agg(i::text).
Most próbáljuk meg minden kulcs értékét nyolcszor kiolvasni — hiszen ha a szótárhoz nem nyúlunk, akkor minek van szükség rá?
Értékelő script: olvasás a szótárból
A T AS (
  KIVÁLASZTÁS
    *
  , (
      KIVÁLASZTÁS
        regexp_replace(ea[array_length(ea, 1)], '^Végrehajtási idő: (d+.d+) ms$', '1')::real et
      BŐVÍTÉS
        (
          KIVÁLASZTÁS
            array_agg(el) ea
          BŐVÍTÉS
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              A SZÓTÁRNÁL (
                KIVÁLASZTÁS
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                BŐVÍTÉS
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              KIVÁLASZTÁS
                (TABLE dict) -> (i % ($$ || (1 << v) || $$) + 1)::text
              BŐVÍTÉS
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  BŐVÍTÉS
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  RENDSZER SZERINT
    1, 2
)
KIVÁLASZTÁS
  v
, avg(et)::numeric(32,3)
BŐVÍTÉS
  T
GROUP BY
  1
RENDSZER SZERINT
1; 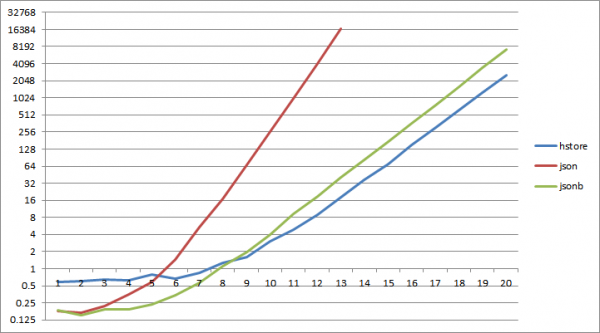
ÉS… már körülbelül 2^6 kulcsnál a json-szótárból való olvasás több mint többszörös hátrányba kerül az hstore-ból való olvasáshoz, a jsonb esetében ugyanez történik 2^9-kor.
Végső következtetések:
- ha szükséges JOIN többször ismétlődő rekordokkal — jobb a táblázat „szótárba helyezése”
- ha a szótár várhatóan kicsi, és keveset olvasol belőle — használhatsz json[b]-t
- minden más esetben hstore + array_agg(i::text) hatékonyabb
Forrás: habr.com
