

Féljünk az operációktól, a bufferektől, amelyek…
Egy kis lekérdezés példáján nézzük meg a PostgreSQL lekérdezések optimalizálásához kapcsolódó általános megközelítéseket. Használni őket vagy sem – az Ön döntése, de érdemes megismerkedni velük.
Néhány későbbi PG verzióban a helyzet megváltozhat a tervező 'intelligenciájának' növekedésével, de a 9.4/9.6-os verziók esetében a helyzet körülbelül ugyanaz, mint itt a példákban.
Veszek egy teljesen valós lekérdezést:
SELECT
  TRUE
FROM
  "Dokumentum" d
INNER JOIN
  "DokumentumKiterjesztés" doc_ex
    USING("@Dokumentum")
INNER JOIN
  "DokumentumTípus" t_doc ON
    t_doc."@DokumentumTípus" = d."DokumentumTípus"
WHERE
  (d."Személy3" = 19091 or d."Munkavállaló" = 19091) AND
  d."$Piszkos" IS NULL AND
  d."Törölt" IS NOT TRUE AND
  doc_ex."Állapot"[1] IS TRUE AND
  t_doc."DokumentumTípus" = 'MunkaTerv'
LIMIT 1;
a táblanevekről és mezőkrőlA "orosz" mező- és táblanevekhez különféleképpen viszonyulhatunk, de ez ízlés kérdése. Mivel nincsenek külföldi fejlesztők, és a PostgreSQL lehetővé teszi, hogy neveket adjon akár írásjelekből is, ha idézőjelbe vannak zárva, ezért megpróbáljuk az objektumokat egyértelműen érthető módon elnevezni, hogy ne legyenek félreértések.
Nézzük meg a kapott tervet:
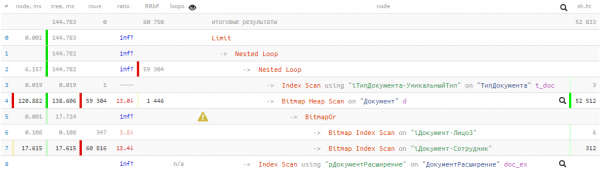
144ms és majdnem 53K buffer — tehát több mint 400MB adat! Szerencsénk van, ha mindez a gyorsítótárban van a lekérdezés időpontjában, különben többszörös időtartamot vehet igénybe, ha diszről kell betölteni.
Az algoritmus a legfontosabb!
Ahhoz, hogy bármilyen lekérdezést optimalizáljunk, először meg kell értenünk, hogy valójában mit is kell tennie.
Ezen cikk keretein kívül hagyjuk az adatbázis struktúrájának fejlesztését, és megegyezünk abban, hogy viszonylag "olcsón" átírhatjuk a lekérdezést és/vagy felrakhatunk az adatbázisra néhány szükséges indexet.
Tehát a lekérdezés:
— ellenőrzi, létezik-e bármilyen dokumentum
— a kívánt állapotban és adott típussal
— ahol a szerző vagy végrehajtó a szükséges munkavállaló
JOIN + LIMIT 1
Elég gyakran a fejlesztőnek könnyebb olyan lekérdezést írni, ahol először sok táblát kapcsol össze, majd a végén egyetlen rekordot hagy meg. De ami a fejlesztőnek könnyebb — nem feltétlenül hatékonyabb az adatbázis számára.
A mi esetünkben mindössze 3 táblánk volt — és milyen hatása volt...
Először is, szabaduljunk meg a "DokumentumTípus" táblával való kapcsolattól, és egyszerre jelezzük az adatbázisnak, hogy a típusú rekord egyedülálló (mi tudjuk ezt, de a tervező még nem sejt):
AZ T-KÉNT (
  KIVÁLASZTÁS
    "@DokumentumTípus"
  BÓL
    "DokumentumTípus"
  HOL
    "DokumentumTípus" = 'MunkaTerv'
  KORLÁTOZÁS 1
)
...
HOL
  d."DokumentumTípus" = (TÁBLÁZAT T)
...
Igen, ha a tábla/CTE egyetlen mezőből áll, egyetlen rekorddal, akkor a PG-ben így is lehet írni, ahelyett
d."DokumentumTípus" = (KIVÁLASZTÁS "@DokumentumTípus" BÓL T KORLÁTOZÁS 1)A PostgreSQL lekérdezések „lusta” számítása
BitmapOr vs UNION
Bizonyos esetekben a Bitmap Heap Scan nagyon drágán fog kijönni nekünk — például a mostani helyzetben, amikor sok rekord megfelel a megkövetelt feltételnek. Ezt kaptuk az OR-feltételből, amely BitmapOr-ra alakult-művelet terve.
Térjünk vissza az eredeti feladathoz — meg kell találni egy rekordot, amely megfelel bármelyik a feltételek közül — tehát nincs szükség arra, hogy az összes 59K rekordot keressük mindkét feltétel szerint. Van mód az első feltétel kezelésére, és a másodikra csak akkor térünk át, ha az elsőnél semmit sem találtunk. Segít nekünk egy ilyen konstrukció:
(
  KIVÁLASZTÁS
    ...
  KORLÁTOZÁS 1
)
UNION ALL
(
  KIVÁLASZTÁS
    ...
  KORLÁTOZÁS 1
)
KORLÁTOZÁS 1
A „külső” KORLÁTOZÁS 1 garantálja, hogy a keresés befejeződik az első rekord megtalálásakor. Ha ez az első blokkban megtalálható, a második végrehajtása nem fog megtörténni (soha nem futtatva a tervben).
A bonyolult feltételek „elrejtése CASE alatt”
Az eredeti lekérdezésben van egy rendkívül kényelmetlen pont — az állapot ellenőrzése a kapcsolt táblán, a „DokumentumKiterjesztés”-en. Függetlenül a többi feltétel igazságától a kifejezésben (például, d."Törölt" NEM IGAZ), ez az összekapcsolás mindig végrehajtásra kerül és „költségekkel jár”. Hogy mennyi erőforrást használunk, az a táblázat méretétől függ.
De módosíthatjuk a lekérdezést úgy, hogy a kapcsolt rekord keresése csak akkor történjen meg, amikor ez valóban szükséges:
KIVÁLASZTÁS
  ...
BÓL
  "Dokumentum" d
HOL
  ...
/*index cond*/ ÉS
  CASE
    HA "$Vázlat" NULL ÉS "Törölt" NEM IGAZ AKKOR (
      KIVÁLASZTÁS
        "Állapot"[1] IGAZ
      BÓL
        "DokumentumKiterjesztés"
      HOL
        "@Dokumentum" = d."@Dokumentum"
    )
  VÉGE
Mivel a kapcsolt táblázatból nekünk nem szükséges egyetlen mező sem a eredményhez, lehetőségünk van a JOIN-t átalakítani egy feltételre egy al-lekérdezésen keresztül.
Hagyjuk az indexelhető mezőket a CASE zárójelein kívül, a szimpla feltételeket az WHEN-blokkon belül – és most a „nehéz” lekérdezés csak a THEN részre való áttéréskor hajtódik végre.
A nevem „Összesen”
Összegyűjtjük az eredmény lekérdezést az összes fent említett mechanikával:
A C T T AS (
  VÁLASZTÁS
    "@DokumentumTípus"
  KÖZBEN
    "DokumentumTípus" = 'Munkaterv'
)
  (
    VÁLASZTÁS
      IGEN
    KÖZBEN
      "Dokumentum" d
    HOL
      ("Személy3", "DokumentumTípus") = (19091, (TÁBLÁZAT T)) ÉS
      ESETBŐL
        AMIKOR "$Vázlat" NULL ÉS "Törölt" NEM IGAZ AKKOR (
          VÁLASZTÁS
            "Állapot"[1] IGAZ
          KÖZBEN
            "DokumentumKiterjesztés"
          HOL
            "@Dokumentum" = d."@Dokumentum"
        )
      VÉGE
    LIMIT 1
  )
UNION ALL
  (
    VÁLASZTÁS
      IGEN
    KÖZBEN
      "Dokumentum" d
    HOL
      ("DokumentumTípus", "Munkatárs") = ((TÁBLÁZAT T), 19091) ÉS
      ESETBŐL
        AMIKOR "$Vázlat" NULL ÉS "Törölt" NEM IGAZ AKKOR (
          VÁLASZTÁS
            "Állapot"[1] IGAZ
          KÖZBEN
            "DokumentumKiterjesztés"
          HOL
            "@Dokumentum" = d."@Dokumentum"
        )
      VÉGE
    LIMIT 1
  )
LIMIT 1;
A mutatók [alkalmazása]
A gyakorlott szemész észrevette, hogy az indexelt feltételek az UNION alblokkjaiban kissé eltérnek - ez azért van, mert már megvannak a megfelelő mutatók a táblán. Ha nem lennének, akkor érdemes lenne létrehozni: Dokumentum(Személy3, DokumentumTípus) és Dokumentum(DokumentumTípus, Munkatárs).
a ROW-feltételek mezőinek sorrendjérőlA tervező szempontjából természetesen írhatjuk is (A, B) = (constA, constB), és a (B, A) = (constB, constA). De amikor a index mezőinek sorrendje szerint, egy ilyen lekérdezést egyszerűbb később hibakeresni.
Mi a helyzet a tervben?
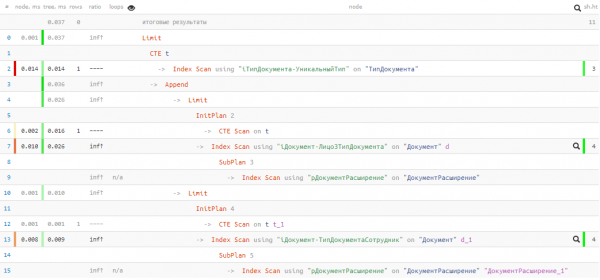
Sajnos nem volt szerencsénk, és az első UNION-blokkból nem találtunk semmit, így a második végül végrehajtásra került. De még így is - összesen 0.037ms és 11 puffer!
Felgyorsítottuk a lekérdezést és drámaian csökkentettük az adatok 'felfúvását' a memóriában több ezer alkalommal, ilyen egyszerű módszereket alkalmazva - nem rossz eredmény a kis másolás után. 🙂
Forrás: habr.com
