

Sokan, akik már használják — szolgáltatásunkat a PostgreSQL tervek vizualizálásához, talán nincsenek tisztában annak egyik szuperképességével — a nehezen olvasható szervernapló részlet...
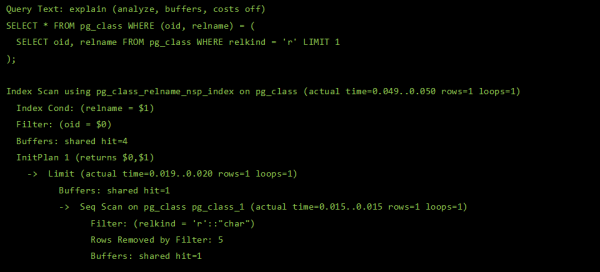
… egy szépen formázott lekérdezéssé konvertálni, amely kontextuális javaslatokat tartalmaz a megfelelő tervcsomópontokról:
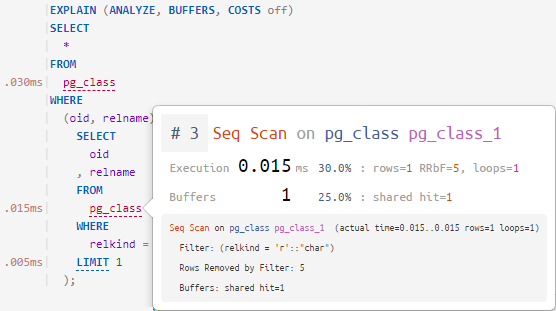
Ebben az előadás második részének elmondom, hogyan sikerült ezt megvalósítanunk.
Az első rész transzkripcióján, amely a lekérdezések teljesítményével kapcsolatos tipikus problémákról és azok megoldásairól szól, a cikkből ismerkedhet meg. .
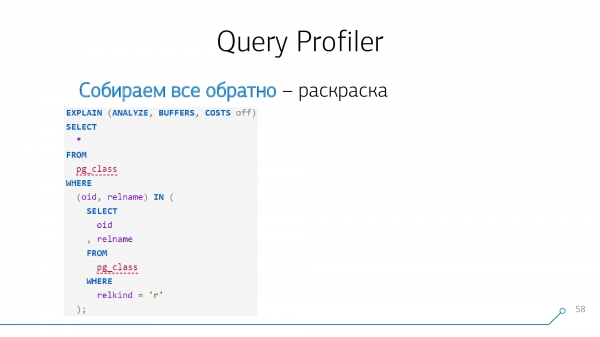
Először foglalkozzunk a színezéssel — és ezúttal nem a tervet fogjuk színezni, azt már színesre festettük, már szépen és érthetően néz ki, hanem a lekérdezést.
Úgy éreztük, hogy így, formázatlan „papírhalomként” a naplóból kiemelt lekérdezés nagyon csúnyán néz ki, és emiatt — kényelmetlen.
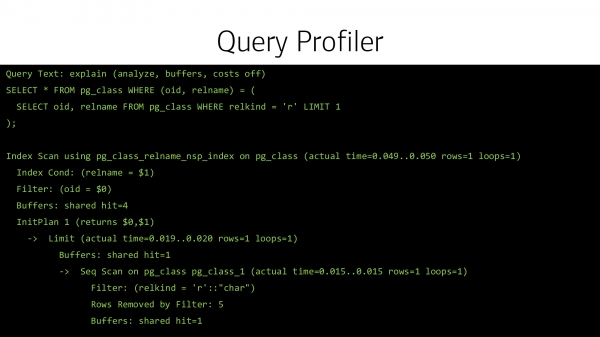
Különösen, amikor a fejlesztők a kódban „ragasztják” a lekérdezés törzsét (ez persze antipattern, de előfordul) egy sorba. Borzalmas!
Rajzoljuk ezt egy kicsit szebben.
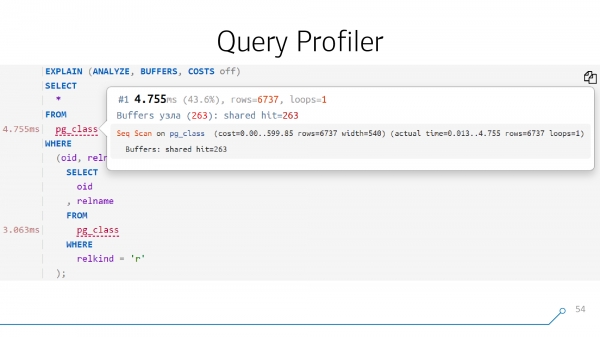
Ha képesek vagyunk ezt szép módon megrajzolni, azaz elemezni és újra összerakni a lekérdezés törzsét, akkor később minden objektumhoz hozzá tudjuk kapcsolni a lekérdezésben áttekinthető javaslatot — mi történt az adott ponton a tervben.
A lekérdezés szintaktikai fája
Ehhez először a lekérdezést kell elemezni.
Mivel a , készítettünk hozzá egy modult, amit . Valójában ez a PostgreSQL parser saját belső működéséhez kapcsolódó kiterjesztett „bindeket” tartalmaz. Tehát egyszerűen csak binárisan lefordított grammatikával és ahhoz kötődő NodeJS oldali bindekkel dolgozunk. Alapul vettünk mások moduljait — itt nincs nagy titok.
A lekérdezés törzsét a funkciónk bemenetére küldjük — a kimenet a JSON-objektum formájában elemzett szintaktikai fa.
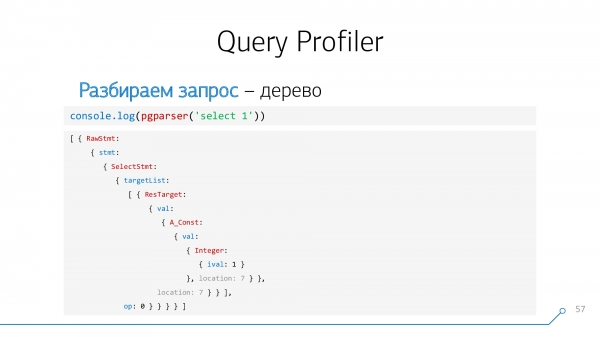
Most már ezen a fán hátrafelé is végigfuthatunk, és összerakhatjuk a lekérdezést a kívánt behúzással, színezéssel, formázással. Nem, ez nem állítható be, de úgy éreztük, hogy pontosan így lenne kényelmes.
A lekérdezés és a terv csomópontjainak összehangolása
Most nézzük meg, hogyan lehet ötvözni a tervet, amelyet az első lépésben elemeztünk, és a lekérdezést, amelyet a második lépésben elemeztünk.
Nézzük meg egy egyszerű példát – van egy lekérdezésünk, amely CTE-t formál és kétszer olvas belőle. Ez így tervez.
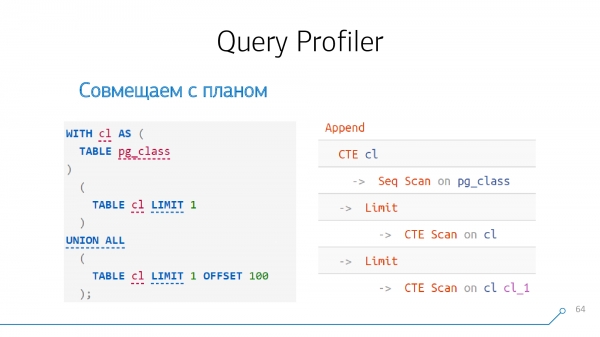
CTE
Ha alaposan megnézzük, hogy a 12. verzió előtt (vagy attól kezdve a kulcsszóval MATERIALIZED) a létrehozás .
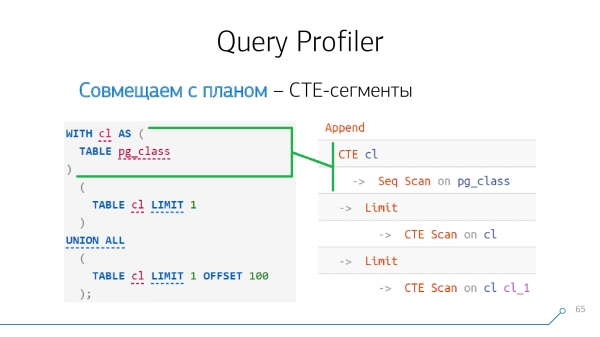
Tehát, ha látunk valahol a lekérdezésben CTE generálást és valahol a tervben egy csomópontot CTE, ezek a csomópontok egyértelműen „ütik” egymást, azonnal össze tudjuk őket vonni.
Feladat „csillaggal”: A CTE-k lehetnek beágyazottak.
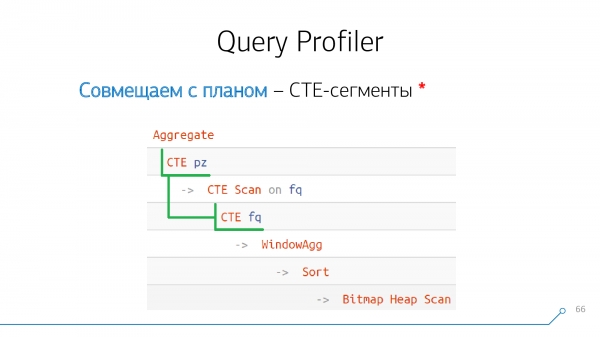
Lehetnek nagyon rosszul beágyazottak, sőt, ugyanaz a nevük is. Például, belül a CTE A létrehozhatsz CTE X, és ugyanazon a szinten belül CTE B újra létrehozhatsz CTE X:
WITH A AS (
  WITH X AS (...)
  SELECT ...
)
, B AS (
  WITH X AS (...)
  SELECT ...
)
...
A megfeleltetéskor meg kell értened ezt. Megérteni ezt „szemmel” – még a tervet is látva, még a lekérdezés törzsét is – nagyon nehéz. Ha a CTE generálás bonyolult, beágyazott, a lekérdezések nagyok – akkor pedig teljesen tudatlan.
UNION
Ha a lekérdezésünkben van egy kulcsszó UNION [ALL] (két eredményhalmaz egyesítési operátora), akkor a tervben vagy egy csomópont felel meg Fűzze hozzá, vagy valamilyen Rekurzív Unió.
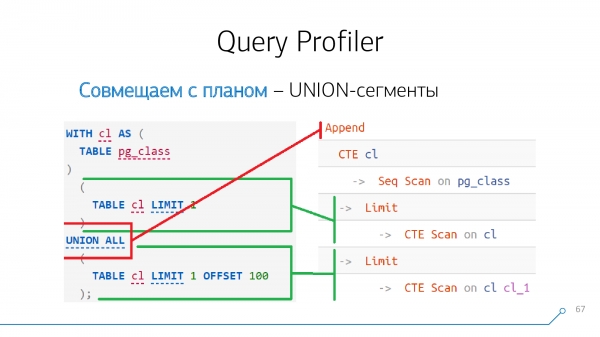
Ami „felül” van a UNION – ez a csomópontunk első gyermeke, ami „alul” – a második. Ha UNION több blokk egyidejűleg „tapaszt” össze Fűzze hozzá- a csomópont mindenképpen csak egy lesz, de gyerekei nem ketten, hanem sokan lesznek – a sorrendben, ahogy jönnek, ennek megfelelően:
  (...) -- #1
UNION ALL
  (...) -- #2
UNION ALL
  (...) -- #3
Append
-> ... #1
-> ... #2
-> ... #3
Feladat „csillaggal”: a rekurzív lekérdezés generálása során (WITH RECURSIVE) is lehet több mint egy UNION. De mindig csak a legutolsó blokk rekurzív a legutolsó UNION. Minden, ami felette van – ez egy, de másik UNION:
WITH RECURSIVE T AS(
  (...) -- #1
UNION ALL
  (...) -- #2, itt befejeződik a rekurzió kezdő állapotának generálása
UNION ALL
  (...) -- #3, csak ez a blokk rekurzív és tartalmazhat hivatkozást T-re
)
...
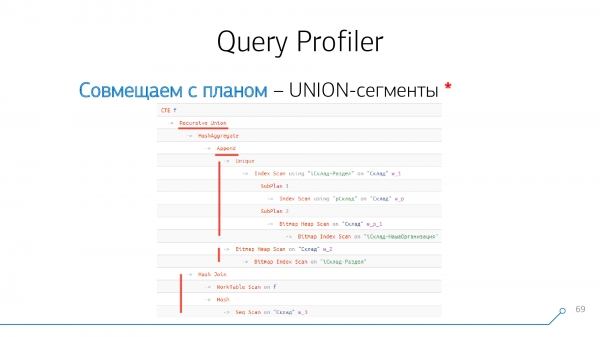
Ilyen példákat is tudni kell „tapasztani”. Ebben a példában azt látjuk, hogy UNION- a szegmensek szám a lekérdezésünkben 3 volt. Ennek megfelelően egy UNION megfelel Fűzze hozzá- csomópont, a másik pedig, Rekurzív Unió.
Olvasási-írási adatok
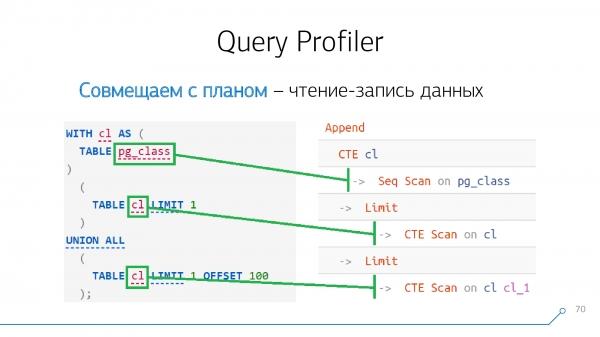
Minden, szétszedtük, most már tudjuk, hogy a lekérdezés melyik darabja melyik tervdarabnak felel meg. És ezekben a darabokban könnyen és lazán megtalálhatjuk azokat az objektumokat, amelyeket „olvasnak”.
A lekérdezés szempontjából nem tudjuk – ez egy tábla vagy CTE, de ugyanazt a csomópontot jelölik. RangeVar. És a terv «olvasva» — ez is egy eléggé korlátozott csomópontok halmaza:
Sekvenciális bejárás a [tbl] táblánBitmap Halomátkeresés a [tbl] táblánIndex [Only] Sun [Hátra] használva [idx] a [tbl]-nCTE Scan a [cte]Beilleszt/Frissítés/Törlés a [tbl] táblán
Tudjuk a terv és a lekérdezés struktúráját, tudjuk a blokkok megfelelését, tudjuk az objektumok neveit — egyértelműen párosítunk.
Ismét a »csillagos« feladat. Átvesszük a lekérdezést, végrehajtjuk, nekünk nincsenek aliasaink — egyszerűen kétszer olvastuk az egy CTE-ből.
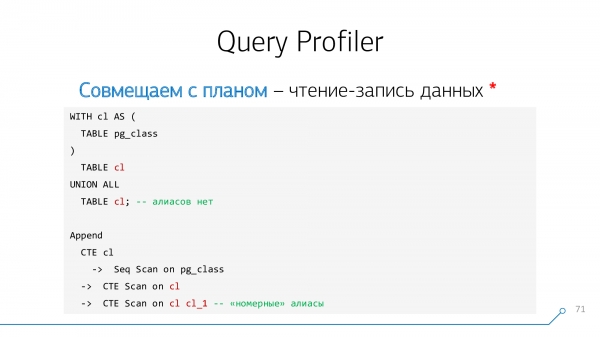
Nézünk a tervbe — mi a gond? Miért bukkant föl az alias? Nem rendreztük. Honnan jött ez a «számozott»?
A PostgreSQL automatikusan hozzáadja. Csak meg kell érteni, hogy ez a fajta alias a számunkra a tervvel való párosítás érdekében semmiféle jelentőséggel nem bír, egyszerűen csak itt van hozzáadva. Ne figyeljünk rá.
Második a »csillagos« feladat: ha tartományozott táblából olvasunk, akkor kapunk egy csomópontot Fűzze hozzá vagy Egyesítés Hozzáfűzés, ami nagy mennyiségű «gyermekből» áll, és mindegyik valamilyen Scana szekciós táblázatból: Sekvenciális bejárás, Bitmap Halomátkeresés vagy Index Scan. De mindenesetre ezek a «gyermekek» nem bonyolult lekérdezések lesznek — így ezeket a csomópontokat lehet megkülönböztetni az Fűzze hozzá alatt UNION.
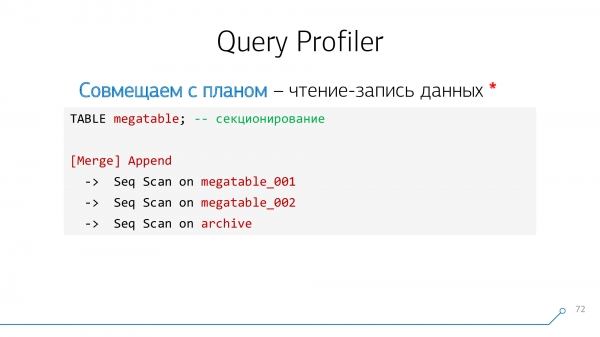
Ilyen csomópontokat is értünk, összegyűjtjük «egy kupacba», és mondjuk: "minden, amit a megatable-ből olvastál — ez itt van és lefelé a fában".
a «normál» adatszerző csomópontok
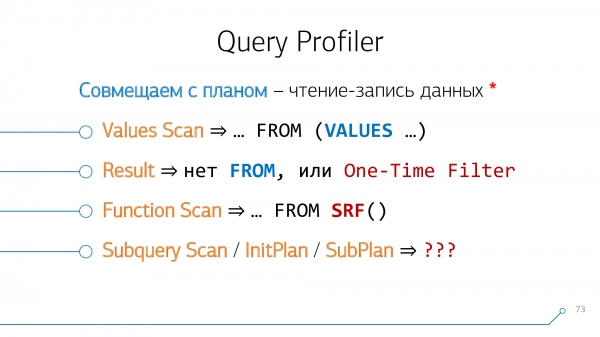
Értékek beolvasása a tervben megfelel VALUES a lekérdezésben.
Eredmény — ez egy lekérdezés nélküli FROM valami SELECT 1. Vagy amikor van egy nyilvánvalóan hamis kifejezés a AHOL-blokkban (akkor keletkezik a 'One-Time Filter' attribútum) One-Time Filter):
EXPLAIN ANALYZE
SELECT * FROM pg_class WHERE FALSE; -- vagy 0 = 1
Eredmény (költség=0.00..0.00 sorok=0 szélesség=230) (valós idő=0.000..0.000 sorok=0 ciklus=1)
One-Time Filter: false
Funkció Vizsgálat a megfelelő SRF-ekre «térképezve».
De a beágyazott lekérdezésekkel sokkal bonyolultabb a helyzet — sajnos nem mindig alakulnak át InitTerv/Alapcsomag. Néha átalakulnak ... Join vagy ... Anti Join, különösen amikor valami ilyesmit írsz, mint WHERE NOT EXISTS .... És ott nem mindig lehetséges az összekapcsolás — a terv szövegében a megfelelő csomópontok operátorai nincsenek.
Ismét a »csillagos« feladat: több VALUES a lekérdezésben. Ebben az esetben a tervben is több csomópontot kapsz Értékek beolvasása.
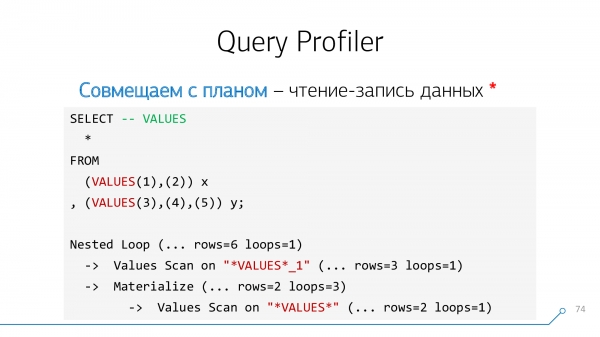
Ezek megkülönböztetésére a «számozott» suffixek segítenek — ez éppen a megfelelő blokkok találásának sorrendjében van hozzáadva, fentről lefelé haladva a lekérdezésben. VALUESÚgy tűnik, mindent elmagyaráztunk a lekérdezésben — csak egy dolog maradt hátra
Adatfeldolgozás
De itt minden egyszerű — az ilyen csomópontok tíz-az-egyhez térképeződnek a megfelelő operátorokra a lekérdezésben, ha ott vannak. Itt nincsenek «csillagok» és bonyodalmak. Limit.
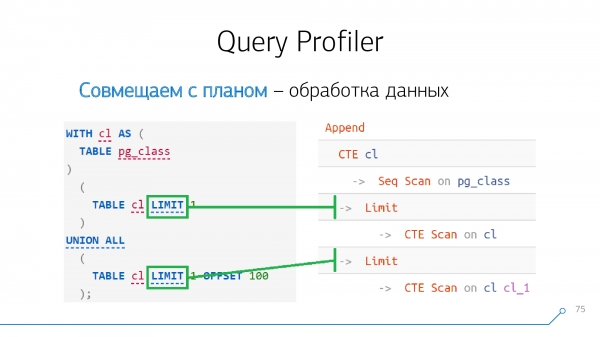
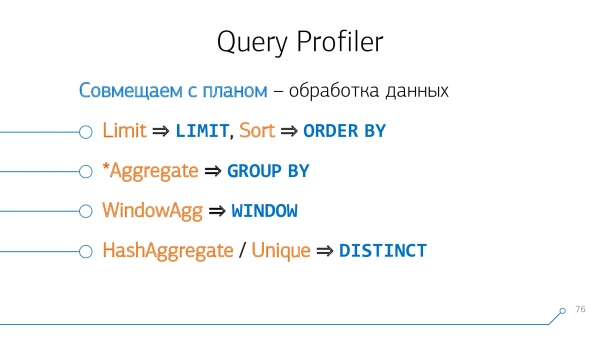
Bonyodalmak akkor merülnek fel, amikor a Limit, Rendezés, Összegyűjt, WindowAgg, Unique párosítani szeretnénk.
JOIN
Ezt nem mindig lehet megtenni, de lehetséges. JOIN между собой. Это сделать не всегда, но можно.
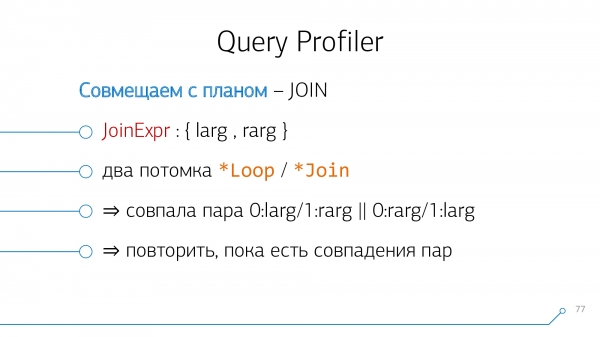
A kérés elemzője szempontjából van egy csomópontunk Csatlakozzon az Expr-hez, amelynek pontosan két gyermeke van - bal és jobb. Ez a, ami „fent” van az Ön JOIN-ján és ami „alatta” van az utasításban.
És a terv szempontjából ez két gyermeke valaminek * Ciklus/* Csatlakozz-csomópont. Beágyazott ciklus, Hash Anti Join,… - valami ilyesmi.
Alkalmazzunk egyszerű logikát: ha van A és B táblánk, amelyek egymással „csatlakoznak” a tervben, akkor az utasításban lehetnek elhelyezve akár A-JOIN-B, vagy B-JOIN-A. Próbáljuk meg így összeilleszteni, próbáljuk meg fordítva, és így tovább, amíg az ilyen párok el nem fogynak.
Nézzük a szintaktikai fáinkat, nézzük a tervünket, vizsgáljuk meg őket... nem hasonlítanak!
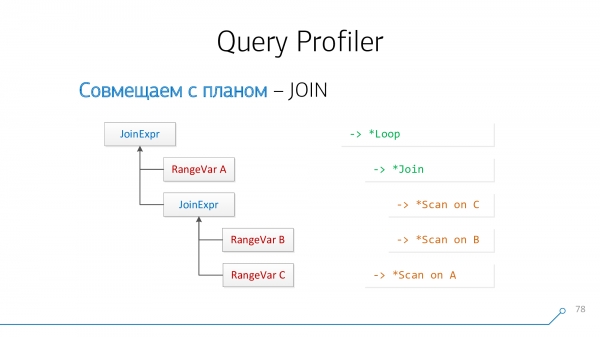
Rajzoljuk újra gráfok formájában - ó, már kezd valami hasonlónak tűnni!
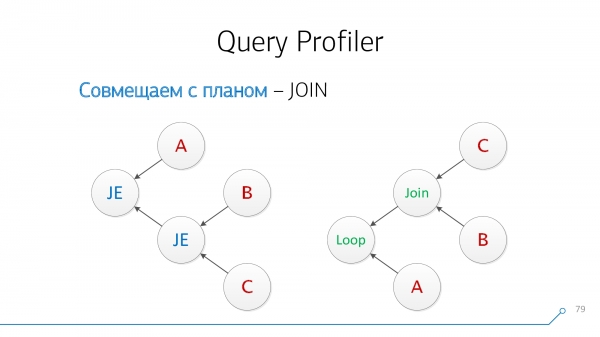
Figyeljünk arra, hogy vannak csomópontjaink, amelyeknek egyszerre B és C gyermekei vannak - mindegy miben a sorrendben. Illesszük össze őket és forgassuk meg a csomópont képet.
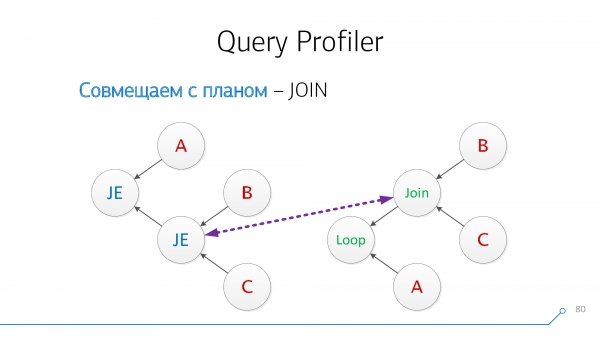
Nézzük meg újra. Most olyan csomópontjaink vannak, amelyeknek gyerekei A és a páros (B + C) - illesszük őket is össze.
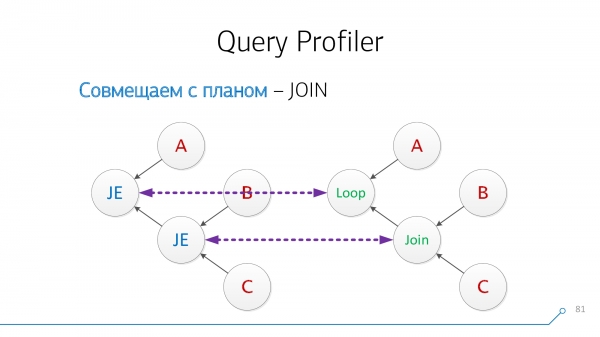
Remek! Így sikeresen összepárosítottuk ezeket a kettőt JOIN a lekérdezésből a terv csomópontjaival.
Sajnos ezt a feladatot nem mindig lehet megoldani.
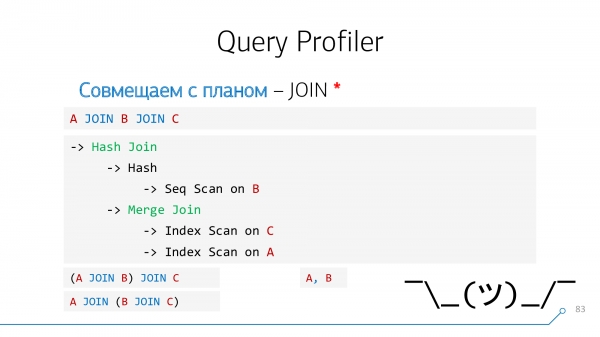
Például, ha a lekérdezésben A JOIN B JOIN C, és a tervben elsőként a „szélső” csomópontok A és C kapcsolódtak össze. Ha a lekérdezésben nincs ilyen operátor, akkor nincs mit kiemelnünk, amire megtanácskozhatnánk. Ugyanez a helyzet a „vesszővel”, amikor Ön ezt írja A, B.
De a legtöbb esetben szinte minden csomópontot sikerül „kibogozni” és egy ilyen jobban megjelenő profilformát készíteni az idő alapján - szó szerint, mint a Google Chrome-ban, amikor JavaScript kódot elemez.
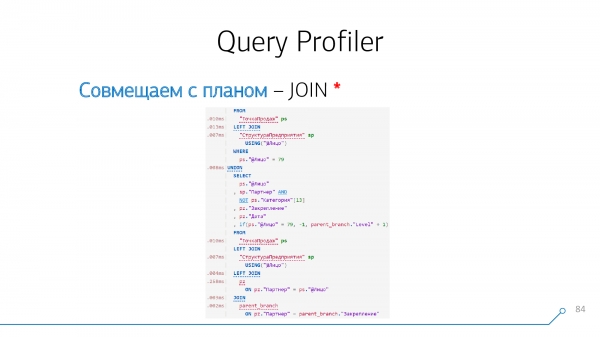
És hogy Önnek minden ezt könnyebben használni, létrehoztunk egy tárolást , ahol elmentheti, majd megtalálhatja terveit az azzal összefüggő lekérdezésekkel együtt, vagy valakivel megoszthatja a hivatkozást.
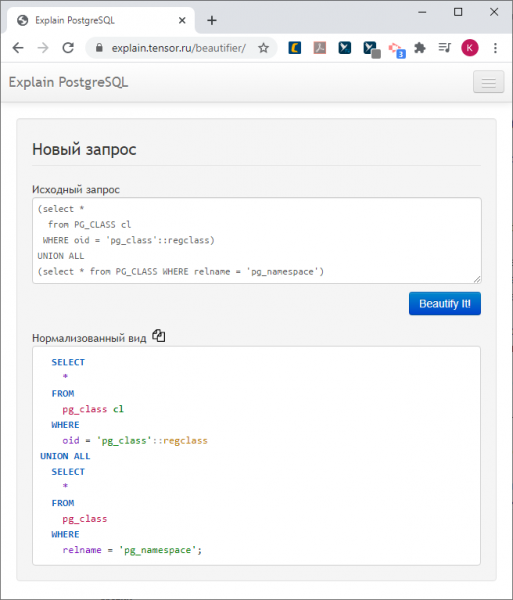
Ha pedig egyszerűen csak egy olvashatatlan lekérdezést kell megfelelő formában hoznía, használja a .
Forrás: habr.com
