

Számos vállalati alkalmazás és virtualizációs rendszer saját mechanizmusokkal rendelkezik a magas rendelkezésre állású megoldások kiépítésére. Különösen az Oracle RAC (Oracle Real Application Cluster) egy vagy több Oracle adatbázis-szerverből álló klasztert jelent, amely együtt dolgozik a terhelés kiegyensúlyozása és a magas rendelkezésre állás biztosítása érdekében a szerver/alkalmazás szinten. Az ilyen üzemmód működéséhez közös tárolóra van szükség, amelyet általában egy tároló rendszer lát el.
Ahogy azt már korábban is tárgyaltuk , maga a tároló rendszer, annak ellenére, hogy van benne redundáns komponens (többek között vezérlők), mégis rendelkezik hibapontokkal – elsősorban egyetlen adatgyűjtemény formájában. Ezért a megbízhatóság iránti magasabb követelményekkel rendelkező Oracle megoldás kiépítéséhez a „N szerver – egy tároló rendszer” sémát tovább kell bonyolítani.
Először is, természetesen meg kell határoznunk, milyen kockázatoktól próbálunk védekezni. Jelen cikk keretein belül nem foglalkozunk a „meteor érkezik” típusú fenyegetések elleni védelemmel. Így a földrajzilag elosztott katasztrófa-helyreállítási megoldások kiépítése a következő cikkek egyike lesz. Itt a Cross-Rack katasztrófa-helyreállítási megoldást fogjuk vizsgálni, amely a szerver szekrények szintjén biztosít védelmet. A szekrények lehetnek egy helyiségben vagy különbözőben, de általában egy épületen belül találhatóak.
Ezeknek a szekrényeknek tartalmazniuk kell a szükséges hardver- és szoftverkészletet, amely lehetővé teszi az Oracle adatbázisok működését a „szomszéd” állapotától függetlenül. Más szóval, a Cross-Rack katasztrófa-helyreállítási megoldás révén kiiktatjuk a következő hibák kockázatait:
- Oracle alkalmazás szerverek
- Tároló rendszerek
- Kommunkációs rendszerek
- Teljes berendezés leállása a szekrényben:
- Áramellátási hiba
- Hűtőrendszer hiba
- Külső tényezők (ember, természet stb.)
Az Oracle szerverek duplázása magában foglalja az Oracle RAC működési elvét, és alkalmazás révén valósul meg. A kommunikációs eszközök duplázása sem jelent problémát. A tároló rendszer duplázása viszont már nem olyan egyszerű.
A legutolsó k варианат a legkönnyebb módja az adatok másolásának a fő tárolóból a tartalék tárolóra. Szinkronizált vagy aszinkron, a tároló lehetőségeitől függően. Aszinkron másolás esetén felmerül az adatok konzisztenciájának biztosítása az Oracle-hoz képest. De még ha programozott integráció is van az alkalmazással, egy esetleges fő tárolói meghibásodáskor adminisztrátorok manuális beavatkozására is szükség lesz, hogy a klasztert a tartalék tárolóra irányítsák.
Egy bonyolultabb megoldás a szoftveres és/vagy hardveres tároló „virtualizátorok”, amelyek megoldják a konzisztencia és a manuális beavatkozás problémáját. De a telepítés és a későbbi adminisztráció bonyolultsága, valamint az ilyen megoldások igencsak magas költsége sokakat elriaszt.
Az All Flash tömb, az AccelStor NeoSapphire™, kifejezetten ilyen forgatókönyvekhez, mint a Cross-Rack katasztrófa helyreállítás, tökéletes megoldás. a Shared-Nothing architektúra segítségével. Ez a modell egy kétnódusú tárolórendszer, amely saját FlexiRemap® technológiáját használja a flash tárolók kezelésére. Ennek köszönhetően A NeoSapphire™ H710 képes akár 600K IOPS@4K véletlenszerű írási teljesítményre és 1M+ IOPS@4K véletlenszerű olvasási teljesítményre, ami klasszikus RAID-alapú tárolók használatakor nem elérhető.
De a NeoSapphire™ H710 legfontosabb jellemzője, hogy a két nodo külön házakban található, mindkettő saját adatmásolatával rendelkezik. A nodok szinkronizálása külső InfiniBand interfészen keresztül történik. Ilyen architektúra révén a nodok különböző helyszínekre is elhelyezhetők, akár 100 méteres távolságra, ezzel biztosítva a Cross-Rack katasztrófa helyreállítást. Mindkét nodo teljesen szinkron üzemmódban működik. A H710 a hosztok felől mint egy hagyományos két vezérlős tárolónak tűnik. Így nem szükséges további szoftveres és hardveres opciókat implementálni, valamint különösen bonyolult beállításokat végezni.
Ha összehasonlítjuk az összes fent említett Cross-Rack katasztrófa helyreállító megoldást, az AccelStor opciója jelentősen kiemelkedik a többi közül:
AccelStor NeoSapphire™ Shared Nothing Architecture
Szoftveres vagy hardveres tároló virtualizátor
Replicáció alapú megoldás
Elérhetőség
Szerver leállás
Nincs állásidő
Nincs állásidő
Nincs állásidő
Switch leállás
Nincs állásidő
Nincs állásidő
Nincs állásidő
Tárolórendszer leállás
Nincs állásidő
Nincs állásidő
Állásidő
Teljes szekrény leállás
Nincs állásidő
Nincs állásidő
Állásidő
Költség és bonyolultság
A megoldás költsége
Alacsony*
Magas
Magas
Telepítés bonyolultsága
Alacsony
Magas
Magas
*AccelStor NeoSapphire™ – ez egy All Flash tömb, amely definíció szerint nem kerül „3 fillérbe”, főleg, hogy kétszeres kapacitással rendelkezik. Azonban, ha a megoldás összköltségét más hasonló gyártókétól összehasonlítjuk, az ár alacsonynak tekinthető.
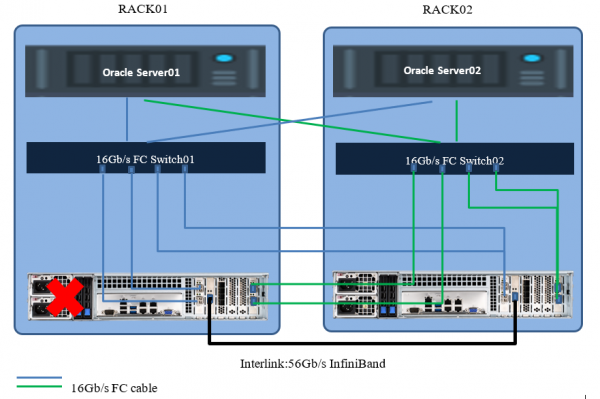
Az alkalmazásszerverek és az All Flash tömb csomópontjainak csatlakozási topológiája a következőképpen fog kinézni:
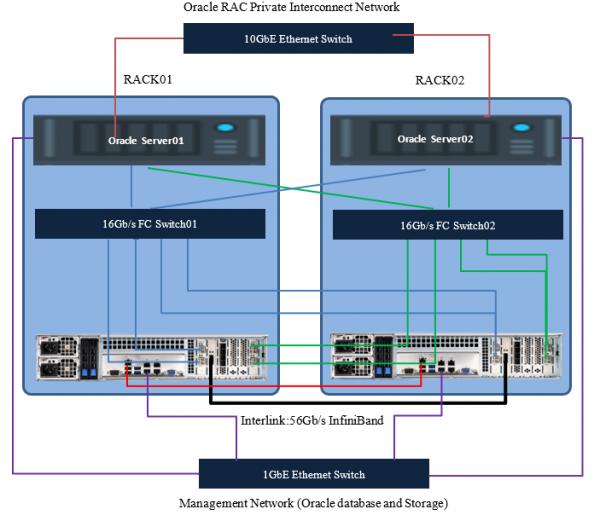
A topológia tervezésekor rendkívül ajánlott a vezérlő- és a szerverek közötti kapcsolók duplikálása is.
Itt és a továbbiakban a Fibre Channel csatlakozásról lesz szó. iSCSI használata esetén minden ugyanaz lesz, figyelembe véve a használt kapcsolótípusokat és az eltérő tömbbeállításokat.
Előkészítő munka a tömbön
Használt hardver és szoftver
Szerverek és kapcsolók specifikációi
Összetevők
Leírás
Oracle Database 11g szerverek
Kettő
Szerver operációs rendszer
Oracle Linux
Oracle adatbázis verzió
11g (RAC)
Processzorok száma szerveren
Kettő 16 magos Intel® Xeon® CPU E5-2667 v2 @ 3.30GHz
Fizikai memória szerverenként
128GB
FC hálózat
16Gb/s FC több úton
FC HBA
Emulex Lpe-16002B
Dedikált nyilvános 1GbE portok a klaszterkezeléshez
Intel ethernet adapter RJ45
16Gb/s FC switch
Brocade 6505
Dedikált privát 10GbE portok az adat-szinkronizációhoz
Intel X520
AccelStor NeoSapphire™ All Flash tömb specifikációja
Összetevők
Leírás
Tárhelyrendszer
NeoSapphire™ nagy rendelkezésre állású modell: H710
Kép verzió
4.0.1
Meghajtók teljes száma
48
Meghajtó mérete
1.92TB
Meghajtó típusa
SSD
FC célportok
16 x 16Gb port (8 a csomópontonként)
Kezelő portok
Az 1GbE ethernet kábel, amely a gazdákhoz csatlakozik az ethernet switchen keresztül
Szívverés port
Az 1GbE ethernet kábel, amely két tárolócsomópont között csatlakozik
Adatszinkronizálási port
56Gb/s InfiniBand kábel
A tömb használatba vétele előtt inicializálni kell. Alapértelmezés szerint mindkét csomópont kezelőcíme azonos (192.168.1.1). Először csatlakozni kell hozzájuk, és új (már különböző) kezelő címeket beállítani, valamint szinkronizálni az időt, majd a Kezelő portokat egy közös hálózatra csatlakoztathatjuk. Ezt követően a csomópontokat HA párra kell összevonni az Interlink csatlakozások számára kiosztott alhálózatokkal.
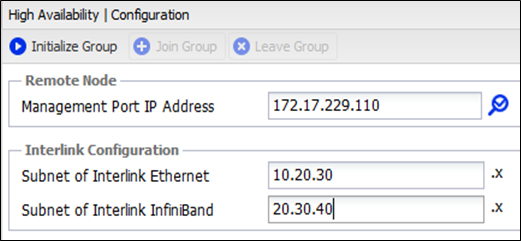
Az inicializálás befejezése után bármely csomópontból kezelhetjük a tömböt.
Ezután létrehozzuk a szükséges köteteket, és közzétesszük őket az alkalmazásszerverek számára.
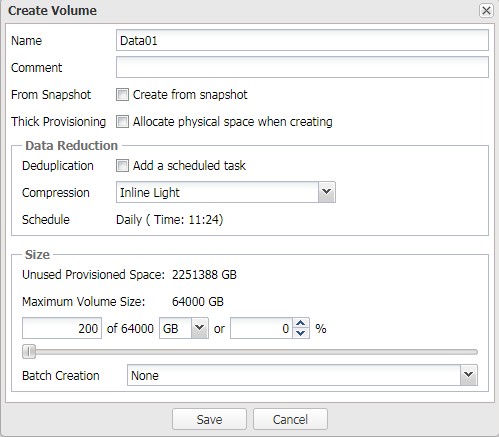
Határozottan ajánlott több kötetet létrehozni az Oracle ASM számára, mivel ez növeli a célok számát a szerverek számára, ami végső soron javítja az általános teljesítményt (több információ a várakozásokról egy másik. ).
Teszt konfiguráció
Tárhely kötet neve
Kötet mérete
Data01
200GB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Néhány magyarázat a tömb működési módjairól és az előforduló folyamatokról rendellenes helyzetekben
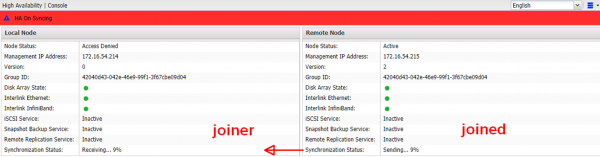
Minden csomópont adatainak egy paramétere van: a "verziószám". Az elsődleges inicializálás után ez azonos és 1-re állítódik. Ha valamilyen okból a verziószám eltérő, akkor mindig a magasabb verzió adatainak szinkronizálása történik az alacsonyabb verzió felé, ezután az alacsonyabb verzió száma igazodik, vagyis ez azt jelenti, hogy a példányok azonosak. Az okok, amelyek miatt a verziók eltérhetnek:
- Egyik csomópont tervezett újraindítása
- Egyik csomópont meghibásodása hirtelen áramszünet miatt (tápellátás, túlmelegedés stb.).
- InfiniBand kapcsolat megszakadása szinkronizálási lehetőség nélkül
- Egyik csomópont meghibásodása adatkárosodás miatt. Itt már egy új HA csoport létrehozására és a teljes adatcsomag szinkronizálására van szükség.
Minden esetben az online állapotban lévő csomópont növeli a verziószámát egy egységgel, hogy a pár kapcsolatánek helyreállítása után szinkronizálja az adatcsomagját.
Ha az Ethernet kapcsolaton megszakítás történik, a Heartbeat ideiglenesen az InfiniBand-ra vált, és 10 másodpercen belül visszatér az eredeti állapotába annak helyreállítása után.
Gazdagépek beállítása
A hibatűrés és a teljesítmény növelése érdekében be kell kapcsolni az MPIO támogatást a tömb számára. Ehhez a /etc/multipath.conf fájlba kell beilleszteni a sorokat, majd újra kell indítani a multipath szolgáltatást.
Rejtett szövegdevices {
device {
vendor «AStor»
path_grouping_policy «group_by_prio»
path_selector «queue-length 0»
path_checker «tur»
features «0»
hardware_handler «0»
prio «const»
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
A következő lépés ahhoz, hogy az ASM működjön az MPIO-n keresztül az ASMLib-en, módosítani kell a /etc/sysconfig/oracleasm fájlt, majd végre kell hajtani a /etc/init.d/oracleasm scandisks parancsot.
Rejtett szöveg
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER=«dm»
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE=«sd»
Megjegyzés
Ha nem kívánja használni az ASMLib-t, használhat UDEV szabályokat, amelyek az ASMLib alapját képezik.
A 12.1.0.2 verziótól kezdve az Oracle Database opció elérhető az ASMFD szoftver részeként.
Kötelező meggyőződni arról, hogy az Oracle ASM-hez létrehozott lemezek a tömb által fizikailag használt blokk méretéhez (4K) viszonyítva ki vannak igazítva. Ellenkező esetben teljesítményproblémák léphetnek fel. Ezért a megfelelő paraméterekkel rendelkező kötetek létrehozása szükséges:
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Az adatbázisok elosztása a létrehozott kötetekre a teszt konfigurációnkhoz
Tárhely kötet neve
Kötet mérete
Kötet LUN-ok térképezése
ASM kötet eszköz részletei
Allocációs egység mérete
Data01
200GB
Térképezze fel az összes tároló kötetet a tárolási rendszer összes adatportjával
Hibatűrés: Normál
Név: DGDATA
Cél: Adatfájlok
4MB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Hibatűrés: Normál
Név: DGGRID1
Cél: Rács: CRS és szavazás
4MB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Hibatűrés: Normál
Név: DGGRID2
Cél: Rács: CRS és szavazás
4MB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Hibatűrés: Normál
Név: DGREDO1
Cél: 1. szál redo naplója
4MB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Hibatűrés: Normál
Név: DGREDO2
Cél: 2. szál redo naplója
4MB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Adatbázis beállítások
- Blokk mérete = 8K
- Cserehely = 16GB
- Automatikus memória kezelés (AMM) letiltása
- Átlátszó hatalmas oldalak letiltása
Egyéb beállítások
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness=10
✓ vm.min_free_kbytes=524288 # ne állítsa be, ha Linux x86-ot használ
✓ vm.vfs_cache_pressure=200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus "\/as sysdba"
alter system set processes=2000 scope=spfile;
alter system set open_cursors=2000 scope=spfile;
alter system set session_cached_cursors=300 scope=spfile;
alter system set db_files=8192 scope=spfile;
Megbízhatósági teszt
A bemutató céljából a HammerDB-t használták az OLTP terhelés emulálására. A HammerDB konfigurációja:
Raktárak száma
256
Összes tranzakció felhasználónként
1000000000000
Virtuális felhasználók
256
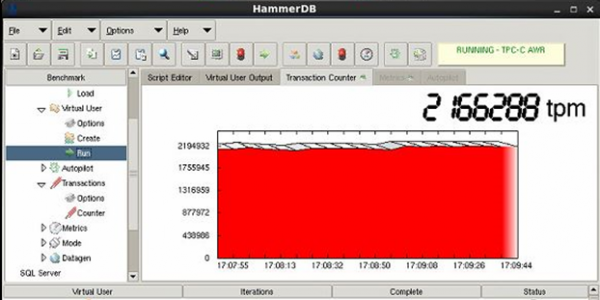
Ennek eredményeként 2,1M TPM értéket kaptunk, ami messze van a tömb teljesítményének határától , de ez a "küszöb" a jelenlegi kiszolgáló konfiguráció számára (elsősorban a processzorok és számuk miatt). Ennek a tesztnek a célja mégis a megoldás megbízhatóságának bemutatása, és nem a teljesítmény maximumának elérése. Ezért egyszerűen ezt a számot fogjuk alapként venni.
Egy csomópont leállásának tesztje
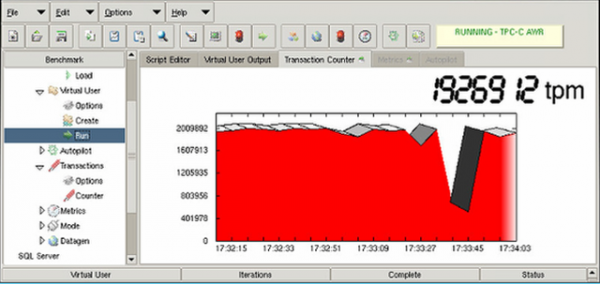
A hosztok elveszítették a tárolóra vezető egyes útvonalakat, de továbbra is működtek a második csomóponttal megmaradtak. A teljesítmény néhány másodpercre csökkent az útvonalak átrendeződése miatt, majd visszatért a normál értékekhez. Szolgáltatáskimaradás nem történt.
A szekrény teljes berendezésének leállásának tesztje
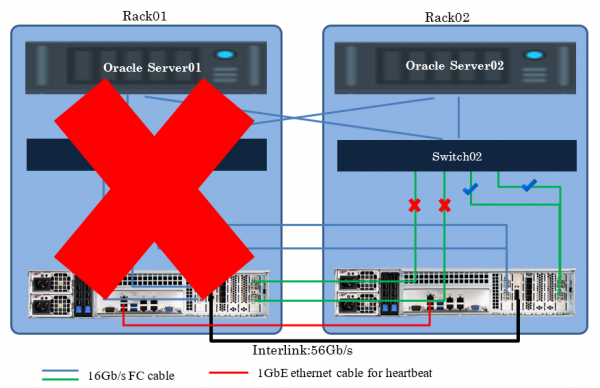
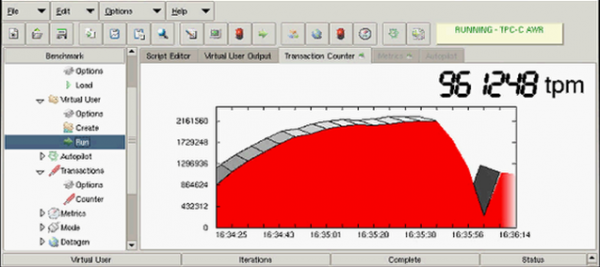
Ebben az esetben a teljesítmény szintén néhány másodpercre csökkent az útvonalak átrendeződése miatt, majd visszatért az eredeti érték felére. Az eredmény megfeleződött egy alkalmazásszerver inaktívvá válása miatt. Szolgáltatáskimaradás szintén nem történt.
Ha a Cross-Rack katasztrófa-helyreállítási megoldás megvalósítására van szükség Oracle számára, ésszerű áron és minimális telepítési/adminisztrációs erőfeszítéssel, akkor az Oracle RAC és az architektúra együttműködése lesz az egyik legjobb lehetőség. Ez helyettesítheti az Oracle RAC-ot bármilyen más szoftverrel, amely klaszterezést biztosít, ugyanazokkal az adatbázis-kezelő rendszerekkel vagy virtualizációs rendszerekkel például. A megoldás felépítési elve változatlan marad. És a végső mutató – a nullás érték az RTO és RPO esetében.
Forrás: habr.com
