

Bevezetés
Egy új rendszer kiépítése során szembesültünk azzal a szükségszerűséggel, hogy nagy mennyiségű különböző naplót kell feldolgoznunk. Eszközként az ELK-t választottuk. Ebben a cikkben a stack konfigurálásával kapcsolatos tapasztalatainkról lesz szó.
Nem célunk az összes lehetőség leírása, de szeretnénk a gyakorlati problémák megoldására összpontosítani. Ezt az indokolja, hogy a dokumentáció és az előre elkészített képek nagy mennyisége mellett számos buktatóval találkoztunk, legalábbis nálunk így alakult.
A stack-et docker-compose segítségével állítottuk fel. Továbbá, volt egy jól megírt docker-compose.yml fájlunk, amely lehetővé tette számunkra, hogy szinte problémamentesen építsük fel a stack-et. Azt hittük, hogy a győzelem már közel van, most egy kicsit finomítunk a saját igényeink szerint, és minden rendben lesz.
Sajnos, a rendszer finomhangolása a naplók fogadására és feldolgozására az alkalmazásunkból nem volt azonnal sikeres. Ezért úgy döntöttünk, hogy először minden komponenst külön-külön tanulmányozunk, majd térünk vissza a kapcsolatokra.
Tehát a logstash-szal kezdtük.
Környezet, telepítés, a Logstash futtatása egy konténerben
A telepítéshez docker-compose-t használunk, a következő kísérletek MacOS-en és Ubuntu 18.0.4-en zajlottak.
A logstash kép, amelyet a kiindulási docker-compose.yml fájlunkban meghatároztunk, a docker.elastic.co/logstash/logstash:6.3.2
Ezt használjuk kísérleteink során.
A logstash futtatásához egy külön docker-compose.yml fájlt írtunk. Természetesen indíthattuk volna a képet a parancssorból is, de mi konkrét feladatot oldottunk meg, ahol minden docker-compose-ból fut.
Röviden a konfigurációs fájlokról
Ahogy a leírásból kiderül, a logstash-t lehet futtatni egyetlen csatornára, ekkor egy *.conf fájlt kell átadni, vagy több csatornára, ekkor a pipelines.yml fájlt kell átadni, amely viszont a .conf fájlokra hivatkozik minden csatornához.
A második utat választottuk. Számunkra ez tűnt univerzálisabbnak és skálázhatónak. Ezért létrehoztunk egy pipelines.yml fájlt, és készítettünk egy pipelines könyvtárat, amelybe a .conf fájlokat helyezzük el minden csatornához.
A konténeren belül van egy másik konfigurációs fájl is — a logstash.yml. Ezt nem érintjük, így használjuk, ahogy van.
Tehát a könyvtáraink struktúrája:
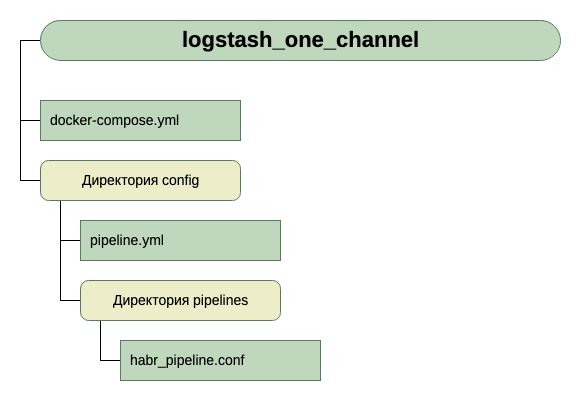
A bemeneti adatok beszerzése érdekében azt egyelőre tcp-n keresztül, a 5046-os porton fogadjuk, a kimenethez pedig a stdout-ot fogjuk használni.
Ez egy egyszerű konfiguráció az első indításhoz. Mivel az alapfeladat az, hogy elinduljon.
Tehát itt van egy docker-compose.yml fájlunk.
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      	- elk
    ports:
      	- 5046:5046
    volumes:
      	- ./${client_name}/config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
	- ./${client_name}/config/pipelines:/usr/share/logstash/config/pipelines:ro
Mit látunk itt?
- A networks és volumes az eredeti docker-compose.yml-ból származik (amelyben az egész stack elindul), és azt hiszem, hogy nem befolyásolják jelentősen az általános képet.
- Létrehozunk egy szolgáltatást (services) logstash néven, a docker.elastic.co/logstash/logstash:6.3.2 képből, és elnevezzük logstash_one_channel-nak.
- A 5046-os portot továbbítjuk a konténerbe, egy azonos belső portra.
- A ./${client_name}/config/pipelines.yml konfigurációs fájlt a /usr/share/logstash/config/pipelines.yml fájlra térképezzük a konténeren belül, ahonnan a logstash be fogja olvasni, és csináljuk read-only-nak, csak a biztonság kedvéért.
- A ./${client_name}/config/pipelines mappát, ahol a csatorna beállítások fájljai találhatóak, a /usr/share/logstash/config/pipelines mappába is átirányítjuk, és azt is read-only-ra állítjuk.
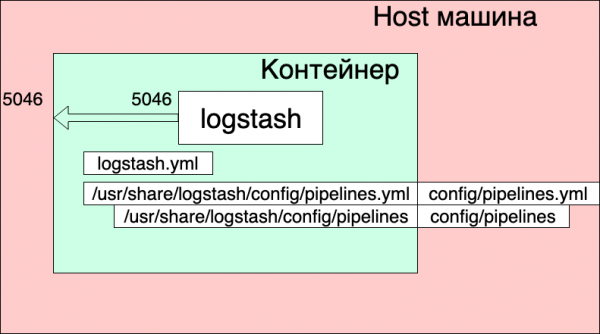
A pipelines.yml fájl.
- pipeline.id: HABR
  pipeline.workers: 1
  pipeline.batch.size: 1
  path.config: ".//config/pipelines/habr_pipeline.conf"
Itt egy csatorna van leírva, amelynek azonosítója HABR és a konfigurációs fájljának elérési útja.
És végül a fájl, "./config/pipelines/habr_pipeline.conf"
input {
  tcp {
    port => "5046"
   }
  }
filter {
  mutate {
    add_field => [ "habra_field", "Hello Habr" ]
    }
  }
output {
  stdout {

    }
  }
Most nem részletezzük, próbáljuk meg elindítani:
docker-compose up
Mit látunk?
A konténer elindult. Ellenőrizhetjük a működését:
echo '13123123123123123123123213123213' | nc localhost 5046
És a konténer konzolján ezt látjuk válaszként:
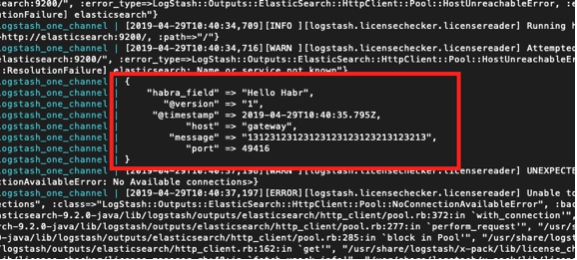
De látunk továbbá ezt is:
logstash_one_channel | [2019-04-29T11:28:59,790][ERROR][logstash.licensechecker.licensereader] Nem sikerült a licenc információt lekérdezni a licenc szerverről {:message=>'"Elasticsearch elérhetetlen: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch', …
logstash_one_channel | [2019-04-29T11:28:59,894][INFO ][logstash.pipeline ] A pipeline sikeresen elindult {:pipeline_id=>'".monitoring-logstash", :thread=>'"#'}
logstash_one_channel | [2019-04-29T11:29:00,015][ERROR][logstash.inputs.metrics ] Az X-Pack telepítve van a Logstash-ra, de az Elasticsearch-ra nem. Kérjük telepítse az X-Pack-ot az Elasticsearch-ra a monitoring funkció használatához. Más funkciók is elérhetők lehetnek.
logstash_one_channel | [2019-04-29T11:29:00,526][INFO ][logstash.agent ] Sikeresen elindította a Logstash API végpontot {:port=>9600}
logstash_one_channel | [2019-04-29T11:29:00,526][INFO ][logstash.agent ] A Logstash API végpont sikeresen elindult {:port=>9600}
logstash_one_channel | [2019-04-29T11:29:04,478][INFO ][logstash.outputs.elasticsearch] Eg健康检查,用于查看Elasticsearch连接是否正常 {:healthcheck_url=http://elasticsearch:9200/, :path="/"}
logstash_one_channel | [2019-04-29T11:29:04,487][WARN ][logstash.outputs.elasticsearch] 尝试恢复与死掉的ES实例的连接,但出现错误. {:url=«:9200/», :error_type=LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=«Elasticsearch Unreachable: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch»}
logstash_one_channel | [2019-04-29T11:29:04,704][INFO ][logstash.licensechecker.licensereader] Eg健康检查,用于查看Elasticsearch连接是否正常 {:healthcheck_url=http://elasticsearch:9200/, :path="/"}
logstash_one_channel | [2019-04-29T11:29:04,710][WARN ][logstash.licensechecker.licensereader] 尝试恢复与死掉的ES实例的连接,但出现错误. {:url=«:9200/», :error_type=LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=«Elasticsearch Unreachable: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch»}
És a napló folyamatosan felfelé halad.
Itt zöld színnel kiemeltem azt az üzenetet, hogy a pipeline sikeresen elindult, pirossal az eseményhibát és sárgával az üzenetet, ami megpróbál kapcsolatba lépni :9200.
Ez azért van, mert a logstash.conf fájlban, amit az image tartalmaz, van egy elérhetőségi ellenőrzés az elasticsearch-ra. A logstash azt feltételezi, hogy az Elk stack-en belül működik, mi viszont leválasztottuk.
Működni lehet, de nem kényelmes.
A megoldás az, hogy letiltjuk ezt a ellenőrzést az XPACK_MONITORING_ENABLED környezeti változóval.
Változtassunk a docker-compose.yml fájlon, és indítsuk el újra:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
Most már minden rendben van. A konténer készen áll a kísérletezésre.
Újra beírhatjuk a szomszédos terminálba:
echo '13123123123123123123123213123213' | nc localhost 5046
És láthatjuk:
logstash_one_channel | {
logstash_one_channel |         "message" => "13123123123123123123123213123213",
logstash_one_channel |      "@timestamp" => 2019-04-29T11:43:44.582Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |     "habra_field" => "Helló Habr",
logstash_one_channel |            "host" => "gateway",
logstash_one_channel |            "port" => 49418
logstash_one_channel | }
Működés egy csatornán belül
Tehát, elindultunk. Most már ráérünk, hogy közvetlenül a logstash beállításának szenteljünk időt. Egyelőre ne nyúljunk a pipelines.yml fájlhoz, nézzük meg, mit érhetünk el, ha csak egy csatornával dolgozunk.
Meg kell jegyezni, hogy a csatorna konfigurációs fájllal való munka általános elvét jól leírja a hivatalos útmutató, itt van
Ha oroszul szeretnél olvasni, akkor ezt használtuk (de a lekérdezési szintaxis ott régi, ezt figyelembe kell venni).
Lépjünk végig lépésről lépésre az Input szekciótól. A tcp munkáját már láttuk. Mi más lehet itt érdekes?
Tesztüzenetek a heartbeat segítségével
Van egy érdekes lehetőség automatikus tesztüzenetek generálására.
Ehhez az input szekcióba be kell kapcsolni a heartbean plugint.
input {
  heartbeat {
    message => "HeartBeat!"
   }
  }
Bekapcsoljuk, és elkezdünk kapni üzeneteket percenként
logstash_one_channel | {
logstash_one_channel |      "@timestamp" => 2019-04-29T13:52:04.567Z,
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "HeartBeat!",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "host" => "a0667e5c57ec"
logstash_one_channel | }
Gyakrabban szeretnénk kapni, ezért hozzá kell adnunk egy interval paramétert.
Így 10 másodpercenként fogunk üzenetet kapni.
input {
  heartbeat {
    message => "HeartBeat!"
    interval => 10
   }
  }
Adatok beszerzése fájlból
Megnézzük a file üzemmódot is. Ha a fájllal normálisan működik, talán nem is lesz szükség ügynökre, legalábbis a helyi használathoz.
A leírás szerint a működési módnak hasonlónak kell lennie a tail -f-hez, tehát új sorokat olvas, vagy, mint opció, olvassa az egész fájlt.
Tehát, mit akarunk elérni:
- Olyan sorokat akarunk kapni, amelyek egy naplófájlba kerülnek.
- Olyan adatokat akarunk kapni, amelyek több naplófájlba íródnak, miközben lehetőségünk van megkülönböztetni, honnan származik az adat.
- Azt szeretnénk ellenőrizni, hogy a logstash újraindításakor nem kapja meg ezeket az adatokat újra.
- Azt is szeretnénk ellenőrizni, hogy ha a logstash le van állítva, a fájlokba továbbra is íródnak az adatok, akkor amikor elindítjuk, megkapjuk ezeket az adatokat.
A kísérlethez még egy sort fogunk hozzáadni a docker-compose.yml fájlhoz, megnyitva a könyvtárat, ahová a fájlokat tesszük.
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
És módosítjuk az input szekciót a habr_pipeline.conf fájlban
input {
  file {
    path => "/usr/share/logstash/input/*.log"
   }
  }
Indulunk:
docker-compose up
A naplófájlok létrehozásához és írásához az alábbi parancsot fogjuk használni:
echo '1' >> logs/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Helló Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:53.876Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log"
logstash_one_channel | }
Igen, működik!
Eközben láthatjuk, hogy automatikusan hozzáadtuk a "path" mezőt. Ezért a későbbiekben szűrhetünk a bejegyzések alapján.
Próbáljuk ki még egyszer:
echo '2' >> logs/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Helló Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:59.906Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "2",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log"
logstash_one_channel | }
Most egy másik fájlba:
echo '1' >> logs/number2.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Helló Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:29:26.061Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number2.log"
logstash_one_channel | }
Remek! A fájl beolvasta, a path helyesen lett megadva, minden rendben van.
Állítsuk le a logstash-t, majd indítsuk el újra. Várjunk. Csend. Tehát nem kapjuk meg újra ezeket a bejegyzéseket.
Most pedig a legbátrabb kísérlet.
Letartóztatjuk a logstash-t és végrehajtjuk:
echo '3' >> logs/number2.log
echo '4' >> logs/number1.log
Újraindítjuk a logstash-t és látjuk:
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Helló Habr",
logstash_one_channel |         "message" => "3",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number2.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.589Z
logstash_one_channel | }
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Helló Habr",
logstash_one_channel |         "message" => "4",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.856Z
logstash_one_channel | }
Hurrá! Minden beolvasta.
De figyelmeztetni kell a következőre. Ha a logstash konténer törlődik (docker stop logstash_one_channel && docker rm logstash_one_channel), akkor semmit sem fogunk beolvasni. A konténeren belül a fájl olvasási pozíciója megmaradt. Ha "nulláról" indítjuk, akkor csak az új sorokat fogja elfogadni.
Már meglévő fájlok beolvasása
Tegyük fel, hogy első alkalommal indítjuk a logstash-t, de már vannak naplóink, amelyeket szeretnénk feldolgozni.
Ha elindítjuk a logstash-t a fenti input szekcióval, akkor nem fogunk semmit kapni. Csak az új sorokat fogja a logstash feldolgozni.
A meglévő fájlokból való sorok betöltéséhez hozzá kell adnunk egy új sort az input szekcióhoz:
input {
  file {
    start_position => "beginning"
    path => "/usr/share/logstash/input/*.log"
   }
  }
Fontos megjegyezni, hogy ez csak az új fájlokra vonatkozik, amelyeket a logstash még nem látott. A már észlelt fájlok méretét a logstash már megjegyezte, ezért csak az új bejegyzéseket fogja figyelembe venni.
Most álljunk meg az input szekció tanulmányozásánál. Rengeteg lehetőség van még, de a további kísérletekhez ennyi elegendő.
Adatok irányítása és átalakítása
Próbáljuk megoldani a következő feladatot: tegyük fel, hogy egy csatornából érkeznek az üzenetek, ezek egy része információs, míg a másik része hibákat jelző. A megkülönböztetés a címkével történik: az egyik INFO, a másik ERROR.
Szükséges, hogy a kimenetben szétválasszuk őket. Tehát az információs üzeneteket egy csatornába, a hibákat pedig a másikba írjuk.
Ehhez az input szekcióból a filterhez és az outputhoz lépünk.
A filter szekció segítségével elemezzük a bejövő üzenetet, létrehozva egy hash-t (kulcs-érték párokat), amelyeken már tudunk dolgozni, azaz feltételek szerint elemezni. Az output szekcióból kiválasztjuk az üzeneteket és mindegyiket a saját csatornájába küldjük.
Az üzenet elemzése grok segítségével
A szöveges sorok elemzéséhez és mezők kinyeréséhez a filter szekcióban van egy speciális plugin — grok.
Nem célom itt részletesen ismertetni, ezért az ), egy egyszerű példát mutatok be.
Ebben az esetben először is meg kell határozni a bemeneti sorok formátumát. Az én soraim a következőképpen néznek ki:
1 INFO message1
2 ERROR message2
Tehát az azonosító az első helyen van, majd INFO/ERROR, és egy szó szóközök nélkül.
Nem nehéz, de a működés megértéséhez ez elegendő.
Tehát a filter szekcióban, a grok pluginban meg kell határoznunk a mintát a soraink elemzéséhez.
Ez így fog kinézni:
filter {
  grok {
    match => { "message" => ["%{INT:message_id} %{LOGLEVEL:message_type} %{WORD:message_text}"] }
   }
  }
Alapvetően ez egy reguláris kifejezés. Kész mintákat használtunk, mint például INT, LOGLEVEL, WORD. Ezek leírását, valamint más mintákat itt találhatók:
Most, amikor ezen a szűrőn keresztül haladunk, a sorunk egy hash-re alakul át, amely három mezőt tartalmaz: message_id, message_type, message_text.
Ezek fognak megjelenni az output szekcióban.
Üzenetek irányítása az output szakaszban az if paranccsal
Az output szakaszban, ahogy emlékszünk, meg akartuk osztani az üzeneteket két ágra. Azokat, amelyek iNFO, a konzolra fogjuk kimeneti, a hibákat pedig egy fájlba.
Hogyan oszthatjuk meg ezeket az üzeneteket? A feladat feltétele már sugallja a megoldást – van egy külön mezőnk, a message_type, amely csak két értéket vehet fel: INFO és ERROR. Éppen ez alapján fogjuk végrehajtani a választást az if operátor segítségével.
if [message_type] == "ERROR" {
        # Itt írunk a fájlba
       } else
     {
      # Itt írunk a stdout-ba
    }
A mezőkkel és operátorokkal való munka leírása itt található .
Most pedig magáról a kimenetről.
A kimenet a konzolon, itt minden világos – stdout {}
A fájlba történő kimenet már más: emlékezzünk, hogy ezt az egészet konténerből futtatjuk, és ahhoz, hogy a fájl, amelybe írjuk az eredményt, kívülről elérhető legyen, meg kell nyitnunk ezt a könyvtárat a docker-compose.yml-ben.
Összesen:
A fájlunk output szakasza így néz ki:
output {
  if [message_type] == "ERROR" {
    file {
          path => "/usr/share/logstash/output/test.log"
          codec => line { format => "custom format: %{message}"}
         }
    } else
     {stdout {
             }
     }
  }
A docker-compose.yml-hez hozzáadunk még egy kötetet a kimenet számára:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
      - ./output:/usr/share/logstash/output
Indítjuk, próbáljuk, látjuk a kettéosztást.
Forrás: habr.com
