

Tisztelt olvasók, kellemes napot kívánok!
Az IT-platformok létrehozásának feladata, amelyek képesek adatok felhalmozására és elemzésére, előbb-utóbb minden olyan vállalat előtt felmerül, amelynek üzleti modellje intelligensen terhelt szolgáltatásnyújtásra vagy technikailag bonyolult termékek létrehozására épít. Az analitikai platformok építése összetett és munkaigényes feladat. Azonban minden feladatot egyszerűsíteni lehet. Ebben a cikkben meg szeretném osztani a low-code eszközök alkalmazásának tapasztalatait, amelyek segítenek analitikai megoldások létrehozásában. Ezt a tapasztalatot a Neoflex cég Big Data Solutions területén végzett projektek során szereztük. A Neoflex Big Data Solutions 2005 óta foglalkozik adattárak és adat tavak építésével, a feldolgozási sebesség optimalizálásának problémáival és az adatminőség-irányítási módszertan kidolgozásával.
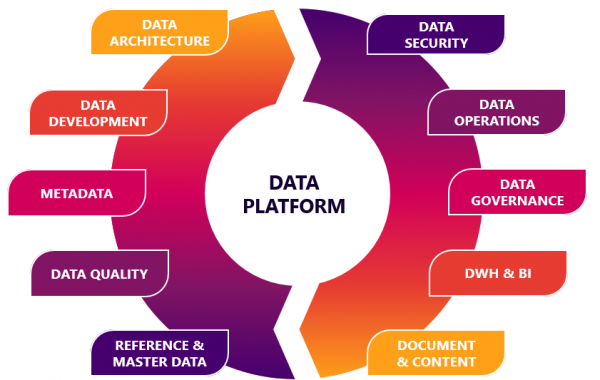
Senki sem kerülheti el a gyengén és/vagy erősen strukturált adatok tudatos felhalmozását. Talán még a kisvállalkozások esetében sem. Hiszen a vállalkozás növekedésekor a jövőbeli vállalkozó olyan kérdésekkel találkozik, mint a hűségprogram kidolgozása, az értékesítési pontok hatékonyságának elemzése, célzott hirdetések vagy a kiegészítő termékek iránti kereslet. Az első megközelítés alapján a feladat „mókásan” is megoldható. De a vállalkozás növekedésekor elkerülhetetlen a költözködés egy analitikai platformra.
De mikor válhatnak az adatelemzési feladatok „Rakéta Tudomány” kategóriájú feladatokká? Talán akkor, amikor valóban nagy adatokkal foglalkozunk.
Ahhoz, hogy egyszerűsítsük a „Rakéta Tudomány” feladatát, a dolgokat egyesével kell megközelíteni.
Minél nagyobb a diszkrét és autonóm jelleg az alkalmazásaid/szolgáltatásaid/mikroszolgáltatásaid esetében, annál könnyebb lesz számodra, a kollégáidnak és az egész vállalatnak a „szezámot” megemészteni.
Ezt az alapelvet gyakorlatilag minden ügyfelünk felismerte, amikor az mérnöki gyakorlataikra alapozva átalakították a tájat a DevOps csapatok körében.
De még a „szigorú, elefántos” diéta mellett is van esély a IT táj „túltelítettségére”. Ekkor érdemes megállni, mélyet lélegezni és körbenézni a low-code engineering platform.
Sok fejlesztőt eltántorít a kódírástól való eltávolodás kilátása, és a low-code rendszerek UI felületein a „húzogatásra” való áttérés. De a gépek megjelenése nem vezetett az mérnökök eltűnéséhez, hanem a munkájukat egy új szintre emelte!
Nézzük meg, miért.
Az adatelemzés a logisztikai, telekommunikációs iparban, a média kutatás területén és a pénzügyi szektorban mindig is felmerült a következő kérdésekkel:
- Az automatizált elemzés sebessége;
- Kísérletek végrehajtásának lehetősége anélkül, hogy hatással lennénk az alapvető adatfeldolgozó folyamatra;
- A feldolgozott adatok megbízhatósága;
- A változások nyomon követése és verziózás;
- Adatnyomozás, adatvonal, CDC;
- Az új funkciók gyors átadása a produkciós környezetbe;
- És a hírhedt: a fejlesztés és fenntartás költsége.
Tehát a mérnököknek rengeteg magas szintű feladatuk van, amelyek végrehajtásához elegendő hatékonysággal csak úgy lehet hozzáférni, ha megszabadulunk a low-level fejlesztési feladatoktól.
A fejlesztők új szintre lépésének előfeltételei az üzlet fejlődése és digitalizálása voltak. A fejlesztő értéke is változik: hiány van azokból a fejlesztőkből, akik képesek belemerülni az automatizálandó üzleti koncepciók lényegébe.
Hozzunk létre analógiát az alacsony és a magas szintű programozási nyelvek között. Az alacsony szintű nyelvek használatától a magas szintű nyelvek felé való áttérés az „ütős utasításokról a gép nyelvén” való áttérést jelenti „utasításokra az emberek nyelvén”. Tehát egy absztrakciós réteg hozzáadása. Ebben az értelemben a low-code platformokra való áttérés a magas szintű programozási nyelvekről – az emberek nyelvén írt „utasításoktól” a „üzleti nyelvű utasításokig” terjed. Ha vannak olyan fejlesztők, akiket ez szomorít, akkor valószínűleg már akkor szomorúak, amikor a Java Script megjelent, amely tömbsorolási funkciókat használ. Ezek a funkciók természetesen más, szintén magas szintű programozási módokkal valósulnak meg.
Ezért a low-code csupán egy újabb absztrakciós szint megjelenését jelenti.
A low-code használatának gyakorlati tapasztalata
A low-code téma elég széles, de most szeretnék egy projektünk példáján keresztül mesélni a "kevéskódos koncepciók" gyakorlati alkalmazásáról.
A "Neoflex" Big Data Solutions részlege főként az üzleti pénzügyi szektorra specializálódik, adatbázisok és adathalmozók építésével, valamint a különböző jelentések automatizálásával. Ebben a szegmensben a low-code alkalmazás régóta standardizálódott. A többi low-code eszköz között említhetők az ETL folyamatok megszervezésére szolgáló eszközök, mint például az Informatica Power Center, IBM Datastage, Pentaho Data Integration. Vagy az Oracle Apex, amely az adat hozzáférési és szerkesztési felületek gyors fejlesztésének környezeteként működik. Azonban a kevéskódos fejlesztési eszközök alkalmazása nem mindig jelent szűkített alkalmazások építését egy kereskedelmi technológiai stack-en, amely nyilvánvalóan függ a beszállítótól.
A low-code platformok segítségével az adatfolyamok orkestrálása is megvalósítható, adat-tudományos platformok hozhatók létre, vagy például adatminőség ellenőrző modulok fejleszthetők.
A kevéskódos fejlesztési eszközök gyakorlati alkalmazásának egyik példája a "Neoflex" és a Mediascope, a orosz média kutatási piac egyik vezető cége közötti együttműködés. E cég üzleti céljainak egyike az adatok előállítása, amelyek alapján a hirdetők, internetes platformok, tévécsatornák, rádióállomások, hirdetési ügynökségek és márkák döntenek a hirdetések vásárlásáról és tervezik marketingkommunikációikat.
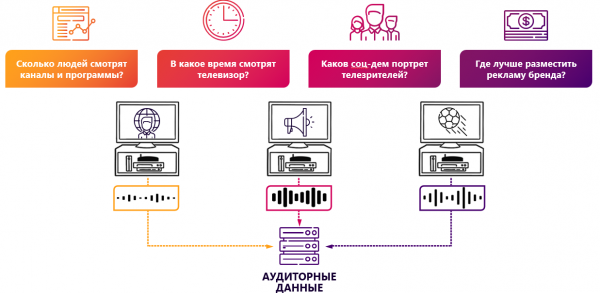
A média kutatások technológiailag igényes üzleti terület. A videófelismerés, az eszközöktől származó adatok gyűjtése, a megtekintés elemzése, a webes aktivitás mérése – mindezek megvalósításához a cégnek jelentős IT-személyzetre és hatalmas tapasztalatra van szüksége az analitikai megoldások kiépítésében. Az információ mennyiségének, forrásaik számának és sokszínűségének exponenciális növekedése folyamatos fejlődésre kényszeríti az IT adatipart. A Mediascope már működő analitikai platformjának egyszerűsített léptéknövelésének egyik lehetősége lehetett volna az IT csapat létszámának növelése. De sokkal hatékonyabb megoldás a fejlesztési folyamat felgyorsítása. A low-code platformok alkalmazása lehet az egyik lépés ebbe az irányba.
A projekt indulásakor a cég már rendelkezett egy működő termékmegoldással. Azonban az MSSQL-re épített megoldás nem tudta teljes mértékben kielégíteni a funkcionalitás skálázhatóságára vonatkozó elvárásokat, miközben megőrzött egy elfogadható költséget a módosításokhoz.
A előttünk álló feladat igazán ambiciózus volt – a Neoflex és a Mediascope egy ipari megoldást kellett, hogy létrehozzon kevesebb mint egy év alatt, feltéve, hogy az MVP már a munka kezdetét követő első negyedévben elkészül.
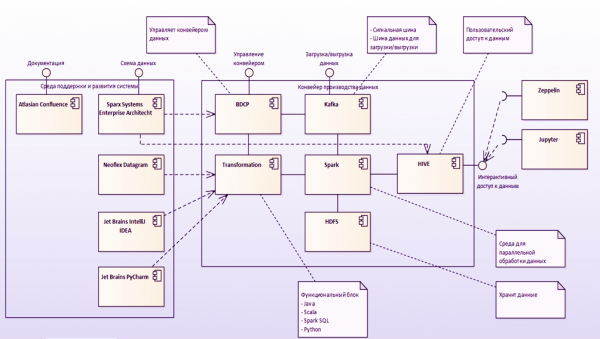
Az új adatplatform felépítésének alapjául a low-code számítástechnikán alapuló Hadoop technológiai stacket választották. Az adatok tárolásának szabványává az HDFS vált, parquet formátumú fájlok használatával. Az adatok hozzáférése érdekében a Hive-ot használták, ahol az összes elérhető bemutató külső táblázatok formájában jelent meg. Az adatok tárolóba történő betöltését Kafka és Apache NiFi segítségével valósították meg.
A low-code eszközt ebben a koncepcióban a legmunkaigényesebb feladat, az analitikai platform adatainak kiszámításának optimalizálására használták.
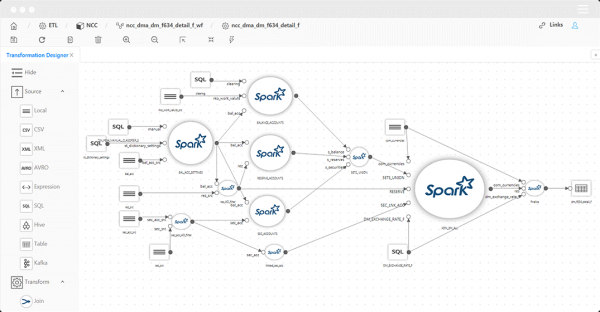
A fő mechanizmus a adatok mappálásához a low-code eszköz, a Datagram lett kiválasztva. Neoflex Datagram – egy eszköz az adatok átalakításának és áramlásának fejlesztésére.
Ezeket az eszközöket használva kikerülhetjük a Scala nyelv kézi kódolását. A Scala-kód automatikusan generálódik a Model Driven Architecture megközelítés felhasználásával.
Nyilvánvaló előnye ennek a megközelítésnek a fejlesztési folyamat felgyorsítása. Azonban a sebességen kívül további előnyei is vannak:
- Források/célállomások tartalmának és struktúrájának megtekintése;
- Az adatok áramlásának származásának nyomon követése a különböző mezőkig (lineage);
- A transzformációk részleges végrehajtása a közbenső eredmények megtekintésével;
- A forráskód megtekintése és módosítása a végrehajtás előtt;
- A transzformációk automatikus validálása;
- Automatikus adatbetöltés 1 az 1-ben.
A belépési küszöb a low-code megoldásokhoz a transzformációk generálásához viszonylag alacsony: a fejlesztőnek SQL-t kell tudnia és tapasztalattal kell rendelkeznie az ETL-eszközök terén. Ugyanakkor meg kell jegyezni, hogy a code-driven transzformációk generátorai nem tekinthetők ETL-eszközöknek a szó szélesebb értelmében. A low-code eszközöknek nem feltétlenül van saját környezetük a kód végrehajtására. Ez azt jelenti, hogy a generált kód abban a környezetben fog futni, amely a klaszterben már jelen volt a low-code megoldás telepítése előtt. Ez kétségtelenül újabb előny a low-code számára. Mivel párhuzamosan a low-code csapat mellett dolgozhat egy „klasszikus” csapat is, amely a funkciót például tiszta Scala kóddal valósítja meg. A két csapat módosításainak integrálása a termelésbe egyszerű és „zökkenőmentes” lesz.
Valószínűleg érdemes megemlíteni, hogy a low-code mellett léteznek no-code megoldások is. Ezek alapvetően eltérő dolgok. A low-code esetében a fejlesztő nagyobb mértékben beavatkozhat a generált kódba. A Datagram esetében lehetséges a generált Scala kód megtekintése és szerkesztése, míg a no-code esetleg nem biztosít ilyen lehetőséget. Ez a különbség jelentős nemcsak a megoldás rugalmassága, hanem a data engineer-ek munkájának kényelme és motivációja szempontjából is.
A megoldás architektúrája
Nézzük meg, hogyan segít a low-code eszköz a fejlesztési sebesség optimalizálásának feladatában a dátumszámítási funkcionalitás terén. Először is nézzük meg a rendszer funkcionális architektúráját. Ebben az esetben a példa a médiakutatásokhoz szükséges adatok előállítási modellje.
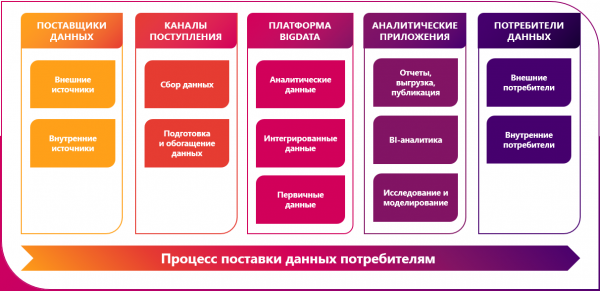
A mi esetünkben az adatok forrásai nagyon változatosak és sokfélék:
- A pipelmeter (TV meter) is a software-hardware device that reads user behavior among respondents on a television panel – who watched which channel, when, in households participating in the study. The provided information is a stream of viewing intervals related to the media package and media product. The data during the loading stage into the Data Lake can be enriched with demographic attributes, geographic ties, timezone, and other information necessary for analyzing the viewing of a particular media product. The measurements conducted can be used for analyzing or planning advertising campaigns, assessing audience activity and preferences, and creating broadcast schedules.
- Data may come from streaming television monitoring systems and measurement of content viewing on internet video resources.
- Measurement tools in the web environment, including both site-centric and user-centric counters. The data provider for the Data Lake may be a browser extension research bar and a mobile app with built-in features. VPN.
- Data can also come from platforms that consolidate results of online surveys and outcomes of telephone interviews in the company's research.
- Additional enrichment of the data lake may occur by loading information from logs of partner companies.
The implementation of as-is loading from source systems into the primary staging of raw data can be organized in various ways. If low-code is used for these purposes, automatic generation of loading scripts based on metadata is possible. In this case, it is not necessary to delve into the level of development of source-to-target mappings. To implement automatic loading, we need to establish a connection to the source, after which we will specify the list of entities to be loaded in the loading interface. The creation of directory structures in HDFS will occur automatically and will correspond to the data storage structure in the source system.
However, in the context of this project, we decided not to use this low-code platform capability since the Mediascope company has already begun work on creating a similar service using Nifi + Kafka.
Azonnal érdemes tisztázni, hogy ezek az eszközök nem helyettesítik egymást, hanem inkább kiegészítik egymást. A Nifi és a Kafka képesek működni mind közvetlen (Nifi -> Kafka), mind fordított (Kafka -> Nifi) kapcsolatokban. A médiaelemzési platform esetében az első kapcsolat fajtáját használták.
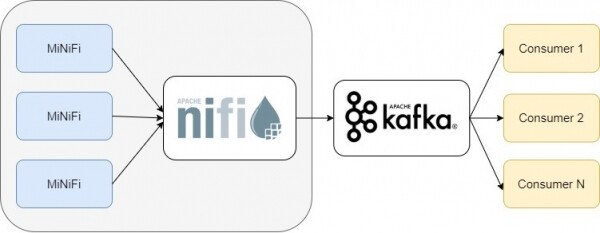
Esetünkben a Nifinek különböző adatforrásokból származó adatokat kellett feldolgoznia és át kellett küldenie a Kafka brokernek. A Kafka egy adott témájába történő üzenetküldés a Nifi PublishKafka processzorainak alkalmazásával történt. Az ilyen pipeline-ok orkestrálása és karbantartása vizuális felületen történik. A Nifi eszköz és a Nifi + Kafka kombinációját a Big Data technológiákba való alacsony belépési küszöb miatt low-code megközelítésnek is nevezhetjük, amely felgyorsítja az alkalmazásfejlesztési folyamatot.
A projekt megvalósításának következő fázisa a részletes adatok egységes szemantikai réteghez való igazítása volt. Ha a entitásnak történelmi atribútumai vannak, a számítás a vizsgált partíció kontextusában történik. Ha az entitás nem történelmi, akkor vagy az objektum teljes tartalmának újraszámítása, vagy a számítás elhagyása is opcionális (a változások hiánya miatt). Ezen a ponton generálják a kulcsokat minden entitás számára. A kulcsokat a megfelelő főobjektumok Hbase adattárába mentik, amely tartalmazza a kulcsok megfeleltetését az analitikai platformon és az adatforrások kulcsai között. Az atomáris entitások konszolidációja a korai analitikai adatok eredményeivel való gazdagítással jár. Az adatok számításához a Spark keretrendszert használták. Az adatok egységes szemantikára történő igazításának leírt funkcióját a low-code eszköz, a Datagram térképezésein alapulva is megvalósították.
A célarchitektúrában SQL-hozzáférést kellett biztosítani az adatokhoz az üzleti felhasználók számára. Ehhez az opcióhoz a Hive-ot használták. A Hive objektumainak regisztrációja automatikusan történik, amikor a low-code eszközben a „Hive Table regisztrálása” opciót bekapcsolják.
A számítási folyamat irányítása
A Datagram rendelkezik egy interfésszel a workflow tervezési folyamataihoz. A térképezések indítása Oozie ütemező segítségével valósítható meg. A folyamatfejlesztői felületen párhuzamos, soros vagy feltételektől függő adattranszformációs sémák hozhatók létre. Támogatás áll rendelkezésre shell script-ekhez és java programokhoz. Lehetséges a használat a szerver Apache Livy. Az Apache Livy a fejlesztési környezetből közvetlenül futtat alkalmazásokat.
Ha a vállalatnak már van saját folyamat-orchesztrálója, a REST API használatával a térképezések beépíthetők a meglévő folyamatokba. Például korábban sikeresen integráltunk Scala térképezéseket PLSQL és Kotlin nyelven írt orchestrátorokba. A low-code eszköz REST API-ja lehetővé teszi a végrehajtható év generálását a térképezési terv alapján, a térképezés hívását, a térképezések sorozatának hívását és természetesen az URL paraméterek átadását a térképezések indításához.
Az Oozie mellett az Airflow eszközeivel is megszervezhető a számítási folyamat. Talán nem állok meg sokáig Oozie és Airflow összehasonlításánál, csak annyit mondok, hogy a médiakutatási projekt munka keretében az Airflow-ra esett a választás. A legfőbb érvek ezúttal a terméket fejlesztő aktívan növekvő közösség és a fejlettebb felhasználói felület + API voltak.
Az Airflow az is jó, mert a számítási folyamatok leírásához sokak által kedvelt Python-t használja. Általában véve, nem sok nyílt forráskódú munkafolyamat-kezelő platform létezik. A folyamatok indítása és nyomon követése (beleértve a Gantt-diagramot is) csak előnyöket ad Airflow karmahoz.
A low-code megoldás térképezéseinek indításához a spark-submit lett a konfigurációs fájl formátuma. Ennek két oka van. Először is, a spark-submit lehetővé teszi egy jar-fájl közvetlen indítását a konzolból. Másodszor, tartalmazhatja az összes szükséges információt a munkafolyamat konfigurálásához (ami megkönnyíti a Dag-ot elkészítő szkriptek írását).
A leggyakrabban előforduló eleme Az Airflow munkafolyamatának esetünkben a SparkSubmitOperator lett.
A SparkSubmitOperator lehetővé teszi jar fájlok – előre definiált bemeneti paraméterekkel rendelkező Datagram térképezések csomagolt változatai – futtatását.
Érdemes megjegyezni, hogy minden Airflow feladat külön szálon fut, és nem tud a többi feladatról. Ennek következtében a feladatok közötti interakciót vezérlő operátorok, mint például a DummyOperator vagy a BranchPythonOperator használatával valósítják meg.
A Datagram alacsony kódú megoldásának használata a konfigurációs fájlok (Dag-okat létrehozó) univerzalizálásával jelentős gyorsulást és egyszerűsítést eredményezett az adathalászati folyamat fejlesztésében.
Vitrinek számítása
Talán a legintellektuálisabb megterhelést jelentő lépés az analitikai adatok előállításában a vitrinépítési fázis. Egy kutatócég adatainak számítási folyamatának keretében ebben a szakaszban a referencia-transzlációhoz való igazítás történik az időzónák figyelembevételével, az adások hálózatához való kapcsolódással. Lehetséges a helyi adásrács (helyi hírek és reklámok) korrekciója is. Ezen a lépésen a közönség figyelési időszakainak felosztása történik a figyelési intervallumok elemzése alapján. Itt zajlik a nézettségi értékek „súlyozása” a jelentőségük alapján (korrekciós tényező számítása).
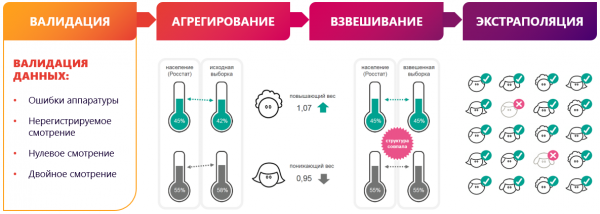
A vitrin előkészítésének külön lépése az adatok érvényesítése. Az érvényesítési algoritmus számos matematikai tudományos modellel kapcsolódik. Azonban az alacsony kódú platform használata lehetővé teszi, hogy a bonyolult algoritmust különálló, vizuálisan olvasható mappákra bontsuk. Mindegyik térkép egy szűk feladatot végez. Ennek eredményeként lehetségessé válik az intermedier hibakeresés, a naplózás és az adatok előkészítésének szakaszainak vizualizálása.
Az érvényesítési algoritmus diszkretizálásáról döntöttek a következő allépésekre:
- A regionális televíziós hálózat nézettségének regressziós modelljeinek megalkotása a regionális összes hálózat nézettségével 60 nap alatt.
- A steudzinenizált maradványok (a tényleges értékek és a regressziós modell által előre jelzett értékek eltérése) számítása minden regressziós pontban és a számítási napon.
- Anomális párminták kiválasztása régió-televízió, ahol a számítási nap steudzinenizált maradványa meghaladja a normát (az operáció beállítása által meghatározott).
- A korrekciók számítása a régió-hálózat anomáliáival kapcsolatosan minden válaszadó esetében, aki a hálózatot nézi a régióban, a válaszadó hozzájárulásának megállapítása mellett (a korrigált maradvány változása) a válaszadó eltávolítása az eljárásból való megértésekor.
- Jelöltek keresése, akik kizárása a normába hozza a korrigált maradványt a számítási napon.
A fenti példa megerősíti azt a hipotézist, hogy egy adatkutatónak sok mindent észben kell tartania... És ha valóban 'mérnök', nem pedig 'kódoló', akkor a low-code eszközök használatakor a szakmai degradálódás félelme végleg el kell, hogyűzzön.
Mit tud még a low-code?
A low-code eszköz használati területe a csomagos és folyamatos adatfeldolgozásra, anélkül, hogy kézzel kellene Scala kódot írni, nem ér véget itt.
A low-code alkalmazása a datalake-ek fejlesztésében már egyfajta standarddá vált számunkra. Talán elmondhatjuk, hogy a Hadoop technológiai stack-re épülő megoldások a klasszikus DWH-k fejlődési útját követik, amelyek relációs adatbázisokon alapulnak. A low-code eszközök a Hadoop stack-en képesek kezelni az adatfeldolgozási feladatokat és az végső BI interfészek kiépítési feladatait is. Érdemes megemlíteni, hogy a BI nemcsak az adatok reprezentálását, hanem azok üzleti felhasználók általi szerkesztését is magában foglalhatja. Ezt a funkciót gyakran használjuk az analitikai platformok felépítésénél a pénzügyi szektor számára.
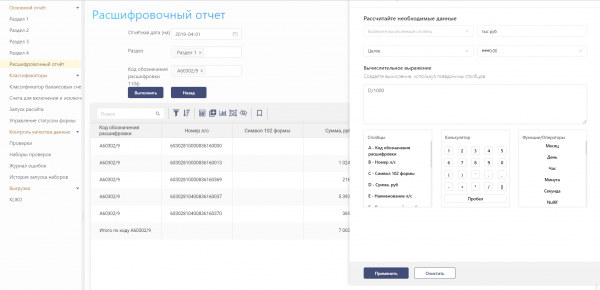
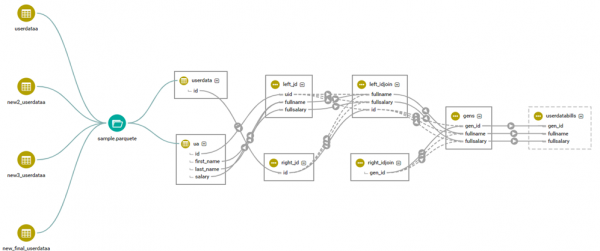
A különféle lehetőségeken belül a low-code és különösen a Datagram segítségével megoldható az adatfolyam-objektumok származásának nyomon követése egészen az egyes mezők szintjéig (lineage). Ehhez a low-code eszközben integrálva van az Apache Atlas és a Cloudera Navigator. Lényegében a fejlesztőnek regisztrálnia kell egy objektumkészletet az Atlas szótárakban, és a regisztrált objektumokra kell hivatkoznia a leképezések elkészítésekor. Az adatok származásának nyomon követésére szolgáló mechanizmus vagy az objektumok közötti függőségek elemzése nagymértékben meggyorsítja az algoritmusok módosításához szükséges időt. Például a pénzügyi jelentések készítésekor ez a funkció kényelmesebbé teszi a jogszabályi változások időszakának átvészelését. Minél jobban megértjük az interformátumú függőségeket a részletes réteg objektumai szempontjából, annál kevesebb „hirtelen” hibával találkozunk és csökkentjük a revorkok számát.
Adatminőség és low-code
A Mediascope cég projektjében megvalósított low-code eszköz által végzett egy másik feladat az Adatminőség osztályba tartozik. A kutatócég projektjének adatellenőrző csővezetékének megvalósítása során az volt a jellemző, hogy ez nem befolyásolta az adatfeldolgozási folyamat működését és sebességét. Az adatellenőrző független folyamatok orkestrálásához már ismert Apache Airflow-t használták. A adatgyártási folyamat minden lépésének elkészültekor párhuzamosan elindult a DQ csővezeték elkülönített része.
Jó gyakorlatnak számít a nyomon követés az adatminőség biztosítása terén már az adatok keletkezésétől kezdve az analitikai platformon. A metaadatokról szerzett információval már a kezdeti rétegbe történő belépéskor ellenőrizhetjük az alapvető feltételek betartását — not null, constraints, foreign keys. Ezt a funkciót a Datagram adatminőség családjába tartozó automatikusan generált leképezések alapján valósították meg. A Mediascope projektjében a kapcsolódás az Enterprise Architect termék metaadataival történt.
A low-code eszköz és az Enterprise Architect integrálásának köszönhetően automatikusan generálták a következő ellenőrzéseket:
- Ellenőrzés a «not null» módosítóval rendelkező mezőkben előforduló «null» értékek jelenlétére;
- Ellenőrzés az elsődleges kulcs duplikációjának jelenlétére;
- Entity külső kulcsának ellenőrzése;
- A sor egyedi ellenőrzése mezők halmaza alapján.
A bonyolultabb ellenőrzésekhez az adatok elérhetősége és hitelessége érdekében egy mappát hoztak létre Scala Expression-nel, amely bemeneti Spark SQL ellenőrző kódot kap, amit az elemzők készítettek a Zeppelinben.
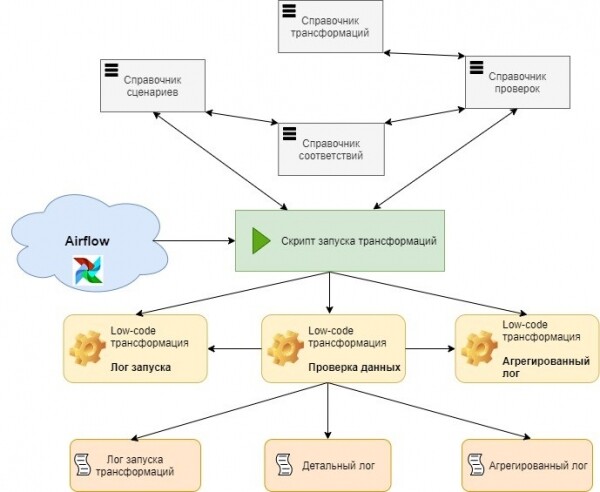
Természetesen az automatikus ellenőrzésekhez fokozatosan kell eljutni. A leírt projekt keretében az alábbi lépések előzték meg ezt:
- DQ, amelyek Zeppelin jegyzetekben valósultak meg;
- DQ, mappába integrálva;
- DQ különálló, nagy méretű mappákban, amelyek különféle ellenőrzéseket tartalmaznak egy adott entitás számára;
- Univerzális paraméterezett DQ-mappák, amelyek információt fogadnak a metaadatokról és a biznisz ellenőrzésekről.
Talán a paraméterezett ellenőrzések szolgáltatásának legfőbb előnye a funkció szállítási idejének csökkentése a termelési környezetbe. Az új minőségi ellenőrzések elkerülhetik a klasszikus kódszállítási mintázatot, amely közvetve a fejlesztői és tesztelési környezeten keresztül történik:
- Minden metainformációs ellenőrzés automatikusan generálódik a modell EA-beli módosításakor;
- Az adatok elérhetőségének ellenőrzése (bármilyen adat meglétének meghatározása adott időpontban) generálható az alapján az adatbázis alapján, amely tárolja a következő adatcsomag várható időpontját objektumok bontásában;
- A biznisz adatok hitelességi ellenőrzéseit az elemzők hozzák létre a Zeppelin notebook-okban, és közvetlenül a DQ modul beállítási tábláiba kerülnek a termelési környezetben.
A termelésbe való közvetlen scriptbetöltés kockázatai lényegében nincsenek. Még szintaktikai hiba esetén is a maximum, amit kockáztatunk, hogy egy ellenőrzés nem hajtódik végre, hiszen az adatok számítási folyamata és a minőségi ellenőrzések elindítása elkülönítve zajlik.
Lényegében a DQ szolgáltatás folyamatosan fut a termelési környezetben, és készen áll, hogy munkába álljon a következő adatcsomag megjelenésekor.
Összegzésként
A low-code alkalmazás használatának előnye egyértelmű. A fejlesztőknek nem kell „nulláról” alkalmazást készíteniük. Az így felszabadított programozó gyorsabban hozza az eredményeket. A sebesség pedig több időforrást szabadít fel az optimalizálási kérdések megoldására. Következésképpen ebben az esetben lehet számítani egy jobb és gyorsabb megoldásra.
Természetesen a low-code nem panacea, és a varázslat önmagában nem fog bekövetkezni:
- A low-code ipar a „megerősödés” szakaszába lépett, és jelenleg nincsenek homogén ipari szabványok;
- Sok low-code megoldás nem ingyenes, és azok megvásárlása tudatos lépés kell, hogy legyen, amit akkor érdemes megtenni, ha teljesen biztosak vagyunk a pénzügyi előnyökben;
- Sok low-code megoldás nem mindig képes jól együttműködni a GIT-tel vagy SVN-nel. Vagy nehezen használható a generált kód elrejtése esetén;
- Az architektúra bővítésekor szükség lehet a low-code megoldás módosítására - ami viszont a „függetlenség és kötődés” hatását kiválthatja a low-code megoldások beszállítójához.
- Az megfelelő szintű biztonság biztosítható, de rendkívül költséges és bonyolult a low-code rendszerek motorjainak megvalósítása. A low-code platformokat nemcsak a használatukból származó előny keresésének elve alapján kell kiválasztani. A választásnál érdemes feltenni a kérdéseket a hozzáférés kezelésének és a hitelesítési adatok delegálásának/eskalációjának funkciói kapcsán az egész szervezet IT táján.
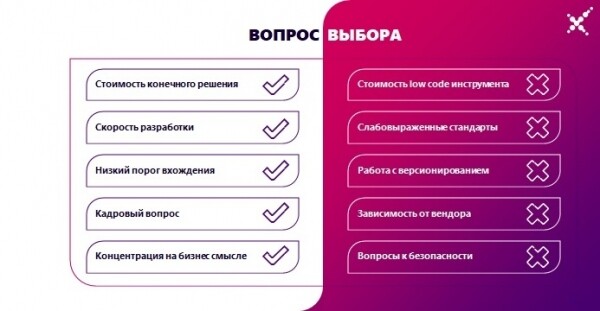
Ha azonban minden ismert hátrányát tekintve a választott rendszernek a használatából származó előnyök mégis dominálnak, akkor félelem nélkül térjünk át a low-code-ra. Annál is inkább, mert a váltás elkerülhetetlen – akárcsak bármilyen evolúció.
Ha egy fejlesztő a low-code platformon gyorsabban végzi a munkáját, mint két fejlesztő low-code nélkül, akkor ez számos előnyt jelent a cég számára. A low-code megoldásokhoz való belépési küszöb alacsonyabb, mint a "hagyományos" technológiáknál, ami kedvezően hat a munkaerőhiány problémájára. A low-code eszközök használatával felgyorsulhat a működési csapatok közötti együttműködés, és gyorsabb döntések születhetnek a kiválasztott adat-tudományi kutatások helyességéről. Az alacsony szintű platformok digitális transzformációt hozhatnak a szervezet számára, mivel a létrehozott megoldások érthetővé válnak nem műszaki szakemberek (különösen üzleti felhasználók) számára.
Ha sürgős határidőkkel, bonyolult üzleti logikával, valamint technológiai szakértőkből adódó hiánnyal küzd, és fel kell gyorsítania a piacon való megjelenést, a low-code az egyik módja lehet az igényei kielégítésének.
Nem érdemes tagadni a hagyományos fejlesztési eszközök fontosságát, azonban sok esetben a low-code megoldások alkalmazása a legjobb módja a feladatok hatékonyságának növelésére.
Forrás: habr.com
