

Megjegyzés: ez a vállalat mérnöki blogjából származó nyilvános posztmortem fordítása . A dokumentum leírja a conntrack problémát a Kubernetes klaszterben, ami néhány termelési szolgáltatás részleges leállásához vezetett.
Ez a cikk hasznos lehet azok számára, akik többet szeretnének megtudni a posztmortemekről, vagy meg akarják előzni a potenciális DNS problémákat a jövőben.
Ez nem DNS
Nem lehet, hogy ez DNS
Ez DNS volt
Egy kis tudnivaló a posztmortemekről és a Preply folyamatokról
A posztmortem a működési zavarokat vagy eseményeket írja le a termelésben. A posztmortem tartalmazza az események idővonalát, a felhasználókra gyakorolt hatást, az elsődleges okokat, a tennivalókat és az ebből levont tanulságokat.
A heti, pizzával egybekötött megbeszéléseinken a technikai csapat körében különböző információkat osztunk meg. Az ilyen megbeszélések legfontosabb részei közé tartoznak a posztmortemek, amelyeket legtöbbször диапrizációval és mélyebb elemzéssel kísérünk. Bár a posztmortemek után nem tapsolunk, próbáljuk fejleszteni a "hibátlan kultúrát" (). Hiszünk abban, hogy a posztmortemek írása és bemutatása segíthet nekünk (és másoknak) a hasonló események jövőbeni megelőzésében, ezért osztjuk meg őket.
Az incidensbe beleavatkozó személyeknek érezniük kell, hogy részletesen beszélhetnek róla, anélkül, hogy a büntetéstől vagy védekezéstől kellene tartaniuk. Nincs elmarasztalás! A posztmortem írása nem büntetés, hanem tanulási lehetőség az egész vállalat számára.
DNS problémák a Kubernetesben. Posztmortem
Dátum: 28.02.2020
Szerzők: Amet U., Andrey S., Igor K., Alexey P.
Állapot: Befejezve
Röviden: DNS részleges elérhetetlenség (26 perc) néhány szolgáltatás számára a Kubernetes klaszterben
Hatás: 15000 esemény elveszett az A, B és C szolgáltatások számára
Elsődleges ok: A Kube-proxy nem tudta helyesen eltávolítani a régi bejegyzést a conntrack táblából, ezért egyes szolgáltatások továbbra is a nem létező podokhoz próbáltak csatlakozni
E0228 20:13:53.795782 1 proxier.go:610] A kube-system/kube-dns:dns végpont kapcsolatok törlése nem sikerült, hiba: hiba történt a conntrack bejegyzések törlésekor az UDP társ {100.64.0.10, 100.110.33.231} esetén, hiba: a conntrack parancs visszatért: ...Trigger: Az alacsony terhelés miatt a Kubernetes klaszterben a CoreDNS-autoscaler csökkentette a podok számát a telepítésben hármról kettőre
Megoldás: A következő alkalmazás telepítése új csomópontok létrehozását indította el, a CoreDNS-autoscaler több podot adott hozzá a klaszter kiszolgálásához, ami a conntrack táblázat felülírását okozta.
Felfedezés: A Prometheus monitorozás nagy számú 5xx hibát észlelt az A, B és C szolgáltatásoknál, és értesítette a hivatásos mérnököket.
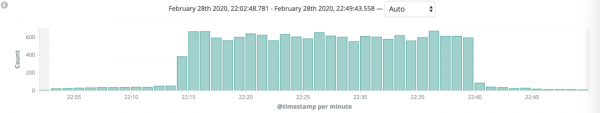
5xx hibák a Kibana-ban.
Műveletek
Művelet
Típus
Felelős
Feladat
Az automatikus skálázót le kell állítani a CoreDNS számára.
megakadályozni
Amet U.
DEVOPS-695
Cache-elő DNS-szerver beállítása.
csökkenteni
Max V.
DEVOPS-665
Conntrack monitorozás beállítása.
megakadályozni
Amet U.
DEVOPS-674
Tanulmányozott leckék.
Mi ment jól:
- A monitorozás pontosan működött. A reakció gyors és szervezett volt.
- Nem ütköztünk semmilyen határértékbe a csomópontokon.
Mi volt rossz:
- A valós ok továbbra is ismeretlen, úgy tűnik, hogy a conntrack-ban.
- Minden lépés csak a következményeket javítja, nem az okot (hibát).
- Tudtuk, hogy előbb vagy utóbb problémáink lehetnek a DNS-szel, de nem priorizáltuk a feladatokat.
Hol volt szerencsénk:
- A következő telepítés kiváltotta a CoreDNS-autoscalert, amely felülírta a conntrack táblát.
- Ez a hiba csak néhány szolgáltatást érintett.
Idővonal (EET)
Idő
Művelet
22:13
A CoreDNS-autoscaler csökkentette a podok számát háromról kettőre.
22:18
A hivatásos mérnökök hívásokat kezdtek kapni a monitorozó rendszertől.
22:21
A hivatásos mérnökök elkezdték kideríteni a hibák okát.
22:39
A hivatásos mérnökök elkezdték visszaállítani az egyik legutóbbi szolgáltatást a korábbi verzióra.
22:40
A 5xx hibák megszűntek, a helyzet stabilizálódott.
- Felfedezési idő: 4 perc
- Cselekvési idő: 21 perc
- Javítási idő: 1 perc
Dokumentáció
- CoreDNS naplók:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Scaling down replica set coredns-6cbb6646c9 to 2. - Hivatkozások a Kibana-ra (csonkítva), Grafana (csonkítva).
A processzorhasználat minimalizálása érdekében a Linux mag egy olyan dolgot használ, mint a conntrack. Röviden, ez egy eszköz, amely egy NAT-bejegyzéssorozatot tartalmaz, amely egy speciális táblázatban van tárolva. Amikor a következő csomag ugyanabból a podból érkezik, mint korábban, a végső IP-cím nem lesz újraszámítva, hanem a conntrack táblából kerül felhasználásra.
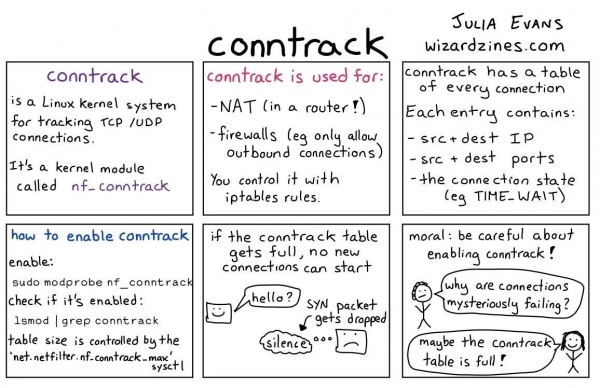
Hogyan működik a conntrack.
Összegzés
Ez volt az egyik posztmortemünk példája, néhány hasznos linkkel. Kifejezetten ebben a cikkben olyan információkat osztunk meg, amelyek más cégek számára hasznosak lehetnek. Ezért nem félünk hibázni, és ezért tettük egyik posztmortemünket nyilvánossá. Íme még néhány érdekes nyilvános posztmortem:
- GitLab:
- Dropbox:
- Spotify:
- Sok más a és a tárolótól
- Ezenkívül nyilvános posztmortem az SRE Könyvvel
Forrás: habr.com
