

A jövő megérkezett, a mesterséges intelligencia és a gépi tanulás technológiáit már sikeresen alkalmazzák a kedvenc boltjaitok, szállítmányozó cégek és még a pulykát nevelő farmok is.
És ha valami létezik, akkor az interneten már biztosan van róla... nyílt projekt! Nézd meg, hogyan segít az Open Data Hub új technológiák skálázásában és elkerülni a bevezetésükkel kapcsolatos nehézségeket.
A mesterséges intelligencia (artificial Intelligence, AI) és a gépi tanulás (machine learning, ML) minden előnye ellenére a szervezetek gyakran nehézségekbe ütköznek ezen technológiák skálázása során. A fő problémák a következők általában:
- Információcsere és együttműködés – szinte lehetetlen információt cserélni felesleges erőfeszítések nélkül, és gyors iterációs módon együttműködni.
- Hozzáférés az adatokhoz – minden feladathoz újra és manuálisan kell létrehozni, ami sok időt vesz igénybe.
- Hozzáférés igény szerint – nincs lehetőség igény szerint elérni a gépi tanulási eszközöket és platformokat, valamint a számítási infrastruktúrát.
- Termelés – a modellek prototípus szinten maradnak, és nem jutnak el a gyártásba.
- AI munkájának nyomon követése és magyarázata – az AI/ML eredmények reprodukálhatósága, nyomon követése és magyarázata nehézkes.
Ha e problémák megoldatlanok maradnak, az kedvezőtlen hatással van az értékes adatkezelési és elemzési szakemberek munkájának sebességére, hatékonyságára és termelékenységére. Ez frusztrációhoz, munkával kapcsolatos csalódottsághoz vezet, és végül a vállalat AI/ML iránti elvárásai semmivé válnak.
A problémák megoldásának felelőssége az IT szakemberekre hárul, akiknek a data analystok számára - helyesen, egy felhőhöz hasonlót - kell biztosítaniuk. Ha bővebben kifejtjük, olyan platformra van szükség, amely szabadságot biztosít és kényelmes, egyszerű hozzáférést kínál. Emellett gyors, könnyen átkonfigurálható, igény szerint skálázható és hibatűrő. Egy ilyen platform megépítése nyílt forráskódú technológiák alapján segít elkerülni a beszállítók függőségét és megőrizni a hosszú távú stratégiai előnyöket a költségek ellenőrzésében.
Néhány évvel ezelőtt hasonló dolgok történtek az alkalmazásfejlesztésben, amelyek a mikroszolgáltatások, hibrid felhő környezetek, IT automatizálás és agilis folyamatok megjelenéséhez vezettek. Annak érdekében, hogy megbirkózzanak mindezzel, az IT szakemberek konténereket, Kubernetes-t és nyílt hibrid felhőket kezdtek használni.
Most ezt a tapasztalatot használják az AI kihívásaira adott válaszként. Ezért az IT szakemberek olyan platformokat hoznak létre, amelyek konténereken alapulnak, lehetővé teszik AI/ML szolgáltatások létrehozását agilis folyamatok keretében, felgyorsítják az innovációt, és hibrid felhőre célozzák őket.
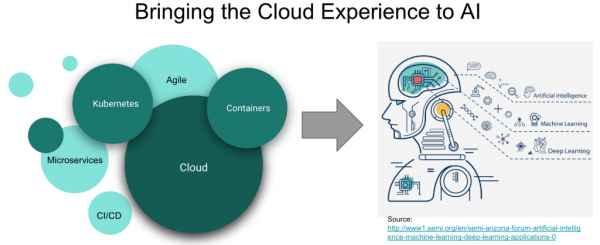
Egy ilyen platform megépítését a Red Hat OpenShift-tel kezdjük, amely a hibrid felhő számára fejlesztett konténer Kubernetes platformunk, valamint egy gyorsan növekvő ökoszisztémával rendelkezik, amely szoftveres és hardveres ML megoldásokkal (NVIDIA, H2O.ai, Starburst, PerceptiLabs stb.) rendelkezik. A Red Hat néhány ügyfele, mint például a BMW Group, ExxonMobil és mások már kiépítették a konténerizált ML eszközök láncait és DevOps folyamatokat ezen a platformon és annak ökoszisztémáján, hogy ipari működésbe lépjenek ML architektúráikkal és felgyorsítsák az adat-analitikusok munkáját.
Még egy ok, amiért elindítottuk az Open Data Hub projektet - példát mutatni egy több nyílt forráskódú projekt alapú architektúrára, és bemutatni, hogyan lehet megvalósítani az ML megoldás teljes életciklusát az OpenShift platformján.
Open Data Hub projekt
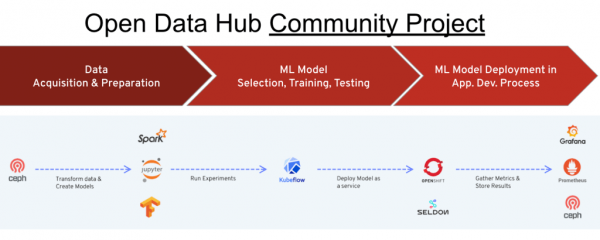
Ez egy nyílt forráskódú projekt, amely a megfelelő fejlesztési közösségen belül fejlődik és a műveletek teljes ciklusát megvalósítja - az alapadatok betöltésétől és átalakításától az ML modellek létrehozásáig, tanításáig és fenntartásáig - AI/ML problémák megoldásakor konténerek és Kubernetes használatával az OpenShift platformján. Ez a projekt mintaként szolgálhat, bemutatva, hogyan lehet felépíteni egy „AI/ML mint szolgáltatás” nyitott megoldást az OpenShift és a megfelelő nyílt forráskódú eszközök, mint a Tensorflow, JupyterHub, Spark stb. alapján. Fontos megjegyezni, hogy a Red Hat maga is használja ezt a projektet AI/ML szolgáltatásai nyújtására. Továbbá az OpenShift integrálódik a NVIDIA, Seldon, Starbust és más szolgáltatók kulcsfontosságú szoftveres és hardveres ML megoldásaival, megkönnyítve a saját gépi tanulási rendszerek felépítését és használatát.
Az Open Data Hub projekt a következő felhasználói kategóriákra és felhasználási forgatókönyvekre összpontosít:
- Adat-analitikus, akinek szüksége van egy felhőalapú, önkiszolgáló megoldásra ML projektek megvalósításához.
- Adat-analitikus, akinek a legújabb AI/ML eszközök és nyílt forráskódú platformok széles választékára van szüksége.
- Adat-analitikus, akinek hozzáférése van az adatforrásokhoz a modellek tanítása során.
- Adat-analitikus, akinek hozzáférésére van szüksége a számítási erőforrásokhoz (CPU, GPU, memória).
- Adat-analitikus, akinek lehetősége van együttműködni és megosztani munkája eredményeit kollégáival, visszajelzést kapni és a gyors iterációs módszerrel javítani.
- Adat-analitikus, aki szeretne együttműködni a fejlesztőkkel (és devops csapatokkal), hogy ML modelljei és munkájának eredményei a produkcióba kerüljenek.
- Adatmérnök, akinek lehetőséget kell biztosítania az adat-analítikának, hogy különböző adatforrásokhoz hozzáférjen a biztonsági normák és követelmények betartása mellett.
- IT rendszerek adminisztrátora/működtetője, akinek lehetősége van anélkül irányítani az nyílt forráskódú komponensek és technológiák életciklusát (telepítés, konfigurálás, frissítés). Ezenkívül megfelelő menedzsment és kvótázó eszközökre van szüksége.
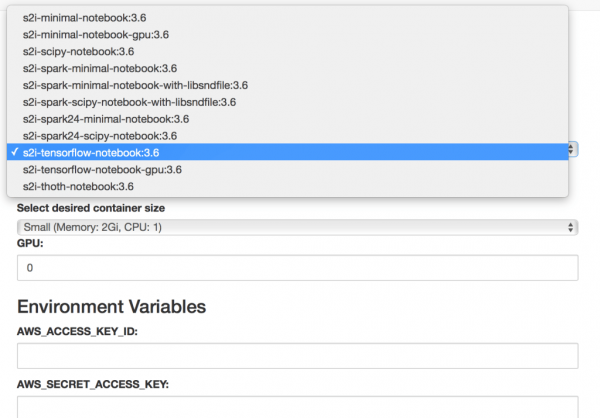
Az Open Data Hub projekt egy sor nyílt forráskódú eszközt egyesít az AI/ML műveletek teljes ciklusának megvalósításához. Az adat-analitikus fő munkasaroként itt a Jupyter Notebookot használja. Ez az eszközkészlet ma széles körben népszerű az adatok feldolgozásával és elemzésével foglalkozó szakemberek körében, és az Open Data Hub lehetővé teszi számukra, hogy könnyen létrehozzák és kezeljék a Jupyter Notebook munkaterületeit, a beépített JupyterHub segítségével. Ezenkívül a Jupyter jegyzetek létrehozása és importálása mellett az Open Data Hub egy sor már kész Jupyter jegyzetet is tartalmaz az AI Library könyvtár formájában.
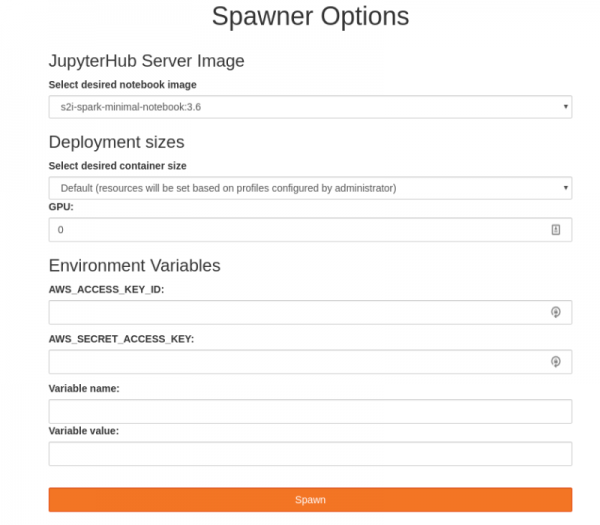
Ez a könyvtár egy open-source gépi tanulási komponenseinek és megoldásainak gyűjteménye, amely megkönnyíti a gyors prototípus-készítést. A JupyterHub integrált az OpenShift RBAC-hozzáférési modellel, lehetővé téve a meglévő OpenShift-fiókok használatát és egyetlen belépési rendszert valósít meg. Ezenkívül a JupyterHub egy felhasználóbarát felületet kínál, amelyet spawnernek hívnak, és amelynek segítségével a felhasználó könnyen beállíthatja a számítási erőforrások (processzormagok, memória, GPU) mennyiségét a kiválasztott Jupyter Notebook számára.
Miután a dátáelemző létrehozta és beállította a notebookot, a további feladatokat a Kubernetes ütemező veszi át, amely része az OpenShiftnek. A felhasználóknak csak azzal kell foglalkozniuk, hogy kísérleteiket elvégezzék, és megosszák munkájuk eredményeit. Ezenkívül a haladó felhasználók közvetlenül használhatják az OpenShift CLI felületet a Jupyter notebooks-ból, hogy Kubernetes-primitivekhez, például Jobokhoz, vagy OpenShift funkciókhoz, mint például a Tekton vagy Knative, férjenek hozzá. Vagy erre használhatják az OpenShift felhasználóbarát GUI-ját, amelyet „OpenShift webkonzolának” neveznek.
Tovább lépve, az Open Data Hub lehetőséget ad az adatsorok (data pipelines) kezelésére. Ehhez Ceph-objektumot használnak, amely S3-kompatibilis objektumtárolóként érhető el. Az Apache Spark adatfolyamot biztosít külső forrásokból vagy a beépített Ceph S3 tárolóból, valamint lehetővé teszi az adatok előzetes transzformálását. Az Apache Kafka kibővített adatcsatorna-kezelési lehetőségeket biztosít, ahol több betöltés és adatok transzformációs, elemzési és tárolási műveletei végezhetők el.
Tehát a dátáelemző hozzáférést kapott az adatokhoz és felépítette a modellt. Most szeretné megosztani az így kapott eredményeket kollégáival vagy alkalmazásfejlesztőkkel, és lehetőséget biztosítani számukra, hogy ezt a modellt szolgáltatásként használják. Ehhez szüksége van egy kiadószerverre, amelyet az Open Data Hub biztosít, és ezt Seldonnak hívják, amely lehetővé teszi a modell közzétételét RESTful-szolgáltatásként.
Egy adott pillanatban ilyen modellekből több is található a Seldon szerveren, és szükség van a használatuk nyomon követésére. Ehhez az Open Data Hub egy releváns metrikák gyűjteményét és egy jelentéskészítő motort kínál a népszerű open-source monitoring eszközök, a Prometheus és a Grafana alapjaira. Ennek eredményeként visszajelzést kapunk az AI modellek használatának nyomon követéséhez, különösen termelési környezetben.
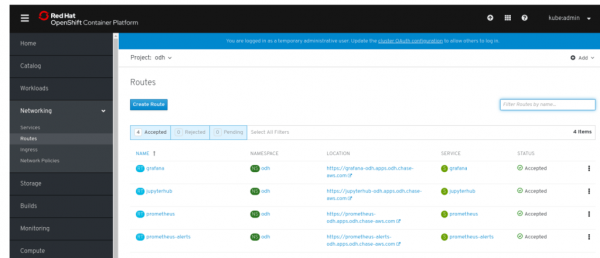
Így az Open Data Hub felhőhöz hasonló megközelítést biztosít az AI/ML műveletek teljes ciklusában, kezdve az adatok hozzáférésével és előkészítésével, egészen a modell tanításáig és ipari telepítéséig.
Mindent egybehozni
Most felmerül a kérdés, hogy mindezt hogyan szervezze meg az OpenShift adminisztrátor. És itt lép működésbe egy speciális Kubernetes operátor az Open Data Hub projektek számára.
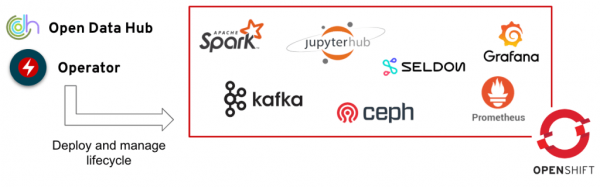
Ez az operátor irányítja az Open Data Hub projekt telepítését, konfigurálását és életciklusát, beleértve olyan említett eszközök telepítését, mint a JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus és Grafana. Az Open Data Hub projekt megtalálható az OpenShift webes konzoljában a community operátorok között. Így az OpenShift adminisztrátora beállíthatja, hogy a megfelelő OpenShift projektek az 'Open Data Hub projekt' kategóriába tartoznak. Ezt egyszer kell elvégezni. Ezután az adatelemző a webes konzolon belép a projektterületére, és látja, hogy a projektjeihez elérhető a megfelelő Kubernetes operátor. Ezt követően egy kattintással létrehoz egy Open Data Hub projekt példányt, és azonnal hozzáfér a fent említett eszközökhöz. Mindez magas rendelkezésre állású és hibatűrő üzemmódban konfigurálható.
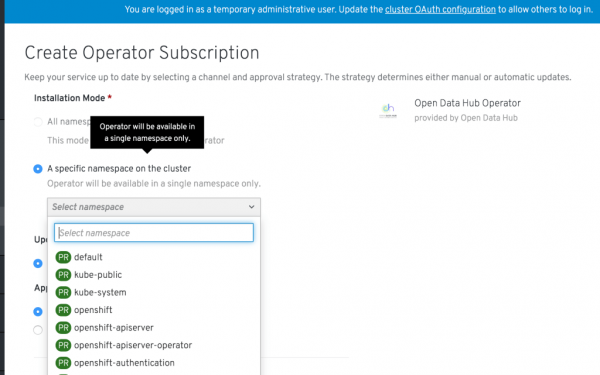
Ha szeretné saját kezűleg kipróbálni az Open Data Hub projektet, kezdje el . A nyílt adatközpont architektúrájának technikai részleteit itt találja , a projekt fejlesztési tervei pedig itt – . A jövőben további integrációt tervezünk a Kubeflow-lal, a szabályozási és biztonsági kérdések megoldását, valamint integrációt a Drools és Optaplanner alapú rendszerekkel. Véleményét kifejezheti és részt vehet a projektben a következő oldalon .
Összefoglalva: A komoly skálázási problémák megakadályozzák a szervezeteket abban, hogy teljes mértékben kihasználják a mesterséges intelligencia és a gépi tanulás potenciálját. A Red Hat OpenShift régóta és sikeresen alkalmazzák hasonló problémák megoldására a szoftveriparban. Az Open Data Hub projekt, amelyet az open-source fejlesztői közösség valósított meg, referenciaként szolgáló architektúrát kínál az AI/ML műveletek teljes ciklusának megszervezéséhez a Red Hat OpenShift hibrid felhőalapján. Van egy világos és átgondolt fejlesztési tervünk ehhez a projekthez, és elkötelezettek vagyunk abban, hogy aktív és termékeny közösséget építsünk az OpenShift platformján elérhető nyílt AI-megoldások köré.
Forrás: habr.com
