

Ez egy fordítási cikk . De előtte egy rövid bevezető. Hogyan alakulnak a zombik? Mindenki volt már olyan helyzetben, amikor segítséget szeretett volna nyújtani egy barátnak vagy kollégának, de nem sikerült. És nem annyira rólad van szó, hanem róla: az egyik serpenyőben ott áll a normális bér, a feladatok és így tovább, míg a másik oldalán ott van a gondolkodás szükségessége. Gondolkodni kényelmetlen és fájdalmas. Ő gyorsan feladja, és továbbra is kódot ír, teljesen kizárva az agyát. Elképzeled, mennyi energiát kellene arra fordítani, hogy legyőzd a megtanult tehetetlenség akadályát, és egyszerűen nem csinálod ezt. Így alakulnak ki a zombik, akiket elvileg meg lehet gyógyítani, de úgy tűnik, senki sem foglalkozik ezzel.
Amikor láttam, hogy (igen, az a tanár az oktatási könyvekből) és nem előadást tart, hanem egy kérdés-felelet ülést, picit óvatos lettem. Mindenesetre, Leslie egy világszerte elismert tudós, a diszkrét számítástechnikában végzett alapvető munkák szerzője, és lehet, hogy ismeri a La betűkből a LaTeX-et — „Lamport TeX”. A másik aggasztó tényező az a követelménye, hogy mindenki, aki eljön, ingyen (teljesen ingyen) hallgassa meg előre néhány előadását, gondoljon ki legalább egy kérdést, és csak akkor jöhet. Úgy döntöttem, megnézem, mit mond Lamport — és csodálatos! Ez pontosan az a dolog, a varázslatos hivatkozás-tabletta a zombik gyógyítására. Figyelmeztetek: a szöveg erősen felkaphatja a fejüket a rendkívül rugalmas módszerek kedvelőinek és a tesztelés nélküli írás ellenzőinek.
A hibrid után tulajdonképpen kezdődik a szeminárium fordítása. Jó olvasást!
Bármilyen feladata is legyen, mindig három lépést kell követnie:
- meghatározni, milyen célt szeretne elérni;
- eldönteni, hogyan fogja elérni a célját;
- elérni a célját.
Ez a programozásra is vonatkozik. Amikor kódot írunk, szükségünk van arra, hogy:
- eldöntsük, mit kell tennie a programnak;
- meghatározzuk, hogyan kell elvégeznie a feladatát;
- megírni a megfelelő kódot.
Az utolsó lépés természetesen nagyon fontos, de erről ma nem fogok beszélni. Ehelyett az első kettőt fogjuk megvitatni. Minden programozónak el kell végeznie őket, mielőtt elkezdene dolgozni. Nem ülsz le írni, ha nem döntötted el, hogy mit is írsz: böngészőt vagy adatbázist. Képesnek kell lenned arra, hogy világos elképzelésed legyen a célról. Előre meg kell gondolnod, hogy a program pontosan mit fog csinálni, és nem szabad csak úgy belefogni, abban a reményben, hogy a kód valahogyan böngészővé alakul.
Hogyan történik ez a kód előzetes megtervezése? Mennyit kellene erre áldoznunk? Minden attól függ, hogy mennyire bonyolult problémát oldunk meg. Tegyük fel, hogy egy hibatűrő, elosztott rendszert szeretnénk írni. Ebben az esetben alaposan át kell gondolnunk mindent, mielőtt leülnénk a kódhoz. De mi van akkor, ha csak annyit kell tennünk, hogy megnöveljük az egész számú változót 1-gyel? Első ránézésre ez triviálisnak tűnik, és nem igényel sok gondolkodást, de aztán eszünkbe jut, hogy előfordulhat túlcsordulás. Tehát ahhoz, hogy megértsük, hogyan kell kezelni az egyszerű vagy bonyolult problémákat, először mindig gondolkodnunk kell.
Ha előzetesen átgondoljuk a lehetséges megoldásokat a problémára, elkerülhetjük a hibákat. Ehhez azonban világos gondolkodásra van szükség. Ennek elérése érdekében érdemes leírni a gondolatainkat. Nagyon tetszik Dick Hintonnak a mondása: „Amikor írsz, a természet bemutatja neked, milyen rendezetlen a gondolkodásod.” Ha nem írsz, csak azt hiszed, hogy gondolkodsz. A gondolataidat specifikációk formájában kell rögzítened.
A specifikációk számos funkciót ellátnak, különösen nagy projektekben. De csak egyikről fogok beszélni: segítenek nekünk világosan gondolkodni. A világos gondolkodás nagyon fontos és meglehetősen nehéz, ezért bármilyen segítség jótékony. Milyen nyelven kellene megírnunk a specifikációkat? Ez általában mindig az első kérdés a programozók számára: milyen nyelven fogunk írni. Nincs egyetlen helyes válasz erre: a megoldandó problémák túlságosan sokfélék. Egyeseknek a TLA+ hasznos — ez az én általánosító nyelvem. Másoknak talán a kínai a kényelmesebb. Minden a helyzettől függ.
Egy másik fontos kérdés: hogyan érhetjük el a tisztább gondolkodást? Válasz: úgy kell gondolkodnunk, mint a tudósok. Ez az a gondolkodásmód, amely az elmúlt 500 évben jól bevált. A tudományban matematikai modelleket építünk a valóságról. Az asztronómia talán az első tudomány volt a szó szoros értelmében. Az asztronómiában használt matematikai modellben az égitestek pontokként jelennek meg, tömeggel, helyzettel és impulzussal, noha valójában rendkívül bonyolult objektumok, hegyekkel és óceánokkal, árapályokkal és apályokkal. Ez a modell, mint minden másik, bizonyos feladatok megoldására készült. Kiválóan alkalmas arra, hogy meghatározza, hová kell irányítani a távcsövet, ha egy bolygót szeretnénk felfedezni. De ha meg akarjuk jósolni a bolygó időjárását, ez a modell nem megfelelő.
A matematika lehetővé teszi számunkra a modell tulajdonságainak meghatározását. A tudomány pedig megmutatja, hogyan viszonyulnak ezek a tulajdonságok a valósághoz. Beszéljünk a mi tudományunkról, a számítástechnikáról. Az a valóság, amellyel dolgozunk — különféle számítógépes rendszerek: processzorok, játékkonzolok, programokat futtató számítógépek és így tovább. Én a program számítógépen való végrehajtásáról fogok beszélni, de alapvetően ezek a megállapítások bármely számítógépes rendszerre alkalmazhatók. A mi tudományunkban számos különféle modellt használunk: Turing-gép, részben rendezett eseményszettek és sok más.
Mi az a program? Ez bármely kód, amelyet önállóan is tekinthetünk. Tegyük fel, hogy böngészőt kell írni. Három feladatot végzünk el: megtervezzük a program megjelenését a felhasználó számára, utána írunk egy magasszintű programvázlatot, végül pedig kódot írunk. A kód írása közben rájövünk, hogy szükségünk van egy eszközre a szöveg formázására. Itt is három feladatot kell megoldanunk: meghatározni, milyen szöveget fog visszaadni ez az eszköz; kiválasztani a formázási algoritmust; kódot írni. Ennek a feladatnak van egy alművelete: a kötőjel helyes beillesztése a szavakba. Ezt az alműveletet is három lépésben oldjuk meg — ahogyan látjuk, ezek több szinten is ismétlődnek.
Nézzük meg részletesebben az első lépést: milyen feladatot old meg a program. Itt leggyakrabban a programot úgy modellezzük, mint egy funkciót, amely bizonyos bemeneteket kap, és adatok visszaadását végzi. Matematikában a funkciót általában rendezett párok halmazaként írjuk le. Például a négyzetre emelés funkciója a természetes számokra a következőként írható le: {, , , , …}. Ennek a funkciónak a definíciós tartománya a pár első elemeiből álló halmaz, vagyis a természetes számok. A funkció meghatározásához meg kell adnunk a definíciós tartományát és a képletet.
De a matematikai funkciók nem ugyanazok, mint a programozási nyelvekben lévő funkciók. A matematika sokkal egyszerűbb. Mivel bonyolult példákra nincs időm, nézzünk egy egyszerűt: funkció a C nyelvben vagy statikus metódus a Java-ban, amely két egész szám legnagyobb közös osztóját adja vissza. E metódus specifikációjában ezt fogjuk írni: számítja GCD(M,N) a paraméterekhez M és N, ahol GCD(M,N) — a funkció, amelynek definíciós tartománya az egész számok párjainak halmaza, míg a visszatérési érték a legnagyobb egész szám, amely osztja M és N. Hogyan viszonyul ez a modell a valósághoz? A modell egész számokkal operál, míg a C vagy Java esetében 32 bites egész. Ez a modell lehetővé teszi számunkra, hogy meghatározzuk, helyes-e az algoritmus GCD, de nem akadályozza meg a túlcsordulás hibáit. Ehhez egy bonyolultabb modellre lenne szükség, amely létrehozására nincs idő.
Beszéljünk a funkció mint modell korlátairól. Egyes programok működése (például operációs rendszerek) nem merül ki abban, hogy meghatározott értéket adjanak vissza a megadott paraméterekre; ezek folyamatosan működhetnek. Továbbá a funkció mint modell gyengén illeszkedik a második lépéshez: a feladat megoldásának tervezéséhez. A gyors rendezés és a buborékrendezés ugyanazt a funkciót számítja, de teljesen eltérő algoritmusok. Ezért a program céljának elérésének módjának leírásához egy másik modellt használok, nevezzük ezt a standard viselkedési modellnek. Ebben a modellben a programot minden engedélyezett viselkedés halmazaként mutatjuk be, amelyek mindegyike egymás után következő állapotok sorozataként jelenik meg, ahol az állapot a változókhoz rendelt értékeket jelenti.
Nézzük meg, hogyan fog kinézni az Euklideszi algoritmus második lépése. Számítanunk kell GCD(M, N). Inicializálunk M hogyan x, és N hogyan y, majd folyamatosan levonjuk a kisebbik változót a nagyobbiktól, amíg egyenlővé nem válnak. Például, ha M = 12, és N = 18, akkor a következő viselkedést tudjuk leírni:
[x = 12, y = 18] → [x = 12, y = 6] → [x = 6, y = 6]
De ha M = 0 és N = 0? Ноль делится на все числа, поэтому наибольшего делителя в этом случае нет. В этой ситуации нам нужно вернуться к первому шагу и спросить: действительно ли нам нужно вычислять НОД для неположительных чисел? Если в этом нет необходимости, то нужно просто изменить спецификацию.
Itt érdemes egy kis kitérőt tenni a termelékenységről. Ezt gyakran a naponta írt kódsorok számával mérik. De a munkája sokkal hasznosabb, ha egy bizonyos mennyiségű kódtól megszabadult, mert így kevesebb hely marad a hibák számára. És a kód ellenőrzése a legkönnyebb az első lépésben. Lehet, hogy egyáltalán nincs szüksége minden olyan funkcióra, amit próbál megvalósítani. A program egyszerűsítésének és az időmegtakarítás leggyorsabb módja az, hogy ne tegyen olyan dolgokat, amelyeket nem érdemes megtenni. A második lépés a második legtöbb lehetőséget kínálja az időmegtakarításra. Ha a termelékenységet a megírt kódsorok számában mérjük, akkor a feladat végrehajtásának módjának átgondolása kevésbé produktívvá fog tenni. mivel a feladatot kevesebb kódsorral oldhatja meg. Itt pontos statisztikát nem tudok megadni, mivel nincs mód arra, hogy megszámoljam azokat a kódsorokat, amelyeket nem írtam meg azért, mert időt szántam a specifikációra, azaz az első és második lépésekre. Kísérletet sem lehet végezni, mert a kísérletben nem szabad végrehajtani az első lépést, a feladat előre meghatározott.Az informális specifikációkban könnyű figyelmen kívül hagyni sok nehézséget. Nem nehéz szigorú specifikációkat írni a funkciókhoz, erről nem szeretnék beszélni. Ehelyett a standard viselkedési modellek szigorú specifikációinak megírásáról fogunk beszélni. Van egy tétel, amely kimondja, hogy bármely viselkedésmód csoportot le lehet írni a biztonsági tulajdonság segítségével
(safety) és a élénkségi tulajdonság segítségével (liveness) (liveness). A biztonság azt jelenti, hogy nem történik semmi rossz, a program nem ad hibás választ. A tartósság azt jelenti, hogy előbb vagy utóbb történik valami jó, azaz a program előbb vagy utóbb helyes választ ad. Általánosságban a biztonság fontosabb mutató, a hibák leggyakrabban itt jelentkeznek. Ezért az időmegtakarítás érdekében nem fogok a tartósságról beszélni, bár természetesen az is fontos.
A biztonságot úgy érjük el, hogy először is, számos lehetséges kiindulási állapotot írunk le. Másodszor, minden lehetséges következő állapotra vonatkozóan meghatározzuk a kapcsolatokat minden állapot esetén. Tudósként viselkedve matematikai módon meghatározzuk az állapotokat. A kiindulási állapotok halmazát egy képlettel írjuk le, például az Euklidesz-algoritmus esetében: (x = M) ∧ (y = N). Bizonyos értékek esetén M és N csak egy kiindulási állapot létezik. A következő állapotra való kapcsolat egy olyan képlettel van leírva, amelyben a következő állapot változói ékezetes írásmóddal, míg a jelenlegi állapot változói ékezet nélkül vannak. Az Euklidesz-algoritmus esetében két képletről van szó, az egyikben x a legnagyobb érték szerepel, a másikban pedig y:
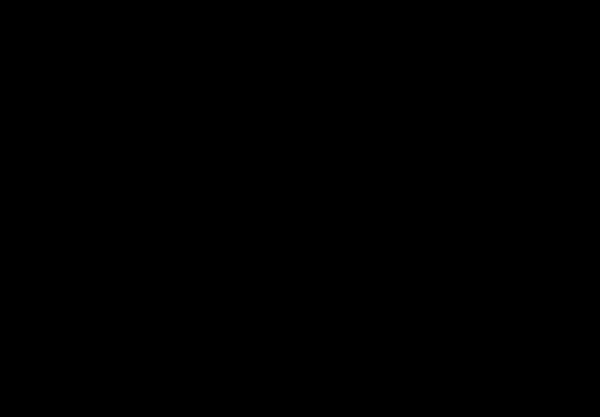
Az első esetben az új y értéke megegyezik a korábbi y értékével, az új x értéket pedig a nagyobb változóból a kisebbet levonva kapjuk. A második esetben fordítva járunk el.
Térjünk vissza az Euklidesz-algoritmushoz. Tegyük fel újra, hogy M = 12, N = 18. Ez meghatározza az egyetlen kiindulási állapotot, (x = 12) ∧ (y = 18). Ezután behelyettesítjük ezeket az értékeket a fenti képletbe és megkapjuk:
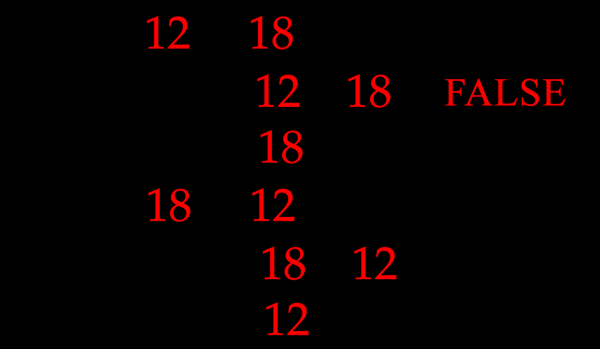
Itt az egyetlen lehetséges megoldás: x' = 18 - 12 ∧ y' = 12, és kapunk egy viselkedést: [x = 12, y = 18]. Hasonlóképpen minden állapotot leírhatunk viselkedésünkben: [x = 12, y = 18] → [x = 12, y = 6] → [x = 6, y = 6].
Az utolsó állapotban [x = 6, y = 6] mindkét kifejezés része hamis lesz, ezért nincs következő állapota. Tehát teljes specifikációt kaptunk a második lépésről — amint látjuk, ez teljesen szokványos matematika, ahogy mérnökök és tudósok is csinálják, nem valami furcsa, mint a számítástechnika területén.
Ezeket a képleteket egyetlen temporális logika képletté lehet egyesíteni. Elegáns, és a magyarázata sem nehéz, de most nincs idő rá. A temporális logikára csak a létfenntartás tulajdonsága miatt van szükség, a biztonsághoz nem szükséges. A temporális logika önmagában nem vonzó, nem teljesen szokványos matematikai terület, de a létfenntartás esetében szükséges rossznak számít.
Az Euklideszi algoritmusban minden értékhez x és y egyedi értékek tartoznak x' és y', amelyek a következő állapottal való kapcsolatot igaznak teszik. Más szavakkal, az Euklideszi algoritmus determinisztikus. Ahhoz, hogy egy nem-determinisztikus algoritmust modellezni tudjunk, a jelenlegi állapotnak több lehetséges jövőbeli állapottal kell rendelkeznie, és minden 'vonás nélküli' változó értéknek több 'vonásos' változó értéket kell adnia, amelyeken a következő állapottal való közvetlen kapcsolat igaz. Ezt nem nehéz megvalósítani, de most nem hozok példákat.
Működő eszköz létrehozásához formális matematika szükséges. Hogyan készíthetünk formális specifikációt? Ehhez szükségünk van egy formális nyelvre, például a . Az Euklideszi algoritmus specifikációja így fog kinézni ezen a nyelven:
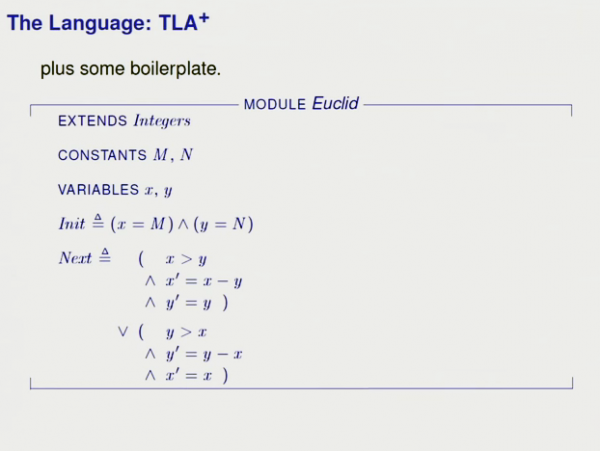
Az egyenlőség jele egy háromszöggel azt jelenti, hogy a jel bal oldalán található érték a jobb oldalon található értékkel egyenlőként van meghatározva. Lényegében a specifikáció egy meghatározás, a mi esetünkben két meghatározás. A TLA+ specifikációhoz deklarációkat és némi szintaxist kell hozzáadni, ahogyan a fenti dián is látható. ASCII formátumban így fog kinézni:
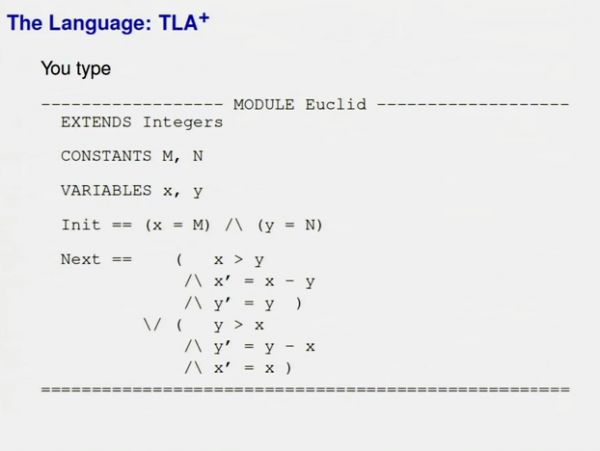
Ahogy látjuk, semmi bonyolult nincs benne. A TLA+ specifikációt ellenőrizhetjük, azaz bejárhatjuk az összes lehetséges viselkedést egy kis modellen. Az esetünkben ez a modell az adott értékekből fog állni. M és NEz egy nagyon hatékony és egyszerű ellenőrzési mód, amely teljesen automatikusan végrehajtható. Emellett írtunk formális bizonyításokat is az igazságosságról, és megnézhetjük őket gépiesen, de ez sok időt igényel, így ezt szinte senki sem teszi.
A TLA+ fő hátránya, hogy ez matematika, és a programozók, valamint a számítástechnikai szakemberek félnek a matematikától. Elsőre ez viccesen hangzik, de sajnos komolyan mondom. A kollégám most mesélte, hogyan próbálta elmagyarázni a TLA+-t néhány fejlesztőnek. Amint a képernyőn megjelentek a képletek, azonnal üveges tekintetük lett. Tehát, ha a TLA+ ijesztő, lehet használni , ez egyfajta játékprogramozási nyelv. A PlusCal kifejezése bármilyen TLA+ kifejezés lehet, tehát lényegében bármilyen matematikai kifejezés. Továbbá, a PlusCal szintaxisában szerepelnek nem determinisztikus algoritmusok is. Mivel a PlusCal bármilyen TLA+ kifejezést képes megjeleníteni, sokkal kifejezőbb, mint bármely valós programozási nyelv. Ezen túlmenően, a PlusCal könnyen olvasható TLA+ specifikációvá fordul. Ez nem jelenti azt, hogy a bonyolult PlusCal specifikációk egyszerűek lesznek TLA+-ban - csupán a kettő közötti megfelelés nyilvánvaló, nem fog extra bonyolultság keletkezni. Végül, ezt a specifikációt a TLA+ eszközeivel ellenőrizni lehet. Összességében a PlusCal segíthet legyőzni a matematika iránti fóbiaiát; a programozók és számítástechnikai szakemberek számára is könnyen érthető. Korábban körülbelül 10 évig publikáltam rajta algoritmusokat.
Lehet, hogy valaki azt mondja, hogy a TLA+ és a PlusCal matematika, és a matematika csak kitalált példákon működik. A gyakorlatban viszont valódi nyelvre van szükség, amely típusokkal, eljárásokkal, objektumokkal stb. rendelkezik. Ez nem igaz. Íme, mit mond Chris Newcomb, aki az Amazonnál dolgozott: „Tíz nagy projekt során használtuk a TLA+-t, és minden alkalommal jelentős hozzájárulást tett a fejlesztéshez, mert el tudtuk csípni a veszélyes hibákat, mielőtt azok a gyártásba kerültek volna, és mert megadta nekünk azt a megértést és magabiztosságot, amely szükséges a teljesítmény agresszív optimalizálásához, anélkül, hogy a program valódiságát befolyásolnánk.”Gyakran hallani, hogy a formális módszerek alkalmazásával nem hatékony kódot kapunk - a gyakorlatban viszont éppen ellenkezőleg van. Ezenkívül elterjedt a vélekedés, hogy a menedzsereket lehetetlen meggyőzni a formális módszerek szükségességéről, még akkor is, ha a programozók meggyőződtek a hasznosságukról. Newcomb pedig azt írja: A menedzserek most már minden módon arra ösztönöznek, hogy TLA+-ra specifikációkat írjunk, és kifejezetten időt is szánnak erre.Amikor a menedzserek látják, hogy a TLA+ működik, örömmel fogadják. Kris Newcomb ezt körülbelül hat hónappal ezelőtt (2014 októberében) írta, most viszont, amennyire tudom, a TLA+-t 14 projektben használják, nem csak 10-ben. Egy másik példa a XBox 360 tervezésével kapcsolatos. Charles Teckerhez jött egy gyakornok, aki specifikációt készített a memória rendszerhez. Ennek a specifikációnak köszönhetően felfedeztek egy hibát, amelyet egyébként nem vettek volna észre, és emiatt minden XBox 360 négy óra használat után leállt volna. Az IBM mérnökei megerősítették, hogy a tesztjeik nem fedezték volna fel ezt a hibát.
A TLA+-ról részletesebben olvashat az interneten, de most beszéljünk az informális specifikációkról. Ritkán írunk programokat, amelyek a legkisebb közös többszöröst számolják ki, és hasonló dolgokat. Sokkal gyakrabban írunk olyan programokat, mint például a strukturális nyomtató eszközt, amelyet a TLA+ számára írtam. A legkönnyebb feldolgozás után a TLA+ kódja így nézne ki:
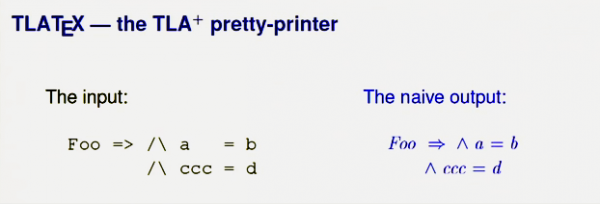
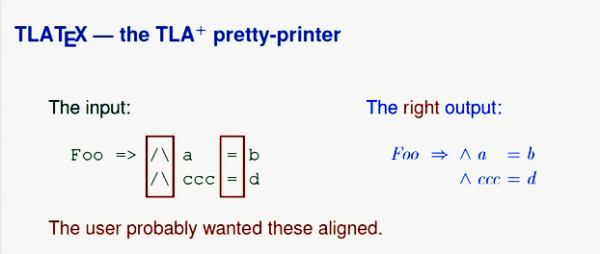
De a bemutatott példában a felhasználó valószínűleg azt akarta, hogy a konjunkciós és egyenlőségi jelek igazodjanak. Így a helyes formázás valószínűleg így nézne ki:
Nézzünk meg egy másik példát:
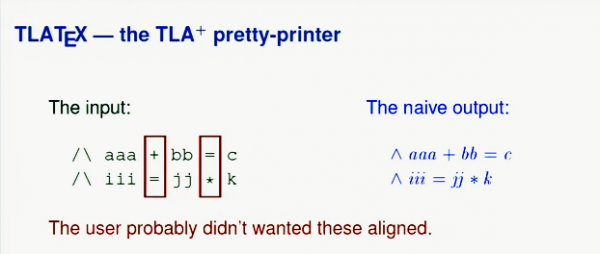
Itt épp ellenkezőleg, az egyenlőség, összeadás és szorzás jeleinek a forrásban való igazítása véletlenszerű volt, ezért a legkönnyebb feldolgozás teljesen elegendő. Összességében nem létezik pontos matematikai meghatározás a helyes formázásra, mert a 'helyes' itt azt jelenti, 'olyannak, amilyennek a felhasználó akarja', és ezt matematikailag nem lehet meghatározni.
Úgy tűnik, ha nincs igazság definíciónk, akkor a specifikáció haszontalan. De ez nem így van. Ha nem tudjuk, hogy pontosan mit kellene tennie a programnak, az nem jelenti azt, hogy nem kell alaposan átgondolnunk a működését - éppen ellenkezőleg, még több energiát kellene erre fordítanunk. Itt a specifikáció különösen fontos. Lehetetlenség meghatározni az optimális programot a strukturális nyomtatáshoz, de ez nem jelenti azt, hogy ezt ne kellene csinálnunk, és a kódot csak szabad áramlásként írni - ez nem helyénvaló. Végül egy hat szabályból álló specifikációt írtam, definíciókkal. kommentárok formájában. A Java fájlban. Íme egy példa egyik szabályra: a bal-megjegyzés token a LeftComment, amely a fedőtokennel összhangban van. Ez a szabály, mondjuk, matematikai angolul íródott: LeftComment összhangban, bal-megjegyzés és fedőtoken — a meghatározásokkal rendelkező kifejezések. Így írják le a matematikai problémákat: definiálják a kifejezéseket, és ezek alapján — szabályokat alkotnak. Az ilyen specifikáció előnye, hogy a hat szabály megértése és hibakeresése sokkal egyszerűbb, mint 850 sor kódé. Meg kell jegyezni, hogy a szabályok megírása nem volt egyszerű, elég sok időt töltöttem a hibakeresésükkel. Kifejezetten erre a célra írtam egy kódot, amely jelzi, hogy éppen melyik szabályt alkalmazom. Mivel ezeket a hat szabályt többször ellenőriztem példákon, nem kellett 850 sor kódot hibakeresnem, és a hibák megtalálása meglehetősen egyszerű volt. A Java számára ezen a téren kiváló eszközök állnak rendelkezésre. Ha csak a kódot írtam volna meg, akkor sokkal több időbe telt volna, és a formázás is rosszabb minőségű lett volna.
Miért nem lehetett formális specifikációt használni? Egyrészt a megvalósítás helyessége itt nem olyan fontos. A struktúrált nyomtatás biztosan valakinek nem tetszik, így nem kellett a helyes működést elérni minden rendkívüli helyzetben. Még fontosabb, hogy nem álltak rendelkezésemre megfelelő eszközök. A TLA+ modellek ellenőrzésére szolgáló eszköz itt haszontalan, így kézzel kellett volna példákat írnom.
A megadott specifikációnak vannak közös vonásai minden specifikációval. Magasabb szintű, mint a kód. Bármely nyelven megvalósítható. Az írásához haszontalan bármilyen eszköz vagy módszer. Egy programozási tanfolyam sem segít ennek a specifikációnak az elkészítésében. Nincsenek olyan eszközök, amelyek ezt a specifikációt feleslegessé tennék, hacsak nem írsz egy nyelvet, amely kifejezetten a TLA+ struktúrált nyomtatással kapcsolatos programok írására készült. Végül, ez a specifikáció nem mond semmit arról, hogyan fogjuk megírni a kódot, csupán azt jelzi, hogy mit csinál ez a kód. A specifikációt azért írjuk, hogy segítsen átgondolni a problémát, mielőtt a kódra összpontosítanánk.
De ennek a specifikációnak vannak olyan sajátosságai is, amelyek megkülönböztetik más specifikációktól. A többi specifikáció 95%-a jelentősen rövidebb és egyszerűbb:
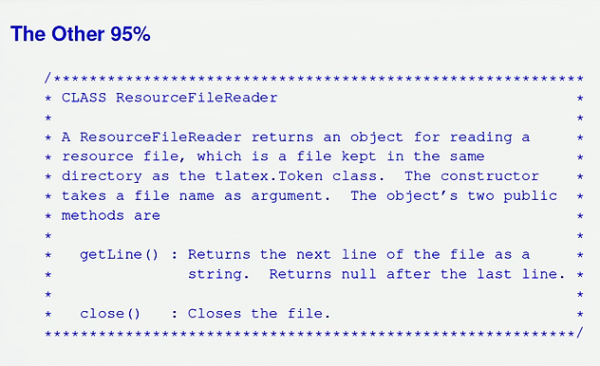
Ezek a specifikációk egy szabályrendszert képeznek. Általában ez a gyenge specifikáció jele. A szabályok következményeinek megértése meglehetősen nehéz, és ezért sok időt kellett töltenem a finomításukkal. Ennek ellenére ebben az esetben nem találtam jobb módszert.
Érdemes néhány szót szólni az olyan programokról, amelyek folyamatosan működnek. Általában párhuzamosan futnak, például operációs rendszerek vagy elosztott rendszerek. Nagyon kevesen képesek megérteni őket elméletben vagy papíron, és én nem tartozom közéjük, bár valaha ez sikerült. Ezért szükség van olyan eszközökre, amelyek ellenőrzik a munkánkat — például a TLA+ vagy a PlusCal.
Miért volt szükség specifikáció írására, ha tudtam, hogy a kód mit kell, hogy csináljon? Valójában csak úgy tűnt, hogy tudom. Ráadásul, ha van specifikáció, akkor egy külső személynek már nincs szüksége arra, hogy belemerüljön a kódba, hogy megértse, mit csinál. Van egy szabályom: nem lehetnek általános szabályok. Ennek a szabálynak természetesen van kivétele, ez az egyetlen általános szabály, amit követek: a kód működésének specifikációja meg kell, hogy mondja az embereknek mindent, amit tudniuk kell a kód használatához.
Tehát mit is kell a programozóknak tudniuk a gondolkodásról? Először is, amit mindenkinek tudnia kell: ha nem írsz, csak azt hiszed, hogy gondolkodsz. Ezen kívül, gondolkodni kell, mielőtt kódolnál, ami azt jelenti, hogy írni kell, mielőtt kódolnál. A specifikáció az, amit írunk, mielőtt elkezdenénk kódolni. A specifikáció szükséges minden olyan kódhoz, amelyet bárki felhasználhat vagy módosíthat. És az a „bárki” lehet magának a kód írójának is, egy hónappal a megírása után. A specifikáció szükséges nagyobb programokhoz és rendszerekhez, osztályokhoz, metódusokhoz, és néha még egy adott metódus bonyolult részeihez is. Mit is kell írni a kódról? Le kell írni, mit csinál, azaz azt, ami hasznos lehet bárki számára, aki ezt a kódot használja. Néha azt is meg kell adni, hogy a kód hogyan éri el a célját. Ha ezt a módszert a algoritmusok kurzusán tanultuk, akkor algoritmusnak nevezzük. Ha viszont ez valami különlegesebb és új, akkor azt magas szintű tervezésnek nevezzük. Formálisan nincs különbség: mindkettő egy absztrakt programmodellt jelent.
Hogyan kell pontosan megírni a kód specifikációját? A legfontosabb: annak egy szinttel feljebb kell lennie magánál a kódnál. Le kell írnia az állapotokat és viselkedéseket. Annyira szigorúnak kell lennie, amennyire a feladat megköveteli. Ha a feladat megvalósítási módszerének specifikációját írod, akkor azt írd meg pszeudokód segítségével vagy a PlusCal használatával. A specifikációk írását formális specifikációk alapján kell tanulni. Ez megadja azokat a szükséges készségeket, amelyek a nem formális specifikációknál is hasznosak lesznek. De hogyan tanuljunk meg formális specifikációkat írni? Amikor programozni tanultunk, programokat írtunk, majd ezeket hibakereséssel javítottuk. Ugyanez a helyzet itt is: a specifikációt meg kell írni, ellenőrizni kell egy modellellenőrző eszközzel, és javítani kell a hibákat. A TLA+ talán nem a legjobb nyelv a formális specifikációkhoz, és valószínűleg a te konkrét igényeidhez más nyelv jobban megfelel. A TLA+ előnye, hogy remekül tanít matematikai gondolkodásra.
Hogyan lehet összekapcsolni a specifikációt és a kódot? Kommentárok segítségével, amelyek összekötik a matematikai fogalmakat és azok megvalósítását. Ha gráfokkal dolgozik, akkor a program szintjén csomópontok tömbjei és kapcsolatok tömbjei lesznek. Ezért le kell írnia, hogy pontosan hogyan valósul meg a gráf ezekkel a programozási struktúrákkal.
Érdemes megjegyezni, hogy semmi az eddigiekből nem vonatkozik a kód írási folyamatára magára. Amikor kódot ír, tehát végrehajtja a harmadik lépést, akkor is gondolkodnia és átgondolnia kell a programot. Ha egy alfeladat bonyolultnak vagy nyilvánvalónak tűnik, akkor specifikációt kell írni hozzá. De itt a kódról nem beszélek. Bármilyen programozási nyelvet használhat, bármilyen módszertant, nem róluk van szó. Ezen kívül semmi az eddigiekből nem ment meg a kód tesztelésének és hibakeresésének szükségétől. Még ha az absztrakt modell helyesen is van megírva, a megvalósításban lehetnek hibák.
A specifikációk írása egy további lépés a kód írási folyamatában. Ennek köszönhetően sok hibát kevesebb erőfeszítéssel lehet felfedezni - ezt az Amazon programozóinak tapasztalata alapján tudjuk. A specifikációkkal a programok minősége javul. De akkor miért járunk annyiszor nélkülük? Mert nehéz írni. És nehéz írni, mert gondolkodni kellene, és az is nehéz. Mindig egyszerűbb úgy tenni, mintha gondolkodnánk. Itt párhuzamot vonhatunk a futással - minél kevesebbet fut, annál lassabban fog futni. Edzeni kell az izmait és gyakorolni kell az írást. Gyakorlatra van szükség.
A specifikáció téves lehet. Lehet, hogy valahol hibáztál, vagy a követelmények megváltoztak, vagy szükségessé vált a fejlesztés. Bármely kód, amit bárki használ, megváltozik, ezért előbb-utóbb a specifikáció el fog térni a programtól. Ideális esetben ilyenkor új specifikációt kellene írni és teljesen át kellene írni a kódot. Jól tudjuk, hogy ezt senki sem teszi. A gyakorlatban javítjuk a kódot, és esetleg frissítjük a specifikációt. Ha ez elkerülhetetlenül előbb-utóbb megtörténik, miért is írunk egyáltalán specifikációkat? Először is, akinek a kódodat módosítania kell, minden egyes felesleges szó a specifikációban aranyat ér, és ez az ember legjobban akár te magad is lehetsz. Gyakran kritizálom magam a hiányos specifikáció miatt, amikor javítom a kódot. Én több specifikációt írok, mint kódot. Ezért, amikor a kódot módosítod, mindig szükséges frissíteni a specifikációt. Másodszor, minden módosítással a kód egyre rosszabb lesz, egyre nehezebb lesz olvasni és karbantartani. Ez az entrópia növekedése. De ha nem kezded a specifikációval, akkor minden egyes írt sor módosítás lesz, és a kód már a kezdetektől fogva terjedelmes és nehezen olvasható lesz.
Ahogy mondta , egy csata sem lett megnyerve a terv szerint, és egy csata sem lett megnyerve terv nélkül.Ő tudott néhány dolgot a csatákról. Vannak, akik úgy vélik, hogy a specifikációk írása időpazarlás. Néha valóban így van, és a feladat annyira egyszerű, hogy nincs mit átgondolni. De mindig emlékezni kell arra, hogy amikor azt tanácsolják, hogy ne írj specifikációt, az azt jelenti, hogy azt tanácsolják, ne gondolkodj. Ezen mindig érdemes elgondolkodni. A feladat átgondolása nem garantálja, hogy ne kövess el hibákat. Ahogy tudjuk, varázspálcát senki sem talált fel, és a programozás bonyolult tevékenység. De ha nem gondolod át a feladatot, garantáltan hibákat fogsz elkövetni.
Több információt a TLA+ és a PlusCal témájában a speciális weboldalon lehet olvasni, ahová a főoldalamról lehet belépni. Ezen a ponton minden, köszönöm a figyelmet.
Emlékeztetem, hogy ez egy fordítás. Amikor megjegyzéseket ír, ne feledje, hogy az író nem fogja ezeket elolvasni. Ha valóban szeretne beszélgetni az íróval, ő a Hydra 2019 konferencián lesz, amely 2019. július 11-12-én kerül megrendezésre Szentpéterváron. A jegyek megvásárolhatók .
Forrás: habr.com
