

Ma arról beszélünk, hogyan tároljuk a legjobban az adatokat egy olyan világban, ahol az ötödik generációs hálózatok, a genomikai szkennerek és az önvezető autók naponta több adatot termelnek, mint amennyit az emberiség a ipari forradalom előtt valaha létrehozott.
A világunk egyre több információt generál. Egy része múló és olyan gyorsan elveszik, ahogy összegyűlik. Másokat hosszabb ideig kell tárolni, és egyesek kifejezetten „évezredekig” szólnak — legalábbis ez látszik a jelenlegi helyzetből. Az információs áramlatok olyan sebességgel ülnek le az adatközpontokban, hogy bármilyen új megközelítés vagy technológia, amely e végtelen „keresletet” szeretné kielégíteni, gyorsan elavul.
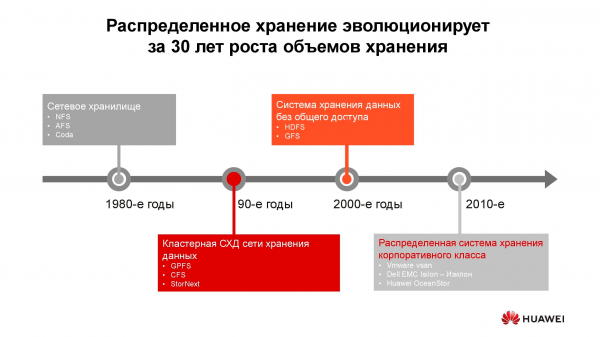
40 év a disztribúciós tároló rendszerek fejlődéséből
Az első hálózati tárolók a számunkra ismert formában az 1980-as években jelentek meg. Sokan közülük találkoztak az NFS (Network File System), AFS (Andrew File System) vagy a Coda rendszerekkel. Egy évtizeddel később a divat és a technológia megváltozott, a disztribúciós fájlrendszerek helyét a GPFS (General Parallel File System), CFS (Clustered File Systems) és StorNext alapú klaszter tárolók vették át. Alapként klasszikus architektúrájú blokk tárolókat használtak, amelyeken egy szoftverrétegen keresztül egy egységes fájlrendszert alakítottak ki. Ezeket és hasonló megoldásokat még mindig alkalmazzák, és megfelelő igényekkel bírnak.
A millennium határán a disztribúciós tárolók paradigmája némileg megváltozott, és a vezető szerepet a SN (Shared-Nothing) architektúrájú rendszerek vették át. Bekövetkezett az áttérés a klaszter tárolásról az egyes csomópontokon történő tárolásra, amelyek általában klasszikus szerverek voltak, megbízható tárolást biztosító szoftverrel; ilyen elvek alapján épültek fel például a HDFS (Hadoop Distributed File System) és a GFS (Global File System).
Közelebb a 2010-es évekhez a disztribúciós tároló rendszerek alapjául szolgáló koncepciók egyre inkább megjelentek a kibővített kereskedelmi termékek között, mint például a VMware vSAN, a Dell EMC Isilon és a mi . Ezek mögött a platformok mögött már nem egy lelkes közösség áll, hanem konkrét gyártók, akik felelősek a termék funkcionalitásáért, támogatásáért, szervizeléséért és garantálják további fejlődését. Ezek a megoldások a különböző területeken a legkeresettebbek.
Távközlési szolgáltatók
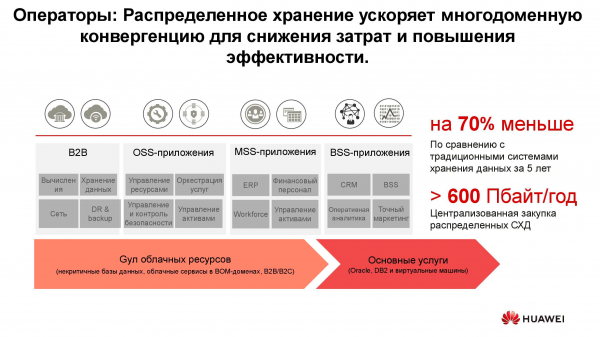
Valószínűleg az egyik legrégebbi felhasználók a elosztott tárolási rendszerek az telekommunikációs szolgáltatók. A diagramon látható, hogy mely alkalmazáscsoportok termelik a legnagyobb adatmennyiséget. Az OSS (Műveleti Támogató Rendszerek), MSS (Meneddzsment Támogató Szolgáltatások) és BSS (Üzleti Támogató Rendszerek) három, egymást kiegészítő szoftverréteget alkotnak, amelyek szükségesek a szolgáltatás nyújtásához az előfizetők számára, a szolgáltató pénzügyi elszámolásához és a mérnökök operációs támogatásához.
Gyakran ezeknek a rétegeknek az adatai erősen keverednek egymással, és hogy elkerüljük a felesleges másolatok felhalmozódását, pontosan ezért használják az elosztott tárolókat, melyek összegyűjtik az összes, a működő hálózattól érkező információt. A tárolók egy közös poolba kerülnek, amelyhez minden szolgáltatás hozzáfér.
Számításaink azt mutatják, hogy a klasszikus tárolórendszerekről a blokk alapú megoldásokra való átállás akár 70% -os költségmegtakarítást is eredményezhet, csupán az hi-end dedikált tárolók elhagyásával és a klasszikus architektúrájú (jellemzően x86) hagyományos szerverek használatával, amelyek speciális szoftverrel működnek együtt. A mobil szolgáltatók már viszonylag régóta vásárolják az ilyen megoldásokat jelentős mennyiségben. Különösen, az orosz szolgáltatók már több mint hat éve használják az ilyen termékeket a Huawei-től.
Igen, van néhány feladat, amelyet elosztott rendszerekkel nem lehet végrehajtani. Például, ha a teljesítményre vagy a régi protokollokkal való kompatibilitásra vonatkozó követelmények magasak. De az adatok legalább 70%-át, amelyet a szolgáltató kezel, teljes mértékben el lehet helyezni egy elosztott poolban.
Banki szektor
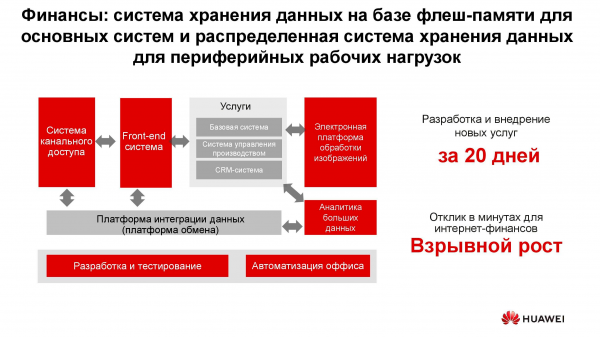
Bár egy bankban számos különböző informatikai rendszer működik, a folyamatkezeléstől kezdve a automatizált banki rendszerekig. Ez az infrastruktúra is hatalmas mennyiségű információval dolgozik, és a feladatok nagy része nem igényel magas teljesítményt és megbízhatóságot a tárolási rendszerekkel szemben, például a fejlesztés, tesztelés, irodai folyamatok automatizálása stb. Itt a klasszikus tárolórendszerek alkalmazása lehetséges, de évről évre egyre kevésbé jövedelmező. Ezenkívül ebben az esetben hiányzik a tárolórendszerek erőforrásainak rugalmas felhasználása, amelynek teljesítménye a csúcs terhelésből van kiszámítva.
Elosztott tárolórendszerek használatakor a csomópontok, amelyek valójában szokásos szerverek, bármikor átalakíthatók például szerverfarmmá, és számítási platformként felhasználhatók.
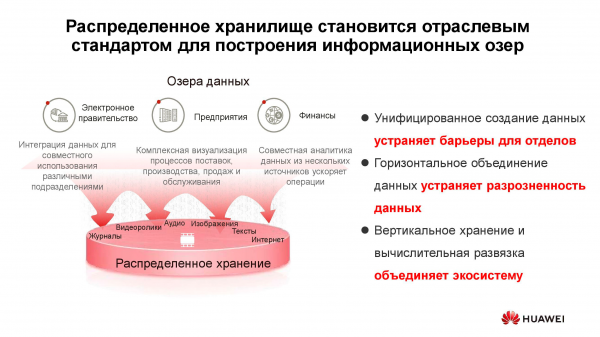
Adótavak
A fenti diagramon a szolgáltatások tipikus fogyasztói láthatók. . Ide tartozhatnak az elektronikus kormányzati szolgáltatások (például a "Kormányzati Szolgáltatások"), a digitalizált vállalatok, pénzügyi struktúrák stb. Mindannyian nagy mennyiségű heterogén információval dolgoznak.
A klasszikus tárolórendszerek alkalmazása ilyen feladatok megoldására nem hatékony, mivel mind magas teljesítményű hozzáférésre van szükség a blokkalapú adatbázisokhoz, mind pedig szokásos hozzáférésre a digitalizált dokumentumok könyvtáraihoz, amelyek objektumok formájában tárolódnak. Ide kapcsolódhat például a webportálon keresztüli megrendelési rendszer is. Ahhoz, hogy mindezt egy klasszikus tárolórendszeren valósítsuk meg, nagy számú eszköz szükséges különböző feladatokhoz. Egy horizontális univerzális tárolórendszer teljes mértékben le tudja fedni az összes korábban említett feladatot: csak néhány tárolási jellemzőkkel rendelkező tárolóterületet kell létrehozni benne.
Új információk generátorai
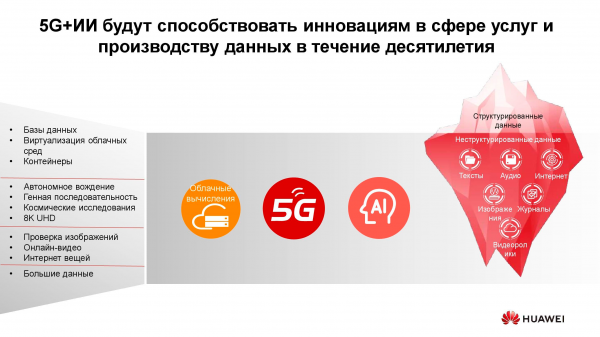
A világban tárolt információ mennyisége évente körülbelül 30%-kal növekszik. Ez jó hír a tárolórendszerek szolgáltatóinak, de mi volt és mi lesz a fő adatforrás?
Tíz évvel ezelőtt a közösségi média vált ilyen generátorokká, ami nagy számú új algoritmus, hardveres megoldás stb. létrehozását követelte meg. Jelenleg három fő növekedési hajtóerőt emelnek ki a tárolókapacitások között. Az első a felhőalapú számítástechnika. Jelenleg a vállalatok körülbelül 70%-a valamilyen módon felhőszolgáltatásokat használ. Ezek lehetnek elektronikus levelezőrendszerek, biztonsági mentések és más virtualizált entitások.
A második hajtóerő az ötödik generációs hálózatok. Ezek új sebességeket és új adatátviteli mennyiségeket jelentenek. Előrejelzéseink szerint az 5G elterjedése csökkenteni fogja a flash memóriakártyák iránti keresletet. Bármekkora memória is legyen a telefonban, az úgyis elfogy, és ha az eszközben 100 megabites csatorna áll rendelkezésre, akkor nincs szükség a fényképek helyi tárolására.
A harmadik csoport a tárolórendszerek iránti kereslet növekedésének okairól az mesterséges intelligencia gyors fejlődése, a big data analitika iránti átmenet és a teljes automatizálás trendje tartozik.
A "új forgalom" jellemzője, hogy . Ezeket az adatokat úgy kell tárolnunk, hogy nem definiáljuk a formátumot. Arra csak a későbbi olvasáshoz van szükség. Például egy banki hitelértékelő rendszer, amely megpróbálja meghatározni, hogy mekkora hitel állítható rendelkezésre, megnézi a közösségi oldalakon megosztott fényképeit, hogy kiderítse, gyakran jár-e a tengerhez vagy éttermekbe, és közben tanulmányozza az elérhető orvosi dokumentumait. Ezek az adatok egyfelől átfogóak, másfelől pedig homogén jellegűek.
Az strukturálatlan adatok óceánja
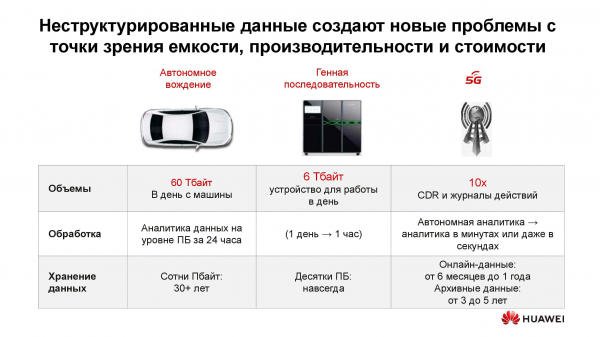
Milyen problémákat okoz az "új adatok" megjelenése? Az első és legfontosabb természetesen az információ mennyisége és a tárolás körüli számítási idő. Csak egy modern önálló autó, amelynek nincsen vezetője, naponta akár 60 TB adatot generál a különböző érzékelőiből és mechanizmusaiból. Az új mozgási algoritmusok kidolgozásához ezt az információt ugyanaznap el kell dolgozni, különben felhalmozódik. Ezenkívül nagyon hosszú ideig kell tárolni — több évtizedig. Csak így lehet a jövőben következtetéseket levonni nagy analitikai minták alapján.
Egyetlen készülék a genetikai szekvenciák dekódolására napi körülbelül 6 TB adatot termel. Az általa gyűjtött adatok ténylegesen nem feltételeznek törlést, tehát elvileg örökké tárolniuk kell.
Végül, ugyanezek az ötödik generációs hálózatok. Az átvitt információn kívül az ilyen hálózat önmaga is hatalmas adatgenerátor: eseménynaplók, hívásfelvételek, gépek közötti interakciók köztes eredményei stb.
Mindez új tárolási és információfeldolgozási megközelítések és algoritmusok kidolgozását igényli. Ilyen megközelítések már megjelentek.
Az új korszak technológiái
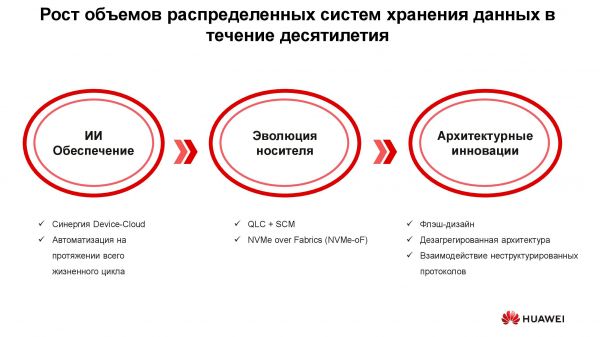
Három csoport megoldásait lehet kiemelni, amelyek célja a tárolórendszerek új követelményeinek kielégítése: a mesterséges intelligencia bevezetése, az adattárolók technikai evolúciója és az innovációk a rendszerarchitektúrában. Kezdjük az AI-jal.
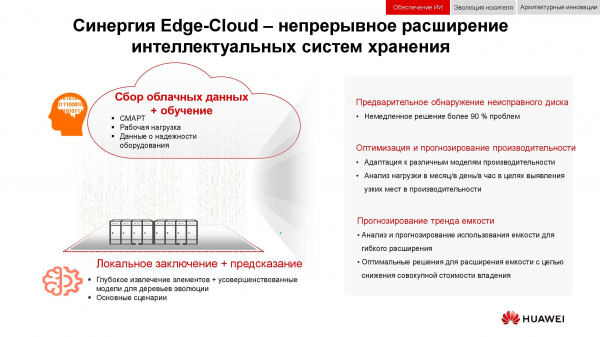
A Huawei új megoldásaiban a mesterséges intelligencia már a tároló szintjén is alkalmazásra kerül, egy AI-processzorral felszerelt rendszer lehetővé teszi a számítógép számára, hogy önállóan elemezze állapotát és előre jelezze a meghibásodásokat. Ha a tárolórendszert kapcsolják egy jelentős számítási kapacitással rendelkező felhőszolgáltatáshoz, a mesterséges intelligencia képes lesz több információt feldolgozni és növelni a hipotéziseinek pontosságát.
A meghibásodások mellett ez a mesterséges intelligencia képes előre jelezni a jövőbeli csúcs terhelést és az időt, amely a kapacitás kimerüléséig hátra van. Ez lehetővé teszi a teljesítmény optimalizálását és a rendszer skálázását még a nem kívánt események bekövetkezése előtt.
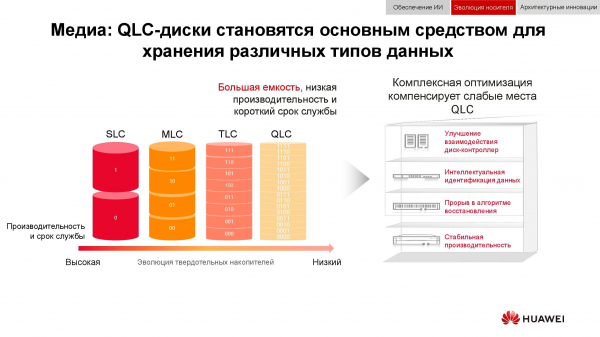
Most pedig a tárolóeszközök fejlődéséről. Az első flash-meghajtók SLC (Single-Level Cell) technológiával készültek. Az ezen alapuló eszközök gyorsak, megbízhatóak és stabilak voltak, de kis kapacitással rendelkeztek és nagyon drágák voltak. A kapacitás növelését és az ár csökkentését bizonyos technikai kompromisszumok révén érték el, amelyek miatt a meghajtók sebessége, megbízhatósága és élettartama csökkent. Ennek ellenére a trend nem befolyásolta magukat a tárolórendszereket, amelyek különböző architektúrás megoldások révén összességében teljesítményük és megbízhatóságuk szempontjából is javultak.
De miért volt szükség All-Flash tárolórendszerekre? Nem volt elég az, hogy egyszerűen a régi HDD-ket új SSD-re cseréljük ugyanazon a formátumon? Erre azért volt szükség, hogy hatékonyan kihasználjuk az új szilárdtest-meghajtók összes erőforrását, ami a régi rendszerekben egyszerűen lehetetlen volt.
A Huawei például ennek a problémának a megoldására számos technológiát dolgozott ki, ezek egyike lett a , amely lehetővé tette a "lemez — vezérlő" kapcsolatok maximális optimalizálását.
Az intelligens azonosítás lehetővé tette az adatok több szálra történő bontását, és foglalkozni tudott számos nem kívánt jelenséggel, mint például a (írási amplifikáció). Ugyanakkor az új helyreállító algoritmusok, különösen a , növelték a rebuild sebességét, csökkentve annak időtartamát elhanyagolható értékekre.
A meghibásodás, a túlterheltség és a "szemét összegyűjtése" — ezek a tényezők már nem befolyásolják a tárolórendszer teljesítményét a vezérlők speciális fejlesztése révén.
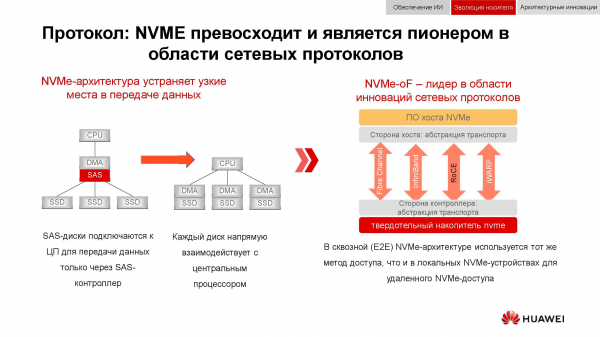
És még a blokkalapú adathordozók is készülnek a találkozóra. . Emlékeztetünk arra, hogy a klasszikus adat-hozzáférési szerkezet így működött: a processzor a PCI Express buszon keresztül fordult a RAID-vezérlőhöz. Ez viszont a mechanikai meghajtókkal a SCSI vagy SAS segítségével lépett kapcsolatba. Az NVMe alkalmazása a backend-en jelentősen felgyorsította az egész folyamatot, azonban volt egy hátránya: a meghajtóknak közvetlenül a processzorhoz kellett csatlakozniuk, hogy közvetlen hozzáférést biztosítsanak a memóriához.
A technológia következő fejlődési fázisa, amelyet most figyelhetünk meg, az NVMe-oF (NVMe over Fabrics) alkalmazása. Ami a Huawei blokkalapú technológiáit illeti, ezek már most támogatják az FC-NVMe-t (NVMe over Fibre Channel), és közel van az NVMe over RoCE (RDMA over Converged Ethernet) is. A tesztmodellek teljesen funkcionálisak, az hivatalos bemutatásukig néhány hónap van hátra. Megjegyezzük, hogy mindez meg fog jelenni a elosztott rendszerekben is, ahol az 'Ethernet veszteség nélkül' nagyon keresett lesz.
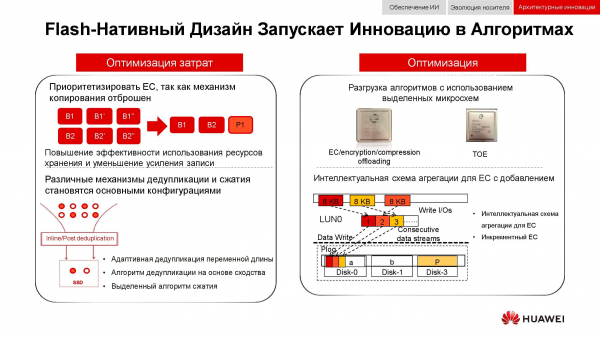
További mód a kifejezetten elosztott tárolók működésének optimalizálására a tükörképzéstől való teljes visszalépés. A Huawei megoldásai már nem használnak n másolatot, mint a megszokott RAID 1 esetén, és teljesen áttérnek a mechanizmusra. (kódolás elvesztés ellen). Egy speciális matematikai csomag meghatározott időközönként számolja ki a kontroll blokkot, amely lehetővé teszi az intermediális adatok helyreállítását azok elvesztése esetén.
A deduplikációs és tömörítési mechanizmusok kötelezővé válnak. Míg a klasszikus tárolók esetében a vezérlőkben telepített processzorok számában korlátozottak vagyunk, addig az elosztott, vízszintesen skálázható tárolórendszerek minden csomópontja tartalmazza a szükséges összes elemet: lemezeket, memóriát, processzorokat és interkonnektálást. Ezek az erőforrások elegendőek ahhoz, hogy a deduplikáció és a tömörítés minimalizálja a teljesítményre gyakorolt hatásukat.
És a hardveres optimalizálási módszerekre. Itt a központi processzorok terhelését sikerült csökkenteni további dedikált mikrochipek (vagy dedikált blokkok a processzorban) segítségével, amelyek szerepet játszanak. (TCP/IP offload engine) vagy amelyek matematikai feladatokat végeznek, például az EC, deduplikáció és tömörítés feladatait.
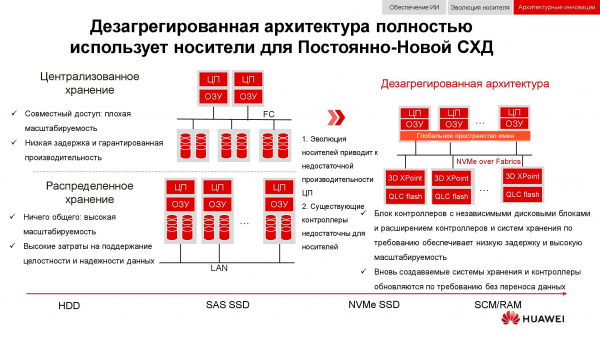
Az adatok tárolásának új megközelítései megvalósultak a dezintegrált (elágazó) architektúrában. A központosított tárolási rendszerekben van egy szervergyár, amely Fibre Channelen csatlakozik sok tárolóhoz. Ennek a megközelítésnek a hátrányai a skálázási nehézségek és a garantált szolgáltatási szint (teljesítmény vagy késleltetés) biztosításának problémái. A hiper-konvergens rendszerek ugyanazokat a hosztokat használják – tárolásra és adatfeldolgozásra egyaránt. Ez gyakorlatilag korlátlan skálázhatóságot biztosít, de jelentős költségeket von maga után az adatintegritás fenntartása.
A fent említett két architektúrától eltérően a dezintegrált architektúra azt jelenti, hogy a rendszert egy számítási gyárra és egy horizontális tárolórendszerre osztjuk. Ez ötvözi mindkét architektúra előnyeit, és lehetővé teszi, hogy csak azt az elemet skálázzuk gyakorlatilag korlátlanul, amelynek a teljesítménye hiányzik.
Az integrációtól a konvergenciáig
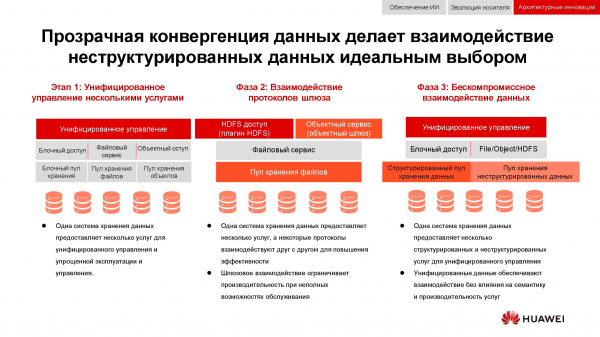
A klasszikus feladat, amelynek relevanciája az elmúlt 15 évben csak nőtt, az, hogy egyszerre biztosítani kell a blokkszintű tárolást, fájlhozzáférést, objektumhozzáférést, nagy adatfarmok működését stb. A torta tetején lehet olyan például a mágnescsíkos biztonsági mentési rendszer.
Az első szakaszban egyedül a szolgáltatások kezelésének egységesítése sikerült. A különböző adattárolási rendszerek egy specializált szoftverre voltak utalva, amelyen keresztül az adminisztrátor az elérhető tartalékokból osztotta el az erőforrásokat. Mivel azonban ezek a tartalékok hardveresen eltérőek voltak, a terhelés migrálása közöttük lehetetlen volt. Magasabb integrációs szinten a memória egyesítése a gateway szintjén történt. Közös fájlhozzáférés esetén azt különböző protokollokon keresztül lehetett biztosítani.
A számunkra jelenleg elérhető legfejlettebb konvergencia módszer egy univerzális hibrid rendszer létrehozására vonatkozik. Éppen olyanra, amilyenné a mi . Az univerzális hozzáférés ugyanazokat a hardverforrásokat használja, logikusan elkülönítve különböző halmazokba, de lehetővé teszi a terhelés migrálását. Mindezt egyetlen irányító konzolon keresztül lehet megvalósítani. Ezzel sikerült megvalósítanunk a "egy adatközpont - egy tárolórendszer" koncepciót.
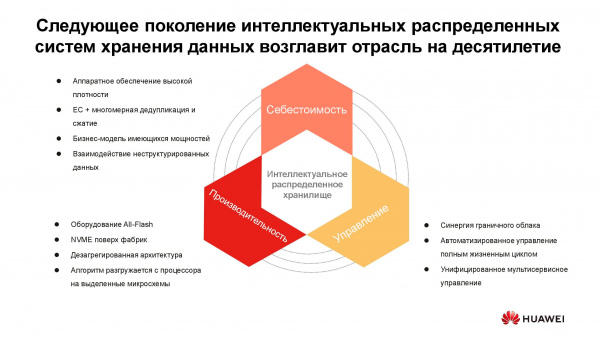
Az információ tárolásának költsége sok architektúra döntést meghatároz. Bár ezt bátran a középpontba helyezhetjük, ma a "valós idejű" tárolás aktív hozzáférésével foglalkozunk, ezért a teljesítményt is figyelembe kell venni. A következő generációs elosztott rendszerek egyik fontos tulajdonsága az egységesítés. Senki sem akar több, különálló rendszert, amelyeket különböző konzolokról kezelnek. Mindezek a tulajdonságok megvalósultak a Huawei új terméksorozatában. .
Új generációs masszív tárolórendszer
Az OceanStor Pacific megfelel a megbízhatóság követelményeinek a "hat kilenc" (99,9999%) szinten, és használható HyperMetro osztályú adatközpontok létrehozására. Két adatközpont közötti távolság esetén, maximum 100 km-en belül, a rendszerek további késleltetés szintje 2 ms, ami lehetővé teszi, hogy bármilyen katasztrófa-ellenálló megoldást építsenek ki rajtuk, beleértve a kvórum-szervereket is.
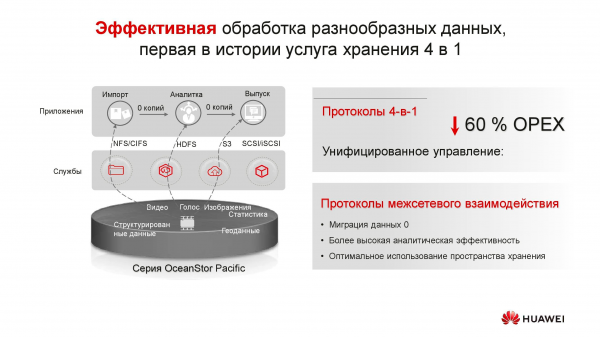
Az új sorozat termékei sokoldalúságot mutatnak a protokollok terén. Az OceanStor 100D már most támogatja a blokkhozzáférést, az objektumhozzáférést és a Hadoop hozzáférést. A közeljövőben fájlhozzáférés is bevezetésre kerül. Nincs szükség több adatpéldány tárolására, ha azokat különböző protokollokon keresztül lehet kiadni.
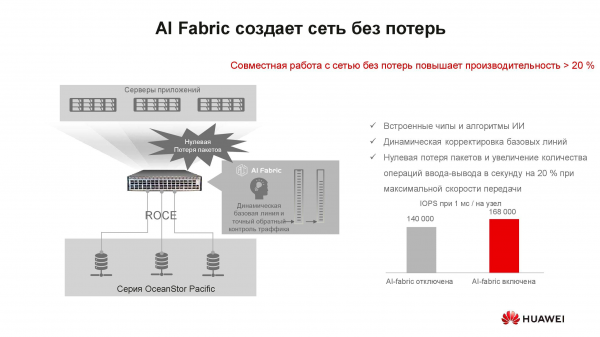
Úgy tűnhet, hogy a "veszteségmentes hálózat" koncepciónak mi köze van a tárolórendszerhez? Az a tény, hogy az elosztott adathorozó rendszerek gyors hálózaton épülnek fel, amely támogatja a megfelelő algoritmusokat és a RoCE mechanizmust. További sebességnövelés és késleltetés-csökkentés érhető el a váltóink által támogatott mesterséges intelligencia rendszer használatával. . A tárolórendszer teljesítménynövekedése az AI Fabric aktiválásával akár 20% is lehet.
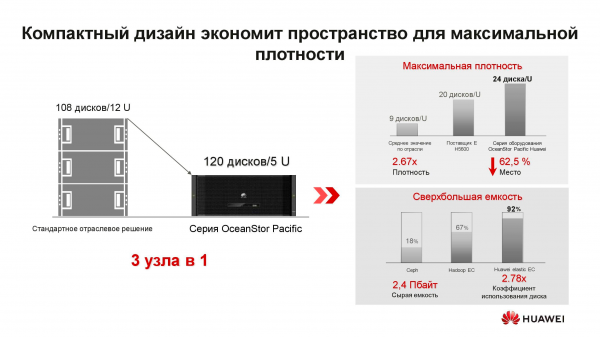
Mit jelent az új OceanStor Pacific elosztott tárolórendszer csomópont? Az 5U formátumban készült megoldás 120 meghajtót tartalmaz és három klasszikus csomópontot képes helyettesíteni, amely több mint kétszeres helymegtakarítást nyújt a rackben. A példányok tárolásának elhagyásával a meghajtók hatékonysága jelentősen nő (akár +92%).
Hozzászoktunk ahhoz, hogy a szoftveresen definiált tárolórendszer egy olyan speciális szoftver, amelyet egy klasszikus szerverre telepítenek. De most már a legoptimálisabb paraméterek eléréséhez ez az architekturális megoldás különleges csomópontokat is megkövetel. A rendszer két ARM processzor alapú szerverből áll, amelyek a három hüvelykes tárolók halmazát irányítják.
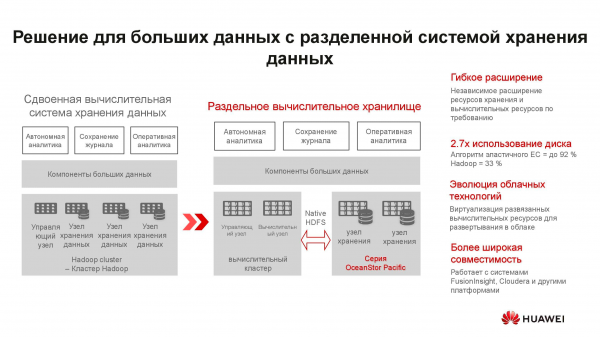
Ezek a szerverek alig alkalmasak a hiper-konvergált megoldásokhoz. Először is, az ARM alkalmazások száma meglehetősen korlátozott, másodszor pedig nehéz fenntartani a terhelés egyensúlyát. Javasoljuk, hogy váltsanak elválasztott tárolásra: a klasszikus vagy rack-szerverekből álló számítási klaszter külön működik, de csatlakozik az OceanStor Pacific tárolócsomópontokhoz, amelyek szintén ellátják közvetlen feladataikat. És ez indokolt.
Példaként vegyünk egy klasszikus megoldást az adatok nagy mennyiségű tárolására egy hiper-konvergált rendszerrel, amely 15 szerverhelyet igényel. Ha a terhelést külön számítási szerverek és az OceanStor Pacific tárolócsomópontok között osztjuk el és elkülönítjük őket, a szükséges helyek száma a felére csökken! Ez csökkenti az adatközpont üzemeltetési költségeit és elenyészővé teszi a teljes tulajdonlási költséget. Egy olyan világban, ahol a tárolt információ mennyisége évente 30%-kal nő, az ilyen előnyöket nem szabad félvállról venni.
***
További információkat a Huawei megoldásairól és azok alkalmazásának lehetőségeiről a weboldalon találhat, vagy közvetlenül a cég képviselőihez fordulhat.
Forrás: habr.com
