

Javaslom, hogy ismerkedjen meg Nikolaj Samohvalov "Ipari megközelítés a PostgreSQL tuningjához: kísérletek adatbázisokon" című előadásának kivonatával.
A shared_buffers = 25% – sok vagy kevés? Vagy éppen megfelelő? Hogyan lehet megérteni, hogy ez a – már elavult – ajánlás megfelelő-e az ön konkrét esetében?
Itt az idő, hogy a postgresql.conf beállításainak kiválasztásához "felnőtt" módon közelítsünk. Nem a vak "autotunerek" vagy elavult cikkek és blogok tanácsai alapján, hanem az alábbiak figyelembevételével:
- szigorúan ellenőrzött kísérletek az adatbázisokon, automatizált módon, nagy mennyiségben és olyan körülmények között, amelyek a lehető legközelebb állnak a "harci" állapotokhoz,
- az adatbázis-kezelő és az operációs rendszer működésének mélyreható megértésével.
A Nancy CLI segítségével (), konkrét példaként vizsgáljuk meg a hírhedt shared_buffers-t különböző helyzetekben, különböző projektekben, és megpróbáljuk kideríteni, hogyan választhatjuk ki az optimális beállítást az infrastruktúránk, az adatbázisunk és a terhelésünk számára.
Az adatbázisokon végzett kísérletekről lesz szó. Ez egy történet, amely körülbelül másfél éve tart.
Egy kicsit magamról. A Postgres-szel kapcsolatos tapasztalatom már több mint 14 év. Számos társadalmi hálózatot alapítottam, ahol a Postgres folyamatosan használatban van.
Továbbá a RuPostgres Meetup csoport, a világon a második. Fokozatosan közelítünk a 2000 fős létszámhoz. RuPostgres.org.
Részese vagyok különféle konferenciáknak, beleértve a Highload-ot is, ahol az adatbázisokért, különösen a Postgres-ért felelek a kezdetek óta.
Az utolsó néhány évben pedig újra elindítottam a Postgres konzultációs gyakorlatomat, 11 időzónában innen.
Amikor ezt néhány évvel ezelőtt megtettem, volt egy kis szünetem a Postgres-szel kapcsolatos aktív kézi munkában, valószínűleg 2010 óta. Meglepetten tapasztaltam, hogy mennyire alig változtak a DBA-k hétköznapjai, és mennyi kézi munkát kell még mindig végezni. Azonnal azt gondoltam, hogy itt valami nem stimmel, és többet kellene automatizálni.
Mivel mindezek távolról zajlottak, a legtöbb ügyfél a felhőkben volt. Már sok minden nyilvánvalóan automatizált. Erről kicsit később. Tehát ez az egész egy olyan eszközkészlet ötletéhez vezetett, ami egy platformot alkothatna, amely szinte minden DBA tevékenységet automatizál, lehetővé téve a nagy számú adatbázis kezelését.
Ebben az előadásban nem lesz:
- „Ezüst lövedékek” és olyan állítások, mint például – állítsa be a 8 GB-ot vagy 25% shared_buffers-t, és minden rendben lesz. A shared_buffers-rel nem lesz túl sok szó.
- Hardcore „belső részek“.
Mi fog történni?
- Lesznek optimalizálási elvek, amelyeket alkalmazunk és fejlesztünk. Lesznek különféle ötletek, amelyek az utunk során merülnek fel, és különböző eszközök, amelyeket többnyire Open Source-ben készítünk, azaz az alapokat Open Source-ban készítjük. Ráadásul a ticketek, szinte minden kommunikációnk Open Source-ban folyik. Nyomon követheti, hogy mit csinálunk éppen, mi várható a következő kiadásban stb.
- Valamint tapasztalataink lesznek ezen elvek és eszközök alkalmazásáról számos cégnél: kis startupoktól a nagy vállalatokig.
Hogyan fejlődik mindez?
Először is, a DBA fő feladata, hogy a példányok létrehozását, a biztonsági mentések telepítését stb. biztosítsa – a szűk keresztmetszetek felkutatása és a teljesítmény optimalizálása mellett.
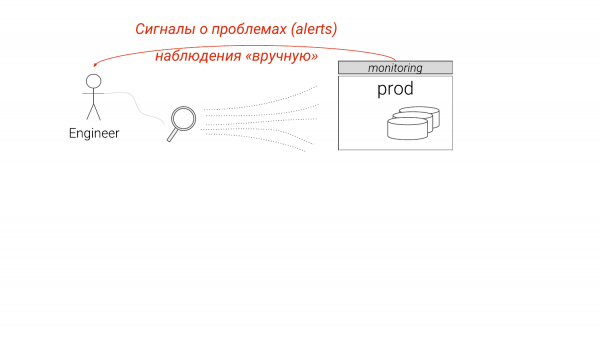
Most így van ez megszervezve. Figyeljük a monitorozást, látunk valamit, amiből hiányzik néhány részlet. Kezdünk mélyebben beleásni, általában kézzel, és próbáljuk megérteni, mit kell kezdeni vele így vagy úgy.
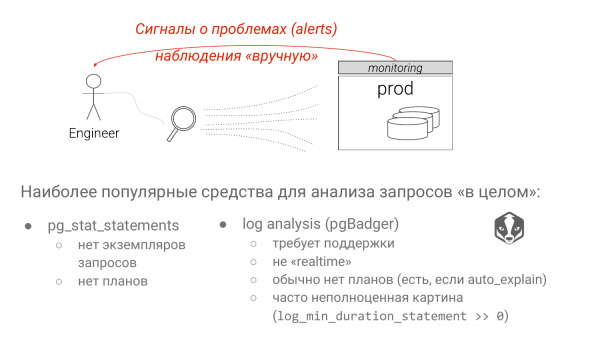
Két megközelítés létezik. A Pg_stat_statements – alapértelmezett megoldás a lassú lekérdezések azonosítására. És a Postgres naplók elemzése a pgBadger segítségével.
Mindkét megközelítésnek komoly hátránya van. Az első megközelítésnél minden paraméter ki van zárva. És ha látunk olyan SELECT * FROM table where oszlop = „?” vagy „$” csoportokat, a Postgres 10-es verziója óta, nem tudjuk, hogy index scan vagy seq scan. Nagyon nagyban függ a paramétertől. Ha ritkán előforduló értéket helyettesít, index scan lesz. Ha olyan értéket helyettesít, amely a táblázat 90%-át teszi ki, nyilvánvalóan seq scan, mert a Postgres tud a statisztikákról. Ez a pg_stat_statements nagy hátránya, bár folynak bizonyos munkák.
A naplók elemzésének legnagyobb hátránya, hogy általában nem engedheti meg magának a „log_min_duration_statement = 0” beállítást. Erről is beszélni fogunk. Ennek megfelelően nem látja a teljes képet. És egy nagyon gyors lekérdezés óriási mennyiségű erőforrást használhat, de nem fogja látni, mert az az Ön küszöbe alatt van.
Hogyan oldják meg a DBA-k a felfedezett problémákat?
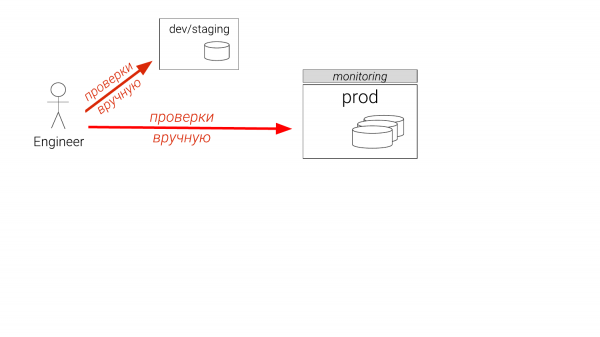
Például találtunk egy problémát. Mit szoktak ilyenkor tenni? Ha te fejlesztő vagy, akkor valamit fogsz csinálni egy olyan példányon, amely nem akkora. Ha te DBA vagy, akkor van staginged. De abból csak egy létezik, és az már fél éve le van maradva. Te pedig azt gondolod, hogy eljöhetsz a productionra. Még a tapasztalt DBA-k is utólag ellenőrzik a productiont, a másolaton. Néha ideiglenes indexet hoznak létre, megbizonyosodnak arról, hogy segít, majd törlik, és átadják a fejlesztőknek, hogy a migrációs fájlokba beépíthessék. Ilyen ostobaságok történnek most. És ez baj.
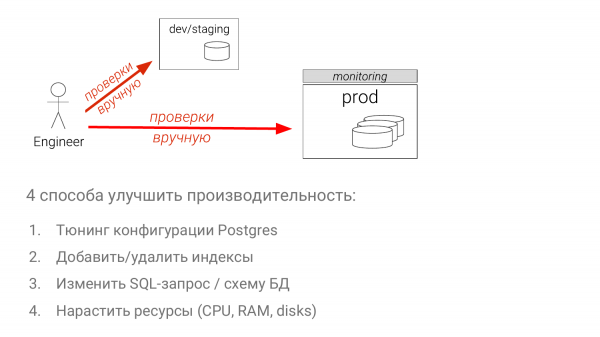
- Finomítani a konfigurációkat.
- Optimalizálni az indexek készletét.
- Megváltoztatni magát az SQL-lekérdezést (ez a legnehezebb módszer).
- További erőforrásokat hozzáadni (ez a legkönnyebb módszer a legtöbb esetben).
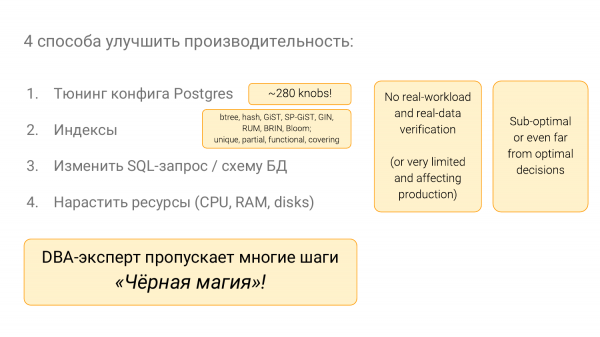
Ezekkel a dolgokkal nagyon sok minden foglalkozik. Sok dolog van a Postgresben. Sok mindent tudni kell. Sok index van a Postgresben, részben a konferencia szervezőinek köszönhetően. Ezt mind tudni kell, és éppen ez váltja ki a DBA-kban azt az érzést, hogy a DBA-k feketemágiát űznek. Azaz körülbelül 10 évet kell foglalkozni a dologgal, hogy az ember normálisan kezdhessen érteni mindehhez.
Én pedig harcolok ezzel a feketemágiával. Azt szeretném, hogy legyen technológia, és ne intuíció mindenben.
Példák az életből
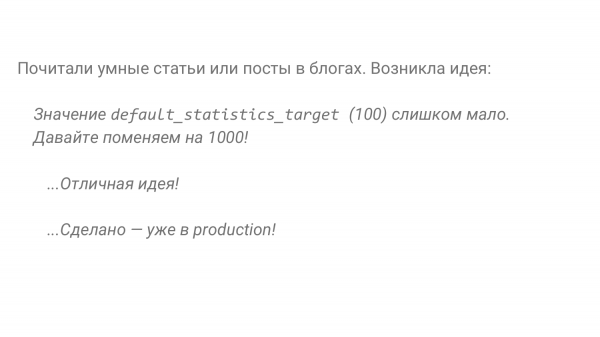
Legalább két projektben tapasztaltam ezt, beleértve a sajátomat is. Egy új bejegyzés a blogban azt mondja nekünk, hogy az 1 000-es érték a default_statistic_targethez – ez jó. Rendben, próbáljuk ki productionban.
És itt van, használva a két éve lévő eszközünket az adatbázisok kísérletei révén, amelyekről ma szó van, össze tudjuk hasonlítani, hogy mi volt és mi lett.
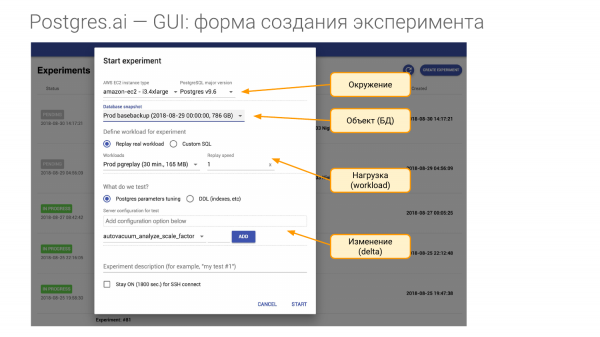
Ehhez kísérletet kell létrehoznunk. Ez négy részből áll.
- Az első – a környezet. Szükségünk van hardverre. Amikor bármilyen céghez megyek és szerződést kötök, azt mondom, hogy olyan hardvert kérnék, mint ami a productionben van. Minden Mesterednek szüksége van legalább egy olyan hardverre. Vagy ez egy Amazonban vagy Google-ben lévő virtuális gép példány, vagy nekem ilyen hardverre van szükségem. Azaz meg akarom reprodukálni a környezetet. A környezet fogalmába beletartozik a Postgres főverzió.
- A második rész – a kutatásaink tárgya. Ez az adatbázis. Különböző módszerekkel létrehozható. Meg fogom mutatni, hogyan.
- A harmadik rész – a terhelés. Ez a legnehezebb pillanat.
- A negyedik rész az, amit ellenőrzünk, azaz hogy mit mivel összehasonlítunk. Tegyük fel, hogy a konfigurációban egy vagy több paramétert megváltoztathatunk, vagy indexet hozhatunk létre stb.
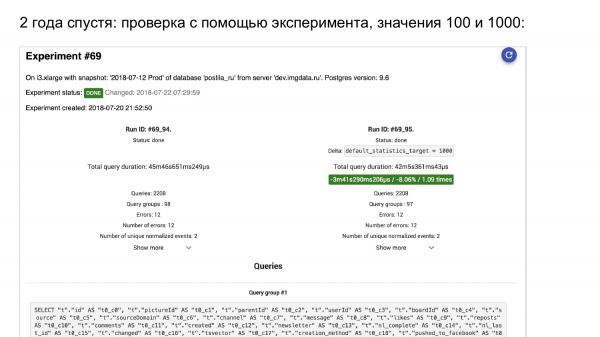
Kísérletet indítunk. Itt van a pg_stat_statements. Bal oldalon az, ami volt. Jobb oldalon az, ami lett.
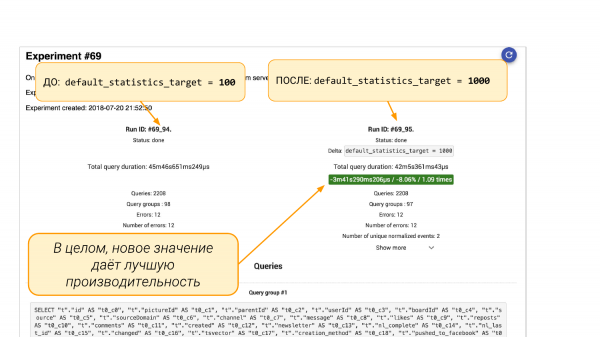
Bal oldalon default_statistics_target = 100, jobbra = 1 000. Látjuk, hogy ez segített. Összességében 8%-kal jobb lett.
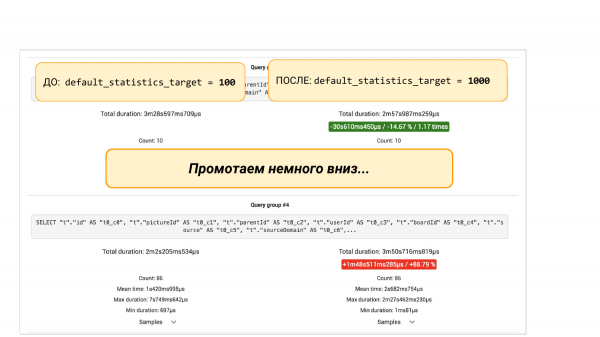
De ha lefelé gördítjük, akkor ott csoportos kérések lesznek a pgBadgerből vagy a pg_stat_statementsből. Két lehetőség van. Látni fogjuk, hogy egy kérés 88%-kal csökkent. Itt már mérnöki megközelítésra van szükség. Tovább mélyebben kell vizsgálódnunk, mert érdekes, hogy miért csökkent. Meg kell érteni, hogy mi történt a statisztikákkal. Miért a több vödör a statisztikában rosszabb eredményhez vezet.
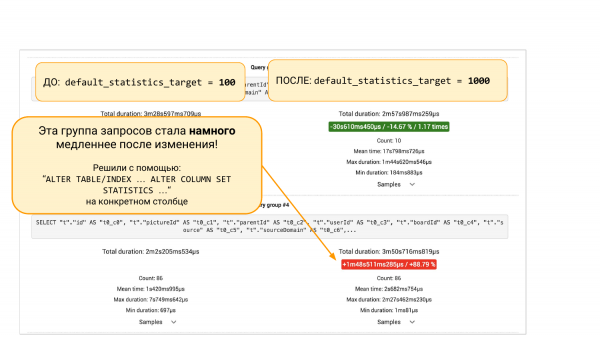
Vagy mélyebb kutatás nélkül egyszerűen végrehajthatunk egy „ALTER TABLE … ALTER COLUMN” parancsot, és visszaállíthatjuk 100 vödröt ennek az oszlopnak a statisztikájában. És további kísérlettel meggyőződhetünk arról, hogy ez a javítás segített. Ennyi. Ez egy mérnöki megközelítés, amely segít a helyzet megértésében és az adatok alapján történő döntéshozatalban, nem pedig az intuíció alapján.
Pár példa más területekről. A tesztek között már sok éve vannak CI-tesztek. És egyetlen projekt sem élhet józan ésszel automatikus tesztek nélkül.
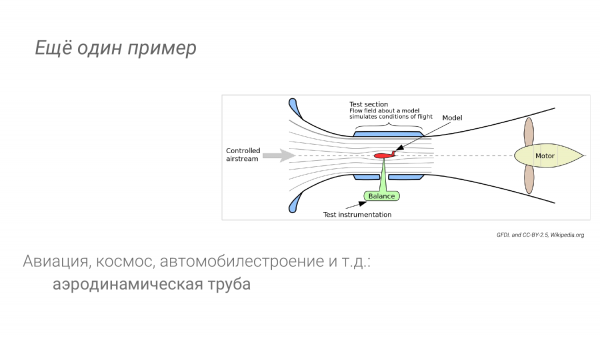
Más iparágakban: a repülésben, az autógyártásban, amikor a aerodinamikát teszteljük, nekünk is van lehetőségünk kísérletek végrehajtására. Nem fogunk azonnal rajz alapján fellőni valamit az űrbe, és nem fogunk azonnal kiállítani egy autót az autópályára. Például van aerodinamikai csatornánk.
Más iparágak megfigyeléseiből következtetéseket vonhatunk le.
Először is, van egy speciális környezet. Közel áll a produkcióhoz, de nem annyira. Fő jellemzője, hogy olcsónak, ismételhetőnek és maximálisan automatizáltnak kell lennie. És speciális eszközöknek is lennie kell a részletes elemzés lebonyolítására.
Valószínűleg, amikor a repülőt elindítottuk és repülünk, kevesebb lehetőségünk van a szárny felületének minden milliméterét tanulmányozni, mint a légcsatornában. Több diagnosztikai eszköz áll rendelkezésünkre. Megengedhetjük magunknak, hogy több nehéz dolgot szereljünk fel, amit nem engedhetünk meg magunknak a levegőben lévő repülőn. Ugyanez a helyzet a Postgres-szel is. Bizonyos esetekben engedélyezhetjük a teljes lekérdezési naplózást kísérletezés közben. Ezt a produkciós környezetben nem szeretnénk megtenni. Talán a terveink között szerepel az auto_explain segítségével való engedélyezése.
Ahogy már mondtam, a magas automatizáltsági szint azt jelenti, hogy megnyomtuk a gombot és megismételtük. Így kell lennie, hogy sok kísérlet legyen, hogy folyamatosan áramoljon.
Nancy CLI – az „adatbázislabor” alapja
Íme, létrehoztunk egy ilyet. Tehát ezekről az ötletekről már júniusban beszéltem, majdnem egy éve. Már van egy úgynevezett Nancy CLI a nyílt forráskódú környezetben. Ez az alapja az adatbázislabor felépítésének.
— Ez nyílt forráskódú, a Gitlab-on. Elmondhatod, kipróbálhatod. Adtam egy linket a diákban. Arra rákattintva elérhető. minden paraméter szerint.
Természetesen sok minden még fejlesztés alatt áll. Sok ötlet van. De már ez az, amit szinte nap mint nap alkalmazunk. Amikor felmerül egy ötlet – például, hogy miért akadtunk el IO-ra 40 000 000 sor törlésekor, kísérletet végezhetünk és alaposabban megvizsgálhatjuk, hogy mi történik, és próbálhatjuk azt azonnal javítani. Tehát kísérletet csinálunk. Például módosítunk valamit és nézzük, mi az eredmény. Ezt pedig nem a produkcióban tesszük. Ez az alapgondolat.
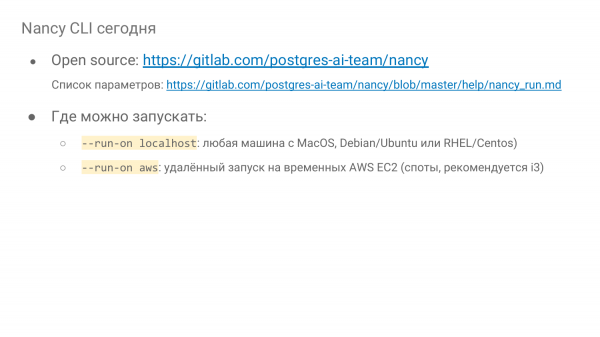
Hol működhet ez? Helyben működhet, tehát bárhol végezhetjük, akár MacBook-on is elindítható. Szükséges a Docker, indulhatunk. És kész. Indítható bármilyen instance-ben, az eszközön vagy virtuális gépen, bárhol.
Van még lehetőség távoli indításra az Amazon EC2 Instance keretein belül, a spotokban. Ez egy nagyon klassz lehetőség. Például tegnap több mint 500 kísérletet végeztünk i3 instance-en, a legkisebbtől kezdve az i3-16-xlarge-ig. Az 500 kísérlet összesen 64 dollárba került. Mindez 15 percig tartott. Tehát a spotok használatának köszönhetően nagyon olcsó – 70%-os kedvezmény, per másodperces számlázás az Amazontól. Nagyon sok mindent el lehet végezni. Igazi kutatásokat lehet folytatni.
Három fő verzióját támogatja a Postgres. Nem túl nehéz kiegészíteni néhány régi verziót, és az új 12-es verziót is.
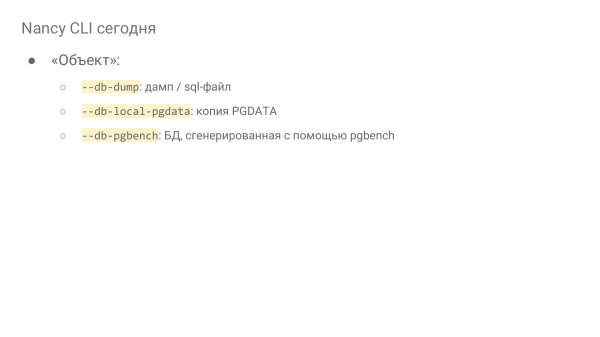
Az objektumot három módon lehet megadni. Ezek:
- Dump/sql fájl.
- A fő mód a PGDATA könyvtár klónozása. Általában a mentési szerverből szokták venni. Ha normális bináris mentéseid vannak, akkor onnan tudsz klónokat készíteni. Ha felhőd van, akkor ezeket a felhőszolgáltató, például az Amazon vagy a Google, automatikusan elvégzi. Ez a legfontosabb módszer éles környezet klónozására. Mi így telepítjük.
- Az utolsó módszer kutatásokra alkalmas, amikor szeretnénk megérteni, hogyan működik valami a Postgresben. Ez a pgbench. A pgbench segítségével generálhatsz terhelést. Ez csak egy opció, a "db-pgbench". Megmondod neki, mekkora skáláról van szó. Minden a felhőben lesz generálva, ahogy mondták.
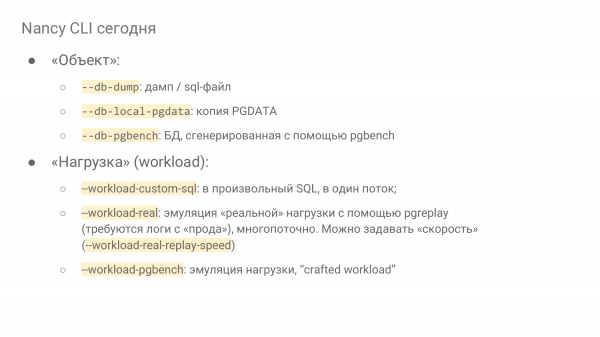
És a terhelés:
- A terhelést egy szálon SQL utasítások végrehajtásával tudjuk végezni. Ez a legprimitívebb mód.
- De emulálhatjuk a terhelést is. Az emulációt elsősorban úgy tudjuk végezni, hogy minden naplót gyűjtünk. Ez fájdalmas. Megmutatom, miért. A pgreplay segítségével játszuk le, amely be van építve Nancy-ba.
- Vagy egy másik lehetőség. Az úgynevezett kézműves terhelés, amelyet bizonyos erőfeszítések árán végzünk. A termelési rendszerünk aktuális terhelésének elemzésével kiemeljük a legjobb lekérdezéseket. A pgbench segítségével tudjuk emulálni ezt a terhelést a laborban.
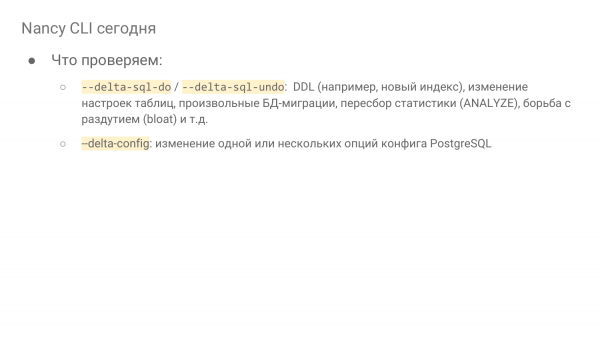
- Vagy végre kell hajtani valamilyen SQL utasítást, azaz ellenőrizni kell egy migrációt, létre kell hozni egy indexet, végre kell hajtani egy ANALYZE-t. És megnézzük, mi volt a vákuum előtt és után. Általában bármilyen SQL.
- Vagy a konfigurációban módosítunk egy vagy több paramétert. Meg tudjuk mondani, hogy például ellenőrizzék 100 értékünket az Amazonon a terabájtos adatbázisunkhoz. És néhány órán belül meg lesz az eredmény. Jellemzően a terabájtos adatbázist néhány órán belül fogjuk telepíteni. De a fejlesztésben van egy javítás, van lehetőségünk sorozatra, azaz egy és ugyanazon a szerveren használhatjuk ugyanazt a pgdata-t, és ellenőrizhetjük. A Postgres újraindul, a cache-ek törlődnek. És terhelést végezhetünk.
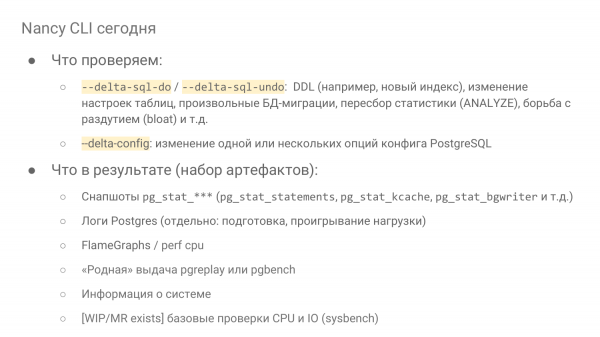
- Megérkezik a könyvtár, amely tele van különféle fájlokkal, kezdve a pg snapshotoktól.stat***. És itt a legérdekesebb a pg_stat_statements, pg_stat_kcache. Ezek két kiterjesztés, amelyek elemzik a lekérdezéseket. A pg_stat_bgwriter nemcsak a pgwriter statisztikáit tartalmazza, hanem a checkpoint adatait is, és azt, hogy a háttérfolyamatok hogyan képesek eltüntetni a koszos puffereket. Ezek mind nagyon érdekesek megnézni. Például, amikor beállítjuk a shared_buffers értéket, nagyon érdekes látni, hogy hányat képesek eltüntetni.
- A Postgres naplói is megérkeznek. Két napló van – a felkészülési napló és a terhelési napló.
- Viszonylag új funkció – FlameGraphs.
- Ha használtad a pgreplay vagy pgbench terhelésvisszajátszási lehetőségeit, akkor a natív kimenetük is látható lesz. Akkor látni fogod a latency-t és a TPS-t. Meg lehet érteni, hogy ők hogyan látták ezt.
- Rendszerinformáció.
- Alapvető CPU és IO ellenőrzések. Ez inkább az EC2 példányokhoz az Amazonban, amikor 100 azonos példányt akarsz egyszerre futtatni, és 100 különböző futást végezni, akkor 10 000 kísérleted lesz. Meg kell győződnöd arról, hogy nem akadtál bele egy hibás példányba, amelyet már valaki domesztikált. Ezen a hardveren mások is aktívak, és neked kevés marad az erőforrásaiból. Az ilyen eredményeket érdemes eldobni. Segítségével Alexey Kopytov sysbench-jével végzünk néhány rövid ellenőrzést, amely megérkezik, és össze lehet hasonlítani a többi helyett, azaz megérted, hogyan viselkedik a CPU és hogyan viselkedik az IO.
Milyen technikai nehézségek vannak különböző cégeknél?
Tegyük fel, hogy valós terhelést akarunk visszaállítani a naplók segítségével. Kiváló ötlet, ha ez az Open Source pgreplay-en van írva. Mi ezt használjuk. De hogy jól működjön, aktiválni kell a teljes lekérdezésnaplózást paraméterekkel és időzítéssel.
Vannak némi nehézség a duration és timestamp körül. Ezt a témát most elhagyjuk. A fő kérdés az, hogy megengedheti-e magának, vagy nem?
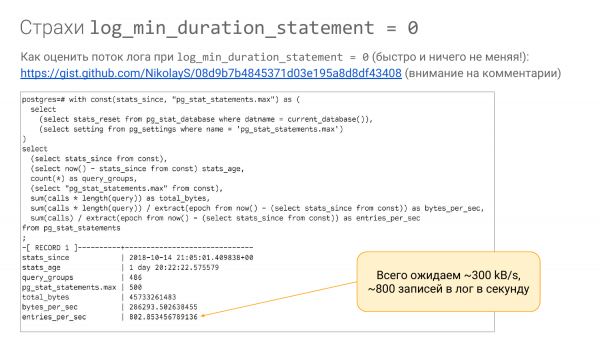
A probléma az, hogy ez lehet, hogy nem elérhető. Először is meg kell értenie, hogy milyen adatfolyamot fognak a naplóba írni. Ha van pg_stat_statements, ezzel a lekérdezéssel (a hivatkozás elérhető lesz a diáknál) megértheti, hogy körülbelül hány bájt fog másodpercenként írni.
A lekérdezés hosszát nézzük. Figyelmen kívül hagyjuk, hogy nincsenek paraméterek, de tudjuk a lekérdezés hosszát és azt, hogy hányszor hajtották végre másodpercenként. Így körülbelül meg tudjuk becsülni, hogy hány bájtot fogunk másodpercenként írni. Lehet, hogy tévedünk kétszer is, de a rangsorunkat pontosan fogjuk tudni így megállapítani.
Látjuk, hogy másodpercenként 802 alkalommal fut le ez a lekérdezés. És azt is látjuk, hogy a bytes_per_sec – 300 kB/s körül fog íródni. Általában pedig ezt a terhelést meg tudjuk engedni magunknak.
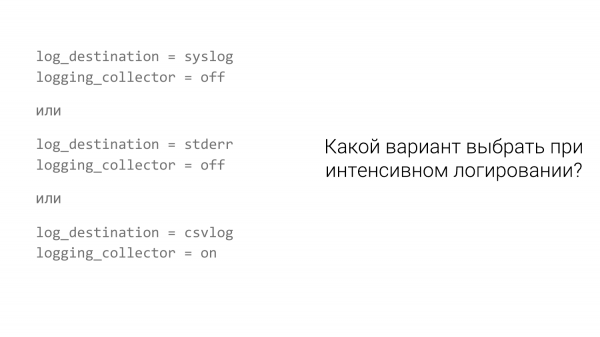
De! A helyzet az, hogy különböző naplózó rendszerek léteznek. Az emberek általában alapértelmezetten a 'syslog'-ot használják.
Ha van syslog, akkor ilyen képet kaphat. Használni fogjuk a pgbenchet, bekapcsoljuk a lekérdezések naplózását, és megnézzük, mi történik.
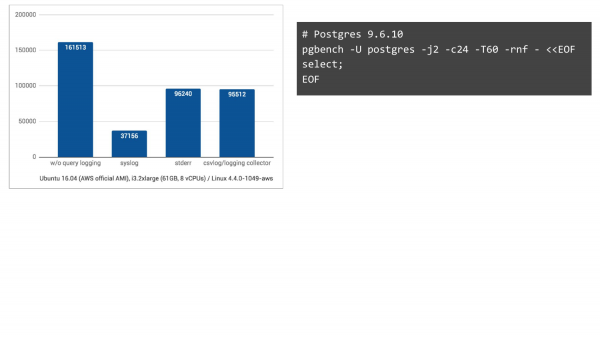
Naplózás nélkül – ez a baloldali oszlop. 161 000 TPS-t értünk el. Syslog-gal – ez Ubuntu 16.04 alatt az Amazonon 37 000 TPS. Ha pedig átállítjuk két másik naplózási módra, akkor sokkal jobb a helyzet. Vártuk, hogy csökkenni fog, de nem ennyire.
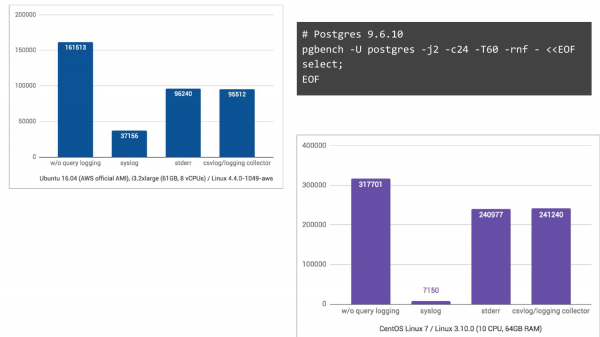
CentOS 7 alatt, ahol a journald is részt vesz, a naplókat bináris formátumba alakítva a kényelmes keresés érdekében, ott egy rémálom, 44-szeres TPS csökkenés tapasztalható.
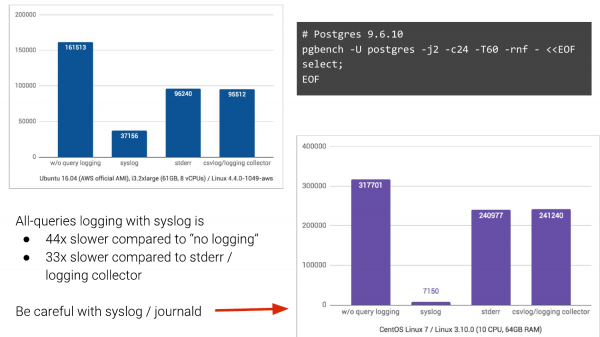
Ez az, amivel az emberek élnek. És a nagyobb cégeknél gyakran nagyon nehéz megváltoztatni. Ha tud elhagyni a syslog-ot, akkor kérem, hagyja el.
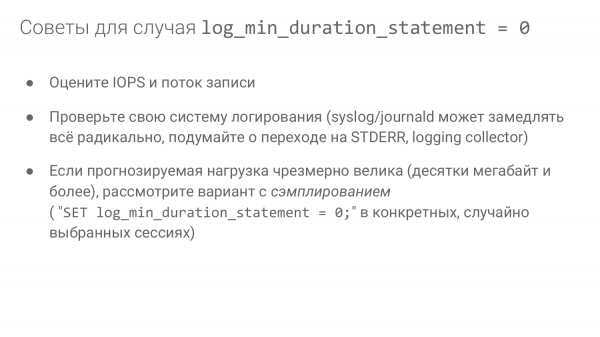
- Értékelje az IOPS-t és az írási sebességet.
- Ellenőrizze a naplózó rendszerét.
- Ha a várható terhelés túl nagy, fontolja meg a mintavételezés lehetőségét.
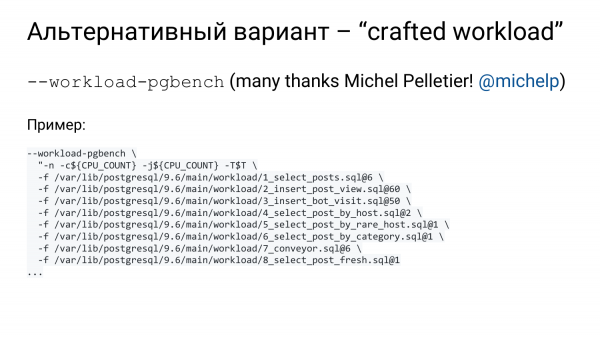
Van pg_stat_statements. Ahogyan mondtam, ennek feltétlenül ott kell lennie. És különféle lekérdezési csoportokat tudunk leírni speciális módon egy fájlban. Ezt követően pedig nagyon kényelmes funkciót vehetünk igénybe a pgbench-ben – lehetőség van több fájl átadására az '-f' opció segítségével.
Ő sok «-f»-et megért. Azt is meg lehet mondani «@» használatával a végén, hogy melyik fájl arányát kellene betartani. Vagyis mondhatjuk, hogy ezt 10%-ban, azt pedig 20%-ban kell futtatni. Ez közelebb fog vinni minket ahhoz, amit a production-on látunk.
Hogyan tudjuk, mi van a production-on? Mekkora a részesedés és miből mennyi? Ez egy kicsit eltér a témától. Van egy másik termékünk is, . Ez is Open Source alapú. Jelenleg aktívan fejlesztjük.
Ez egy kicsit más okokból született. Azért, mert a monitoring nem elégséges. Vagyis eljössz, megnézed az adatbázist, megnézed a felmerülő problémákat. És általában csinálsz egy health_check-et. Ha tapasztalt DBA vagy, akkor végezz el health_check-et. Megnézted az indexhasználatot, stb. Ha van OKmeter-ed, az nagyszerű. Ez egy remek monitoring eszköz a Postgres számára. OKmeter.io – kérlek, telepítsd, nagyon jól meg van csinálva. Ez egy fizetős szolgáltatás.
Ha nincs, akkor általában nem sok mindened van. A monitorozás általában csak CPU-t, IO-t és az is fenntartással, ennyi. Viszont nekünk több kell. Látni akarjuk, hogyan működik az autovakuum, hogyan működik a checkpoint, az io-ban el kell különíteni a checkpoint-ot a bgwriter-től és a backend-től, stb.
A problémát az jelenti, hogy amikor segítesz egy nagy vállalatnak, nem tudnak gyorsan bevezetni valamit. Nem tudják gyorsan megvenni az OKmeter-t. Lehet, hogy fél év múlva megveszik. Nem tudják gyorsan telepíteni a szükséges csomagokat.
Így született meg az ötlet, hogy szükségünk van egy olyan speciális eszközre, amely nem igényel semmilyen telepítést, vagyis nem kell semmit telepítened a production-ra. Telepítheted a laptopodra, vagy egy observing server-re, ahonnan indítani fogod. És ez rengeteg mindent elemez: az operációs rendszert, a fájlrendszert, magát a Postgres-t, végezve valamilyen könnyű lekérdezéseket, amelyeket közvetlenül a production-on lehet futtatni anélkül, hogy bármi leállna.
Postgres-checkup-nak neveztük. Ha orvosi értelemben nézzük, akkor ez egy rendszeres egészségügyi ellenőrzés. Ha autós szempontból, akkor ez olyan, mint egy szerviz. Az autódnak évente vagy két évente kell átfésülnie az állapotát, a márkától függően. De te elvégzel hasonló ellenőrzéseket az adatbázisodra? Tehát végzel mélyreható vizsgálatokat rendszeresen? Ezt meg kell tenni. Ha készítesz biztonsági másolatokat, akkor készíts checkup-ot is, ez semmivel sem kevésbé fontos.
És van egy ilyen eszközünk. Csak három hónapja kezdett aktívan fejlődni. Még fiatal, de már sok funkcióval rendelkezik.
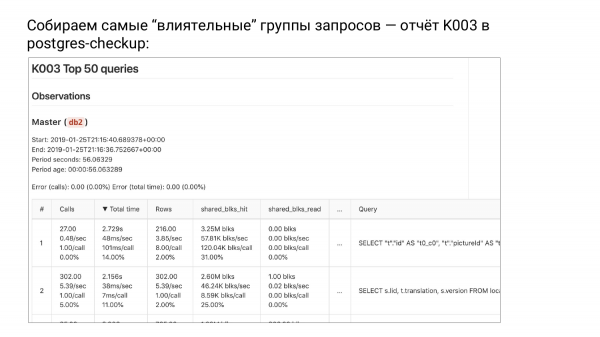
Összegyűjtjük a legbefolyásosabb lekérdezési csoportokat – K003 jelentés a Postgres-checkupban
Itt van egy jelentéscsoport K. Jelenleg három jelentés érhető el. Létezik egy K003 jelentés is. Ebben a pg_stat_statements csúcsai szerepelnek, a total_time szerint rendezve.
Amikor a total_time szerint rendezzük a lekérdezési csoportokat, akkor a csoport tetején egy olyan csoportot látunk, amely a legnagyobb mértékben terheli a rendszerünket, azaz a legtöbb erőforrást fogyasztja. Miért nevezem csoportoknak a lekérdezéseket? Mert eltávolítottuk a paramétereket. Ezek már nem lekérdezések, hanem lekérdezési csoportok, azaz absztrakt csoportok.
Ha felülről lefelé optimalizálunk, könnyebbé tesszük az erőforrásainkat, és elhalasztjuk azt az időpontot, amikor frissítenünk kell. Ez egy nagyon jó módja a pénzmegtakarításnak.
Talán ez nem a legjobb megoldás a felhasználók számára, mert előfordulhat, hogy nem látjuk a ritka, de nagyon bosszantó eseteket, amikor valaki 15 másodpercet várt. Összességében ezek annyira ritkák, hogy nem észleljük őket, de közben az erőforrásokkal foglalkozunk.
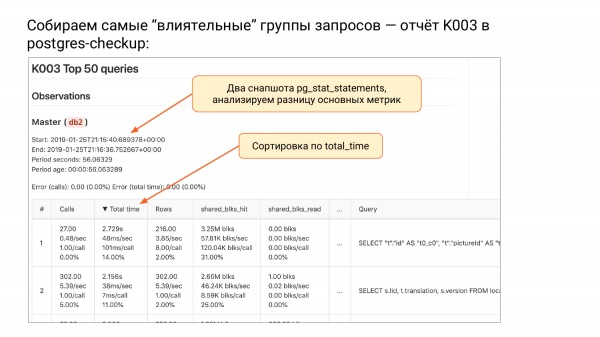
Mi történt ebben a táblázatban? Két pillanatfelvételt készítettünk. A Postgres_checkup minden metrikánál delta értéket számít: total-time, calls, rows, shared_blks_read stb. Minden, a delta kiszámítva. A pg_stat_statements egyik nagy problémája, hogy nem emlékezik a resetre. Míg a pg_stat_database emlékszik, a pg_stat_statements nem. Látja, hogy ott 1 000 000 van, de nem tudjuk, honnan számoltuk.
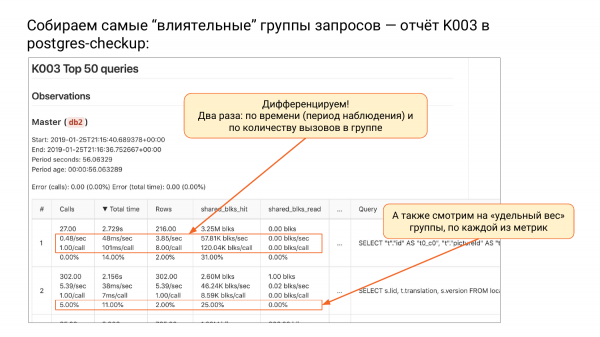
Itt viszont tudjuk, hogy két pillanatfelvételünk van. A delta ebben az esetben 56 másodperc volt. Nagyon rövid időtartam. A total_time szerint rendeztük. Továbbá differenciálhatunk, azaz minden metrikát elosztunk a duration értékkel. Ha minden metrikát elosztunk a durationnal, akkor megkapjuk a másodpercenkénti hívások számát.
A következő a total_time per másodperc – ez a kedvenc metrikám. Másodpercekben mérik, másodpercenként, azaz mennyi időt vett igénybe a rendszerünk a lekérdezési csoport végrehajtására másodpercenként. Ha ott több mint egy másodpercet lát, az azt jelenti, hogy több mint egy magra volt szükség. Ez egy nagyon jó metrika. Megértheti, hogy ennek a személynek például minimum három magra van szüksége.
Ez a mi találmányunk, ilyet sehol máshol nem láttam. Figyeljen – ez egy nagyon egyszerű dolog – másodpercenként. Néha, amikor a CPU 100%-os, akkor félórát jelent másodpercenként, azaz fél órán keresztül csak ezek a lekérdezések foglalták el az időt.
A következő azaz a másodpercenkénti sorok száma. Tudjuk, hogy hány sort adtunk vissza másodpercenként.
A következő érdekes dolog, hogy mennyi shared_buffers-t olvastunk másodpercenként a shared_buffers-ból. A találatok már ott voltak, a sorokat pedig a rendszer cache-ből vagy a lemezről vettük. Az első lehetőség gyors, a második esetleg gyors, esetleg nem, a szituációtól függően.
A második diferenciálási módszer az, hogy a csoportban lévő kérelmek számát osztjuk fel. A második oszlopban mindig lesz egy kérés osztva a kéréshez. Aztán érdekes – hány milliszekundum volt ebben a kérésben. Tudjuk, hogy ez a kérés átlagosan hogyan viselkedik. Minden kéréshez 101 milliszekundumra volt szükség. Ez a hagyományos metrika, amelyre szükségünk van a megértéshez.
Hány sor állt vissza átlagosan minden kérésre. Látjuk, hogy a csoport 8-at ad vissza. Átlagosan hányat vett és olvasott a cache-ből. Látjuk, hogy minden jól cache-elt. Csak találatok az első csoport számára.
A sorok negyedik alkatrésze – ez hány százalék az összes hívásból. Van 1 000 000 hívásunk. És megérthetjük, hogy ez a csoport mekkora mértékben járul hozzá. Látjuk, hogy az első csoport ebben az esetben kevesebb mint 0,01%-ot tesz ki. Tehát annyira lassú, hogy nem látjuk az összképen. A második csoport – 5%-ot a hívások között. Tehát az összes hívás 5%-a a második csoport.
A total_time-mal is érdekes. Az első csoport kérdéseire az időnk 14%-át költöttük. A másodikra 11%-ot, és így tovább.
Nem fogok a részletekbe belemerülni, de ott vannak finomságok. Fent megjelenítjük a hibát, mert amikor összehasonlítunk, a pillanatképek elmozdulhatnak, azaz néhány kérés kieshet, és a második már nem lehet jelen, és néhány új megjelenhet. És ott kiszámítjuk a hibát. Ha 0-t látsz, az jó. Nincsenek hibák. Ha a hiba százaléka 20% alatt van, az rendben van.
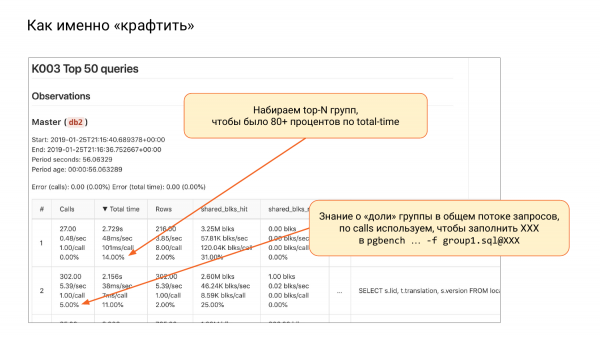
Most visszatérünk a témánkhoz. Meg kell alkotnunk a workload-ot. Fentről lefelé haladunk, amíg el nem érjük a 80%-ot vagy 90%-ot. Általában ez 10-20 csoport. És fájlokat készítünk a pgbench-hez. Ott a random-ot használjuk. Néha ez sajnos nem sikerül. A Postgres 12-ben pedig több lehetőség lesz ennek a megközelítésnek a használatára.
És így 80-90%-ot elérünk a total_time-értékeknél. Mi jön a „@” után? Nézzük a hívásokat, megnézzük, hány százalékot mutatnak, és megértjük, hogy itt hány százalékot kellene elérnünk. Ebből a százalékból felmérhetjük, hogyan balanszírozzuk az egyes fájlokat. Ezt követően használjuk a pgbench-et, és kezdjük el a munkát.
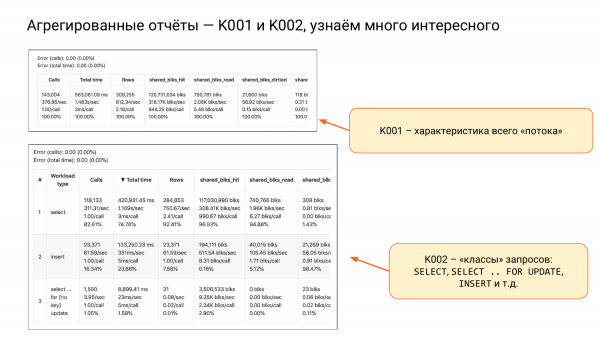
Van még K001 és K002 is.
A K001 egy nagy sorozat négy alkategóriával, ami az egész terhelésünket jellemzi. Nézzük a második oszlopot és a második alkategóriát. Látjuk, hogy körülbelül másfél másodperc másodpercenként, tehát ha két magunk van, akkor az jó lesz. Körülbelül 75%-os terheléssel fog működni. Ha 10 magunk van, akkor teljesen nyugodtak lehetünk. Így értékelhetjük a forrásokat.
A K002-t a kérésosztályoknak hívom, tehát SELECT, INSERT, UPDATE, DELETE. Külön a SELECT FOR UPDATE, mert az zárolja.
Itt azt a következtetést vonhatjuk le, hogy a szokásos SELECT hívások 82%-át teszik ki az összes hívásnak, viszont a total_time alapján 74%-ot. Tehát sokszor hívják őket, de kevesebb erőforrást használnak.
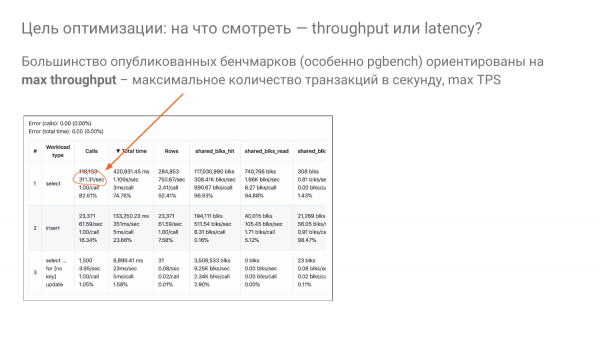
És visszatérünk a kérdéshez: „Hogyan válasszuk ki helyesen a shared_buffers-t?”. Megfigyeltem, hogy a legtöbb benchmark arra az elképzelésre épít, hogy nézzük meg, mekkora lesz a throughput, azaz a teljesítmény. Ez TPS-ben vagy QPS-ben van mérve általában.
Próbálunk a lehető legtöbb tranzakciót kisajtolni az autóból a finomhangolási paraméterek segítségével. Itt, a SELECT esetén, éppen 311 tranzakció másodpercenként.
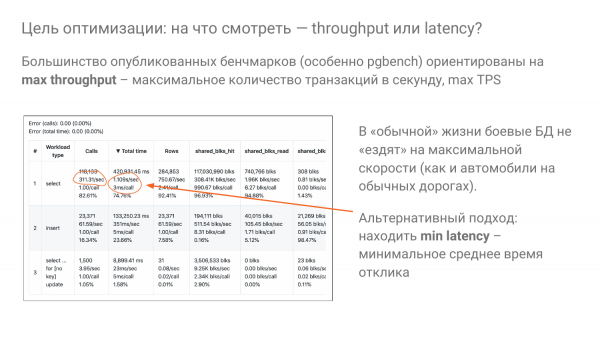
De senki sem jár munkába és haza autóval teljes sebességgel. Ez butaság. Ugyanez vonatkozik az adatbázisokra is. Nem szabad maximális sebességgel menni, és senki sem teszi ezt. Senki sem él olyan produkcióban, ahol 100%-os a CPU. Persze lehet, hogy valaki mégis, de az nem jó.
Az ötlet az, hogy általában a lehetőségeink 20%-án járunk, és lehetőleg nem haladunk meg 50%-ot. Az elsődleges célunk az, hogy optimalizáljuk a válaszidőt a felhasználóink számára. Tehát a kezünket úgy kell forgatnunk, hogy minimális latency legyen 20%-os sebességnél, mondjuk. Ez az ötlet is része az kísérleteinknek.
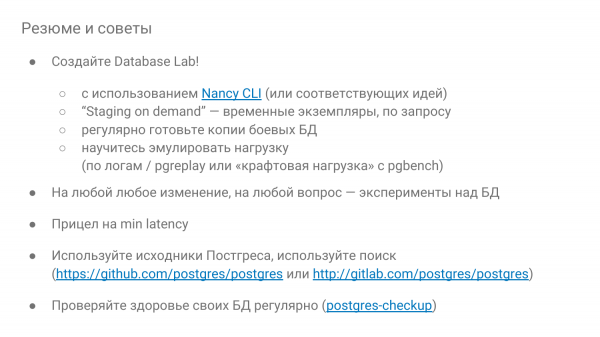
Összegzésként a következő ajánlásokat teszem:
- Mindenképpen készítsen Database Lab-ot.
- Ha lehet, készítsen on-demand rendszert, hogy egy bizonyos időre beinduljon – játszanak vele és aztán dobják el. Ha felhői vannak, akkor ez magától értetődő, tehát legyen sok standing.
- Legyenek kíváncsiak. Ha valami nem stimmel, teszteljék kísérletekkel, hogyan működik. A Nancy használható az önképzésre, hogy ellenőrizzék, hogyan működik az adatbázis.
- Célzottan minimalizálják a válaszidőt.
- Ne féljenek a Postgres forrásaitól. Amikor a forrásokkal dolgoznak, tudniuk kell angolul. Rengeteg megjegyzés található ott, minden el van magyarázva.
- Rendszeresen ellenőrizzék az adatbázis egészségét, legalább háromhavonta manuálisan, vagy a Postgres-checkup segítségével.
Kérdések
Nagyon köszönöm! Nagyon érdekes dolog.
Két dolog.
Igen, két dolog. Csak nem teljesen értettem. Amikor a Nancyt használjuk, csak egy paramétert tudunk finomítani, vagy egy egész csoportot?
Van delta-konfig paraméterünk. Oda bármennyit beállíthat egyszerre. De érteni kell, hogy ha sok mindent megváltoztat, akkor rossz következtetéseket vonhat le.
Igen. Miért kérdeztem? Mert nehéz kísérletezni, amikor csak egy paraméter van. Finomítja, megnézi, hogyan működik. Beállítja. Aztán jön a következő.
Lehet egyszerre finomítani, de ez természetesen helyzettől függ. De jobb egy ötletet tesztelni. Tegnap jutott eszünkbe egy ötlet. Nagyon hasonló helyzetünk volt. Két konfigurációnk volt. Nem tudtuk, miért van nagy különbség. És felmerült az ötlet, hogy dichotómiát kellene használni, hogy fokozatosan megértsük és megtaláljuk a különbséget. Azonnal a paraméterek felének azonosnak kell lennie, aztán a negyedének, és így tovább. Minden rugalmas.
Van még egy kérdésem. A projekt fiatal, fejlődik. Készen áll a dokumentáció, van részletes leírás?
Ott szándékosan tettem egy linket a paraméterek leírására. Ez ott van. De sok minden még nincs kész. Keresem a hasonló gondolkodású embereket. És találkozom velük, amikor előadásokat tartok. Ez nagyon klassz. Valaki már dolgozik velem, valaki segített és valamit ott csinált. És ha érdekli ez a téma, adjon visszajelzést – mi hiányzik.
Amint létrehozzuk a laboratóriumot, lehet, hogy lesz visszajelzés. Meglátjuk. Köszönöm!
Jó napot! Köszönöm az előadást! Láttam, hogy van támogatás az Amazon számára. Tervezik a GSP támogatását?
Jó kérdés. Elkezdjük csinálni. És jelenleg leállítottuk, mert spórolni szeretnénk. Azaz van támogatás a localhost használatával. Te magad is létrehozhatsz egy példányt, és lokálisan dolgozhatsz. Különben így csináljuk. A Getlabban így csinálom, ott GSP-n. De hogy ilyen orchestrációt csináljunk, azt nem látjuk értelmét, mert a Google-nél nincsenek olcsó spotok. Vannak ??? példányok, de azokkorlátozásokkal járnak. Először is, mindig csak 70%-os kedvezménnyel működnek, és ott nem lehet játszani az árral. A spotokat 5-10%-kal emeljük meg, hogy csökkentsük annak a valószínűségét, hogy téged lecipelnek. Azaz a spoton spórolsz, de bármikor elvehetik. Ha picit magasabb áron dolgozol, mint a többiek, akkor később megölnek. A Google-nél teljesen más a specifikáció. És van még egy nagyon rossz korlátozás – ezek csak 24 óráig élnek. Néha viszont 5 napig szeretnénk kísérletezni. De spoton ezt meg lehet csinálni, a spotok néha hónapokig életben maradnak.
Jó napot! Köszönöm az előadást! Megemlítetted a checkup-ot. Hogyan számoljátok ki a stat_statements hibákat?
Nagyon jó kérdés. Nagyon részletesen tudom mutatni és mesélni. Röviden - megnézzük, hogyan változott a lekérdezési csoportok összessége: mennyi hullott ki és hány új jelent meg. Aztán két metrikát nézünk: total_time és calls, ezért van ott két hiba. És nézzük, hogy milyen mértékben járultak hozzá a változó csoportok. Két almetszés van: távozott és érkezett. Nézzük, hogy milyen a hozzájárulásuk a teljes képet tekintve.
De nem félsz, hogy az ott két-háromszor meg fog fordulni a snapshotok között?
Azaz újra regisztráltak, vagy mi?
Például ez a lekérdezés egyszer már ki lett szorítva, aztán érkezett egy újabb, és ismét ki lett szorítva, aztán még egyszer jött és ismét ki lett szorítva. És te itt valamit számoltál, és hol van ez az egész?
Jó kérdés, ezeket meg kell nézni.
Én hasonló dolgot csináltam. Persze, egyszerűbben, egyedül csináltam. De le kellett állítanom, reset stat_statements-t kellett csinálnom, és a snapshot pillanatában arra orientálódtam, hogy ott kevesebb mint egy bizonyos arány van, hogy nem érte el a maximális stat_statements mértéket, ami felhalmozódhatott. Azt gondolom, hogy valószínűleg nem szorult ki semmi.
Igen-igen.
De hogyan lehetne máshogy megbízhatóan csinálni, azt nem értem.
Sajnos nem emlékszem pontosan – használunk-e ott lekérdezés szöveget vagy queryid-t a pg_stat_statements-ből, és arra orientálódunk. Ha a queryid-re orientálódunk, akkor elvileg összehasonlítható dolgokat hasonlítunk.
Nem, hiszen többször is kiszorulhat a pillanatképek között, és újra megérkezhet.
Ugyanazzal az azonosítóval?
Igen.
Ezt meg fogjuk vizsgálni. Jó kérdés. Meg kell nézni. De jelenleg az, amit látunk, vagy 0-ját írja...
Ez persze ritka eset, de meglepett, amikor megtudtam, hogy a stat_statements ott kiszoríthatja.
A Pg_stat_statements-ben sok minden lehet. Találkoztunk azzal, hogy ha a track_utility = on, akkor a készletek is nyomon követésre kerülnek.
Igen, természetesen.
És ha van egy véletlenszerű Java Hibernate-ed, akkor ott kezd el zárolódni a hash-tábla. És amint kikapcsolod a nagyon terhelt alkalmazást, 50-100 csoportod lesz. És ott viszonylag minden stabil. Az egyik módja ennek a problémának a kezelésére az, hogy növeljük a pg_stat_statements.max értékét.
Igen, de tudni kell, hogy mennyire. És valahogy figyelemmel kell kísérni. Én is így csinálom. Azaz van egy pg_stat_statements.max-om. És nézem, hogy az aktuális pillanatkép időpontjában nem érem el a 70%-ot. Rendben, azt jelenti, hogy semmit sem veszítettünk. Reseteljük. És újra gyűjtjük. Ha a következő pillanatképnél 70% alatt van, akkor valószínűleg újra semmit sem veszítettünk.
Igen. Alapértelmezés szerint most 5000. És nagyon sokaknak ez elég.
Általában - igen.
Videó:
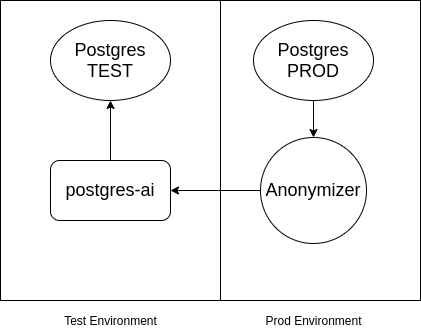
P.S. Hozzátenném, hogy ha a Postgres-ben érzékeny adatok találhatók, amelyek nem kerülhetnek tesztkörnyezetbe, akkor érdemes használni . A séma nagyjából így néz ki:
Forrás: habr.com
