

Feltöltöttem a Githubra .
Ez egy egyszerű hash-táblázat GPU-ra, amely másodpercenként több százmillió beszúrást képes kezelni. Az én laptopomon, melyben NVIDIA GTX 1060 található, a kód körülbelül 210 ms alatt beszúr 64 millió véletlenszerűen generált kulcs-érték párt, és körülbelül 64 ms alatt töröl 32 millió párt.
Ez körülbelül 300 millió beszúrást / másodperc és 500 millió törlést / másodperc sebességet jelent a laptopomon.
A táblázat CUDA-n íródott, bár ugyanezt a módszert alkalmazhatjuk HLSL-re vagy GLSL-re is. A megvalósításnak vannak bizonyos korlátai, amelyek biztosítják a magas teljesítményt a grafikus kártyán:
- Csak 32 bites kulcsokat és hasonló értékeket kezel.
- A hash-táblázat fix méretű.
- És ennek a méretnek két hatványának kell lennie.
A kulcsokhoz és értékekhez egyszerű elválasztót kell fenntartani (a megadott kódban ez 0xffffffff).
Zárolás nélküli hash-táblázat
A hash-táblázat nyílt címezést alkalmaz, , amely egyszerűen egy kulcs-érték párokat tároló tömb, amely a memóriában található, és kiváló gyorsítótár teljesítménye van. Ezt nem lehet elmondani a láncolásról, amely egy mutató keresését jelenti egy láncolt listában. A hash-táblázat egy egyszerű tömb, amely tárolja az elemeket. KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
A táblázat méretének kétszeres hatványnak kell lennie, nem prím számnak, mert a pow2 / AND-maszk alkalmazásához elegendő egy gyors utasítás, míg a modulus operátor sokkal lassabban működik. Ez fontos a lineáris sondázás esetében, mivel a táblázatban történő lineáris keresés során a slot indexét minden slotra be kell burkolni. Ennek következtében a modulus operáció költsége hozzáadásra kerül minden slotnál.
A táblázat csak kulcsot és értéket tárol minden elemhez, nem a kulcs hash-ét. Mivel a táblázat csak 32 bites kulcsokat tárol, a hash nagyon gyorsan számítható ki. A megadott kódban Murmur3 hash-t alkalmaznak, amely csak néhány eltolást, XOR-ot és szorzást hajt végre.
A hash table employs a blocking protection method that is independent of the order of placement in memory. Even if some write operations disrupt the sequence of other such operations, the hash table will still maintain a correct state. We will discuss this further below. The method works excellently with graphics cards, where thousands of threads are executed concurrently.
The keys and values in the hash table are initialized as empty.
The code can be modified to handle both 64-bit keys and values. Atomic operations for reading, writing, and compare-and-swap are required for keys. For values, atomic read and write operations are needed. Fortunately, in CUDA, read-write operations for 32- and 64-bit values are atomic as long as they are naturally aligned (see ), and modern graphics cards support 64-bit atomic compare-and-swap operations. Of course, switching to 64 bits does result in a slight performance decrease.
State of the hash table
Each key-value pair in the hash table can have one of four states:
- Both key and value are empty. In this state, the hash table is initialized.
- The key has been written, but the value is not yet. If another execution thread reads the data at this moment, it will return an empty value. This is normal; the same would happen if another execution thread had completed slightly earlier, and we are discussing concurrent data structures.
- Both key and value have been written.
- The value is available to other execution threads, but the key is not yet. This may happen because the CUDA programming model implies a weakly ordered memory model. This is fine; in any case, the key is still empty even if the value is no longer so.
An important nuance is that once a key has been written to a slot, it does not move anymore—even if the key is deleted, we will discuss this below.
The hash table code works even with weakly ordered memory models, where the order of reads and writes to memory is unknown. When we discuss insertion, search, and deletion in the hash table, remember that each key-value pair is in one of the four states described above.
Insertion into the hash table
A CUDA function that inserts key-value pairs into a hash table looks like this:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
To insert a key, the code iterates through the hash table array starting from the hash of the key being inserted. In each slot of the array, an atomic compare-and-swap operation is performed, where the key in that slot is compared to empty. If a mismatch is found, the key in the slot is updated to the key being inserted, and the original key of the slot is returned. If this original key was empty or matched the key being inserted, it means the code has found a suitable slot for insertion and writes the value into that slot.
If there are multiple elements with the same key in a single kernel call gpu_hashtable_insert() then any of their values can be written to the key slot. This is considered normal: one of the key-value write operations during the call will be successful, but since this all occurs in parallel across multiple execution threads, we cannot predict which memory write operation will be the last.
Searching in the hash table
Code for looking up keys:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
To find the value of a key stored in the table, we iterate through the array starting from the hash of the key we are looking for. In each slot, we check if the key is the one we are seeking, and if so, we return its value. We also check if the key is empty, and if so, we terminate the search.
If we cannot find the key, the code returns an empty value.
All these search operations can occur concurrently during insertions and deletions. Each pair in the table will have one of the four states described above for the thread.
Deletion in the hash table
Code for deleting keys:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
A kulcs eltávolítása szokatlanul történik: a kulcsot benne hagyjuk a táblázatban, és az értékét (nem magát a kulcsot) üresnek jelöljük. Ez a kód nagyon hasonlít a lookup(), kivéve, hogy a kulcs egyezésének észlelésekor üresre állítja az értékét.
Mint már említettük, amint a kulcs beírásra kerül a slotba, már nem mozdul el. Még ha egy elemet eltávolítunk a táblázatból, a kulcs a helyén marad, csak az értéke válik üressé. Ez azt jelenti, hogy nem kell atomszerű műveletet alkalmaznunk a slot értékének írásához, mert mindegy, hogy a jelenlegi érték üres-e vagy sem – úgyis üres lesz.
A hash-tábla méretének megváltoztatása
A hash-tábla méretét egy nagyobb tábla létrehozásával és az üres elemek átvitelével a régi táblából lehet megváltoztatni. Ezt a funkciót nem valósítottam meg, mert egyszerűen akartam tartani a kód példáját. Ráadásul a CUDA programokban a memóriaallokálást gyakran a hosztkódban végzik, nem a CUDA kernelben.
A cikkben leírja, hogyan módosítható egy zárak ellen védett adatszerkezet.
Versenyhelyzet
A fenti kódrészletekben a gpu_hashtable_insert(), _lookup() és _delete() egyszerre egy kulcs-érték párt kezelnek. Lentebb gpu_hashtable_insert(), _lookup() és _delete() minden párt párhuzamosan kezelnek, minden pár adott GPU végrehajtási szálban:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
A zárak elleni védett hash tábla támogatja a párhuzamos beszúrásokat, kereséseket és eltávolításokat. Mivel a kulcs-érték párok mindig az egyik négy állapot egyikében találhatóak, és a kulcsok nem mozdulnak el, a tábla garantálja a helyességet, még különböző típusú műveletek egyidejű használata mellett is.
Ha azonban párhuzamosan kezelünk egy beszúrási és törlési csomagot, és ha a bemeneti pártömbben vannak duplikált kulcsok, akkor nem tudjuk megjósolni, hogy mely párok "győznek" – melyek íródnak be utoljára a hash táblába. Tegyük fel, hogy a következő bemeneti pártömbbel hívtuk meg a beszúrási kódot: A/0 B/1 A/2 C/3 A/4. Amikor a kód befejeződik, a párok B/1 és C/3 garantáltan benne lesznek a táblában, ugyanakkor benne lesz bármelyik pár a következők közül: A/0, A/2 vagy A/4Ez problémát jelenthet, vagy nem – ez attól függ, hogyan alkalmazzuk. Előre tudhatja, hogy a bemeneti tömbben nincsenek ismétlődő kulcsok, vagy lehet, hogy nem fontos, hogy mi volt az utoljára rögzített érték.
Ha ez problémát jelent Önnek, akkor el kell választania az ismétlődő párokat különböző rendszer CUDA-hívásokra. A CUDA-nál bármely kernelhívással kapcsolatos művelet mindig befejeződik a következő kernelhívás előtt (legalábbis egy szálon belül. Különböző szálakon a kernel párhuzamosan fut). Ha az előző példában egy kernelt hívunk meg A/0 B/1 A/2 C/3, a másikat pedig A/4, akkor a kulcs A az értéket fog kapni 4.
Most beszéljünk arról, hogy a lookup() és delete() funkcióknak egyszerű (plain) vagy változó (volatile) mutatót kell-e használniuk a hash-táblában lévő párok tömbjére. azt állítja, hogy:
A fordító saját belátása szerint optimalizálhatja a globális vagy közös memória olvasási és írási műveleteit... Ezeket az optimalizálásokat a
volatile: ... bármilyen hivatkozás erre a változóra tényleges memóriaolvasási vagy -írási utasításra fordítódik.
A helyességi megfontolások nem igénylik. volatileHa a végrehajtási szál egy korábbi olvasásból származó, megőrzött értéket használ, akkor az azt jelenti, hogy egy kicsit elavult információt fog használni. De ez mindenképp egy érvényes hash-tábla állapotából származó információ egy adott kernelhívás pillanatában. Ha a legfrissebb információra van szüksége, akkor használhat mutatót volatile, de akkor a teljesítmény kissé csökken: az én tesztjeim szerint – 32 millió elem törlésénél a sebesség 500 millió törlés/másodpercről 450 millió törlés/másodpercre csökkent.
Teljesítmény
A 64 millió elembe történő beszúrás és 32 millió elem törlésének tesztjén a std::unordered_map és a GPU hash-tábla közötti verseny gyakorlatilag hiányzik:
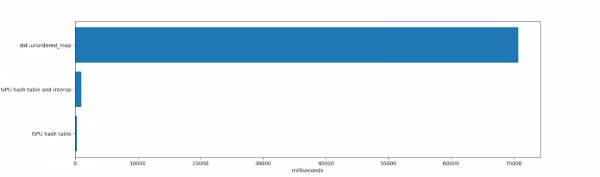
std::unordered_map 70 691 ms-t szánt a műveletek beszúrására és törlésére, majd a unordered_map felszabadítására (több millió elem felszabadítása nem kis időt vesz igénybe, mivel belül számos memóriaallokáció zajlik). Őszintén szólva, a unordered_map std::unordered_map esetében teljesen más korlátok. Ez egyetlen CPU-végrehajtási szál, amely bármilyen méretű kulcs-érték párokat támogat, jól működik magas kihasználtsági arányok mellett és stabil teljesítményt mutat számos törlés után.
A GPU és az inter-process kommunikáció hash táblázatának működési időtartama 984 ms volt. Ebbe beleértendő a táblázat memória elhelyezése és törlése (1 GB memória egyszeri lefoglalása, ami a CUDA-ban valamennyi időt igényel), az elemek beillesztése és törlése, valamint azok bejárása. Szintén figyelembe lett véve minden memória-másolás a videokártyába és onnan.
A hash táblázat működése 271 ms-ig tartott. Ebbe az időtartamba beleszámít a videokártya által az elemek beillesztésére és törlésére fordított idő, és nem számít bele az idő a memóriába másolás és az így létrejött táblázat bejárása. Ha a GPU-táblázat hosszú ideig él, vagy ha a hash táblázat teljesen a videokártyában van (például egy hash táblázat létrehozásához, amelyet egy másik GPU-kód hasznosít, nem a központi processzor), akkor a tesztelési eredmény releváns.
A videokártyához készült hash táblázat magas teljesítményt mutat a nagy sávszélesség és aktív párhuzamosítás révén.
Hátrányok
A hash táblázat architektúrájának több problémája van, amelyeket figyelembe kell venni:
- A lineáris zónázás megnehezíti a klaszterezés, amely miatt a kulcsok a táblázatban távolról sem ideálisan helyezkednek el.
- A kulcsokat a funkció nem törli
törlésés idővel eltorlaszolják a táblázatot.
Ennek következtében a hash táblázat teljesítménye fokozatosan csökkenhet, különösen, ha hosszú ideig létezik és sok beillesztést és törlést végeznek benne. Az egyik módja ezen hátrányok enyhítésének az új táblázatra való újra-hash-elés, elég alacsony kihasználtsági arány mellett, és a törölt kulcsok kiszűrése újra-hash-eléskor.
A fent leírt problémák illusztrálására a fent említett kódot használom egy 128 millió elemből álló táblázat létrehozásához, ciklikusan 4 millió elemet fogok beilleszteni, amíg el nem töltöm a 124 millió helyet (körülbelül 0,96 kihasználtsági arány). Íme az eredmények táblázata, minden sor a CUDA maghívása 4 millió új elem beillesztéséről egy hash táblázatba:
kihasználtsági arány
A beszúrás időtartama 4 194 304 elem
0,00
11,608448 ms (361,314798 millió kulcs/másodperc)
0,03
11,751424 ms (356,918799 millió kulcs/másodperc)
0,06
11,942592 ms (351,205515 millió kulcs/másodperc)
0,09
12,081120 ms (347,178429 millió kulcs/másodperc)
0,12
12,242560 ms (342,600233 millió kulcs/másodperc)
0,16
12,396448 ms (338,347235 millió kulcs/másodperc)
0,19
12,533024 ms (334,660176 millió kulcs/másodperc)
0,22
12,703328 ms (330,173626 millió kulcs/másodperc)
0,25
12,884512 ms (325,530693 millió kulcs/másodperc)
0,28
13,033472 ms (321,810182 millió kulcs/másodperc)
0,31
13,239296 ms (316,807174 millió kulcs/másodperc)
0,34
13,392448 ms (313,184256 millió kulcs/másodperc)
0,37
13,624000 ms (307,861434 millió kulcs/másodperc)
0,41
13,875520 ms (302,280855 millió kulcs/másodperc)
0,44
14,126528 ms (296,909756 millió kulcs/másodperc)
0,47
14,399328 ms (291,284699 millió kulcs/másodperc)
0,50
14,690304 ms (285,515123 millió kulcs/másodperc)
0,53
15,039136 ms (278,892623 millió kulcs/másodperc)
0,56
15,478656 ms (270,973402 millió kulcs/másodperc)
0,59
15,985664 ms (262,379092 millió kulcs/másodperc)
0,62
16,668673 ms (251,627968 millió kulcs/másodperc)
0,66
17,587200 ms (238,486174 millió kulcs/másodperc)
0,69
18,690048 ms (224,413765 millió kulcs/másodperc)
0,72
20,278816 ms (206,831789 millió kulcs/másodperc)
0,75
22,545408 ms (186,038058 millió kulcs/másodperc)
0,78
26,053312 ms (160,989275 millió kulcs/másodperc)
0,81
31,895008 ms (131,503463 millió kulcs/másodperc)
0,84
42,103294 ms (99,619378 millió kulcs/másodperc)
0,87
61,849056 ms (67,815164 millió kulcs/másodperc)
0,90
105,695999 ms (39,682713 millió kulcs/másodperc)
0,94
240,204636 ms (17,461378 millió kulcs/másodperc)
A kihasználtság növekedésével a teljesítmény csökken. Ez a legtöbb esetben nem kívánatos. Ha az alkalmazás elemeket insertál a táblázatba, majd eldobja őket (például egy könyv szavainak számolásakor), akkor ez nem probléma. De ha az alkalmazás tartós hash-táblát használ (például egy grafikus szerkesztőben a nem üres kép részek tárolására, amikor a felhasználó gyakran ad hozzá és töröl információt), akkor ez a viselkedés zavaró lehet.
Megmértem a hash-táblahoz való zondázás mélységét 64 millió insertálás után (kihasználtság 0,5). Az átlagos mélység 0,4774 volt, így a legtöbb kulcs a legjobb lehetséges slotokban vagy egyetlen slot távolságra a legjobbtól helyezkedett el. A maximális zondázási mélység 60 volt.
A zondázási mélységet 124 millió insertálás után (kihasználtság 0,97) mértem. Az átlagos mélység már 10,1757 volt, a maximális pedig - 6474 (!!). A lineáris zondázás teljesítménye drámaian csökken a magas kihasználtság mellett.
A legjobb, ha a hash-táblánk alacsony kihasználtsági együtthatóval rendelkezik. De így a memóriafogyasztás miatt a teljesítményünket is növeljük. Szerencsére, 32 bites kulcsok és értékek esetén ez indokolt lehet. Ha a fenti példában egy 128 millió elemű táblán 0,25-ös kihasználtsági együtthatót tartunk, akkor legfeljebb 32 millió elemet helyezhetünk el benne, míg a fennmaradó 96 millió slot elvész — páranként 8 bájt, 768 MB elveszett memória.
Fontos megjegyezni, hogy itt a videokártya memória elvesztéséről van szó, amely értékesebb erőforrás, mint a rendszer memória. Bár a legtöbb modern asztali videokártya, amely támogatja a CUDA-t, legalább 4 GB memóriával rendelkezik (a cikk írásakor az NVIDIA 2080 Ti 11 GB-tal rendelkezik), mégis nem bölcs dolog, ilyen mennyiségeket elveszíteni.
Később részletesebben írok a videokártyák hash-tábláinak létrehozásáról, amelyeknek nincs problémájuk a mélységi kereséssel, valamint a törölt slotok újrahasználásának módjairól.
Mélységi keresés mérése
A kulcs mélységi keresésének meghatározásához az értékel hajtheti be a kulcs hash-ját (a táblában elérhető ideális indexét) a tényleges táblabeli indexéből:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
A két bináris szám mágikus tulajdonának és annak a ténynek köszönhetően, hogy a hash-tábla kapacitása a kettő hatványa, ez a megközelítés akkor is működni fog, amikor a kulcs indexe a tábla elejére kerül. Tekintsünk egy kulcsot, amely 1-re hash-elődik, de a 3-as slotba lett beillesztve. Akkor a 4 kapacitású táblánk esetében (3 — 1) & 3, ami 2-nek felel meg.
Zárás
Ha bármi kérdése vagy megjegyzése van, írjon nekem a címen, vagy nyisson új témát.
Ez a kód a csodálatos cikkek ihletésével készült:
A jövőben folytatom a videokártyák hash-tábláinak megvalósításáról való írást és teljesítményük elemzését. A terveim között szerepel a láncolás, a Robin Hood hash-elés és a kakukkos hash-elés atomikus műveletek használatával olyan adatstruktúrákban, amelyek kényelmesek a videokártyák számára.
Forrás: habr.com
