

Ez a strukturált információt leíró nyelv szabványa (ISO, ITU-T, GOST), valamint az információ kódolásának szabálya. Programozóként számomra ez csupán egy újabb formátum a sorosításra és az adatok reprezentálására, hasonlóan a JSON-hoz, XML-hez, XDR-hez és másokhoz. Rendkívül elterjedt a mindennapi életünkben, és sokan találkoznak vele: mobil, telefonos és VoIP kommunikációban (UMTS, LTE, WiMAX, SS7, H.323), hálózati protokollokban (LDAP, SNMP, Kerberos), minden, ami a kriptográfiához kapcsolódik (X.509, CMS, PKCS szabványok), bankkártyákon és biometrikus útleveleken, és még sok más helyen.
A cikkben : Python ASN.1 könyvtár, amely aktívan alkalmazható kriptográfiai projektekben. .
Általában nem ajánlatos az ASN.1-et kriptográfiai feladatokhoz használni: az ASN.1 és a kodekjei bonyolultak. Ez azt jelenti, hogy a kód nem lesz egyszerű, ami mindig egy plusz támadási felületet képvisel. Elég csak megnézni Cryptography Engineering szabványokkal rendelkezünk, amelyek aktívan használják X.509 tanúsítványokat CMC , és számos PKCS szabványt . Ezért számítani kell arra, hogy tudni kell dolgozni az ASN.1-gyel, ha valaki kriptográfiával foglalkozik. BER
(Basic Encoding Rules)
- (Canonical Encoding Rules)
- (Distinguished Encoding Rules)
- (Generic String Encoding Rules)
- (JSON Encoding Rules)
- OER
- (Octet Encoding Rules)
- (Packed Encoding Rules)
- XER
- (XML Encoding Rules)
- XMLDSig
XAdES, ASN.1 egyszerű szavakkal ASN.1 — Kommunikáció heterogén rendszerek között Olivier Dubuisson által , , .
length) és magát a tartalmat (Tag), amely az kódolt elem típusát azonosítja (egész szám, szöveg, dátum, stb.), a hosszát (Llength) a tartalom és a tartalom (VA BER lehetővé teszi a hossz értékének megadása nélkül a kódolást, amely különleges határozatlan hosszú értéket állít be, és a kommunikációt az End-Of-Octets címkével zárja le. A hossz kódolásán kívül sok variáció van a típusok kódolásában is, például:
- INTEGER, OBJECT IDENTIFIER, BIT STRING és az elem hossza nem lehet normálisan kódolva (nem a minimális formában);
- A BOOLEAN igaz bármilyen nem null tartalom esetén;
- A BIT STRING tartalmazhat 'felesleges' nullás biteket;
- A BIT STRING, OCTET STRING, valamint az összes származtatott karakterlánc típus, beleértve a dátum/időt is, darabokra (chunk) bonthatók változó hosszúságúakra, amelyek hosszát a (de)kódolás alatt előre nem ismerjük;
- Az UTCTime/GeneralizedTime különböző módokon rendelkezhet az időzóna eltolásának megadásáról és 'felesleges' nullás másodpercekről;
- A SEQUENCE alapértelmezett értékeit lehet kódolni, de nem kötelező;
- A BIT STRING utolsó biteinek elnevezett értékeit nem feltétlenül szükséges kódolni;
- A SEQUENCE (OF)/SET (OF) elemei szabadon rendezhetők.
Az eddig említett okokból kifolyólag, az adatok kódolása úgy, hogy az az eredeti formához hasonló legyen - nem mindig lehetséges. Ezért jött létre egy szabályhalmaz: a DER - szigorúan szabályozza az egyetlen megengedett kódolási módot, ami kritikus kriptográfiai feladatok esetén, ahol például egy bit változása érvényteleníti az aláírást vagy a hash-t. A DER lényeges hátránya, hogy az összes elem hossza előre ismert kell legyen a kódolás során, ami megakadályozza az adatok folyamatos sorozatba állítását. A CER codec mentes ettől a hátránytól, és az adatok egyértelmű ábrázolását is garantálja. Sajnos (vagy szerencsére, hogy még nem bonyolultabb dekódolóink vannak?) nem vált népszerűvé. Ezért a gyakorlatban 'kevert' BER és DER formátumú adatokkal találkozunk. Mivel a CER és DER a BER részhalmazai, bármely BER dekódoló képes ezeket feldolgozni.
Problémák a pyasn1-gyel
A munkahelyünkön sok programot írunk Pythonban a kriptográfiával kapcsolatban. Néhány éve szinte nem voltak elérhető szabad könyvtárak: vagy nagyon alapszintű könyvtárak, amelyek csak az egész szám és a struktúra fejlécének kódolására/dekódolására képesek, vagy ez a könyvtár . Éveken át éltünk vele, és kezdetben nagyon elégedettek voltunk, mivel lehetővé teszi az ASN.1 struktúrák magas szintű objektumként való kezelését: például a dekódolt X.509 tanúsítvány lehetővé teszi a mezői elérését szótár-interfészen keresztül: cert[«tbsCertificate»][«serialNumber»] megmutatja a tanúsítvány sorozatszámát. Hasonlóképpen, összetett objektumokat "építhetünk" úgy, hogy listaként és szótárként dolgozunk velük, majd egyszerűen meghívhatjuk a pyasn1.codec.der.encoder.encode funkciót, és megkaphatjuk a dokumentum sorosított reprezentációját.
Ugyanakkor hátrányok, problémák és korlátok derültek ki. A pyasn1-ben voltak és sajnos még mindig vannak hibák: a cikk írásának időpontjában a pyasn1 egyik alapvető típusa — GeneralizedTime, dekódolva és kódolva.
A projektjeinkben helytakarékosság miatt gyakran csak a fájl elérési útját, a mesterséget és a hosszát tartjuk nyilván a bájtokban, amelyekre hivatkozni szeretnénk. Például egy tetszőleges aláírt fájl valószínűleg a CMS SignedData ASN.1 struktúrában lesz található:
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DEFINED BY id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 Itt van a KÉSZÍTENDŐ FÁJL TARTALMA 751 bájtnyi méretben

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
és mi meg tudjuk szerezni az eredeti aláírt fájlt 65 bájt eltolással, 751 bájt hosszúsággal. A pyasn1 nem tárol ilyen információkat a dekódolt objektumaiban. Kifejlesztettek egy úgynevezett TLVSeeker-t — egy kis könyvtárat, amely lehetővé teszi a címkék és objektumhosszak dekódolását, amelynek interfészén parancsoltuk, hogy 'ugorj a következő címkére', 'lépj be a címkébe' (belépünk a SEQUENCE objektumba), 'ugorj a következő címkére', 'jelentsd az offseted és az objektum hosszát, ahol éppen vagyunk'. Ez volt a 'kézi' navigálás az ASN.1 DER-sorozatos adatokban. De BER-kódolt adatokkal nem lehetett így dolgozni, mert például az OCTET STRING bájtstruktúra több chunk-ban is kódolva lehetett.
Egy másik hátrány a mi feladatainkhoz a pyasn1 számára — nem lehetett megérteni a dekódolt objektumok alapján, hogy egy adott mező jelen volt-e a SEQUENCE-ben vagy sem. Például, ha a struktúra tartalmaz egy mezőt, Field SEQUENCE OF Smth OPTIONAL, akkor az teljesen hiányozhatott a beérkezett adatokból (OPTIONAL), vagy jelen lehetett, de nullás hosszúságú (üres lista) lehetett. Általánosságban nem lehetett ezt megállapítani. Pedig ez szükséges a beérkező adatok szigorú érvényességi ellenőrzéséhez. Képzelje el, hogy egy tanúsítványkibocsátó központ kiadna egy tanúsítványt 'nem éppen' érvényes ASN.1 séma szerinti adatokkal! Például a 'TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı' tanúsítványkibocsátó központ a gyökér tanúsítványában túllépett a megengedetteken. a megfelelő hosszhatárain a subject komponens — nem lehet őszintén dekódolni a sémával. A DER kódoló megköveteli, hogy a mező, amelynek értéke DEFAULT, ne legyen kódolva az átvitel során — ilyen dokumentumok léteznek a valóságban, és a PyDERASN első verziója még tudatosan megengedte ezt a nem érvényes (DER szempontjából) viselkedést a visszafelé kompatibilitás érdekében.
Egy másik korlátozás a nehézség abban, hogy könnyen megállapítsuk, hogy egy adott objektum milyen formátumban (BER/DER) volt kódolva a struktúrában. Például a CMS szabvány kimondja, hogy az üzenetet BER-nek kell kódolnia, de a signedAttrs mező, amelyen a kriptográfiai aláírás készül, DER-ben kell lennie. Ha DER-rel dekódoljuk, akkor az CMS feldolgozása során hibát kapunk, ha pedig BER-rel dekódoljuk, akkor nem fogjuk tudni, hogy a signedAttrs milyen formában volt. Ennek eredményeként a TLVSeeker segítségével (amelynek megfelelője nincs a pyasn1-ben) kell keresnünk az egyes signedAttrs mezők helyét, és külön-külön kell dekódolnunk DER-ben az elkódolt reprezentációból.
Nagyon vágytunk a DEFINED BY mezők automatikus feldolgozásának lehetőségére, amelyek nagyon gyakran előfordulnak. Az ASN.1 struktúra dekódolása után számos ANY mező maradhat, amelyeket tovább kell feldolgozni a struktúrában megadott OBJECT IDENTIFIER alapján választott séma szerint. A Python kódban ez azt jelenti, hogy if-et kell írnunk, és azt követően hívni kell a dekódert az ANY mező számára.
A PyDERASN megjelenése
Az Atlasban rendszeresen, amikor problémákat találunk, vagy javítjuk a használt szabad szoftvereket, folyamatosan küldjük fel a javításokat. A pyasn1-be többször küldtünk fejlesztéseket, de a pyasn1 kódja nem a legegyszerűbb a megértésre, és néha nem kompatibilis API-változások történtek benne, amik problémákat okoztak. Ráadásul hozzászoktunk a generatív tesztelés írásához, ami nem volt jelen a pyasn1-ben.
Egy szép napon úgy döntöttem, hogy elég, ha ezt tűröm, és itt az ideje, hogy megpróbáljak egy saját könyvtárat írni __slot__-okkal, offset-ekkel és szépen megjelenő blob-okkal! Egyszerűen egy ASN.1 kodek létrehozása nem lett volna elegendő — át kellett volna alakítani az összes, egymástól függő projektünket erre, több százezer sor kóddal, amelyek tele vannak ASN.1 struktúrákkal kapcsolatos munkával. Tehát az egyik követelmény számára: a jelenlegi pyasn1 kód könnyen átírható legyen. Az egész szabadságomat arra költöttem, hogy megírjam ezt a könyvtárat, és minden projektet átállítottam rá. Mivel ezek szinte 100%-os tesztlefedettséggel rendelkeznek, ez a könyvtár teljes működőképességét is jelenti.
A PyDERASN is gyakorlatilag 100%-os tesztlefedettséggel rendelkezik. Generatív tesztelést használ a nagyszerű könyvtárral . Ezen kívül fuzzingot is végeztek -hez 32 magos gépeken. Annak ellenére, hogy gyakorlatilag már nem maradt Python2 kódunk, a PyDERASN továbbra is megőrzi a kompatibilitást, és emiatt egyetlen függősége van. Továbbá, tesztelve van az .
A használati elve hasonló a pyasn1-hez — magas szintű Python objektumokkal való munka. Az ASN.1 séma leírása hasonló.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
A PyDERASN azonban szigorú típuselméletet alkalmaz. A pyasn1-ben, ha egy mező típusa CMSVersion(INTEGER) volt, akkor hozzárendelhettünk int vagy INTEGER-t is. A PyDERASN szigorúan megköveteli, hogy a hozzárendelt objektum CMSVersion legyen. Továbbá, mivel Python3 kódot írunk, használunk , ezért a funkcióinkban nem érthetetlen arguments vannak, mint például def func(serial, contents), hanem def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), és a PyDERASN segít ilyen kódot fenntartani.
Ugyanakkor a PyDERASN rendkívül kényelmes engedményeket tesz a típuselmélet terén. A pyasn1 nem engedte meg, hogy a SubjectKeyIdentifier().subtype(implicitTag=Tag(...)) mezőt SubjectKeyIdentifier() objektumhoz rendeljük (a szükséges IMPLICIT TAG nélkül), és gyakran kellett másolni és újra létrehozni objektumokat csak a megváltozott IMPLICIT/EXPLICIT címkék miatt. A PyDERASN szigorúan csak az alap típust figyeli — a címkéket automatikusan behelyettesíti a már meglévő ASN.1 struktúra séma alapján. Ez jelentősen leegyszerűsíti az alkalmazások kódját.
Ha hiba történik a dekódolás során, akkor a pyasn1-ben nehéz megérteni, hol pontosan is történt. Például a fent említett török tanúsítvány esetén a következő hibát kapjuk: UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (at 138) unsatisfied bounds: 1 ⇐ 77 ⇐ 64 ASN.1 struktúrák írásakor az emberek hibázhatnak, és ez segít könnyebben debuggolni az alkalmazásokat vagy kideríteni a másik fél által kódolt dokumentumok problémáit.
A PyDERASN első verziójában nem volt támogatás BER kódolásra. Ez sokkal később jelent meg, és a UTCTime/GeneralizedTime időzónás feldolgozása még mindig nem támogatott. Ez a jövőben érkezik, mivel a projektet jellemzően munka melletti szabadidőben írják.
Az első verzióban nem volt DEFINED BY mezőkkel való munka. Néhány hónap múlva ez a lehetőség megjelent class ContentInfo(Sequence): schema = ( ("contentType", ContentType(defines=((("content",), { id_authenticatedData: AuthenticatedData(), id_digestedData: DigestedData(), id_encryptedData: EncryptedData(), id_envelopedData: EnvelopedData(), id_signedData: SignedData(), }),))), ("content", Any(expl=tag_ctxc(0))), )
ez azt jelenti, hogy ha a contentType OID-t tartalmaz az id_signedData értékkel, akkor a content mezőt (ami ugyanebben a SEQUENCE-ben található) a SignedData séma szerint kell dekódolni. Miért kell ennyi zárójel? A mező egyszerre több mezőt "meghatározhat", ahogyan az az EnvelopedData struktúrákban is előfordul. A meghatározott mezők az úgynevezett decode path alapján azonosíthatók — ez határozza meg egy elem pontos helyét az összes struktúrában.
Nem mindig akarjuk vagy van lehetőségünk ezeket a definíciókat közvetlenül a sémába beletenni. Lehetnek alkalmazás-specifikus esetek, amikor az OID-ek és struktúrák csak egy külső projektben ismertek. A PyDERASN lehetőséget biztosít arra, hogy ezeket a definíciókat közvetlenül a struktúra dekódolásakor adjuk meg:
ContentInfo().decode(data, ctx={"defines_by_path": (( ( "content", DecodePathDefBy(id_signedData), "certificates", any, "certificate", "tbsCertificate", "extensions", any, "extnID", ), ((("extnValue",), { id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(), id_ce_basicConstraints: BasicConstraints(), [...] id_ru_subjectSignTool: SubjectSignTool(), }),), ),)})
Itt azt mondjuk, hogy a CMS SignedData esetében minden csatolt tanúsítvány esetében dekódolni kell minden kiterjesztésüket (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool stb.). A decode path-on keresztül megadjuk, hogy melyik elemhez kell "hozzárendelni" a definíciókat, mintha azok a sémában lettek volna megadva.
Végül, a PyDERASN lehetőséget biztosít a
parancssorból csinos nyomtatást . Tetszőleges ASN.1 dekódolható, de megadhatunk egy pontosan meghatározott sémát is, és valami ilyesmit láthatunk:
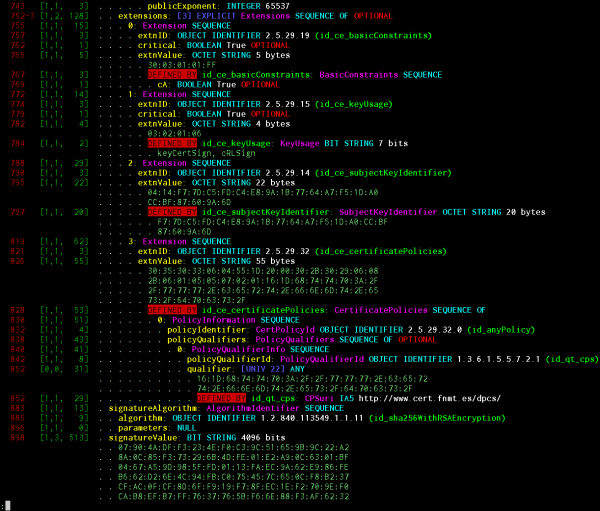
Megjelenített információ: objektum eltolás, címke hossza, tartalom hossza, EOC (end-of-octets) megléte, BER-kódolás jelzése, határidős hosszúságú kódolás jelzése, EXPLICIT címke hossza és eltolása (ha van), objektum mélysége a struktúrákban, IMPLICIT/EXPLICIT a címke értéke, a séma szerinti objektum neve, alap ASN.1 típusa, sorszám a SEQUENCE/SET OF belül, CHOICE értéke (ha van), emberi olvasású INTEGER/ENUMERATED/BIT STRING a sémában, bármilyen alap típus értéke, DEFAULT/OPTIONAL jelző a sémából, annak jelzése, hogy az objektum automatikusan lett dekódolva a DEFINED BY alapján és hogy melyik OID miatt, emberi olvasású OID.
A pretty printing rendszer kifejezetten úgy lett kialakítva, hogy PP-objektumok sorozatát generálja, amelyeket már külön eszközökkel vizualizálnak. A képernyőképen egy egyszerű színes szövegben látható renderer. Léteznek JSON/HTML formátumú renderer-ek is, hogy ezt ki lehessen világítani ASN.1-ben a böngészőben. projektben.
Egyéb könyvtárak
Ez nem volt cél, de a PyDERASN jelentősen mint a pyasn1. Például, CRL fájlok dekódolása, amelyek mérete megabájtban mérhető, olyan hosszú időt vehet igénybe, hogy el kell gondolkodni az adatok tárolásának (gyors) közbenső formátumain és az alkalmazások architektúrájának megváltoztatásán. A pyasn1 a CRL-t a laptopomon több mint 20 perc alatt dekódolja, míg a PyDERASN mindössze 28 másodperc alatt! Van egy , amely a kriptográfiai struktúrákkal való gyors munkára irányul: ez a samme CRL-t teljesen (nem lustán) 29 másodperc alatt dekódolja, de majdnem kétszer annyi RAM-ot használ Python3 alatt (983 MiB szemben 498 MiB) és 3,5-szer annyit Python2 alatt (1677 szemben 488), míg a pyasn1 akár 4,3-szor annyit is elhasznál (2093 szemben 488).
Az asn1crypto, amelyet említettem, nem került megfontolásra, mert a projekt még csak formálódott, és nem hallottunk róla. Most is inkább nem tekintenénk rá, mivel azonnal észrevettem, hogy a GeneralizedTime nem fogad el tetszőleges formátumot, és a sorozatolás során csendben eltávolítja a másodpercre utaló részeket. Ez elfogadható X.509 tanúsítványokkal való munkához, de általános esetben nem megfelelő.
Jelenleg a PyDERASN az általam ismert legszigorúbb nyílt Python/Go DER dekódoló. A kedvenc Go programozási nyelvemben az encoding/asn1 könyvtárban OBJEKT AZONOSÍTÓ és UTCTime/GeneralizedTime stringek. Néha a szigorúság akadályozhat (elsősorban a régi alkalmazások visszafelé kompatibilitása miatt, amelyeket senki sem fog javítani), ezért a PyDERASN során a dekódolásnál különféle beállításokat lehet megadni. a ellenőrzések enyhítése.
A projekt kódja maximálisan egyszerű próbál lenni. Az egész könyvtár egy fájl. A kódot úgy írták, hogy a megértést helyezi előtérbe, a teljesítmény optimalizálásának és a DRY kódnak a nélkül. Nincs benne, ahogy már említettem, teljes körű BER dekódolás a UTCTime/GeneralizedTime stringekhez, valamint a REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV, CHARACTER STRING típusú adatokhoz. Minden más esetben én személy szerint nem látok értelmet más könyvtárak használatának Pythonban.
Mint minden projektem, típus. , , , , a PyDERASN teljesen , amely a következő feltételekkel terjeszthető , és ingyenesen letölthető. Példák a használatra megtalálhatók és a .
, , a következő tagja , Python/Go-fejlesztő, vezető szakember .
Forrás: habr.com
