

A hibabiztosság és a magas rendelkezésre állás nagy témák, ezért külön cikkeket szánunk a RabbitMQ-nak és a Kafkának. Ez a cikk a RabbitMQ-ról szól, a következő pedig a Kafkáról, a RabbitMQ-hoz viszonyítva. A cikk hosszú, ezért helyezkedj el kényelmesen.
Vizsgáljuk meg a hibabiztossági, konzisztencia- és magas rendelkezésre állási (HA) stratégiákat, valamint azokat a kompromisszumokat, amelyeket minden stratégiában meg kell hozni. A RabbitMQ klaszterre épülő csomópontokon is működhet - ekkor elosztott rendszerként van klasszifikálva. Amikor elosztott rendszerekről beszélünk, gyakran említjük a konzisztenciát és a rendelkezésre állást.
Ezek a fogalmak azt írják le, hogyan viselkedik a rendszer hibák esetén. Hálózati kapcsolat megszakadása, szerverhiba, merevlemez hiba, a szerver ideiglenes elérhetetlensége a szemétgyűjtés miatt, csomagvesztés vagy hálózati kapcsolat lassulása. Mindez adatvesztést vagy konfliktusokat okozhat. Kiderül, hogy gyakorlatilag lehetetlen olyan rendszert létrehozni, amely egyidejűleg teljesen ellentmondás-mentes (adatvesztés nélkül, adateltérések nélkül) és elérhető (elfogadja a olvasási és írási műveleteket) az összes hibaesetre.
Látni fogjuk, hogy a konzisztencia és a rendelkezésre állás a spektrum eltérő végein helyezkedik el, és választani kell, hogy melyik irányba szeretnénk optimalizálni. A jó hír az, hogy a RabbitMQ használatával ez a választás lehetséges. Olyan „geek” kapcsolókat használsz, amelyekkel a konzisztencia vagy a nagyobb rendelkezésre állás irányába mozdíthatod el az egyensúlyt.
Különös figyelmet fordítunk arra, hogy mely konfigurációk vezetnek adatvesztéshez a megerősített feljegyzések miatt. Felelősségi lánc áll a kiadók, brókerek és fogyasztók között. Miután a brókerhez továbbították az üzenetet, az ő feladata - hogy ne veszítse el az üzenetet. Amikor a bróker megerősíti a kiadónak az üzenet fogadását, nem várjuk, hogy elvesszen. De látni fogjuk, hogy ez valóban előfordulhat a bróker és a kiadó konfigurációjától függően.
Egy csomópont hibabiztonsági primitívjai
Stabil sorok/routing
A RabbitMQ kétféle sorozatot támogat: tartós (durable) és nem tartós (non-durable). Minden sorozat az Mnesia adatbázisban tárolódik. A tartós sorozatok újra megjelennek a csomópont indításakor, így túlélik az újraindítást, a rendszerhibát vagy a szerverleállást (addig, amíg az adatok mentve vannak). Ez azt jelenti, hogy amíg a routolást (exchange) és a sorozatot tartósnak nyilvánítják, a sorozat/routolási infrastruktúra visszatér a működő állapotba.
A nem tartós sorozatok és routolás eltávolításra kerülnek a csomópont újraindításakor.
Tartós üzenetek
Csak azért, mert egy sorozat tartós, nem jelenti azt, hogy az összes benne lévő üzenet túléli a csomópont újraindítását. Csak azok az üzenetek kerülnek visszaállításra, amelyeket a kiadó tartósnak nyilvánított, tartós (persistent). A tartós üzenetek valóban extra terhelést jelentenek a broker számára, de ha az üzenet elvesztése elfogadhatatlan, akkor nincs más lehetőség.
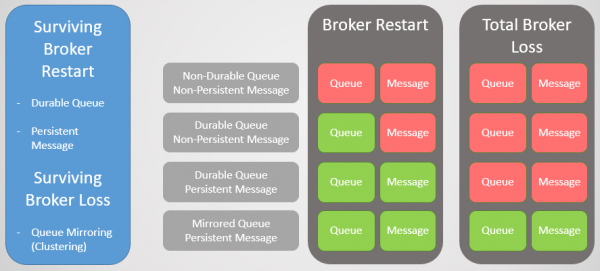
1. ábra. A tartósság mátrixa
Klaszterezés sorozatmásolással
Ahhoz, hogy túlélhessük a broker elvesztését, redundanciára van szükség. Több RabbitMQ csomópontot klaszterbe vonhatunk, majd további redundanciát biztosíthatunk a sorozatok több csomópont közötti replikálásával. Így, ha egy csomópont meghibásodik, nem veszítjük el az adatokat és továbbra is elérhetőek maradunk.
Sorozatmásolás:
- egy fő sorozat (mester), amely minden írási és olvasási utasítást fogad
- egy vagy több tükör, amelyek minden üzenetet és metadata-t kapnak a fő sorozatból. Ezek a tükrök nem a skálázás érdekében léteznek, hanem kizárólag redundanciát biztosítanak.
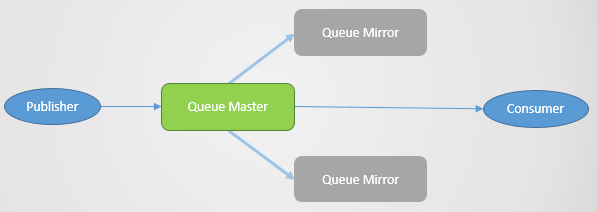
2. ábra. Sorozatmásolás
A másolást a megfelelő politikák állítják be. Itt megadhatók a replikációs arány és akár azok a csomópontok is, amelyeken a sorozatnak el kell helyezkednie. Példák:
ha-mode: allha-mode: exactly, ha-params: 2(egy mester és egy tükör)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
A kiadó megerősítése
A következetes üzenetmegőrzés érdekében szükséges a kiadó megerősítése (Publisher Confirms). Enélkül üzenetek elvesztésének kockázata áll fenn. A megerősítést a kiadó felé a üzenet lemezre írása után küldik el. A RabbitMQ nem fogadja el az üzeneteket közvetlenül, hanem időszakosan, több száz milliszekundumonként írja azokat lemezre. Amikor a sor tükröződik, a megerősítést csak akkor küldik, amikor az összes tükör is lemezre írta az üzenet másolatát. Ez azt jelenti, hogy a megerősítések használata késleltetést okoz, de ha az adatbiztonság fontos, akkor szükséges.
Hibabiztos sor
Amikor a bróker leáll vagy összeomlik, az összes vezető sor (master) az adott csomóponton együtt leáll. Ezután a klaszter kiválasztja a legöregebb tükör példányt minden masterből, és új masterként előlépteti azt.
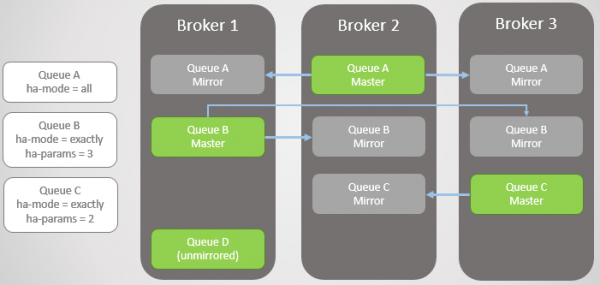
3. ábra. Több tükrözött sor és azok politikái
A 3. bróker összeomlik. Figyelembe kell venni, hogy a C sor tükör példánya a 2. brókerben mester szintre emelkedik. Ezenkívül új tükör példány készül a C sor számára az 1. brókerben. A RabbitMQ mindig igyekszik fenntartani a politikákban megadott replikációs arányt.
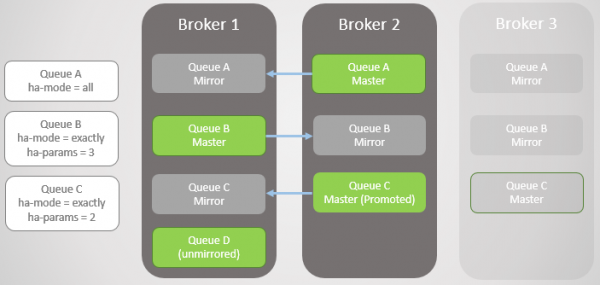
4. ábra. A 3. bróker összeomlik, ami a C sor hibáját okozza
Most az 1. bróker is összeomlik! Csak egy brókerünk maradt. A B sor tükör példánya mesterré emelkedik.
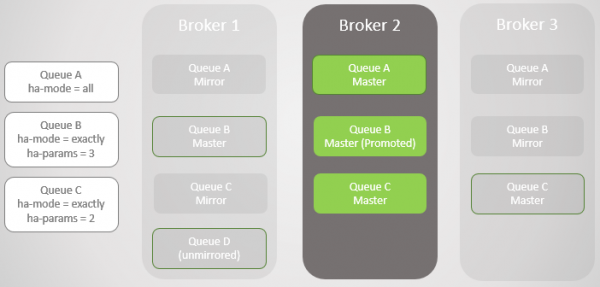
5. ábra
Visszaállítottuk az 1. brókert. Függetlenül attól, hogy az adatok mennyire élték túl a bróker elvesztését és helyreállítását, az összes tükör üzenet elvetésre kerül az újraindításkor. Ezt fontos megjegyezni, mivel következményei lesznek. Hamarosan áttekintjük ezeket a következményeket. Így az 1. bróker most ismét a klaszter tagja, és a klaszter igyekszik betartani a politikákat, ezért tükröket hoz létre az 1. brókeren.
Ebben az esetben az 1. bróker elvesztése teljes volt, akárcsak az adatoké, tehát a nem tükrözött B sor teljesen elveszett.
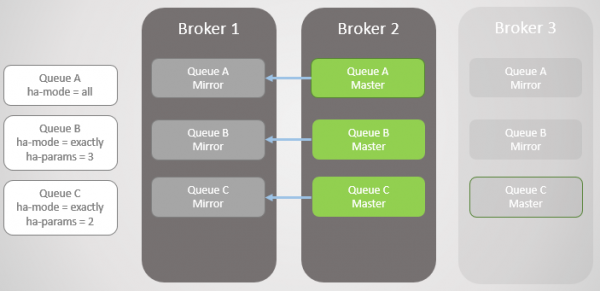
6. ábra. Az 1. bróker visszatér a rendszerbe
A 3-as broker visszatért a működésbe, így az A és B sorok újra megkapják az általa létrehozott tükörsorokat, hogy megfeleljenek a HA politikájuknak. De most minden fő sor egyetlen csomóponton található! Ez nem ideális, a csomópontok közötti egyenletes elosztás jobb lenne. Sajnos itt nincsenek különösebb lehetőségek a mesterek újraelosztására. Ezzel a problémával később foglalkozunk, mivel először meg kell vizsgálnunk a sorok szinkronizálását.
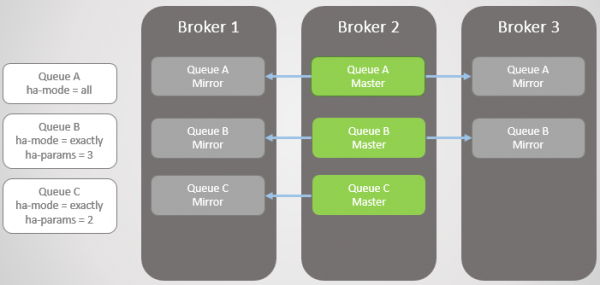
7. ábra. A 3-as broker visszatér. Minden fő sor egyetlen csomóponton!
Igen, most már van egy képe arról, hogyan biztosítják a tükörsorok a redundanciát és a hibatűrést. Ez garantálja a hozzáférhetőséget egy csomópont leállása esetén, és védi az adatvesztéstől. De még nem végeztünk, mert valójában minden sokkal bonyolultabb.
Szinkronizálás
Új tükör létrehozásakor minden új üzenet mindig replikálódik erre a tükörre és bármely másikra. Ami a fő sorban lévő meglévő adatokat illeti, azokat replikálhatjuk az új tükörbe, amely a mester teljes másolatává válik. A meglévő üzeneteket nem is replikálhatjuk, és lehetővé tehetjük a fő sor és az új tükör közötti időbeli egyeztetést, amikor az új üzenetek a vége felé érkeznek, míg a meglévő üzenetek elhagyják a fő sor fejét.
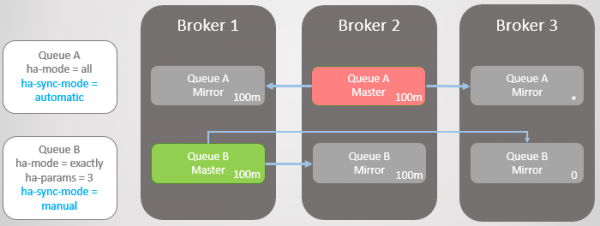
Ez a szinkronizálás automatikusan vagy manuálisan történik, és a sorok politikájával van szabályozva. Nézzünk egy példát.
Két tükörsorunk van. Az A sor automatikusan szinkronizálódik, míg a B sor manuálisan. Mindkét sorban tíz üzenet található.
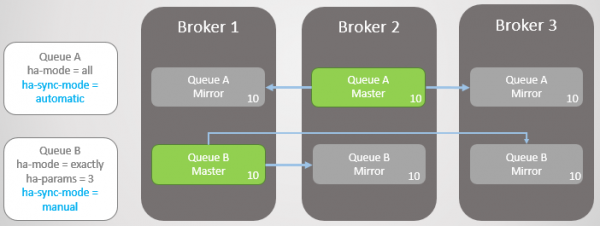
8. ábra. Két sor különböző szinkronizálási módokkal
Most elveszítjük a 3-as brokert.
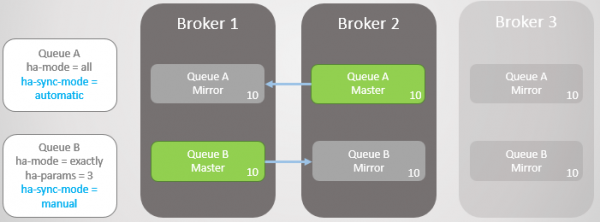
9. ábra. A 3-as broker leállt
A 3-as broker visszatér. A klaszter tükröt hoz létre minden sor számára egy új csomóponton, és automatikusan szinkronizálja az új A sort a mesterrel. Azonban az új B sor tükröje üresen marad. Így az A sor teljes redundanciájával rendelkezünk, míg a B sor meglévő üzeneteihez csak egy tükör tartozik.
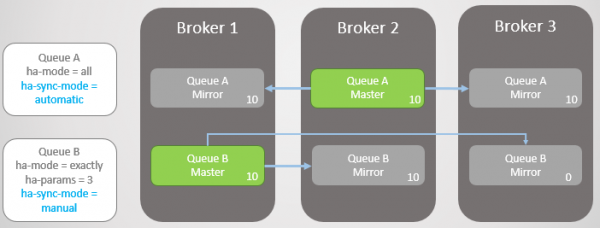
10. ábra. Az új A sori tükör megkapja az összes meglévő üzenetet, míg az új B sori tükör nem.
Mindkét sorba további tíz üzenet érkezik. Ezt követően a 2. Broker leáll, és az A sor visszaáll a legöregebb tükörre, ami az 1. Brokeren található. A hiba esetén nincsen adatvesztés. A B sorban húsz üzenet található a mesternél, és csak tíz a tükörnél, mivel ez a sor soha nem másolta az eredeti tíz üzenetet.
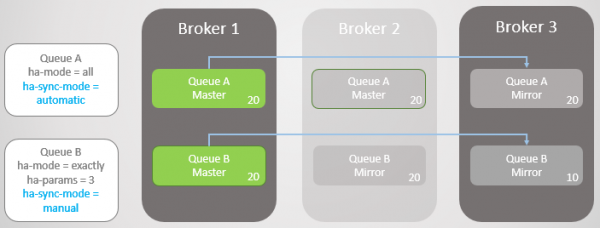
11. ábra. Az A sor visszaáll az 1. Brokerre üzenetvesztés nélkül.
Mindkét sorba ismét tíz üzenet érkezik. Most az 1. Broker leáll. Az A sor probléma nélkül vált a tükörre üzenetvesztés nélkül. A B sor azonban problémákkal küzd. Ezen a ponton optimalizálhatjuk vagy a rendelkezésre állást, vagy a konzisztenciát.
Ha optimalizálni akarjuk a rendelkezésre állást, akkor a politikát ha-promote-on-failure kell beállítani mindig. Ez az alapértelmezett érték, így egyszerűen nem kell megadni a politikát. Ebben az esetben tulajdonképpen tűrjük a hibákat a nem szinkronizált tükrökön. Ez üzenetvesztéshez vezet, de a sor továbbra is olvasható és írható.
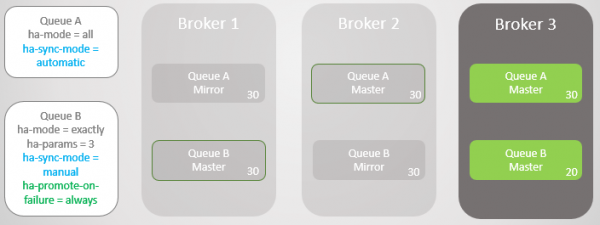
12. ábra. Az A sor visszaáll a 3. Brokerre üzenetvesztés nélkül. A B sor visszaáll a 3. Brokerre tíz üzenet veszteséggel.
Azt is beállíthatjuk, hogy ha-promote-on-failure az értékre when-synced. Ebben az esetben a sor nem a tükörre áll vissza, hanem megvárja, amíg az 1. Broker a saját adataival ismét üzemkész lesz. Miután visszatért, a fő sor ismét az 1. Brokerre kerül üzenetvesztés nélkül. A rendelkezésre állás a adatbiztonság rovására megy. De ez egy kockázatos üzemmód, ami akár teljes adatvesztést is okozhat, amit nemsokára megvizsgálunk.
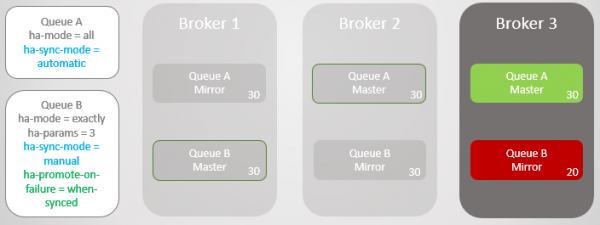
13. ábra. A B sor elérhetetlenné válik az 1. Broker elvesztése után.
Feltetheted a kérdést: "Talán jobb soha nem használni az automatikus szinkronizálást?". A válasz az, hogy a szinkronizálás blokkoló művelet. A szinkronizálás során a fő sor nem végezhet el semmilyen olvasási vagy írási műveletet!
Nézzük meg a példát. Jelenleg nagyon nagy soraink vannak. Hogyan nőhetnek ilyen méretűre? Több okból is:
- A sorokat nem használják aktívan.
- Ezek nagy sebességű sorok, és jelenleg a fogyasztók lassan dolgoznak.
- Ezek nagy sebességű sorok, hiba történt, és a fogyasztók utolérik magukat.
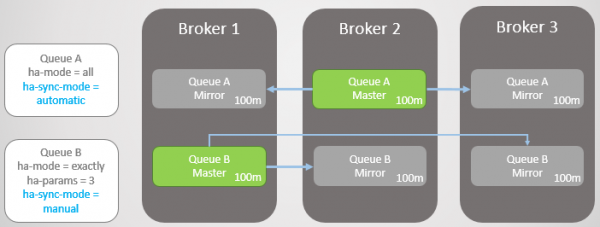
14. ábra. Két nagy sor különböző szinkronizálási móddal
Most a 3. bróker leáll.
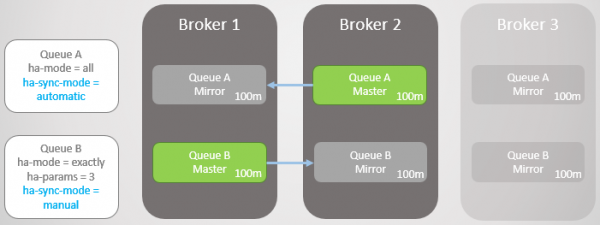
15. ábra. A 3. bróker leáll, egy-master és egy-tükör marad minden sorban
A 3. bróker visszatér, és új tükrök jönnek létre. A Fő A Sor elkezdi újra szinkronizálni a meglévő üzeneteket az új tükörre, és ez idő alatt a Sor nem elérhető. Az adatok replikációjához két órára van szükség, ami két órás leállást jelent a Sor számára!
Azonban a B Sor az egész időszak alatt elérhető marad. Néhány redundanciáról lemondott a rendelkezésre állás érdekében.
16. ábra. A sor nem elérhető a szinkronizálás alatt
Két óra elteltével az A Sor is elérhetővé válik és újra kezdheti a be- és kiolvasási műveleteket.
Frissítések
Ez a blokkoló viselkedés a szinkronizálás alatt megnehezíti a nagyon nagy sorokkal rendelkező klaszterek frissítését. Valamikor a master csomópontot újra kell indítani, ami azt jelenti, hogy vagy a tükörre kell áttérni, vagy a sort le kell állítani a szerver frissítése alatt. Ha az áttérést választjuk, akkor elveszítjük az üzeneteket, ha a tükrök nincsenek szinkronizálva. Alapértelmezés szerint a bróker kikapcsolása során nem történik áttérés a nem szinkronizált tükrökre. Ez azt jelenti, hogy amint a bróker visszatér, nem vesztünk el üzeneteket, egyedül a sor leállása okozott kárt. A bróker kikapcsolásának viselkedését a politika határozza meg. ha-promote-on-shutdown. Két érték közül lehet választani:
mindig= a nem szinkronizált tükrökre való áttérés engedélyezve vanwhen-synced= áttérés csak a szinkronizált tükörre, különben a sor nem lesz elérhető írásra és olvasásra. A sor visszatér, amint a bróker is.
Bárhogy is van, a nagy sorok esetében választani kell az adatok elvesztése és a nem elérhetőség között.
Amikor a rendelkezésre állás növeli az adatok biztonságát
Mielőtt döntést hoznánk, figyelembe kell venni egy további bonyodalmat. Noha az automatikus szinkronizálás jobb a redundancia szempontjából, hogyan befolyásolja az adatok biztonságát? Természetesen a RabbitMQ jobb redundanciája kisebb valószínűséggel veszti el a meglévő üzeneteket, de mi a helyzet az új üzenetekkel a kiadók részéről?
Itt figyelembe kell venni a következőket:
- Visszaadhat-e a kiadó egy hibát, és a felügyeleti szolgáltatás vagy a felhasználó később újrapróbálkozhat?
- Visszatarthat-e a kiadó egy üzenetet helyben, vagy az adatbázisban, hogy később újrapróbálkozzon?
Ha a kiadó csak eldobja az üzenetet, akkor valójában a rendelkezésre állás javítása a adatok biztonságát is növeli.
Ezért meg kell találni az egyensúlyt, és a megoldás a konkrét helyzettől függ.
Problémák a ha-promote-on-failure=when-synced
Ötlet ha-promote-on-failure= when-synced az abban rejlik, hogy megakadályozzuk a szinkronizálatlan tükörre való váltást, így elkerülve az adatok elvesztését. A sor olvasásra vagy írásra nem elérhető. Ehelyett megpróbáljuk visszaállítani a leállt brókert sértetlen adatokkal, hogy folytathassa a munkát mint mester adatvesztés nélkül.
De (és ez egy nagy DE) ha a bróker elvesztette az adatait, akkor nagy problémánk van: a sor elveszett! Minden adat eltűnt! Még akkor is, ha vannak tükör, amelyek jellemzően a fő sorhoz képest lemaradnak, ezeket a tükröket is el kell dobni.
Az azonos nevű csomópont újabb hozzáadásához azt kérjük a klasztertől, hogy felejtse el az elveszett csomópontot (parancs alapján rabbitmqctl forget_cluster_node) és indítson el egy új brókert ugyanazzal a hosztnévvel. Amíg a klaszter emlékezik az elveszett csomópontra, emlékezik a régi sorra és a szinkronizálatlan tükrökre is. Amikor azt kérjük a klasztertől, hogy felejtse el az elveszett csomópontot, ez a sor is elfelejtődik. Most újra kell hirdetni. Minden adatunkat elvesztettük, bár voltak tükrök részleges adatkészlettel. Jobb lett volna áttérni a szinkronizálatlan tükörre!
Ezért a manuális szinkronizálás (és a szinkronizálás elmaradása) a ha-promote-on-failure=when-synced, véleményem szerint, meglehetősen kockázatos. A dokumentumok azt mondják, hogy ez a megoldás létezik az adatok biztonságáért, de ez egy kétélű fegyver.
A mesterek újraelosztása
Ahogy ígértük, visszatérünk ahhoz a problémához, hogy az összes mester összegyűlik egy vagy több csomóponton. Ez akkor is bekövetkezhet, ha „folyékony” (rolling) frissítést hajtanak végre a klaszteren. Egy három csomóponttal rendelkező klaszterben minden fő sor egy vagy két csomóponton gyűlik össze.
A mesterek újraelosztása két okból problémás lehet:
- Nincsenek megfelelő eszközök az újraelosztás végrehajtására
- Sorok szinkronizálása
Van egy harmadik fél áthelyezése , amelyet hivatalosan nem támogatnak. A RabbitMQ útmutatója a harmadik fél bővítményekről azt írja: A bővítmény néhány kiegészítő konfigurációs és jelentéskészítési eszközt biztosít, de nem támogatja és nem ellenőrzi a RabbitMQ csapata. Használja saját felelősségére.
Van még egy trükk, hogy a fő sort a HA politikákon keresztül mozgassuk. Az útmutató említi ehhez. Így működik:
- Törli az összes tükröt egy ideiglenes politikával, amelynek magasabb prioritása van, mint a meglévő HA politikának.
- Megváltoztatja az ideiglenes HA politikát azzal, hogy "csomópont" módot használ, konkrét csomópontot megadva, amelyre a fő sort át kell helyezni.
- Szinkronizálja a sort az erőltetett migrációhoz.
- A migráció befejezése után törli az ideiglenes politikát. Az eredeti HA politika lép érvénybe, és létrejön a szükséges tükör mennyiség.
A hátránya ennek a megközelítésnek, hogy nem működik jól, ha nagy sorok vannak, vagy szigorú redundanciaigények.
Most nézzük meg, hogyan működnek a RabbitMQ klaszterek hálózati részlegzésekkel.
Konzisztencia megsértése
A disztribúciós rendszer csomópontjai hálózati kapcsolatokkal vannak összekapcsolva, és a hálózati kapcsolatok letilthatók. A letiltások gyakorisága a helyi infrastruktúrától, vagy a választott felhő megbízhatóságától függ. Mindenesetre a disztribúciós rendszereknek képesnek kell lenniük kezelni ezeket. Ismét választás elé állunk a rendelkezésre állás és a konzisztencia között, és a jó hír az, hogy a RabbitMQ mindkettőt biztosít (csak nem egyszerre).
A RabbitMQ-val két alapvető lehetőségünk van:
- Engedélyezni a logikai részlegzést (split-brain). Ez biztosítja a rendelkezésre állást, de adatvesztést okozhat.
- Megtagadni a logikai részlegzést. Ez rövid távú rendelkezésre állásvesztést okozhat, attól függően, hogy a kliensek hogyan kapcsolódnak a klaszterhez. Két csomópont esetén teljes nem elérhetőséget is okozhat a klaszterben.
De mi az a logikai részlegzés? Amikor a klaszter kettéoszlik a hálózati kapcsolatok elvesztése miatt. Minden oldalon a tükrök fővé emelkednek, így végül minden sorhoz több fő tartozik.
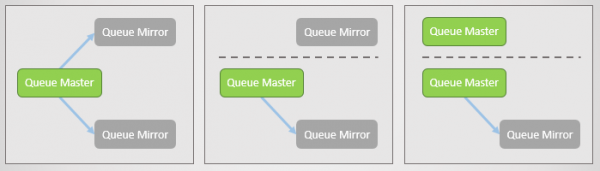
Ábra. 17. Fő sor és két tükör, mindkettő külön csomóponton. Ezután hálózati hiba lép fel, és az egyik tükör leválik. A leválasztott csomópont észleli, hogy a másik kettő kiesett, és a saját tükreit főként irányítja. Most két fő sorunk van, amelyek mindkettő engedélyezik az írást és az olvasást.
Ha a kiadók mindkét főtől adatokat küldenek, akkor két eltérő másolatunk lesz.
A RabbitMQ különböző módjai garantálják vagy a rendelkezésre állást, vagy a konzisztenciát.
Ignore mód (alapértelmezett)
Ez a mód a rendelkezésre állást biztosítja. A kapcsolat megszakadása után logikai elválás következik be. A kapcsolat helyreállásakor a rendszergazdának el kell döntenie, hogy melyik részt kell előnyben részesítenie. A vesztes oldal újraindul, és az ott felhalmozódott adatok elvesznek.
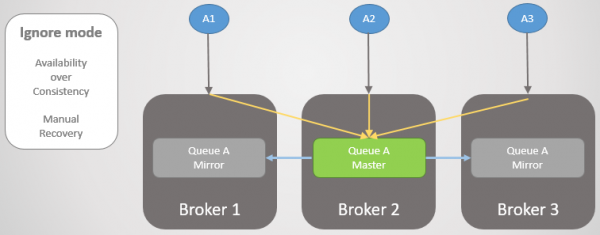
Ábra. 18. Három kiadó kapcsolódik három brókerhez. A klaszter belsőleg az összes kérést a fő sorba a Bróker 2-re irányítja.
Most elveszítjük a Brókert 3. Ez észleli, hogy a többi bróker kiesett, és saját tükörpárját a főszerepre emeli. Így történik a logikai különválás.
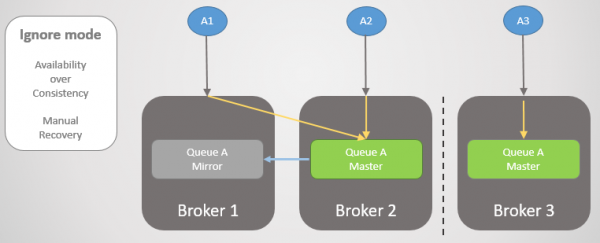
Ábra. 19. Logikai elválás (split-brain). Az írások két fő sorba mennek, és a két másolat eltér.
A kapcsolat helyreáll, de a logikai elválás megmarad. A rendszergazdának manuálisan kell kiválasztania a vesztes oldalt. Az alábbi esetben a rendszergazda újraindítja a Brókert 3. Minden üzenet elveszik, amelyet nem sikerült továbbítania.
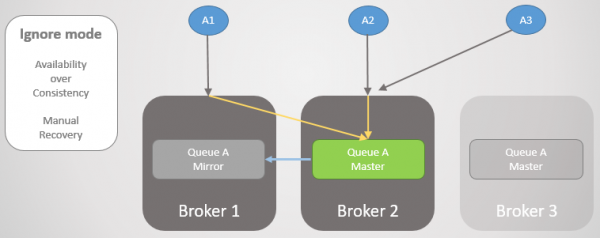
Ábra. 20. A rendszergazda letiltja a Brókert 3.
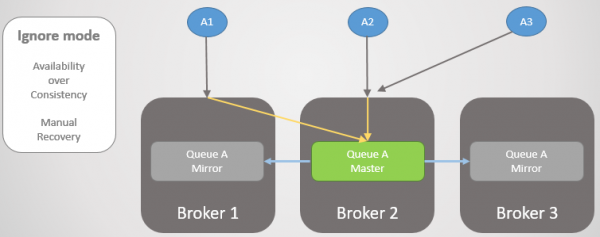
Ábra. 21. A rendszergazda újraindítja a Brókert 3, és az csatlakozik a klaszterhez, elveszítve minden üzenetet, ami ott maradt.
A kapcsolat megszakítása alatt és a helyreállítása után a klaszter és ez a sor rendelkezésre állt az olvasáshoz és íráshoz.
Autoheal mód
Ugyanúgy működik, mint az Ignore mód, azzal a különbséggel, hogy a klaszter automatikusan választja ki a vesztes oldalt a szétválás és a kapcsolat helyreállítása után. A vesztes oldal üresen tér vissza a klaszterbe, és a sor minden olyan üzenetet elveszít, amelyeket csak arra az oldalra küldtek.
Pause Minority mód
Ha el akarjuk kerülni a logikai szétválasztást, akkor az egyetlen lehetőségünk, ha lemondunk az írásról és olvasásról a kisebb oldalon a klaszter szétválasztásakor. Amikor a broker észleli, hogy a kisebb oldalon van, leállítja a működését, azaz lezárja az összes meglévő kapcsolatot és elutasít minden újat. Másodpercenként egyszer ellenőrzi a kapcsolat helyreállítását. Amint a kapcsolat helyreáll, újraindítja a működést és csatlakozik a klaszterhez.
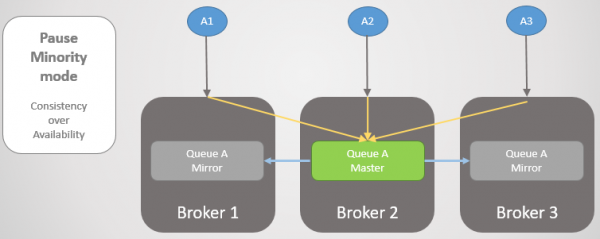
22. ábra. Három kiadó kapcsolódik három brokerhez. A klaszter belsőleg az összes kérést az 2. broker fő sorába irányítja.
Ezután az 1. és 2. broker elkülönül a 3. brokertől. Ahelyett, hogy a tükör másolatát fő brokerre emelné, a 3. broker leállítja működését és elérhetetlenné válik.
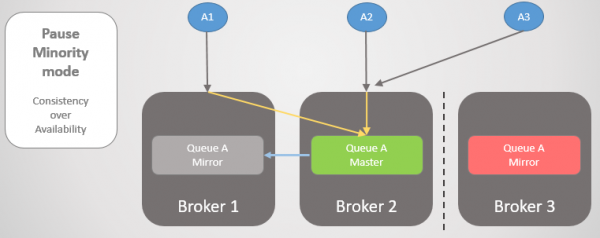
23. ábra. A 3. broker leállítja a működését, bontja az összes kliens kapcsolatát, és elutasítja a csatlakozási kérelmeket.
Amint a kapcsolat helyreáll, visszatér a klaszterbe.
Nézzük meg egy másik példát, ahol a fő sor a 3. brokeren található.
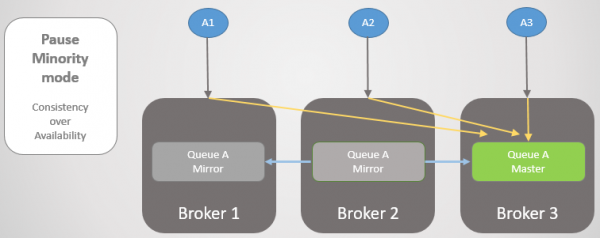
24. ábra. A fő sor a 3. brokeren.
Ezután ismét bekövetkezik a kapcsolat megszakadása. A 3. broker szünetel, mivel a kisebb oldalon van. A másik oldalon a csomópontok észlelik, hogy a 3. broker leállt, így a 1. és 2. broker régebbi tükörmásolata fő brokerre emelkedik.
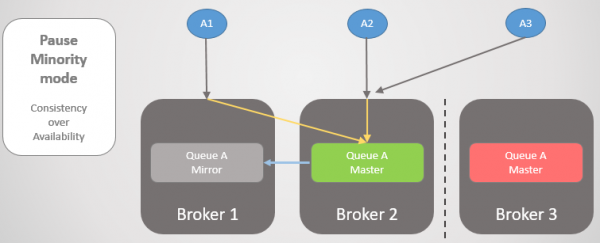
25. ábra. Átmenet a 2. brokerhez, amikor a 3. broker nem elérhető.
Amikor a kapcsolat helyreáll, a 3. broker csatlakozik a klaszterhez.

26. ábra. A klaszter visszatért a normál működéshez.
Itt fontos megérteni, hogy konzistenciát kapunk, de elérhetőséget is biztosíthatunk. ha sikeresen átkonfiguráljuk a klienseket a rész nagyobb részére. A legtöbb helyzetben én a Szüneteltessük a Kisebbséget módot választanám, de ez tényleg a konkrét esettől függ.
Az elérhetőség biztosítása érdekében fontos, hogy a kliensek sikeresen csatlakozzanak a csomóponthoz. Nézzük meg a lehetőségeinket.
A kliensek kapcsolatának biztosítása
Több lehetőségünk van arra, hogy a kapcsolat megszakadása után az ügyfeleket a klaszter fő részére vagy a működő csomópontokra irányítsuk (egy csomópont leállása után). Először is emlékezzünk arra, hogy egy adott sor egy bizonyos csomóponton helyezkedik el, de a forgalomirányítás és a politikák minden csomóponton replikálódnak. Az ügyfelek bármely csomóponthoz csatlakozhatnak, és a belső forgalomirányítás azokat a megfelelő helyre irányítja. De amikor egy csomópont felfüggesztésre kerül, akkor elutasítja a kapcsolatokat, így az ügyfeleknek egy másik csomóponthoz kell csatlakozniuk. Ha egy csomópont leállt, akkor valóban alig tud valamit tenni.
Lehetőségeink:
- A klaszterhez való hozzáférés terheléselosztó segítségével történik, amely egyszerűen ciklikusan végigjárja a csomópontokat, miközben az ügyfelek újrapróbálkoznak a csatlakozással a sikeres befejezésig. Ha egy csomópont nem működik vagy felfüggesztésre került, akkor a csomópontra való kapcsolódási kísérletek kudarcot vallanak, de a következő kísérletek más szerverekhez fognak irányulni (ciklikus módban). Ez alkalmas rövid távú kapcsolatmegszakadásra vagy olyan szerverre, amely gyorsan újraindul.
- A klaszterhez való hozzáférés terheléselosztón keresztül, a felfüggesztett/hibás csomópontok listából való eltávolításával, amint észlelésre kerülnek. Ha ezt gyorsan meg tudjuk tenni, és az ügyfelek képesek újrapróbálkozásra, akkor folyamatos elérhetőséget nyerünk.
- Minden ügyfélnek nyújtsunk egy listát az összes csomópontról, és az ügyfél csatlakozásakor véletlenszerűen választ egyet közülük. Ha a csatlakozási kísérlet hibát ad, akkor a lista következő csomópontjára lép, amíg csatlakozni nem tud.
- Az elérhetetlen/felfüggesztett csomópont forgalmának eltávolítása DNS segítségével. Ezt egy alacsony TTL használatával hajtjuk végre.
Következtetések
A RabbitMQ klaszterezésének saját előnyei és hátrányai vannak. A legnagyobb hátrányok közé tartozik, hogy:
- a klaszterre csatlakozó csomópontok elutasítják adataikat;
- a blokkoló szinkronizáció a sor elérhetetlenségét eredményezi.
Minden nehéz döntés ezekből a két architekturális sajátosságból fakad. Ha a RabbitMQ képes lenne megőrizni az adatokat a klaszter újra csatlakoztatásakor, a szinkronizálás gyorsabban történne. Ha pedig képes lenne nem blokkoló szinkronizálásra, akkor jobban kezelné a nagy sorokat. Ezeknek a két problémának a megoldása komoly javulást hozna a RabbitMQ megbízhatóságában és magas rendelkezésre állásában az üzenetküldő technológia terén. Nem merném ajánlani a RabbitMQ klaszterezését az alábbi helyzetekben:
- Megbízhatatlan hálózat.
- Megbízhatatlan tárolás.
- Nagyon nagy sorok.
A magas rendelkezésre állás beállításaival kapcsolatban a következőket fontolja meg:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignoreSysWOW64autoheal)- megbízható üzenetek
- győződjön meg róla, hogy a kliensek az aktív csomóponthoz csatlakoznak, amikor egy csomópont meghibásodik
Az adatkonzisztencia (adatbiztonság) érdekében a következő beállításokat fontolja meg:
- Publisher Confirms és Manual Acknowledgements a fogyasztó oldalán
ha-promote-on-failure=when-synced, ha a kiadók később újrapróbálkozhatnak, és ha van nagyon megbízható tárolója! Ellenkező esetben állítson be=always.ha-sync-mode=automatic(de a nagy, inaktív sorok esetében szükség lehet kézi módra; továbbá gondolja át, hogy a rendelkezésre állás hiánya üzenetvesztéshez vezethet-e)- Pause Minority üzemmód
- megbízható üzenetek
Még nem beszéltünk minden lehetséges magas rendelkezésre állásról és megbízhatóságról; például arról, hogyan végezhetjük el biztonságosan az adminisztratív eljárásokat (például a gördülő frissítéseket). Beszélni kell a federációról és a Shovel bővítményről is.
Ha még valamit kihagytam, kérlek, jelezd.
Lásd még az én , ahol a RabbitMQ klaszterben készítek kísérleteket Dockeren és Blockade-on, hogy teszteljek néhány üzenetvesztési forgatókönyvet, amelyeket ebben a cikkben írok le.
Előző cikkek a sorozatban:
1. szám —
2. szám —
3. szám —
Forrás: habr.com
