

A Megvizsgáltuk a RabbitMQ klaszterezését a megbízhatóság és a magas rendelkezésre állás érdekében. Most mélyebben belemerülünk az Apache Kafka világába.
Itt a replikáció egysége a partíció. Minden témához tartozik egy vagy több partíció. Minden partíció rendelkezik egy vezetővel, amelynek lehetnek követői vagy nem. A téma létrehozásakor meg kell adni a partíciók számát és a replikációs arányt. A megszokott érték 3, ami három replikát jelent: egy vezetőt és két követőt.
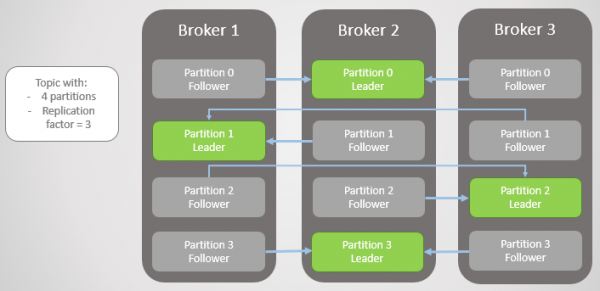
1. ábra. Négy partíció három bróker között elosztva
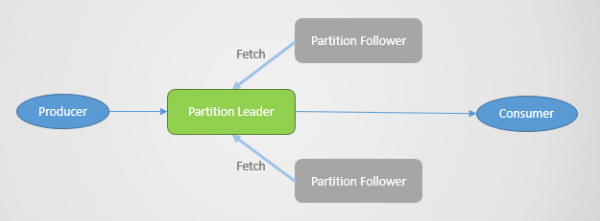
Minden olvasási és írási kérés a vezetőhöz érkezik. A követők időszakonként kérdéseket küldenek a vezetőnek az utolsó üzenetek megszerzésére. A fogyasztók soha nem fordulnak a követőkhöz, azok csupán a redundancia és a megbízhatóság érdekében léteznek.
Partíció hiba
Amikor egy bróker leáll, gyakran több partíció vezetője is meghal. Ezek közül egy másik csomópont követője válik a vezetővé. Valójában ez nem mindig így van, mivel a szinkronizálás tényezője is befolyásol: vannak-e szinkronizált követők, és ha nincsenek, akkor megengedett-e a nem szinkronizált replikára való áttérés. De egyelőre ne bonyolítsuk a dolgokat.
A hálózatból kikerül a 3-as bróker – és a 2-es partícióhoz új vezetőt választanak a 2-es brókerből.
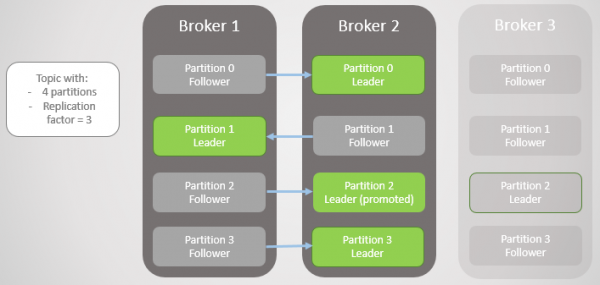
2. ábra. A 3-as bróker meghal, és a 2-es bróker követője új vezetőként kerül a 2-es partícióhoz
Ezután a 1-es bróker is leáll, és az 1-es partíció is elveszíti a vezetőjét, akinek szerepét a 2-es bróker veszi át.
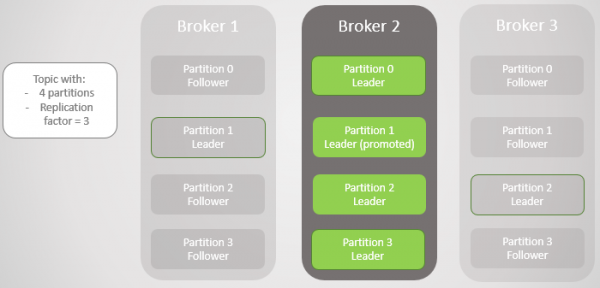
3. ábra. Egyedül maradt bróker. Az összes vezető egy brókerben van, nulla redundanciával
Amikor a 1-es bróker visszatér a hálózatba, négy követőt ad hozzá, biztosítva ezzel valamennyi partíció számára a redundanciát. De az összes vezető továbbra is a 2-es brókernél maradt.
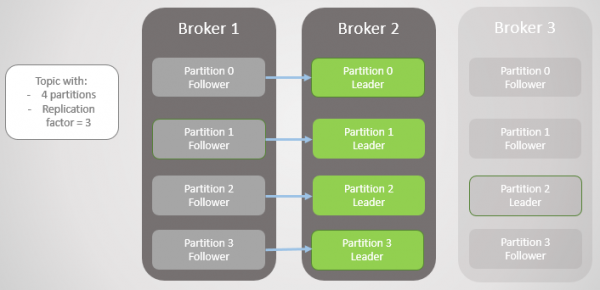
4. ábra. A vezetők a 2-es brókernél maradnak
Amikor a 3-as bróker újraindul, visszatérünk a három replikás partícióhoz. De az összes vezető továbbra is a 2-es brókernél van.
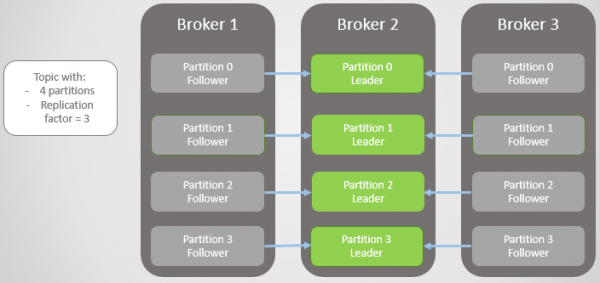
5. ábra. A vezetők kiegyensúlyozatlan elhelyezése az 1-es és 3-as brókerek helyreállítása után
A Kafka rendelkezik egy eszközzel, amely a vezetők jobb újraelosztását teszi lehetővé, mint a RabbitMQ-nál. Ott harmadik féltől származó bővítményt vagy szkriptet kellett használni, amely megváltoztatta a politikákat a fő csomópont migrálásának csökkentésére a redundancia csökkentése érdekében a migráció során. Ezenkívül nagyobb sorok esetén a szinkronizáció idejére a meg nem felelés elfogadásával kellett együtt élni.
A Kafka a vezető preferált replikákkal rendelkezik. Amikor a téma partíciók létrejönnek, a Kafka megpróbálja egyenletesen szétosztani a vezetőket a csomópontok között, és ezeket az első vezetőket preferáltként jelöli meg. Az idő múlásával a szerverek újraindulása, meghibásodások és a kapcsolati hibák miatt a vezetők más csomópontokon is megjelenhetnek, ahogy az a fent leírt szélső esetben is megtörténik.
Ezek kijavítására a Kafka két lehetőséget kínál:
- Opció auto.leader.rebalance.enable=true lehetővé teszi a vezérlőcsomópont számára, hogy automatikusan visszájára rendeljen újra preferált replikákra és így helyreállítsa az egyenletes eloszlást.
- Az adminisztrátor futtathat egy szkriptet kafka-preferred-replica-election.sh a manuális újraosztáshoz.
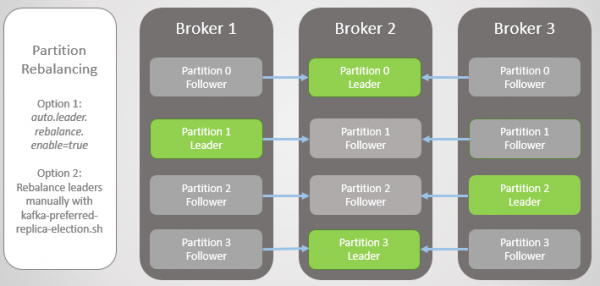
6. ábra. Replikák az újraelosztás után
Ez egy leegyszerűsített hibaeset volt, de a valóság bonyolultabb, bár itt semmi túl nehéz nem áll. Minden az összeszinkronizált replikákra (In-Sync Replicas, ISR) redukálódik.
Az összeszinkronizált replikák (ISR)
Az ISR az a replikák halmaza, amely egy partíciót „összeszinkronizáltnak” tart. Itt van egy vezető, és a követők akár nincsenek is. A követő akkor számít összeszinkronizáltnak, ha az összes vezetői üzenetet pontosan másolta le az időkorlát lejárta előtt replica.lag.time.max.ms.
A követőt eltávolítják az ISR-ből, ha:
- nem kérte az adatok lekérdezését az időkereten belül replica.lag.time.max.ms (halottnak számít)
- nem tudott frissülni az időkereten belül replica.lag.time.max.ms (lassúnak számít)
A követők az időkeretben kérik az adatokat replica.fetch.wait.max.ms, amely alapértelmezetten 500 ms.
Az ISR céljának pontos ismertetéséhez látnunk kell a gyártótól (producer) érkező visszaigazolásokat és néhány hibaesetet. A gyártók választhatják meg, mikor küld a bróker visszaigazolást:
- acks=0, nem küld visszaigazolást
- acks=1, visszaigazolás érkezik, miután a vezető feljegyezte az üzenetet a helyi naplójába
- acks=all, visszaigazolás érkezik, miután az összes ISR replikához elmentették az üzenetet a helyi naplókba
A Kafka terminológiájában, ha az ISR megőrizte az üzenetet, annak „elkötelezése” megtörténik. Az acks=all a legbiztonságosabb opció, de további késleltetést is okoz. Nézzük meg két példa hibát és azt, hogyan kölcsönhatnak a különböző 'acks' opciók az ISR fogalmával.
Acks=1 és ISR
Ebben a példában láthatjuk, hogy ha a vezető nem várja el, hogy minden követő megőrizze az üzenetet, akkor a vezető hibája esetén adatok elveszhetnek. Az átváltás nem szinkronizált követőre engedélyezhető vagy letiltható a beállítással. unclean.leader.election.enable.
Ebben a példában a gyártónak az acks=1 értéke van beállítva. A partíció minden három broker közt elosztva van. A 3-as broker lemaradt, nyolc másodperccel ezelőtt szinkronizálódott a vezetővel és most 7456 üzenettel lemaradt. Az 1-es broker mindössze egy másodpercet késlekedett. A gyártónk gyorsan visszakapja az ack-t, a lassú vagy halott követők várakozása nélkül, akit a vezető nem vár.
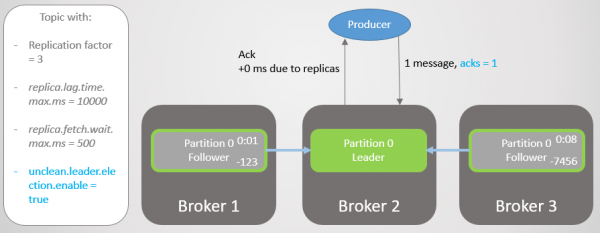
7. ábra. ISR három replikával
A 2-es broker leáll, és a gyártó kapcsolati hibát kap. Miután a vezetőség a 1-es brokerre vált, 123 üzenetet veszítünk el. Az 1-es broker követője az ISR-ben volt, de nem szinkronizálódott teljesen a vezetővel, amikor az leállt.
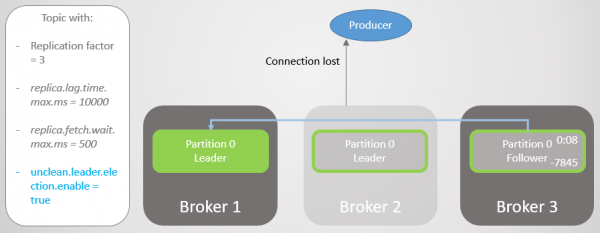
8. ábra. Üzenetek vesznek el a hibák során
A konfigurációban bootstrap.servers a gyártó több brokert sorol fel, és megkérdezheti egy másik brokert, hogy ki lett az új partícióvezető. Ezután kapcsolatot létesít az 1-es brokerrel, és folytatja az üzenetek küldését.
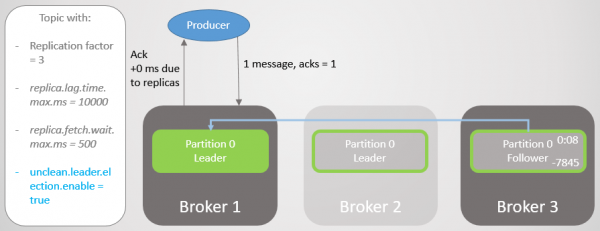
9. ábra. Az üzenetek küldése egy rövid szünet után újraindul
A 3-as broker még inkább lemaradt. Lekérdezések végrehajtására képes, de nem tud szinkronizálódni. Ennek oka lehet a brokers közötti lassú hálózati kapcsolat, tárolási probléma stb. Az ISR-ből eltávolítják. Most az ISR csupán egy replikából áll — a vezetőből! A gyártó továbbra is küldi az üzeneteket, és megkapja a visszaigazolásokat.
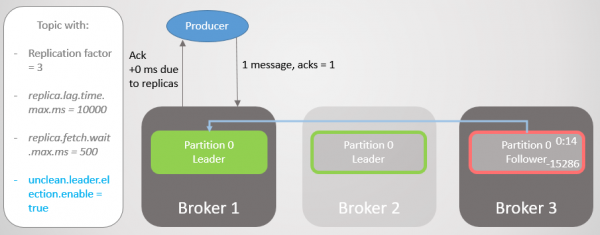
10. ábra. A 3-as broker követője eltávolítva az ISR-ből
Az 1-es broker leáll, és a vezető szerepe a 3-as brokerhez kerül 15286 üzenet veszteséggel! A gyártó kapcsolati hibát kap. Az ISR-en kívülre történő váltás csak a beállítás miatt volt lehetséges. unclean.leader.election.enable=true. Ha ez be van állítva hamis, akkor az átváltás nem történt volna meg, és minden olvasási és írási kérés elutasításra került volna. Ebben az esetben várunk, hogy az 1-es broker visszatérjen az érintetlen adataival a replikában, amely újból átveszi a vezetőséget.
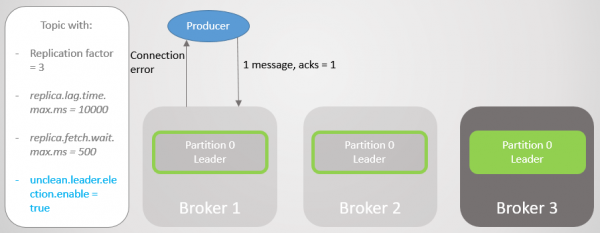
11. ábra. Az 1-es broker leáll. Nagy mennyiségű üzenet veszteség a hiba során
A gyártó kapcsolatot létesít az utolsó brókerrel, és látja, hogy ő most a részleg vezetője. Üzeneteket kezd küldeni a 3. brókernek.
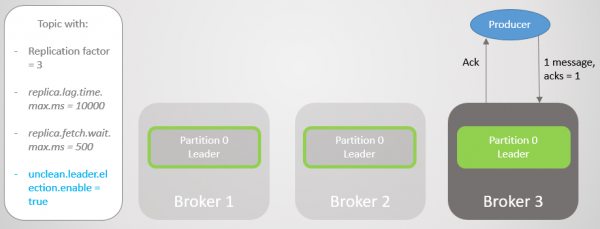
12. ábra. Rövid szünet után az üzenetek ismét a 0. részlegbe kerülnek.
Láttuk, hogy a gyártó folyamatosan küldte az üzeneteket a rövid megszakítások mellett, amikor új kapcsolatokat létesítettek és új vezetőt kerestek. Ez a konfiguráció a rendelkezésre állást biztosítja az összhang fenntartásával (adatbiztonság). A Kafka ezer üzenetet vesztett, de továbbra is új bejegyzéseket fogadott.
Acks=all és ISR
Ismételjük meg ezt a forgatókönyvet, de acks=all. A 3. bróker késlekedése átlagosan négy másodperc. A gyártó üzenetet küld acks=all, és most nem kap gyors választ. A vezető vár arra, hogy az üzenetet az összes replikái az ISR-ben elmentsék.
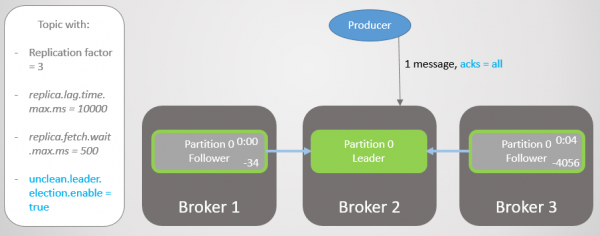
13. ábra. ISR három replikával. Az egyik lassan működik, ami írási késlekedést eredményez.
Négy másodpercnyi további késlekedés után a 2. bróker ack-t küld. Minden replika most teljesen frissítve van.
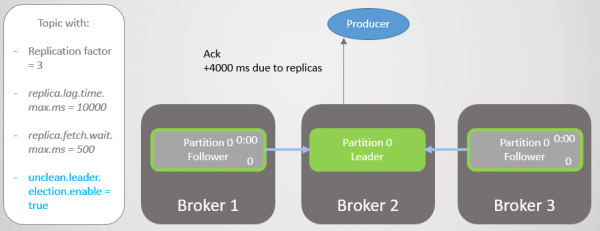
14. ábra. Minden replika menti az üzeneteket és ack-t küld.
A 3. bróker most még jobban lemarad, és törlik az ISR-ből. A késlekedés jelentősen csökken, mivel az ISR-ből eltűntek a lassú replikák. A 2. bróker most csak az 1. brókerre vár, amelynek átlagos késlekedése 500 ms.
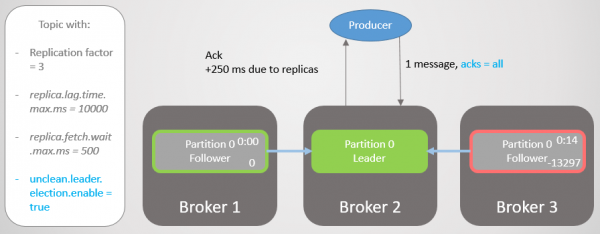
15. ábra. A 3. bróker replikája törlésre kerül az ISR-ből.
Ezután a 2. bróker összeomlik, és a vezetés az 1. brókerre száll át anélkül, hogy üzenetek vesznének el.
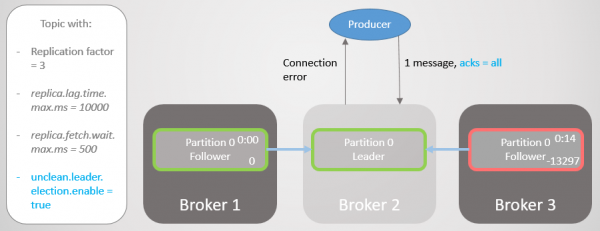
16. ábra. A 2. bróker összeomlik.
A gyártó új vezetőt talál, és elkezd üzeneteket küldeni neki. A késlekedés tovább csökken, mivel most az ISR egy replikából áll! Ezért a beállítás acks=all nem ad redundanciát.
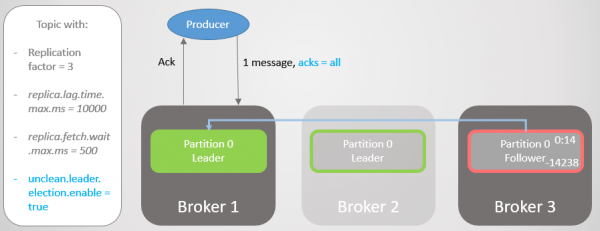
17. ábra. A 1. bróker replikája a vezetést veszi át üzenetek elvesztése nélkül.
Ezután a 1. bróker összeomlik, és a vezetés a 3. brókerre száll át, 14238 üzenet elvesztésével!
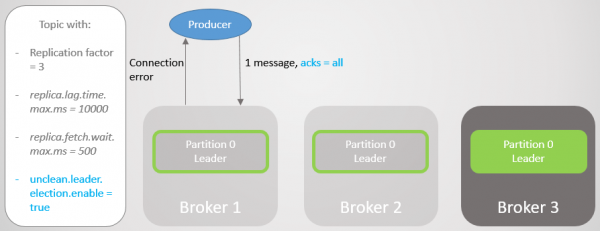
18. ábra. A 1. bróker meghal, és a nem tiszta beállítással történő vezetésváltás kiterjedt adatok elvesztését okozza.
Nem kellett volna beállítanunk a beállítást unclean.leader.election.enable az értékre igaz. Alapértelmezés szerint ez hamis. A beállítás acks=all a unclean.leader.election.enable=true biztosítja a rendelkezésre állást némi további adatbiztonsággal. De, ahogy látod, még mindig elveszíthetünk üzeneteket.
De mi van, ha növelni akarjuk az adatok biztonságát? Beállíthatjuk a unclean.leader.election.enable = false, de ez nem feltétlenül véd meg minket az adatvesztéstől. Ha a vezető hirtelen leáll, és vele együtt az adatok is eltűnnek, akkor az üzenetek továbbra is elvesznek, és hozzáférhetetlenné válnak, amíg az adminisztrátor helyre nem állítja a helyzetet.
Jobb biztosítani az összes üzenet redundanciáját, ellenkező esetben érdemes lemondani a feljegyzésről. Így legalább a bróker szempontjából az adatvesztés lehetősége csak két vagy több egyidejű hiba esetén merül fel.
Acks=all, min.insync.replicas és ISR
A téma konfigurációja min.insync.replicas növeljük az adatok biztonsági szintjét. Nézzük át újra a múltbeli forgatókönyv utolsó részét, de ezúttal min.insync.replicas=2.
Tehát a 2. brókernek van egy replika vezetője, míg a követő a 3. brókerből ki lett zárva az ISR-ből.
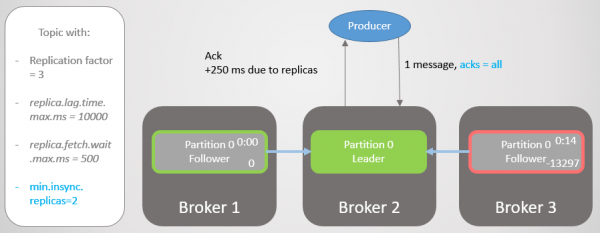
19. ábra. ISR két replikával
A 2. bróker leáll, a vezetés átkerül az 1. brókerhez anélkül, hogy üzenetek veszedelmesen eltűnnének. De most az ISR csak egy replikát tartalmaz. Ez nem felel meg a minimális követelménynek a feljegyzések megszerzésére, ezért a bróker hibát jelez a feljegyzési kísérlet során. NotEnoughReplicas.
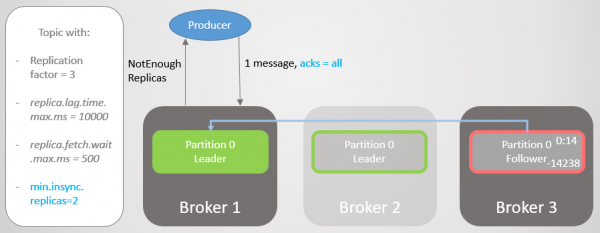
20. ábra. Az ISR száma egyel alacsonyabb, mint amit a min.insync.replicas megad.
Ez a konfiguráció a rendelkezésre állást az összeférhetőség érdekében áldozza fel. Mielőtt megerősítenénk az üzenetet, biztosítjuk, hogy legalább két replikára rögzítve legyen. Ez sokkal nagyobb bizalmat ad a gyártónak. Itt az üzenetek vesztése csak abban az esetben lehetséges, ha két replika egy időben meghibásodik egy rövid időintervallumban, míg az üzenet nem lett replikálva egy további követőre, ami valószínűtlen. De ha szuperparanoid vagy, beállíthatod az 5-ös replikációs arányt, és min.insync.replicas 3-ra. Itt egyszerre három brókernak kellene leállnia az adatvesztéshez! Természetesen az ilyen megbízhatóságért extra késéssel fizetsz.
Amikor a rendelkezésre állás szükséges az adatok biztonságához
Mint a , néha a rendelkezésre állás szükséges az adatok biztonságához. Ezen érdemes elgondolkodni:
- Visszaadhat-e a kiadó egyszerűen hibát, és a felette álló szolgáltatás vagy felhasználó később megpróbálhatja újra?
- Visszatarthat-e a kiadó egy üzenetet helyben, vagy az adatbázisban, hogy később újrapróbálkozzon?
Ha a válasz negatív, akkor a rendelkezésre állás optimalizálása növeli az adatok biztonságát. Kevesebb adatot fogsz veszíteni, ha a rendelkezésre állást választod a feljegyzéstől való lemondás helyett. Így minden a kiegyensúlyozás keresésére vezethető vissza, és a megoldás a konkrét helyzettől függ.
Az ISR értelme
Az ISR beállítás lehetővé teszi az optimális egyensúly kiválasztását az adatok biztonsága és a késleltetés között. Például biztosítja a rendelkezésre állást a többszörös replikák hibája esetén, minimalizálva a halott vagy lassú replikák késleltetésre gyakorolt hatását.
Mi magunk választjuk ki az értéket replica.lag.time.max.ms az igényeinknek megfelelően. Lényegében ez a paraméter azt jelenti, hogy mekkora késleltetést hajlandók vagyunk elviselni acks=all. Az alapértelmezett érték tíz másodperc. Ha ez túl hosszú a számotokra, csökkenthetitek. Ekkor növekedni fog az ISR változások frequenciája, mivel a követők gyakrabban lesznek eltávolítva és hozzáadva.
A RabbitMQ esetében egyszerű tükörhalmazok vannak, amelyeket replikálni kell. A lassú tükrök további késleltetést okoznak, a halott tükrök válaszára pedig a csomagok élettartamának lejártáig kell várni, amelyek ellenőrzik minden csomópont elérhetőségét (net tick). Az ISR érdekes módja annak, hogy elkerüljük ezeket a késleltetési problémákat. De kockáztatjuk a fölösleg elvesztését, mivel az ISR csak a vezetőre csökkenthető. E kockázat elkerülése érdekében használja a következő beállítást. min.insync.replicas.
Az ügyfelek csatlakozási garanciája
A beállításokban bootstrap.servers a gyártó és a fogyasztó számára több brókert megadhatunk az ügyfelek csatlakoztatására. Az ötlet az, hogy ha az egyik csomópont lekapcsol, több tartalék marad, amellyel az ügyfél kapcsolatot tud létesíteni. Ezek nem feltétlenül a particionálás vezetői, hanem egyszerűen egy lépés a kezdeti betöltéshez. Az ügyfél megkérdezheti őket, hogy melyik csomóponton található a partició vezetője az olvasáshoz/íráshoz.
A RabbitMQ-ban az ügyfelek bármely csomóponthoz csatlakozhatnak, és a belső irányítás a kéréseket a megfelelő helyre küldi. Ez azt jelenti, hogy a RabbitMQ elé terheléselosztót állíthatsz. A Kafka megköveteli, hogy az ügyfelek kifejezetten ahhoz a csomóponthoz csatlakozzanak, ahol a megfelelő partició vezetője van. Ilyen helyzetben nem lehet terheléselosztót alkalmazni. A lista bootstrap.servers kritikus fontosságú, hogy az ügyfelek elérhessék a szükséges csomópontokat és megtalálják őket hiba esetén.
A Kafka konszenzus architektúrája
Eddig nem tárgyaltuk, hogyan tud a klaszter a bróker leállásáról, és hogyan választanak új vezetőt. A Kafka hálózati szétválasztásokkal kapcsolatos működésének megértéséhez először meg kell értenünk a konszenzus architektúráját.
Minden Kafka klasztert együtt telepítenek a Zookeeper klaszterrel — ez egy elosztott konszenzus szolgáltatás, amely lehetővé teszi a rendszer számára, hogy elérje a konszenzust egy adott állapotban, prioritást adva a konzisztenciának a rendelkezésre állással szemben. Az olvasási és írási műveletek jóváhagyásához a Zookeeper többségi egyetértése szükséges.
A Zookeeper tárolja a klaszter állapotát:
- A témák, partíciók listája, a konfiguráció, a jelenlegi vezető példányok, a preferált példányok.
- A klaszter tagjai. Minden broker pingelni a Zookeeper klasztert. Ha az nem kap pinget egy adott időtartamon belül, a Zookeeper a brokert elérhetetlennek jelöli.
- A vezérlő fő és tartalék csomópontjainak kiválasztása.
A vezérlő csomópont egy Kafka broker, amely a példányok vezetőinek megválasztásáért felelős. A Zookeeper értesítéseket küld a vezérlőnek a klaszter tagságáról és a téma változásairól, és a vezérlőnek ezek szerint kell cselekednie.
Például vegyünk egy új témát tíz partícióval és 3-as replikációs tényezővel. A vezérlőnek ki kell választania minden partíció vezetőjét, miközben optimálisan kell elosztania a vezetőket a broker-ek között.
Minden partíció esetében a vezérlő:
- frissíti a Zookeeper-ben az ISR és vezető információkat;
- minden broker-nek, amely ezt a partíciót replikálja, megküldi a LeaderAndISRCommand parancsot, értesítve a broker-eket az ISR-ről és a vezetőről.
Amikor a vezető broker leáll, a Zookeeper értesítést küld a vezérlőnek, aki kiválaszt egy új vezetőt. A vezérlő először frissíti a Zookeeper-t, majd parancsot küld minden brokernek, értesítve őket a vezetőség változásáról.
Minden vezető felelős az ISR halmazért. A konfigurálás replica.lag.time.max.ms meghatározza, hogy ki kerül oda. Az ISR változása esetén a vezető új információkat ad át a Zookeeper-nek.
A Zookeeper mindig tájékoztatva van minden változásról, így ha hiba lép fel, a vezetés zökkenőmentesen átvált az új vezetőre.
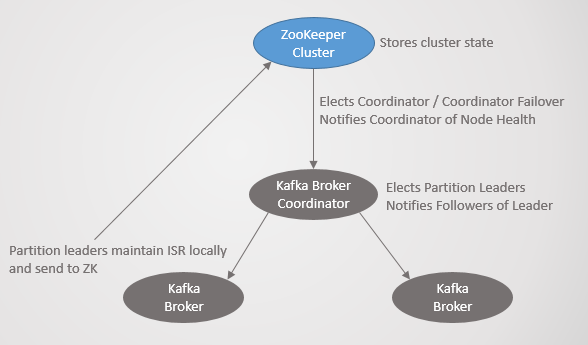
21. ábra. Kafka konszenzus
Replikációs protokoll
A replikáció részleteinek megértése segít jobban megérteni a potenciális adatvesztési forgatókönyveket.
Lekérdezések, Log End Offset (LEO) és Highwater Mark (HW)
Megvizsgáltuk, hogy a követők időnként lekérdezéseket küldenek a vezetőnek. Az alapértelmezett intervallum 500 ms. Ez eltér a RabbitMQ-tól, ahol a replikálás nem a válaszsor tükör, hanem a mester általi kezdeményezés alapján történik. A mester nyomja a változásokat a tükrökre.
A vezető és minden követő tárolja a napló végének eltolódását (Log End Offset, LEO) és a Highwater címkét (HW). Az LEO címke tárolja az utolsó üzenet eltolódását a helyi replikában, míg a HW az utolsó commit eltolódását. Ne feledje, hogy a "commit" státuszhoz a üzenetet minden replikába el kell menteni az ISR-ben. Ez azt jelenti, hogy az LEO általában egy kicsit megelőzi a HW-t.
Amikor a vezető üzenetet kap, azt helyben tárolja. A követő lekérdezést küld, átadva a saját LEO-ját. Ezt követően a vezető üzenetcsomagot küld, kezdve ezzel a LEO-val, és átadja a jelenlegi HW-t. Amikor a vezető értesítést kap, hogy minden replikátor eltárolta az üzenetet a megadott eltolódással, áthelyezi a HW címkét. Csak a vezető képes áthelyezni a HW-t, így minden követő megtudja a jelenlegi értéket a lekérdezéseik válaszaiban. Ez azt jelenti, hogy a követők lemaradhatnak a vezetőtől mind üzenetekben, mind a HW tudásával kapcsolatban. A fogyasztók csak a jelenlegi HW-ig kapják meg az üzeneteket.
Figyeljen arra, hogy a "tárolt" (persisted) az memóriába írt, nem pedig lemezen tárolt. A teljesítmény érdekében a Kafka előre meghatározott időközönként szinkronizál a lemezen. A RabbitMQ-nak is van egy ilyen időköze, de csak akkor küld vissza megerősítést a publikálónak, amikor a mester és minden tükör lemezre írta az üzenetet. A Kafka fejlesztői a teljesítmény érdekében úgy döntöttek, hogy az üzenet memóriába írásakor azonnal visszaküldik az ack-t. A Kafka arra játszik, hogy a redundancia kompenzálja a kockázatot, hogy a megerősített üzenetek rövid távon csak memóriában tárolódjanak.
Vezető leállás
Amikor a vezető meghibásodik, a Zookeeper értesíti a vezérlőt, amely ezt követően kiválaszt egy új vezető replikát. Az új vezető beállít egy új HW címkét a saját LEO-jához képest. Ezt követően a követők értesítést kapnak az új vezetőről. A Kafka verziójától függően a követő két forgatókönyv közül választ:
- Megszorítja a helyi naplót a megismert HW-ig, és a új vezetőnek üzenetlekérdezést küld az ezen címke utáni üzenetekre.
- Küldjön egy kérést a vezetőnek, hogy megtudja a HW-t a vezetővé választásának időpontjában, majd vágja vissza a naplót erre az eltolásra. Ezután elkezd periódikus kéréseket végezni a mintavételezésre, kezdve ezzel az eltolással.
A követőnek vissza kell vágnia a naplót az alábbi okok miatt:
- Amikor a vezető meghibásodik, az ISR készletből az első követő, aki be van jegyezve a Zookeeperbe, megnyeri a választásokat és vezetővé válik. Minden követő az ISR-ben, noha 'szinkronizáltak', nem biztos, hogy a volt vezetőtől megkapták az összes üzenet másolatát. Teljesen lehetséges, hogy a választott követőnek nincs a legfrissebb másolata. A Kafka garantálja, hogy a replikák között nincs eltérés. Így a különbségek elkerülése érdekében minden követőnek vissza kell vágnia a naplóját az új vezető HW értékéig a vezetővé választásának időpontjában. Ez egy újabb oka annak, hogy a konfigurálás acks=all ennyire fontos a konzisztencia szempontjából.
- Az üzenetek időszakonként leíródnak a lemezekre. Ha a klaszter összes csomópontja egyszerre hibásodott meg, akkor a lemezeken eltérő eltolásokkal rendelkező replikák maradnak. Teljesen lehetséges, hogy amikor a brókerek visszatérnek a hálózatba, az új vezető, akit választanak, lemarad a követőktől, mert ő korábban tárolta a lemezen az adatokat.
Újra csatlakozás a klaszterhez
Újra csatlakozáskor a replikák ugyanolyan módon lépnek be, mint a vezető meghibásodásakor: ellenőrzik a vezető replikáját és visszavágják a naplójukat a HW-jához (a választás időpontjában). Összehasonlításképpen, a RabbitMQ a csatlakozott csomópontokat teljesen újként kezeli. Mindkét esetben a bróker elveti az összes meglévő állapotot. Ha automatikus szinkronizálás történik, akkor a mesternek minden jelenlegi tartalmat teljesen replikálnia kell az új tükörbe, 'ja, hogy a világ várjon'. Ezen művelet során a mester nem fogad el olvasási vagy írási műveleteket. Ez a megközelítés problémákat okoz nagy sorok esetén.
A Kafka — egy elosztott napló, és összességében több üzenetet tárol, mint a RabbitMQ sor, ahol az adatok eltávolításra kerülnek a sorból, miután el lettek olvasva. Az aktív soroknak viszonylag kicsiknek kell maradniuk. De a Kafka egy olyan napló, amely saját tárolási politikával rendelkezik, amely napok vagy hetek időtartamot állíthat be. A sor zárolási és teljes szinkronizációs megközelítése teljesen elfogadhatatlan egy elosztott napló esetében. Ehelyett a Kafka követői egyszerűen levágják a naplójukat a HW vezetőhöz (az ő megválasztásának időpontjában), ha a másolatuk megelőzi a vezetőt. A valószínűbb esetben, amikor a követő lemarad, egyszerűen lekérdezéseket kezdenek végezni, kezdve a jelenlegi LEO-juktól.
Az új vagy újraegyesített követők az ISR-en kívül kezdik, és nem vesznek részt a commitokban. Egyszerűen a csoport mellett dolgoznak, és gyorsan kapják az üzeneteket, amíg be nem érnek a vezetőhöz és be nem lépnek az ISR-be. Itt nincs zárolás, és nem szükséges minden adatokat eldobni.
Konzisztencia megsértése
A Kafka több komponenssel rendelkezik, mint a RabbitMQ, ezért itt bonyolultabb viselkedések figyelhetők meg, amikor a klaszterben megszakad a kapcsolat. De a Kafka-t alapvetően klaszterek számára tervezték, így a megoldások nagyon jól átgondoltak.
Az alábbiakban néhány kapcsolati megszakítással kapcsolatos forgatókönyvet talál:
- Forgatókönyv 1. A követő nem látja a vezetőt, de még mindig látja a Zookeeper-t.
- Forgatókönyv 2. A vezető nem lát egyetlen követőt sem, de még mindig látja a Zookeeper-t.
- Forgatókönyv 3. A követő látja a vezetőt, de nem látja a Zookeeper-t.
- Forgatókönyv 4. A vezető látja a követőket, de nem látja a Zookeeper-t.
- Forgatókönyv 5. A követő teljesen elkülönült a többi Kafka csomóponttól és a Zookeeper-től.
- Forgatókönyv 6. A vezető teljesen elkülönült a többi Kafka csomóponttól és a Zookeeper-től.
- Forgatókönyv 7. A Kafka vezérlő csomópont a másik Kafka csomópontot nem látja.
- Forgatókönyv 8. A Kafka vezérlő nem látja a Zookeeper-t.
Minden forgatókönyvhez saját viselkedés tartozik.
Forgatókönyv 1. A követő nem látja a vezetőt, de még mindig látja a Zookeeper-t.
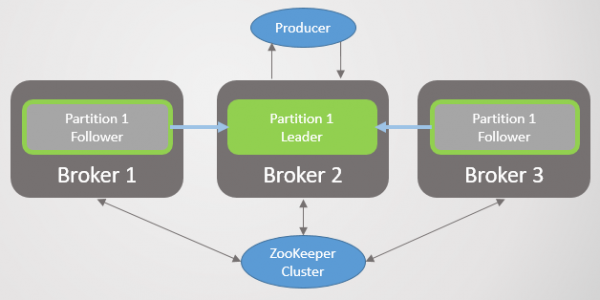
Ábra 22. Forgatókönyv 1. ISR három példányból.
A kapcsolat megszakítása a 3-as brókert a 1-es és 2-es brókertől, de a Zookeeper-től nem választja el. A 3-as bróker többé nem tud lekérdezéseket végezni. Az idő leteltével. replica.lag.time.max.ms Eltávolítják az ISR-ből és nem vesz részt az üzenetek elkötelezésében. Amint a kapcsolat helyreáll, újra megkezdi a lekérdezéseket és csatlakozik az ISR-hez, amikor utoléri a vezetőt. A Zookeeper továbbra is kapja a pingeket, és azt hiszi, hogy a bróker él és egészséges.
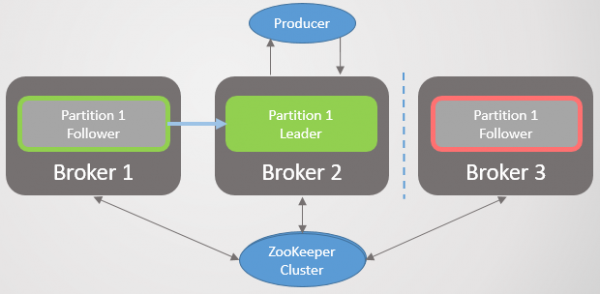
Ábra 23. Forgatókönyv 1. A bróker eltávolításra kerül az ISR-ből, ha nem kap lekérdezést tőle a replica.lag.time.max.ms intervallum alatt.
Nincs logikai felosztás (split-brain) vagy csomópont felfüggesztése, mint a RabbitMQ esetében. Ehelyett a redundancia csökken.
Forgatókönyv 2. A vezető nem lát egyetlen követőt sem, de még mindig látja a Zookeeper-t.
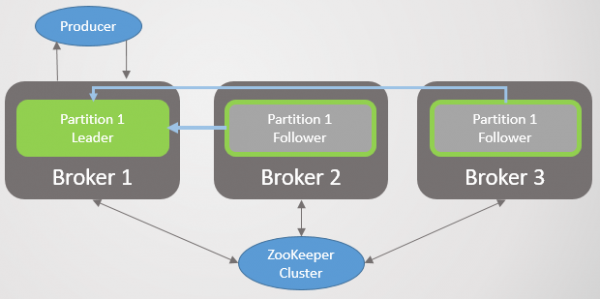
Ábra 24. Forgatókönyv 2. A vezető és két követő.
A hálózati kapcsolat megszakad a vezető és a követők között, de a bróker még mindig látja a Zookeeper-t. Mint az első forgatókönyvben, az ISR összehúzódik, de ezúttal csak a vezetőre, mivel minden követő leáll a lekérdezések küldésével. Ismételten, nincs logikai felosztás. Helyette a redundancia elvesztése történik az új üzeneteknél, amíg a kapcsolat helyre nem áll. A Zookeeper továbbra is kap pingeket, és azt hiszi, hogy a bróker él és egészséges.
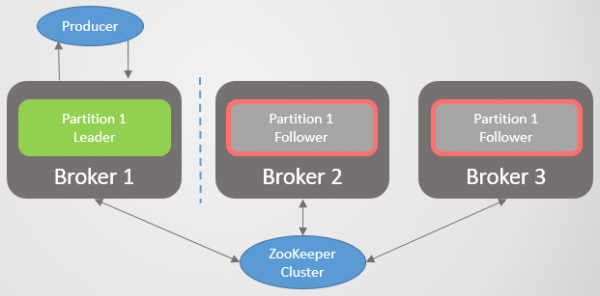
Ábra 25. Forgatókönyv 2. Az ISR csak a vezetőre szűkült.
Forgatókönyv 3. A követő látja a vezetőt, de nem látja a Zookeeper-t.
A követő el van választva a Zookeeper-től, de nem a brókertől a vezetéssel. Ennek eredményeként a követő továbbra is küldi a lekérdezéseket és tagja marad az ISR-nek. A Zookeeper már nem kap pingeket, és regisztrálja a bróker leállását, de mivel ez csak egy követő, a helyreállás után nincs következménye.
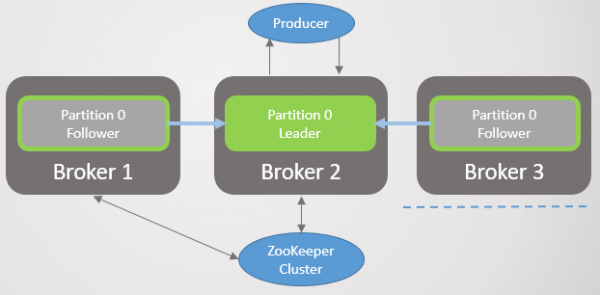
Ábra 26. Forgatókönyv 3. A követő továbbra is küldi a lekérdezéseket a vezetőnek.
Forgatókönyv 4. A vezető látja a követőket, de nem látja a Zookeeper-t.
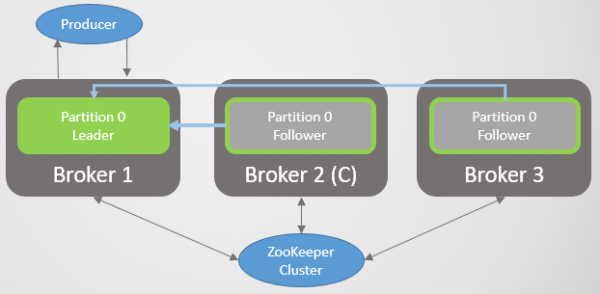
Ábra 27. Forgatókönyv 4. A vezető és két követő.
A vezető el van választva a Zookeeper-től, de nem a követő brókerektől.
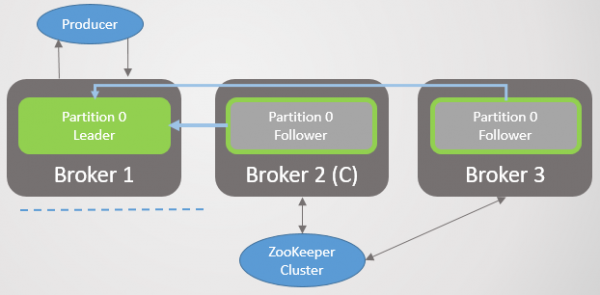
Ábra 28. Forgatókönyv 4. A vezető el van szigetelve a Zookeeper-től.
Néhány idő elteltével a Zookeeper regisztrálja a bróker leállását és értesíti a vezérlőt. Az új vezetőt a követők közül választja ki. Azonban az eredeti vezető továbbra is azt fogja gondolni, hogy ő a vezető, és folytatni fogja a felvételek fogadását. acks=1. A követők már nem küldenek neki lekérdezéseket, ezért ő halottnak fogja őket tartani, és megpróbálja az ISR-t önmagára összeszorítani. De mivel nincs kapcsolata a Zookeeper-rel, nem fogja tudni megtenni, és ezen a ponton le fog mondani a további felvételek fogadásáról.
Üzenetek acks=all nem kapnak megerősítést, mert először az ISR minden replikát tartalmaz, és az üzenetek nem jutnak el hozzájuk. Amikor az eredeti vezető megpróbálja eltávolítani őket az ISR-ből, nem tudja ezt megtenni, és teljesen leállítja az összes üzenet fogadását.
Az ügyfelek hamarosan észreveszik a vezérváltást, és elkezdenek feljegyzéseket küldeni az új szerverre. Amint a hálózat helyreáll, az eredeti vezető látja, hogy már nem vezető, és levágja a naplóját az új vezető HW értékére, amely a hiba pillanatában volt, hogy elkerülje a naplók eltéréseit. Ekkor elkezdi új vezetőtől lekérni a másolatokat. Az összes eredeti vezető feljegyzése, amelyet nem replikáltak az új vezetővel, elveszik. Vagyis elvesznek az üzenetek, amelyeket az eredeti vezető nem erősített meg azokban a néhány másodpercben, amikor két vezető működött.
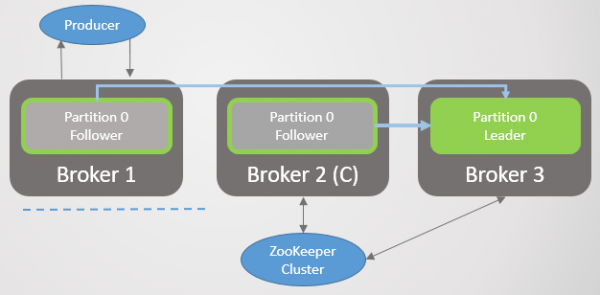
33. ábra. 4. forgatókönyv. A vezető az 1-es brokerben követővé válik a hálózat helyreállítása után
5. forgatókönyv. A követő teljesen el van különítve a többi Kafka csomóponttól és a Zookeeper-től
A követő teljesen el van különítve a többi Kafka csomóponttól és a Zookeeper-től. Egyszerűen eltávolítják az ISR-ből, amíg a hálózat helyre nem áll, majd utoléri a többieket.

34. ábra. 5. forgatókönyv. Az elszigetelt követő eltávolítása az ISR-ből
6. forgatókönyv. A vezető teljesen el van különítve a többi Kafka csomóponttól és a Zookeeper-től.
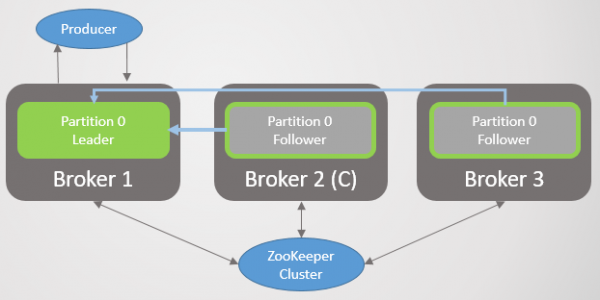
35. ábra. 6. forgatókönyv. A vezető és két követő
A vezető teljesen el van különítve a követőitől, a kontrollerétől és a Zookeeper-től. Rövid időre továbbra is fogadni fogja a feljegyzéseket a acks=1.
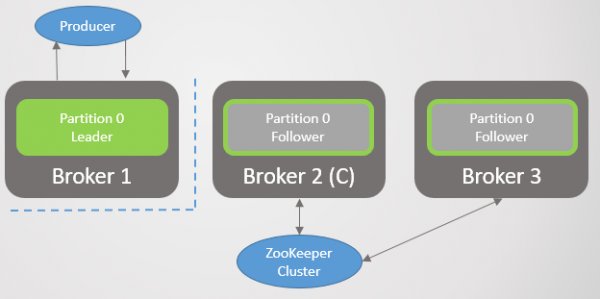
36. ábra. 6. forgatókönyv. A vezető elszigetelése a többi Kafka csomóponttól és a Zookeeper-től
A kérések elmaradásával, replica.lag.time.max.ms, próbálni fogja a legkisebbre zsugorítani az ISR-t, de nem tudja ezt megtenni, mivel nincs kapcsolat a Zookeeper-rel, akkor leállítja az összes feljegyzés fogadását.
Közben a Zookeeper halottnak nyilvánítja az elszigetelt brokert, és a kontroller új vezetőt választ.
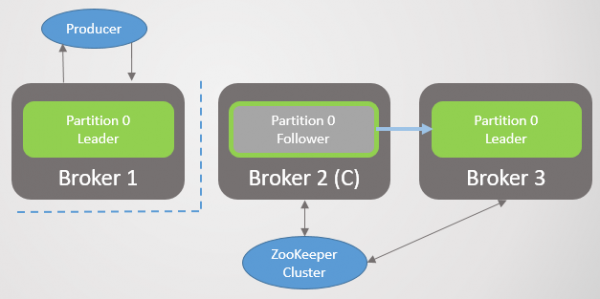
37. ábra. 6. forgatókönyv. Két vezető
Az eredeti vezető néhány másodpercig fogadhatja a feljegyzéseket, de ezután leállítja az összes üzenet fogadását. Az ügyfelek 60 másodpercenként frissítik a legutóbbi metaadatokat. Értesítést kapnak a vezérváltásról, és elkezdenek feljegyzéseket küldeni az új vezetőnek.
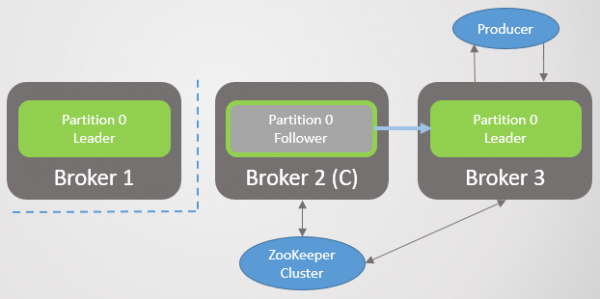
38. ábra. 6. forgatókönyv. A gyártók át kapcsolnak az új vezetőre
Minden megerősített bejegyzés elveszik, amelyet az eredeti vezető készített a kapcsolat megszakítása óta. Amint a hálózat helyreáll, az eredeti vezető a Zookeeper-en keresztül észleli, hogy már nem vezető. Ekkor levágja a naplóját az új vezető HW-ának állapotáig a megválasztás időpontjában, és követőként kezd el lekérdezéseket küldeni.
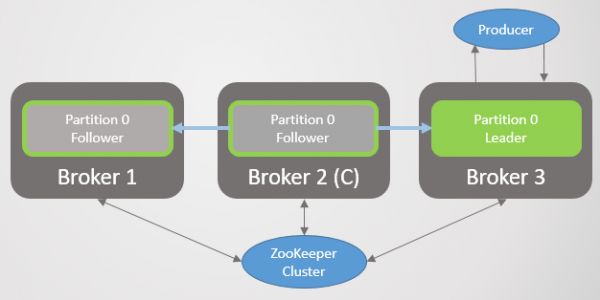
34. ábra. 6. forgatókönyv. Az eredeti vezető követővé válik a hálózat kapcsolatának helyreállítása után
Ebben a helyzetben rövid időre logikai szétválás figyelhető meg, de csak akkor, ha acks=1 és min.insync.replicas szintén 1. A logikai szétválás automatikusan megszűnik, amikor a hálózat helyreáll, amikor az eredeti vezető megérti, hogy már nem vezető, vagy amikor minden ügyfél megérti, hogy a vezető megváltozott, és elkezdenek írni az új vezetőnek - attól függően, hogy mi történik előbb. Mindenesetre néhány üzenet elveszik, de csak acks=1.
Van egy másik változata ennek a forgatókönyvnek, amikor közvetlenül a hálózat szétválása előtt a követők lemaradtak, és a vezető az ISR-t egyetlen saját magára szorította. Ekkor izolálódik a kapcsolat megszűnése miatt. Új vezetőt választanak, de az eredeti vezető továbbra is fogad bejegyzéseket, anélkül, hogy acks=all, mert az ISR-ben rajta kívül senki sincs. Ezek a bejegyzések elvesznek a hálózat helyreállítása után. Az egyetlen módja ennek a helyzetnek a elkerülésére - min.insync.replicas = 2.
7. forgatókönyv. A Kafka vezérlőcsomópont nem lát másik Kafka csomópontot
Általánosságban, miután a kapcsolat megszakadt egy Kafka csomóponttal, a vezérlő nem tudja átadni neki a vezetőváltoztatásról szóló információt. A legrosszabb esetben ez rövid távú logikai szétválást eredményez, mint a 6. forgatókönyvben. Gyakran előfordul, hogy a bróker egyszerűen nem válik vezetőjelöltté a legutolsó hiba esetén.
8. forgatókönyv. A Kafka vezérlő nem látja Zookeeper-t
A leválasztott vezérlő nem kap pingi üzenetet Zookeeper-től, és új Kafka csomópontot választ vezérlőnek. Az eredeti vezérlő továbbra is úgy képzelheti el magát, de nem kap értesítést Zookeeper-től, ezért nem lesz semmilyen feladata. Amint a hálózat helyreáll, rájön, hogy már nem vezérlő, hanem egy szokványos Kafka csomóponttá vált.
Következtetések a forgatókönyvekből
Azt látjuk, hogy a követők kapcsolati elvesztése nem vezet az üzenetek elvesztéséhez, hanem csak ideiglenesen csökkenti a redundanciát, míg a hálózat helyreáll. Ez természetesen adatvesztéshez vezethet, ha egy vagy több csomópont elveszik.
Ha a kapcsolat elvesztése miatt a vezető leválik a Zookeeperről, ez üzenetvesztéshez vezethet a acks=1. A Zookeeperrel való kapcsolat hiánya rövid távú logikai szétválást okoz két vezető között. Ezt a problémát a acks=all.
A parameter min.insync.replicas két vagy több replikára vonatkozó paraméter biztosítja, amely további garanciákat ad arra, hogy az ilyen rövid távú forgatókönyvek ne vezessenek üzenetvesztéshez, mint a 6. forgatókönyv.
Összefoglalás az üzenetvesztésről
Soroljunk fel minden lehetséges módot, ahogy adatokat lehet elveszíteni a Kafka-ban:
- Bármilyen vezetői hiba, ha az üzeneteket a következő módon erősítették meg: acks=1
- Bármely nem tiszta (unclean) vezetőváltás, tehát ha a követő kívül esik az ISR-en, még a acks=all
- A vezető izolációja a Zookeeper-től, ha az üzeneteket a következő módon erősítették meg: acks=1
- Teljes vezetői izoláció, aki már összenyomta az ISR csoportot csak önmagára. Minden üzenet elveszik, még a acks=all. Ez csak akkor igaz, ha min.insync.replicas=1.
- A szakasz összes csomópontjának egyidejű hibái. Mivel az üzeneteket memóriából erősítik meg, néhány még nem íródott a lemezre. A szerverek újraindítása után néhány üzenet hiányozhat.
A nem tiszta vezetőváltások elkerülhetők vagy azok megtiltásával, vagy legalább kettő redundanciával. A legmegbízhatóbb konfiguráció a acks=all és min.insync.replicas több mint 1.
A RabbitMQ és a Kafka megbízhatóságának közvetlen összehasonlítása
A megbízhatóság és a magas rendelkezésre állás biztosítása érdekében mindkét platform elsődleges és másodlagos replikálási rendszert valósít meg. Azonban a RabbitMQ-nak van egy Achilles-sarka. Hiba után a csomópontok eldobják adataikat, és a szinkronizáció blokkolva van. Ez a kettős csapás megkérdőjelezi a nagy sorok tartósságát a RabbitMQ-ban. Be kell érnie vagy a redundancia csökkentésével, vagy a hosszú blokkokkal. A redundancia csökkentése növeli a tömeges adatvesztés kockázatát. De ha a sorok kicsik, akkor a redundancia biztosítása érdekében rövid elérhetetlenségi időszakokkal (néhány másodperc) elvégzett újrapróbálkozása segítségével kezelhetők.
A Kafka nem szenved ilyen problémában. Csak az adatokat dobja el, amelyek eltérnek a vezető és a követő pontjaitól. Minden közös adat megmarad. Ezen kívül a replikáció nem blokkolja a rendszert. A vezető folytatja a feljegyzéseket, amíg az új követő utoléri, így a devopsok számára a klaszterhez való csatlakozás vagy újracsatlakozás triviális feladattá válik. Természetesen még mindig vannak olyan problémák, mint a hálózati sávszélesség a replikáció során. Ha több követőt adunk hozzá egyszerre, akkor a sávszélesség határával találkozhatunk.
A RabbitMQ jobb megbízhatóságot kínál a klaszterben lévő több szerver egyidejű meghibásodása esetén. Ahogy már említettük, a RabbitMQ csak akkor küld visszaigazolást a publikálónak, miután a mester és az összes tükör lemezre írta az üzenetet. De ez további késlekedést okoz két okból:
- fsync néhány száz milliszekundumonként
- A tükör meghibásodását csak a csomagok élettartamának lejárta után lehet észlelni, amelyek ellenőrzik minden csomópont elérhetőségét (net tick). Ha a tükör lelassul vagy összeomlik, az késleltetést ad.
A Kafka arra támaszkodik, hogy ha az üzenet több csomóponton van tárolva, az üzeneteket akkor lehet visszaigazolni, amint bekerültek a memóriába. Emiatt kockázatot jelent az üzenetek bármilyen típusú (még acks=all, min.insync.replika=2) egyidejű meghibásodása esetén.
Összességében a Kafka magasabb teljesítményt mutat, és eredetileg klaszterekhez tervezték. A követők száma 11-re növelhető, ha ez szükséges a megbízhatóság érdekében. Az 5-ös replikálási arány és a minimális számú szinkronizált replikák min.insync.replicas=3 nagyon ritka eseménnyé teszi az üzenetvesztést. Ha az infrastruktúrája képes biztosítani ezt az arányt és szintet, akkor ezt az opciót választhatja.
A RabbitMQ klaszterezés jó a kis sorok számára. De még a kis sorok is gyorsan megnőhetnek nagy forgalom esetén. Amint a sorok nagyokká válnak, kemény választást kell tennünk a rendelkezésre állás és a megbízhatóság között. A RabbitMQ klaszterezés legjobban a nem tipikus helyzetekhez illik, ahol a RabbitMQ rugalmasságának előnyei felülmúlják a klaszterezés hátrányait.
A nagy sorokkal kapcsolatos RabbitMQ sebezhetőség elleni egyik gyógymód az, hogy azokat sok kisebb részre osszuk. Ha nem követelünk meg teljes sorrendet az összes sorban, csak a megfelelő üzenetek (például egy adott ügyfél üzenetei) esetében, vagy egyáltalán nem sorba állítunk, akkor ez a megoldás elfogadható: nézd meg a projektjeimet a sor felosztásához (a projekt még korai fázisban van).
Végül ne felejtsd el, hogy több hiba is létezik a RabbitMQ és a Kafka klaszterezési és replikálási mechanizmusaiban. Az idő múlásával a rendszerek érettebbé és stabilabbá váltak, de soha egyetlen üzenet sem lesz 100%-ban védett az elvesztéstől! Ezenkívül a datacenterekben nagyszabású balesetek történnek!
Ha valamit kihagytam, hibát követtem el, vagy nem értesz egyet egyetlen tétellel sem, ne habozz írni egy megjegyzést vagy kapcsolatba lépni velem.
Gyakran kérdezik tőlem: „Mit válasszak, Kafka vagy RabbitMQ?”, „Melyik platform a jobb?”. Az igazság az, hogy ez valóban a te helyzetedtől, jelenlegi tapasztalataidtól stb. függ. Nem merek véleményt mondani, mivel túl nagy leegyszerűsítés lenne, ha egyetlen platformot ajánlanék az összes használati esetre és lehetséges korlátra. Ezt a ciklus cikket írtam, hogy te is kialakíthasd a saját véleményedet.
Szeretném mondani, hogy mindkét rendszer vezető szerepet játszik ezen a területen. Lehet, hogy egy kicsit elfogult vagyok, mert a saját projektjeim tapasztalata alapján jobban értékelem az olyan dolgokat, mint az üzenetek garantált sorrendje és megbízhatóság.
Látok más technológiákat, amelyeknek hiányzik ez a megbízhatóság és garantált sorrend, aztán nézem a RabbitMQ-t és a Kafka-t - és megértem mindkét rendszer hihetetlen értékét.
Forrás: habr.com
