

Megjegyzés fordítás.A cikk szerzője Cindy Sridharan, az imgix mérnöke, aki API-fejlesztéssel és különösen mikroszolgáltatások tesztelésével foglalkozik. Ebben a cikkben megosztja részletes meglátását a jelenlegi elosztott nyomkövetési problémákról, ahol szerinte valóságos hiány van a valóban hatékony eszközökből a sürgető feladatok megoldásához.
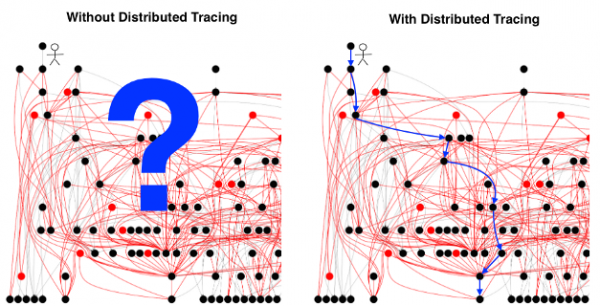
[A kép forrása a az elosztott nyomkövetésről.]
Úgy tartják, hogy nehézségekkel küzd, és a hasznossága . A nyomkövetés "problematikai jellegét" sokféle okra hivatkozva magyarázzák, gyakran utalva a rendszer minden komponensének nehézkes beállítására, hogy a megfelelő fejlécet minden kéréshez át lehessen adni. Bár ez a probléma valóban létezik, nem nevezhető legyőzhetetlennek. Érdekesség, hogy ez nem magyarázza meg, miért nem szeretnék a fejlesztők a nyomkövetést (még a már működőt sem).
A legnagyobb nehézség az elosztott nyomkövetéssel nem az adatok gyűjtése, nem a formátumok elosztásának és bemutatásának standardizálása, és nem is az, hogy mikor, hol és hogyan kell mintát venni. Egyáltalán nem próbálom triviálisnak tekinteni ezeket a "használhatósággal kapcsolatos problémákat" — valójában jelentős technikai és (ha valóban nyílt forráskódú) ) politikai kihívások léteznek, amelyeket le kell küzdeni ahhoz, hogy ezeket a problémákat megoldottnak lehessen tekinteni.
Azonban ha elképzeljük, hogy ezek a problémák megoldódnak, valószínű, hogy semmi lényeges nem fog változni a végfelhasználói élményszempontjából. A nyomkövetés továbbra sem biztos, hogy gyakorlati előnyöket hoz a leggyakoribb hibakeresési forgatókönyvekben — még akkor is, ha azt már telepítették.
Ez a eltérő nyomkövetés
Az elosztott nyomkövetés számos szétszórt komponenst foglal magában:
- alkalmazások és middleware felszerelése nyomonkövetési eszközökkel;
- elosztott kontextus átadása;
- nyomvonalak gyűjtése;
- nyomvonalak tárolása;
- azok kiemelése és vizualizálása.
A sok beszélgetés az elosztott nyomozásról nagyrészt arra a nézőpontra redukálódik, hogy azt egyfajta unáris műveletként kell kezelni, amelynek egyetlen célja a rendszer teljes diagnosztikájának elősegítése. Ennek hátterében nagymértékben az áll, ahogyan a történelmi fejlődés folytán kialakultak az elosztott nyomozásról alkotott elképzelések. , amikor a Zipkin forráskódai nyilvánosságra kerültek, megemlítést nyert, hogy [Zipkin] gyorsabbá teszi a Twittert. Az első kereskedelmi ajánlatok a nyomozásra szintén úgy lettek népszerűsítve, mint .
Megjegyzés fordítás.: Annak érdekében, hogy a további szöveget jobban megérthessük, határozzunk meg két alapvető fogalmat az :
- a kérést az Envoy sidecar megfogja, és létrejön egy 'gyermek' a span-ben (ezért látjuk a nyomokban), majd átirányítódik a konténerbe — az elosztott nyomozás alapvető eleme. Ez egy munkafolyamat (például egy adatbázis lekérdezés) leírását tartalmazza, névvel, kezdési és befejezési időponttal, címkékkel, naplókkal és kontextussal.
- A Span-ok általában hivatkozásokat tartalmaznak más spanokra, ami lehetővé teszi, hogy több span-t egyesítsünk Trace — a lekérdezés életének vizualizálását, ahogyan az elosztott rendszeren keresztül halad.
A Trace-ek rendkívül értékes adatokat tartalmaznak, amelyek segíthetnek olyan feladatokban, mint: produkciós tesztelés, katasztrófa-helyreállítási tesztek lebonyolítása, hibabeépítős tesztelés stb. Valójában némelyik cég már ilyen célokra használja a nyomozást. Kezdjük azzal, hogy más alkalmazásokkal is rendelkezik, az egyszerű spanok tárolási rendszerbe történő átvitele mellett:
- Például, az Uber nyomozási eredményekkel a tesztforgalom és a produkciós forgalom elkülönítésére.
- Facebook A trace adatok kritikus útvonal elemzésére és a forgalom irányítására a szokásos katasztrófa-helyreállítási tesztek során.
- Ezen kívül a közösségi hálózat Jupyter naplók, amelyek lehetővé teszik a fejlesztők számára, hogy tetszőleges lekérdezéseket végezzenek a nyomozási eredmények alapján.
- Az LDFI elosztott trace-eket alkalmaznak hibabeépítős teszteléshez. A fent említett lehetőségek egyike sem kapcsolódik közvetlenül a
hibakeresési szcenárióhoz, amikor a mérnök a trace-t szemlélve próbál megoldani egy problémát.Amikor a helyzet
valójában a hibakeresési szcénárióig eljut, az elsődleges interfész a diagram traceview (bár néhányan így nevezik „Gantt-diagramnak” „cascade diagramnak” vagy ). Énaz alatt (bár néhányan így nevezik értem, hogy minden span és a kapcsolódó metadatok, amelyek együtt alkotják a trace-t. Minden nyílt forráskódú nyomkövető rendszer, valamint minden kereskedelmi nyomkövető megoldás egy alapú (bár néhányan így nevezik felhasználói felületet kínál a trace-ek vizualizálására, a részletezésére és a szűrésére.
A problémám az összes nyomkövető rendszerrel, amelyet eddig megismertem, az az, hogy a végső vizualizáció (traceview) gyakorlatilag teljesen tükrözi a trace generálásának folyamatát. Még amikor alternatív vizualizációk is felajánlásra kerülnek: intenzitási térképek (heatmap), szolgáltatások topológiája, késleltetési hisztogramok, - végül mindezek visszavezetnek a (bár néhányan így nevezik.
A múltban én hogy a nyomkövetés területén a legtöbb "újítás" a UI/UX vonatkozásában látszólag korlátozódik további metadaták nyomához, amelyekben nagy kardinalitású információk találhatók (high-cardinality) vagy lehetőséget adnak a konkrét span-ok részletezésére vagy inter- és intra-trace kérésekre továbbra is a fő vizualizációs eszköz marad. Amíg ez a helyzet fennáll, a elosztott nyomkövetés (legjobb esetben) a 4. helyet foglalja el hibaelhárító eszközként a metrikák, naplók és stack trace-ek mögött, a legrosszabb esetben pedig üres pénzkidobásnak és időpazarlásnak bizonyul.metódusokat használva. Eközben (bár néhányan így nevezik A traceview problémája
abban rejlik, hogy teljes képet adjon egy adott kérés mozgásáról a kapcsolódó elosztott rendszer összes komponensében. Néhány fejlettebb nyomkövető rendszer lehetővé teszi egyes span-ok részletezését és az időbeli lebontás megtekintését
Cél (bár néhányan így nevezik egy folyamat (amikor a span-ok funkcionális határokkal bírnak). bent egy folyamat (amikor a span-ek funkcionális határokon belül vannak).
A mikroszolgáltatások architektúrájának alapvető előfeltevése az a gondolat, hogy a szervezeti struktúra a vállalat szükségleteivel együtt fejlődik. A mikroszolgáltatások támogatói állítják, hogy a különböző üzleti feladatok különálló szolgáltatásokra való átültetése lehetővé teszi a kis, autonóm fejlesztőcsapatok számára, hogy ellenőrizzék e szolgáltatások teljes életciklusát, így függetlenül tudják létrehozni, tesztelni és telepíteni ezeket a szolgáltatásokat. Ennek a megosztásnak a hátránya azonban az, hogy elveszik az információ arról, hogyan kölcsönhatnak ezek a szolgáltatások egymással. Ilyen körülmények között a megosztott nyomkövetés pótolhatatlan eszközként jelentkezik a szcenárióhoz, amikor a mérnök a trace-t szemlélve próbál megoldani egy problémát. komplex szolgáltatásközi kölcsönhatásokhoz.
Ha valóban , akkor egyetlen ember sem képes fejben tartani annak teljes képét. Valójában egy eszköz kifejlesztése annak alapfeltevése alapján, hogy ez egyáltalán lehetséges, olyan, mint egy antipattern (hatékonytalan és terméketlen megközelítés). Az ideális helyzetben egy eszköz szükséges a hibakereséshez, amely segít szűkíteni a keresési területet, hogy a mérnökök a problémás forgatókönyvhöz kapcsolódó dimenziók (szolgáltatások/felhasználók/gazdagépek stb.) egy részhalmazára tudjanak összpontosítani. A hibák okának kiderítésekor a mérnököknek nem kell foglalkozniuk azzal, hogy mi történt az összes szolgáltatásban egyszerre, mivel ez a követelmény ellentmondana a mikroszolgáltatások architektúrájának alapgondolatának.
A traceview azonban pontosan ez. Igen, egyes nyomkövető rendszerek tömörített traceview-t kínálnak, amikor a trace-ek spanjainak száma olyan nagy, hogy azokat egyetlen vizualizáción belül nem lehet megjeleníteni. Azonban a még ilyen csökkentett vizualizációban található információk óriási volumene miatt a mérnököknek továbbra is kénytelenek «átfésülni» azt, manuálisan szűkítve a mintát a problémás forrásszolgáltatások halmazára. Sajnos ebben a tekintetben a gépek jelentősen gyorsabbak az embereknél, kevésbé hajlamosak a hibákra, és az eredményeik is ismételhetőbbek. Egy másik ok, amiért a traceview módszert helytelennek tartom, az az, hogy nem alkalmas a hipotézisen alapuló hibakeresésre. Alapvetően a hibakeresés egy
Mégegy ok, amiért a traceview módszert helytelennek tartom, az az, hogy rosszul illeszkedik a hipotézisalapú hibakereséshez. Alapvetően a hibakeresés iteratív A folyamat, amely a hipotézis felállításával kezdődik, ezt követi a különböző megfigyelések és tények vizsgálata, amelyek a rendszer különböző vektoraitól származnak, következtetések / általánosítások levonása és a hipotézis igazságának további értékelése.
Lehetőség gyorsan és olcsón a hipotézisek tesztelése és a mentális modell megfelelő javítása kulcsfontosságú a hibakeresésben. Bármilyen hibakereső eszköznek interaktívnak kell lennie, és szűkítenie kell a keresési teret, vagy téves nyom esetén lehetővé kell tennie a felhasználó számára, hogy visszalépjen és egy másik rendszerterületre összpontosítson. Az ideális eszköz ezt előre jelezve, azonnal felhívva a felhasználó figyelmét a potenciálisan problémás területekre.
Sajnos, (bár néhányan így nevezik nem nevezhető interaktív felülettel rendelkező eszköznek. A legjobb, amit remélhetünk a használatakor, az, hogy felfedezünk egy forrást, amely megnövekedett késleltetéseket okoz, és átnézünk mindenféle vele kapcsolatos címkét és naplót. Ez nem segít a mérnöknek az minták felismerésében a forgalomban, például a késleltetések eloszlásának sajátosságai, vagy az különböző mérések közötti korrelációk felfedezésében. segíthet megkerülni ezeket a problémákat. Valójában sikeres elemzésre gépi tanulás segítségével az anomális span-ok azonosítása és az anomális viselkedéssel összefüggésbe hozható címkék alhalmazának azonosítása érdekében. Ennek ellenére még nem találkoztam meggyőző vizualizációkkal, amelyeket gépi tanulás vagy adat-elemzés alkalmazásával készítettek span-ok esetén, amelyek jelentősen eltérnek a traceview-tól vagy a DAG-tól (irányított aciklikus gráf).
A span-ok túl alacsony szintűek
A traceview alapvető problémája az, hogy a span-ok túl alacsony szintű primitívek a késleltetési és az alapok okainak elemzéséhez. Ez olyan, mintha egyedileg elemeznénk a processzor utasításokat, miközben egy kivétel elhárítására törekszünk, tudva, hogy léteznek sokkal magasabb szintű eszközök, mint például a backtrace, amelyekkel sokkal kényelmesebb dolgozni.
Továbbá, bátran állítom a következőt: ideálisan egyáltalán nincs szükségünk teljes képre a kérelem életciklusa alatt bekövetkezett események, amelyeket a modern nyomozóeszközök képviselnek. Ehelyett egy magasabb szintű absztrakcióra van szükség, amely tartalmazza a következőket: mi ment rosszul (hasonlóan a backtrace-hez), némi kontextussal együtt. Ahelyett, hogy az egész trace-t megfigyelném, azt részeit szeretném látni, ahol valami érdekes vagy szokatlan történik. Jelenleg a keresés manuálisan zajlik: a mérnök megkapja a trace-t, és saját maga elemzi a span-eket valami érdekes után kutatva. Az a megközelítés, amikor az emberek figyelik a span-eket különböző trace-ekben a gyanús aktivitás felfedezése reményében, egyáltalán nem skálázható (főleg, ha minden metaadatot figyelembe kell venni, amely a különböző span-ekben kódolva található, mint például a span ID, RPC metódus neve, a span hossza, naplózások, címkék stb.).A traceview alternatívái
A nyomozási eredmények akkor a leghasznosabbak, ha úgy lehet azokat vizualizálni, hogy nem triviális képet kapjunk arról, mi történik a rendszeren belüli összefüggő részekben. Mindaddig, amíg ez nem áll rendelkezésre, a hibakeresési folyamat nagyrészt
inert marad és a felhasználó képességétől függ, hogy észlelje a helyes korrelációkat, ellenőrizze a rendszer megfelelő részeit, vagy összerakja a puzzle darabjait – ellentétben azzal, ami segítene a felhasználónak abban, hogy megfogalmazza ezeket a hipotéziseket. eszközNem vagyok vizuális tervező vagy UX szakértő, de a következő részben szeretnék megosztani néhány ötletet arról, hogyan nézhetnek ki az ilyen vizualizációk.
Fókusz a konkrét szolgáltatásokon
Olyan környezetben, ahol az iparág a
SLO (szolgáltatási szint célok) és az SLI (szolgáltatási szint mutatók) elképzelések köré konszolidálódik, szolgáltatásorientált vizualizáció a legjobban a négy csapat számára illeszthető. A trace-ek, különösen a szűrés nélküli trace-ek, információk kincsestára minden egyes komponensről a megosztott rendszerben. Ezt az információt egy ügyes feldolgozónak kell ellátnia, amely a felhasználók számára
szolgáltatásorientált megállapításokat szállít. Ezeket előre fel lehet ismerni – még mielőtt a felhasználó ránézne a trace-ekre: felfedezések. Ezek előre azonosíthatók — még mielőtt a felhasználó ránézne a trace-ekre:
- Késleltetés-eloszlási diagramok csak a kiugró kérések számára (kiugró kérések);
- Késleltetés-eloszlási diagramok abban az esetben, amikor a szolgáltatás SLO-céljait nem érik el;
- A leggyakoribb, legérdekesebb és legfurcsább címkék a kérdésekben, amelyek leggyakrabban megismétlődnek;
- Késleltetés bontás azok számára, amikor függőségek a szolgáltatás nem éri el a kitűzött SLO-célokat;
- Késleltetés bontás különböző alsóbb (downstream) szolgáltatásokra.
Ezekre a kérdésekre a beépített metrikák egyszerűen nem tudnak válaszolni, arra kényszerítve a felhasználókat, hogy alaposan tanulmányozzák a span-eket. Ennek következtében egy rendkívül felhasználó-ellenséges mechanizmussal állunk szemben.
Ezért merül fel a kérdés: mi a helyzet a különböző csapatok által irányított, sokrétű szolgáltatások közötti komplex interakciókkal? Nem lenne (bár néhányan így nevezik a legalkalmasabb eszköz az ilyen helyzetek megvilágítására?
A mobilfejlesztők, állapotmentes szolgáltatások tulajdonosai, állapottal rendelkező szolgáltatások (például adatbázisok) tulajdonosai és platformok másik képviseletére is érdeklődhetnek elosztott rendszer; (bár néhányan így nevezik — ez túl általános megoldás ezen alapvetően eltérő igényekhez. Még a nagyon összetett mikroszolgáltatás-architektúrában is a szolgáltatás tulajdonosának nincs szüksége mélyreható ismeretekre több mint két-három upstream- és downstream-szolgáltatásról. Lényegében a legtöbb forgatókönyvben a felhasználóknak csak a kérdések megválaszolásához kell foglalkozniuk korlátozott szolgáltatáscsoporttal.
Ez hasonló ahhoz, hogy egy kis szolgáltatásalcsoportra nézzünk nagyítóval, hogy alaposan megvizsgáljuk őket. Ez lehetővé teszi a felhasználó számára, hogy sürgetőbb kérdéseket tegyen fel a szolgáltatások közötti komplex interakciókkal és azok közvetlen függőségeivel kapcsolatban. Ez analóg a backtrace-zel a szolgáltatások világában, ahol a mérnök tudja, mit nem csak úgy, hanem van némi elképzelése arról, hogy mi történik a környező szolgáltatásokban, hogy megértse, miért.
Az általam képviselt megközelítés teljesen ellentétes a „felülről lefelé” megközelítéssel, amely a traceview-ra épül, amikor az elemzés az egész trace-ból indul, és fokozatosan leereszkedik az egyes spanekhez. Ezzel szemben a „lentről felfelé” megközelítés egy kicsi részlet elemzésével kezdődik, közel a potenciális incidens okához, majd szükség szerint bővíti a keresési teret (más csapatok bevonásával a szélesebb körű szolgáltatások elemzéséhez). A második megközelítés jobban alkalmazkodik a kezdeti hipotézisek gyors ellenőrzéséhez. Miután konkrét eredményeket kaptunk, áttérhetünk egy célzottabb és részletesebb elemzésre.
Topológia építése
A konkrét szolgáltatáshoz kötődő nézetek rendkívül hasznosak lehetnek, ha a felhasználó tudja, melyik szolgáltatás vagy szolgáltatáscsoport felelős a késleltetések növekedéséért vagy hibák forrásául szolgál. Azonban egy bonyolult rendszerben a hibás szolgáltatás azonosítása nem trivialis feladat egy leállás során, különösen, ha a szolgáltatásoktól nem érkeztek hibajelentések.
A szolgáltatások topológiájának felépítése nagyban segíthet annak megértésében, hogy melyik szolgáltatás mutat hibák gyakoriságának vagy késleltetésének növekedését, ami észlelhetően rontja a szolgáltatás teljesítményét. A topológia építése alatt nem szolgáltatási térképet, amely megjeleníti a rendszerben található összes szolgáltatást és ismert . Ez a megjelenítés semmivel sem jobb, mint az irányított aciklikus grafikonra alapozott traceview. Ehelyett szeretném látni dynamikusan generált szolgáltatási topológiát, amely meghatározott attribútumokon, például hibák gyakoriságán, válaszidőn vagy bármilyen felhasználó által megadott paraméteren alapul, amely segít tisztázni a konkrét gyanús szolgáltatások helyzetét.
Nézzük például. Tegyük fel, hogy van egy hipotetikus híroldal. A főoldali szolgáltatás (front page) adatokat cserél a Redis-szel, az ajánlórendszerrel, a hirdetési szolgáltatással és a videószolgáltatással. A videószolgáltatás az S3-ból veszi a videókat, míg a metaadatokat a DynamoDB-ből nyeri. Az ajánlórendszer a metaadatokat a DynamoDB-ből kapja, adatokat tölt le a Redis-ből és a MySQL-ből, és üzeneteket ír a Kafka-ba. A hirdetési szolgáltatás az MySQL-ből kap adatokat és üzeneteket ír a Kafka-ba.
Az alábbiakban látható ennek a topológiának a schematikus ábrázolása (sok kereskedelmi program készít topológiát a nyomkövetéshez). Hasznos lehet, ha meg kell értened a szolgáltatások közötti függőségeket. Azonban a szcenárióhoz, amikor a mérnök a trace-t szemlélve próbál megoldani egy problémát., amikor egy adott szolgáltatás (mondjuk, a videószolgáltatás) megnövekedett válaszidőt mutat, egy ilyen topológia nem túl hasznos.
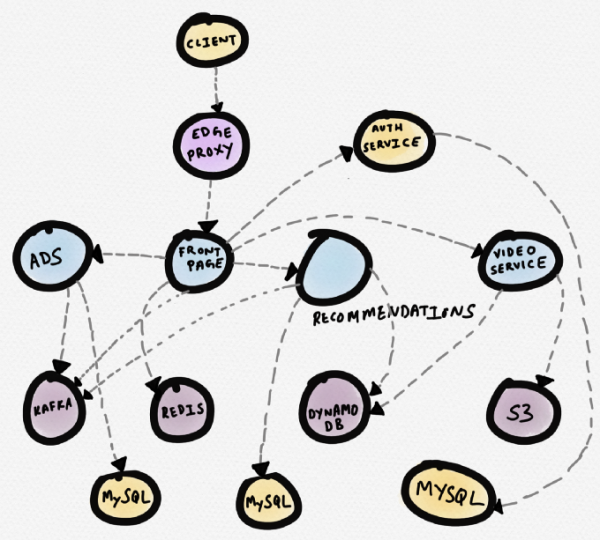
A hipotetikus híroldal szolgáltatásainak ábrája
Jobban megfelelne az alább látható diagram. Ezen a problémás szolgáltatás (video) középen látható. A felhasználó azonnal észreveszi. A vizualizációból világosan kiderül, hogy a videószolgáltatás rendellenesen működik az S3 válaszidejének növekedése miatt, amely befolyásolja a főoldal egy részének betöltési sebességét.
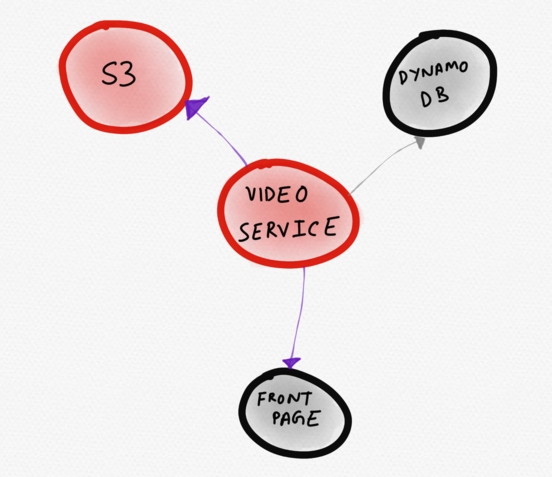
Dinamikus topológia, amely csak az "érdekes" szolgáltatásokat jeleníti meg
A dinamikusan generált topológiai diagramok hatékonyabbak lehetnek, mint a statikus szolgáltatási térképek, különösen rugalmas, automatikusan méretezhető infrastruktúrákban. A szolgáltatások topológiájának összehasonlítási lehetősége lehetővé teszi a felhasználó számára, hogy relevánsabb kérdéseket tegyen fel. A rendszerrel kapcsolatos pontosabb kérdések nagyobb valószínűséggel vezetnek a rendszer működésének jobb megértéséhez.
Összehasonlító ábrázolás
Egy másik hasznos vizualizáció az összehasonlító ábrázolás lesz. Jelenleg a trace-ek nem alkalmasak túl jól az oldalankénti összehasonlításra, ezért általában az a span-ok. A cikk fő mondanivalójának pedig az a lényege, hogy a span-ek túl alacsony szintűek ahhoz, hogy a nyomkövetési eredményekből a legértékesebb információt ki lehessen nyerni.
Két trace összehasonlítása nem igényel lényegi új vizualizációkat. Valójában elegendő valami, mint egy hisztogram, amely ugyanazt az információt reprezentálja, mint a traceview. Meglepetés, de még ez az egyszerű módszer is jóval nagyobb eredményeket hozhat, mint a két trace külön-külön történő vizsgálata. Még erősebben működne az a lehetőség vizualizálni trace-ek összehasonlítása összességében. Rendkívül hasznos lenne látni, hogyan hat a legutóbb telepített adatbázis-konfigurációs változtatás, amely magában foglalja a GC-t (szemétgyűjtést), a downstream szolgáltatás válaszidejére több órás időtartamban. Ha az, amit itt leírok, hasonlít az infrastruktúra változások A/B analíziséhez, több szolgáltatásban a nyomozási eredmények segítségével, akkor nem vagy túl távol az igazságtól.
Zárás
Nem kérdőjelezem meg magának a trace-nek a hasznosságát. Őszintén hiszem, hogy nincs más módszer, amely hasonlóan gazdag, eseti és kontextuális adatokat gyűjt, mint amit a trace tartalmaz. Ugyanakkor azt is gondolom, hogy minden trace-elési megoldás rendkívül hatékonytalanul használja ezeket az adatokat. Amíg a trace-elési eszközök a traceview-szerű megjelenítésre korlátozódnak, korlátozottak lesznek a fontos információk maximális kihasználásában, amelyeket a trace-ekből nyerhetünk ki. Ezenkívül fennáll a kockázata annak, hogy egy rendkívül ellenséges és nem intuitív vizuális interfész fejlődik ki, amely nagyban korlátozza a felhasználó képességét az alkalmazás hibáinak elhárításában.
Bonyolult rendszerek hibakeresése, még a legújabb eszközök használatával is, hihetetlenül nehéz. Az eszközöknek segítenie kell a fejlesztőknek a hipotézisek megfogalmazásában és tesztelésében, aktívan nyújtva releváns információkat, kiemelve a kiugró értékeket és észlelve a késleltetések eloszlásában rejlő sajátosságokat. Ahhoz, hogy a trace a fejlesztők preferált eszközévé váljon a production bundok feloldásában vagy a több szolgáltatást érintő problémák megoldásában, eredeti felhasználói interfészekre és vizualizációkra van szükség, amelyek jobban megfelelnek azoknak a mentális modelleknek, amelyeket a szolgáltatások létrehozásában és üzemeltetésében dolgozó fejlesztők képviselnek.
Komoly szellemi erőfeszítésekre lesz szükség ahhoz, hogy egy olyan rendszert tervezzünk, amely a trace eredményekben elérhető különböző jeleket olyan módon jeleníti meg, amely optimalizált az elemzés és a következtetések megkönnyítésére. Gondosan átgondolandó, hogyan lehet a hibakeresés során a rendszer topológiáját elvonatkoztatni, hogy segítse a felhasználót a vak foltok leküzdésében anélkül, hogy egyes trace-ekbe vagy span-ekbe nézne.
Jó lehetőségekre van szükségünk az absztrakcióra és a szintbontásra (különösen a felhasználói felületen). Olyanokra, amelyek jól illeszkednek a hipotézisek alapú hibakeresés folyamatába, ahol iteratívan kérdéseket tehetünk fel és ellenőrizhetjük a hipotéziseket. Ezek nem oldják meg automatikusan az összes megfigyelhetőséggel kapcsolatos problémát, de segítenek a felhasználóknak fejleszteni az intuíciójukat és megalapozottabb kérdéseket megfogalmazni. Arra ösztönzöm a szakmát, hogy gondolkodjanak tudatosabban és innovatívabban a vizualizáció terén. Itt valóban van lehetőség a horizontok kiszélesítésére.
Fejlesztési eszközök, amelyek Kubernetesben futnak
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «».
Forrás: habr.com
