

A CAP-tétel a megosztott rendszerek elméletének kulcseleme. Természetesen a körülötte zajló viták sosem csillapodnak; a meghatározások nem kanonikusak, és szigorú bizonyítékok sincsenek... Ennek ellenére, közönséges józan észre támaszkodva™, intuitívan értjük, hogy a tétel helyes.
Az egyetlen dolog, ami nem egyértelmű, az a «P» betű jelentése. Amikor egy klaszter megoszlik, dönt – vagy nem válaszol addig, amíg el nem éri a kvórumot, vagy megadja azokat az adatokat, amelyek éppen rendelkezésre állnak. Az ilyen döntések alapján a rendszer CP-ként vagy AP-ként van besorolva. A Cassandra például attól függően viselkedhet így vagy úgy, hogy a klaszter beállításai vagy a konkrét lekérdezés paraméterei milyenek. De ha a rendszer nem «P», és megoszlik, akkor mi történik?
A kérdésre adott válasz kissé meglepő: a CA-klaszter nem tud megoszlani.
Milyen klaszterről beszélünk, amely nem tud megoszlani?
Egy ilyen klaszter elengedhetetlen tulajdonsága a közös adatkezelő rendszer. A legtöbb esetben ez SAN-on keresztüli csatlakozást jelent, ami a CA-megoldások alkalmazását a SAN-infrastruktúrával rendelkező nagyvállalatokra korlátozza. Ahhoz, hogy többen szerverek ugyanazokkal az adatokkal dolgozhassanak, klaszter fájlrendszer szükséges. Az ilyen fájlrendszerek megtalálhatók a HPE (CFS), Veritas (VxCFS) és IBM (GPFS) portfóliójában.
Oracle RAC
A Real Application Cluster opció először 2001-ben jelent meg az Oracle 9i kiadásával. Egy ilyen klaszterben több példány a szerver azonos adatbázissal dolgozik.
Az Oracle képes működni klaszter fájlrendszerrel és a saját megoldásával – ASM, Automatic Storage Management.
Minden példány saját naplót vezet. A tranzakciót egy példány hajtja végre és rögzíti. Példányhiba esetén a klaszter egyik életben maradó csomópontja (példánya) elolvassa a naplóját, és helyreállítja az elveszett adatokat – ezzel biztosítva a rendelkezésre állást.
Minden példány saját gyorsítótárazást támogat, és ugyanazok az oldalak (blokkok) egyszerre több példány gyorsítótárában is jelen lehetnek. Sőt, ha egy példány számára szükséges egy oldal, és az egy másik példány gyorsítótárában rendelkezésre áll, akkor azt a «szomszédtól» is megkaphatja a cache fusion mechanizmus segítségével, ahelyett, hogy lemezről olvasna.
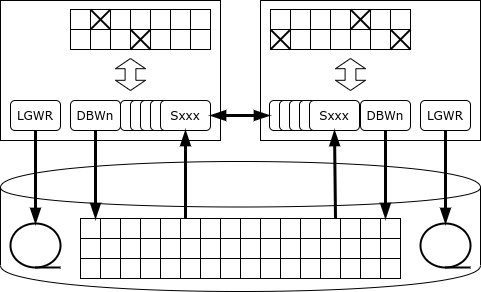
De mi történik, ha az egyik példánynak módosítania kell az adatokat?
Az Oracle sajátossága, hogy nincs dedikált zárszolgáltatása: ha a szerver zárolni akar egy sort, akkor a zárolásról szóló bejegyzés közvetlenül azon a memóriamenedzsment oldalon kerül elhelyezésre, ahol a zárolt sor található. Ennek a megközelítésnek köszönhetően az Oracle kiemelkedő teljesítményt nyújt a monolitikus adatbázisok között: a zárolásszolgáltatás soha nem válik szűk keresztmetszetté. De felhasználói konfigurációban ez az architektúra intenzív hálózati forgalomhoz és kölcsönös zárolásokhoz vezethet.
Amint a bejegyzés zárolva van, az egy példány értesíti az összes többi példányt, hogy az az oldal, ahol ez a bejegyzés található, monopolhelyzetbe került. Ha egy másik példány módosítani szeretné a bejegyzést ugyanazon az oldalon, várnia kell, míg a változások az oldalon rögzítve nem lesznek, azaz az információ a lemezen található naplóba nem kerül bejegyzésre (eközben a tranzakció folytatódhat). Előfordulhat, hogy az oldalakat egymás után több példány is módosítja, és ilyenkor a lemezre íráskor tisztázni kell, hogy kinek van éppen az aktuális verziója az oldalról.
Az ugyanazon oldalak véletlenszerű frissítése különböző RAC csomópontok által drámaian csökkentheti az adatbázis teljesítményét – odáig, hogy a klaszter teljesítménye akár alacsonyabb lehet, mint egyetlen példányé.
Az Oracle RAC helyes használata a fizikai adatok elválasztása (például szekcionált táblák mechanizmusának segítségével) és az egyes szekciók egy dedikált csomóponton keresztüli kezelése. A RAC fő célja nem a horizontális skálázás, hanem a hibatűrés biztosítása.
Ha egy csomópont nem reagál a heartbeat-re, akkor az azonnal indítja a diszk alapú szavazási eljárást. Ha itt sem jelentkezik a hiányzó csomópont, akkor az egyik csomópont átvállalja az adatok helyreállításának feladatait:
- «megfagyasztja» az összes oldalt, amely a hiányzó csomópont cache-ében volt;
- beolvassa a hiányzó csomópont redo naplóit és újra alkalmazza az azokban rögzített változásokat, és közben ellenőrzi, hogy más csomópontoknak van-e frissebb verziója a módosítandó oldalakról;
- visszavonja a befejezetlen tranzakciókat.
Az Oracle-ban a szolgáltatás fogalma – egy virtuális példány – segíti az áttérést a csomópontok között. Egy példány több szolgáltatást is kiszolgálhat, és egy szolgáltatás átköltözhet a csomópontok között. Az adatbázis egy adott részét szolgáló alkalmazás példánya (például egy ügyféllcsoportra) egy szolgáltatással működik, míg a szolgáltatás, amely a database ezen részéért felelős, csomópont hibája esetén átköltözik egy másik csomópontra.
IBM Pure Data Systems for Transactions
A klaszter megoldás az adatbázis-kezelők számára 2009-ben jelent meg a Kék Óriás portfóliójában. Eszmeileg a Parallel Sysplex klaszter utódja, amely "szokványos" hardveren alapul. 2009-ben kiadott a DB2 pureScale nevű terméket, amely egy szoftvercsomag, míg 2012-ben az IBM bemutatta az Pure Data Systems for Transactions néven ismert szoftver-hardver készletet. Ne tévessze össze a Pure Data Systems for Analytics-szal, amely nem más, mint a Netezza átnevezett változata.
A pureScale architektúrája első pillantásra hasonlít az Oracle RAC-ra: több csomópont csatlakozik egy közös adattároló rendszerhez, és minden csomóponton saját adatbázis-kezelő példány fut a saját memóriaterületeivel és tranzakciós naplóival. Az Oracle-lal ellentétben a DB2-nek van egy dedikált zárszolgáltatása, amely a db2LLM* folyamatok sorozataként van jelen. A klaszteres konfigurációban ez a szolgáltatás egy külön csomópontra kerül, amely a Parallel Sysplex néven coupling facility (CF), a Pure Data pedig – PowerHA.
A PowerHA a következő szolgáltatásokat nyújtja:
- zárkezelő;
- globális gyorsítótár;
- interprocess kommunikációs terület.
A PowerHA és az adatbázis csomópontok közötti adatátvitelhez távoli memóriahozzáférést használnak, ezért a klaszter interkonnektnek támogatnia kell az RDMA protokollt. A PureScale mind az Infiniband, mind az RDMA over Ethernet megoldást használhat.
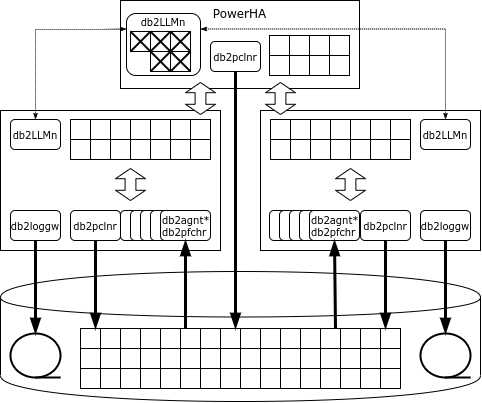
Ha egy csomópontnak szüksége van egy oldalra, és az oldal nincs a gyorsítótárban, akkor a csomópont kéri az oldalt a globális gyorsítótárból, és csak abban az esetben olvassa le a lemezen, ha ott sem találja. Az Oracle-lal ellentétben a kérés csak a PowerHA-hoz irányul, nem a szomszédos csomópontokhoz.
Ha a példány módosítani kívánja a sorokat, akkor azokat kizárólagos módban zárolja, míg azokat az oldalakat, ahol a sor található, megosztott módban zárolja. Minden zárolást globális zároláskezelő registrál. Amikor a tranzakció befejeződik, a csomópont üzenetet küld a zároláskezelőnek, aki a módosított oldalt az globális gyorsítótárba másolja, feloldja a zárolásokat és érvényteleníti a módosított oldalt a többi csomópont gyorsítótárában.
Ha az oldal, ahol a módosítható sor található, már zárolva van, akkor a zároláskezelő a módosított oldalt a módosításokat végző csomópont memóriájából olvassa, feloldja a zárolást, érvényteleníti a módosított oldalt a többi csomópont gyorsítótárában, és visszaadja a blokkolt oldalt annak a csomópontnak, aki kérte.
A „piszkos”, azaz módosított oldalak diszkre írhatók úgy a szokásos csomópontról, mint a PowerHA (castout) által.
Ha a pureScale egyik csomópontja meghibásodik, a helyreállítás kizárólag azokon a tranzakciókon korlátozódik, amelyek a hiba pillanatában még nem fejeződtek be: azok az oldalak, amelyeket ez a csomópont módosított a befejezett tranzakciók során, a globális gyorsítótárban találhatók a PowerHA-n. A csomópont csökkentett konfigurációban újraindul a klaszter egyik szerverén, visszagörgeti a befejezetlen tranzakciókat és feloldja a zárolásokat.
A PowerHA két szerveren működik, és a fő csomópont szinkron módon replikálja az állapotát. Ha a fő csomópont meghibásodik, a PowerHA klaszter a tartalék csomóponttal folytatja a működést.
Természetesen, ha egy adathalmazon keresztül egy csomópontot használunk, a klaszter általános teljesítménye magasabb lesz. A PureScale akár észlelheti is, hogy egyes adatmezők egy csomópont által vannak feldolgozva, és ekkor az ezekhez a mezőkhöz kapcsolódó összes zárolást a csomópont helyben kezeli, anélkül, hogy kommunikációra lenne szükség PowerHA-val. De amint az alkalmazás megpróbál hozzáférni ezekhez az adatokhoz egy másik csomópont révén, a központosított zároláskezelés újra megkezdődik.
Az IBM belső, 90%-os olvasásból és 10%-os írásból álló terhelési tesztjei, amelyek nagyon hasonlítanak a valódi ipari terheléshez, majdnem lineáris skálázódást mutatnak 128 csomópontig. A tesztelési körülmények, sajnos, nem kerültek nyilvánosságra.
HPE NonStop SQL
A saját nagy rendelkezésre állású platformja a Hewlett-Packard Enterprise portfóliójában is megtalálható. Ez a NonStop platform, amelyet 1976-ban indított el a Tandem Computers. 1997-ben a céget felvásárolta a Compaq, amely 2002-ben a Hewlett-Packard részévé vált.
A NonStop kritikus alkalmazások, például HLR vagy bankkártya-feldolgozás építésére szolgál. A platform szoftver-hardware komplexumként (appliance) érkezik, amely tartalmazza a számítási csomópontokat, az adattároló rendszert és a kommunikációs berendezéseket. A ServerNet hálózat (a modern rendszerekben Infiniband) szolgál a csomópontok közötti adatcserére, valamint az adattároló rendszerhez való hozzáférésre.
A rendszer korai verzióiban egyedi processzorokat használtak, amelyek szinkronizáltak voltak egymással: minden műveletet egyszerre hajtottak végre több processzor, és amint az egyik processzor hibázott, leállt, míg a másik folytatta a működést. Később a rendszer átállt a hagyományos processzorokra (először MIPS, majd Itanium, végül x86), és a szinkronizálásra más mechanizmusokat használtak:
- üzenetek: minden rendszerfolyamatnak van egy másodlagos „árnyéka”, amelynek az aktív folyamat időszakosan üzeneteket küld az állapotáról; ha az alapfolyamat meghibásodik, az árnyékfolyamat az utolsó üzenet által meghatározott ponton kezdi el a munkát;
- szavazás: az adattároló rendszer rendelkezik egy speciális hardverkomponenssel, amely több azonos megkeresést fogad, és csak akkor teljesíti őket, ha a megkeresések egybeesnek; a fizikai szinkronizálás helyett a processzorok aszinkron módon dolgoznak, és az eredményeiket csak a bemeneti/kimeneti műveletek pillanataiban hasonlítják össze.
1987 óta a NonStop platformon relációs adatbázis-kezelő rendszer működik - először SQL/MP, majd később SQL/MX.
Az adatbázis teljes részre van osztva, és minden részért a Data Access Manager (DAM) folyamat felel. Ez biztosítja az adatok írását, a gyorsítótárazást és a zármechanizmust. Az adatok feldolgozását az Executor Server Process nevű végrehajtó folyamatok végzik, amelyek azonos csomópontokon futnak, mint a megfelelő adatkezelők. Az SQL/MX ütemező felosztja a feladatokat a végrehajtók között, és összegzi az eredményeket. A konszenzusos változtatások végrehajtásához a TMF (Transaction Management Facility) könyvtárral biztosított kétszakaszos megkötési protokollt használnak.
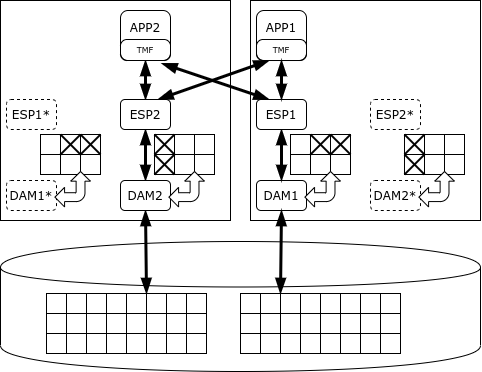
A NonStop SQL képes prioritásokat rendelni a folyamatokhoz úgy, hogy a hosszú analitikai lekérdezések ne akadályozzák a tranzakciók végrehajtását. Azonban a rendeltetése kifejezetten a rövid tranzakciók kezelése, nem pedig az analitika. A fejlesztő garantálja a NonStop klaszter elérhetőségét öt 'kilences' szinten, tehát az leállás mindössze évi 5 perc.
SAP HANA
Az első stabil HANA (1.0) adatbázis-verzió 2010 novemberében jelent meg, a SAP ERP csomag pedig 2013 májusában váltott HANA-ra. A platform megvásárolt technológiákra épül: TREX keresőmotor (oszlopos tárolók keresésére), P*TIME adatbázis és MAX DB.
A szó maga, 'HANA', az High performance ANalytical Appliance mozaikszava. Ezt az adatbázist kód formájában szállítják, amely bármilyen x86 szerveren futhat, de az ipari telepítések csak tanúsítással rendelkező hardvereken engedélyezettek. Léteznek HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi és NEC megoldások. Néhány Lenovo konfiguráció akár SAN nélkül is üzemeltethető – a GPFS klaszter a helyi lemezeken funkcionál az általános tároló rendszereként.
A fent említett platformokkal ellentétben a HANA egy memóriában lévő adatbázis, azaz az adatok prv kezdőképe a RAM-ban tárolódik, és a merevlemezre csak naplókat és időszakos pillanatképeket írnak – vészhelyzet esetén történő helyreállítás céljából.
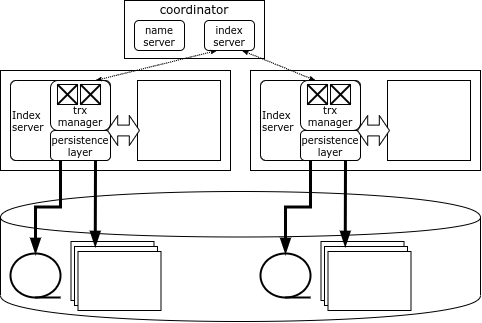
A HANA klaszter minden csomópontja a saját adatainak egy részéért felel, és az adatok térképe egy speciális komponensben - a Névszolgáltatóban - van tárolva, amely a koordináló csomóponton található. Az adatok nem duplikálódnak a csomópontok között. A zárakra vonatkozó információk szintén minden csomóponton tárolódnak, de a rendszer rendelkezik globális holtpontészlelővel.
A HANA client, when connecting to a cluster, loads its topology and can subsequently access any node directly depending on the data it needs. If the transaction involves data from a single node, it can be executed locally by that node, but if it modifies data from multiple nodes, the initiating node contacts the coordinator node, which opens and coordinates the distributed transaction, committing it using an optimized two-phase commit protocol.
The coordinator node is duplicated, so in case the coordinator fails, a backup node immediately takes over. However, if a data node fails, the only way to access its data is to restart the node. Typically, HANA clusters maintain a spare server to quickly restart the lost node.
Forrás: habr.com
