

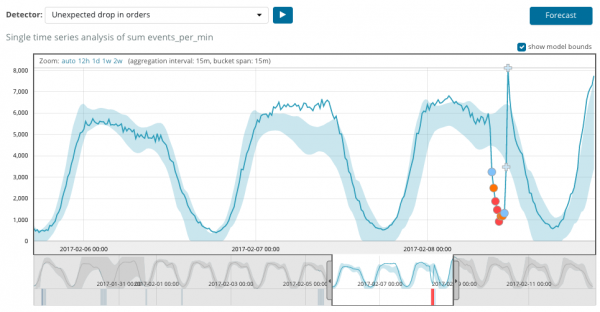
Emlékeztetjük, hogy az Elastic Stack alapját a relációs adatbázis nélküli Elasticsearch, a Kibana webes felület és az adatok gyűjtő-feldolgozó eszközök (legismertebb a Logstash, különböző Beats, APM és mások) alkotják. Az említett termékcsomag kellemes kiegészítője az adatelemzés gépi tanulási algoritmusok segítségével. A cikkben azt vizsgáljuk, hogy milyen algoritmusokkal van dolgunk. Kérjük, kattintson a folytatáshoz.
A gépi tanulás egy fizetős funkció a feltételesen ingyenes Elastic Stack-ben, amely az X-Pack csomag része. A használatának megkezdéséhez elegendő telepítés után aktiválni a 30 napos próbaverziót. A próbaidőszak lejárta után kérheti a támogatást a meghosszabbításra, vagy megvásárolhat egy előfizetést. Az előfizetés költsége nem az adatmennyiségtől, hanem a használt node-ok számától függ. Igen, az adatmennyiség természetesen befolyásolja a szükséges node-ok számát, de a licencelési megközelítés mégis humánusabb a cég költségvetéséhez képest. Ha nincs szükség magas teljesítményre, lehet spórolni.
Az ML az Elastic Stack-ben C++ nyelven íródott és a JVM-en kívül működik, amelyen magával az Elasticsearch-szel forog. Tehát a folyamat (amely egyébként autodetect néven ismert) minden olyan adatot elfogyaszt, amit a JVM nem tud kezelni. A demóstandon ez nem olyan kritikus, de termelési környezetben fontos, hogy külön node-okat különítsünk el a ML feladatokhoz.
A gépi tanulási algoritmusok két kategóriába sorolhatók — és . Az Elastic Stack-ben a felügyelet nélküli kategóriába tartozik az algoritmus. A matematikai keretrendszerét meg lehet nézni a gépi tanulási algoritmusoknak.
Az algoritmus a gépi tanulás elemzésének elvégzéséhez az Elasticsearch indexeiben tárolt adatokat használja. Elemzési feladatokat létrehozni lehet a Kibana felületéről és API-n keresztül is. Ha a Kibana-n keresztül végezzük, nem szükséges bizonyos dolgokat tudni. Például az algoritmus által a munkafolyamat során használt kiegészítő indexek.
A munkafolyamat során használt kiegészítő indexek.ml-state — információ a statisztikai modellekről (elemzési beállítások);
.ml-anomalies-* — az ML algoritmusok eredményei;
.ml-notifications — az elemzési eredmények értesítéseinek beállításai.
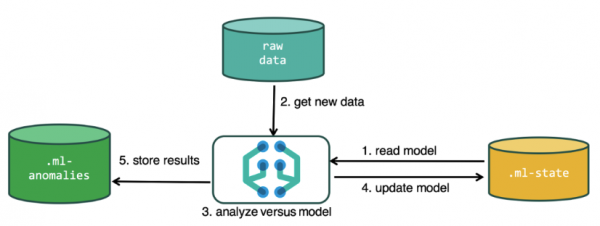
Az Elasticsearch adatbázis adatstruktúrája indexekből és az azokban tárolt dokumentumokból áll. Ha a relációs adatbázissal összehasonlítjuk, az index hasonlítható az adatbázis sémájához, míg a dokumentum a táblázat rekordjának felel meg. Ez a hasonlat feltételes, és azért került elő, hogy megkönnyítse a további anyag megértését azok számára, akik csak hallottak az Elasticsearchről.
Az API-n keresztül elérhető funkciók megegyeznek a webes interfésszel, ezért a koncepciók megértése érdekében bemutatjuk, hogyan állíthatjuk be a Kibana-t. A bal oldali menüben található a Machine Learning rész, ahol új feladatot (Job) hozhatunk létre. A Kibana interfésze az alábbi képen látható. Most áttekintjük a feladatok típusait, és bemutatjuk azokat az elemzési módszereket, amelyeket itt összeállíthatunk.
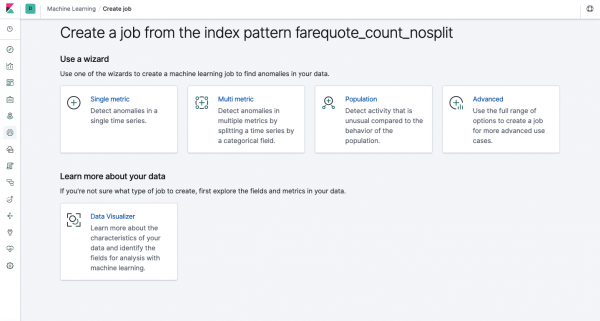
Single Metric — egy metrika elemzése, Multi Metric — két vagy több metrika elemzése. Mindkét esetben az egyes metrikák izolált környezetben kerülnek elemzésre, azaz az algoritmus nem veszi figyelembe a párhuzamosan elemzett metrikák viselkedését, ahogyan az a Multi Metric esetében tűnhetett. Az eltérő metrikák korrelációjának figyelembevételéhez Population-elemzést lehet alkalmazni. Az Advanced pedig egy finomhangolás, amely extra opciókkal látja el az algoritmusokat a specifikus feladatokhoz.
Single Metric
Az egyetlen metrika változásainak elemzése a legegyszerűbb feladat, amit itt végezhetünk. A Create Job gombra kattintva az algoritmus anomáliákat keres.
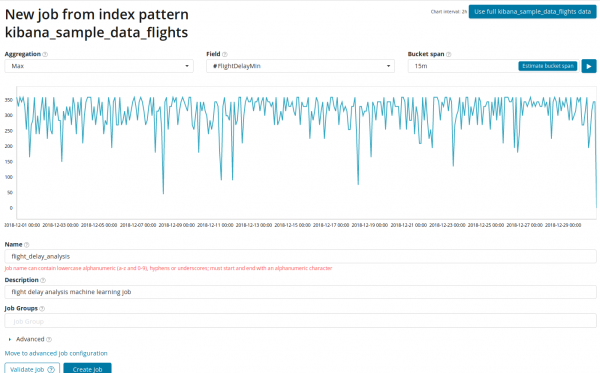
A mezőben Aggregation itt kiválaszthatja az anomáliák keresésének megközelítését. Például, ha Min az anomáliának számító értékek az átlagos értékek alattiak lesznek. Létezik Max, High Mean, Low, Mean, Distinct és mások. Minden funkció leírását megtekintheti .
A mezőben Field az a numerikus mező, amelyet a dokumentumban az elemzéshez használunk.
A mezőben — a vizsgálni kívánt idővonal megosztásának részletessége. Megbízhat az automatikus beállításokban, vagy manuálisan is választhat. Az alábbi képen egy túl alacsony részletességű példa látható — lehet, hogy egy anomáliát elkerül. Ezzel a beállítással módosíthatja az algoritmus érzékenységét az anomáliákra.
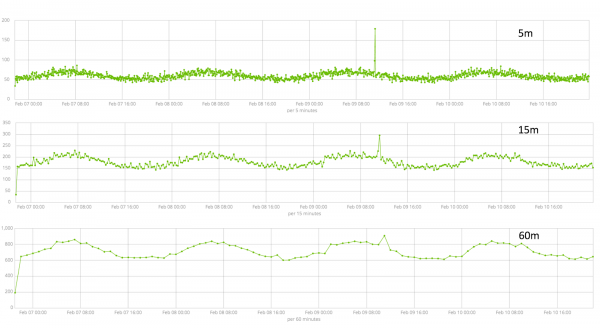
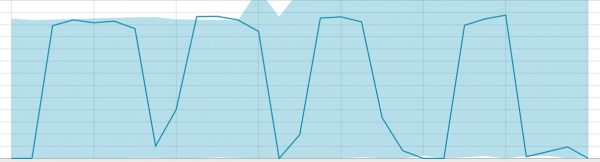
Az összegyűjtött adatok időtartama — kulcsfontosságú dolog, amely befolyásolja az elemzés hatékonyságát. Az elemzés során az algoritmus meghatározza az ismétlődő intervallumokat, kiszámítja a megbízhatósági intervallumot (alapvonalakat), és azonosítja az anomáliákat — az átlagos viselkedéstől való eltéréseket. Például:
Alapvonalak kis adatsor esetén:
Amikor az algoritmusnak van mit tanulnia - az alapvonalak így néznek ki:
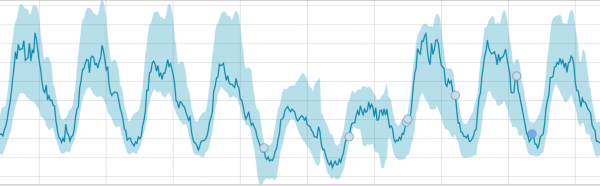
A feladat elindítása után az algoritmus meghatározza a normától való anomális eltéréseket, és azokat az anomália valószínűsége szerint rangsorolja (zárójelben a megfelelő jelölés színe):
Figyelmeztetés (kék): kevesebb mint 25
Kisebb (sárga): 25-50
Jelentős (narancs): 50-75
Kritikus (piros): 75-100
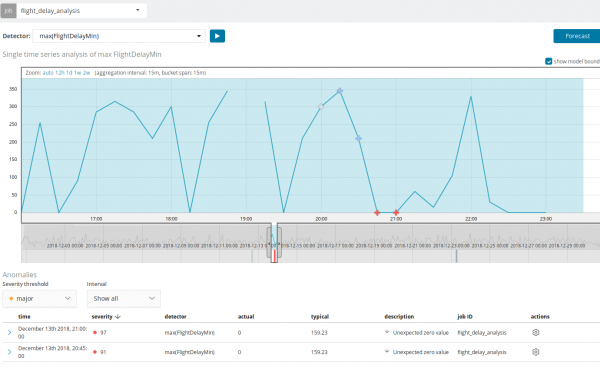
Az alábbi grafikon egy példát mutat az észlelt anomáliákkal.
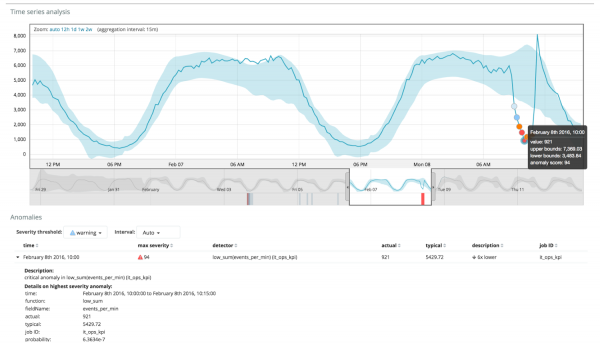
Itt látható a 94-es szám, amely az anomália valószínűségét jelzi. Nyilvánvaló, hogy mivel az érték közel van a 100-hoz, egy anomália áll előttünk. A grafikon alatt található oszlopban egy minimális valószínűség van feltüntetve: 0.000063634%.
Az anomáliák keresésén kívül a Kibana-ban előrejelzést is futtathatunk. Ez egyszerűen megtehető ugyanabból a nézetből, ahol az anomáliák is találhatóak - gomb: Előrejelzés a jobb felső sarokban.
Az előrejelzés legfeljebb 8 hétre előre készül. Még ha nagyon szeretnénk is - többet nem lehet tervezett módon.
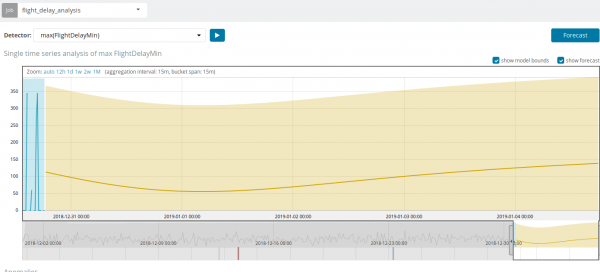
Bizonyos helyzetekben az előrejelzés nagyon hasznos lehet, például amikor a felhasználói terhelést nyomon követjük az infrastruktúrán.
Több metrikus
Térjünk át a következő ML lehetőségre az Elastic Stack-ben - több metrika együttes elemzése. De ez nem jelenti azt, hogy az egyik metrika függőségét a másiktól fogják elemezni. Ez ugyanaz, mint a Single Metric, csupán több metrika létezik egy képernyőn az egymással való összehasonlítás kényelme érdekében. Az egyik metrika másikkal való függőségét a Population részben fogjuk ismertetni.
A Multi Metric négyzetre kattintva egy beállítási ablak jelenik meg. Részletesebben áttekintjük őket.
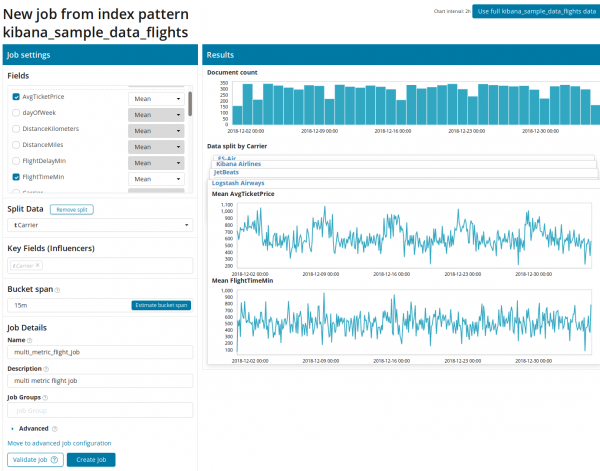
Először ki kell választani az elemzéshez szükséges mezőket és az adatok aggregációját. Az aggregációs lehetőségek ugyanazok, mint a Single Metric esetében (Max, High Mean, Low, Mean, Distinct és mások). Ezt követően az adatok, ha szükséges, kibővíthetők egy mező alapján (a mező: Adatok felosztása). A példában ezt az OriginAirportIDmező alapján tettük. Vegye figyelembe, hogy a jobb oldalon található metrikák grafikonja most több grafikon formájában jelenik meg.
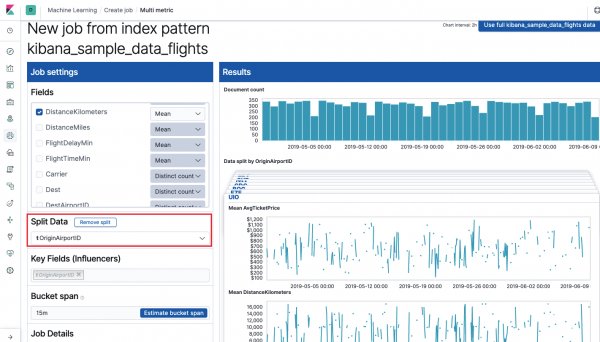
Mező Kulcsmezők (Befolyásolók) közvetlen hatással van az észlelt anomáliákra. Alapértelmezés szerint itt mindig lesz legalább egy érték, de Ön továbbiakat is hozzáadhat. Az algoritmus figyelembe veszi ezen mezők hatását az elemzés során, és megjeleníti a leg „befolyásosabb” értékeket.
A Kibana felületén indítás után körülbelül ilyen kép jelenik meg.
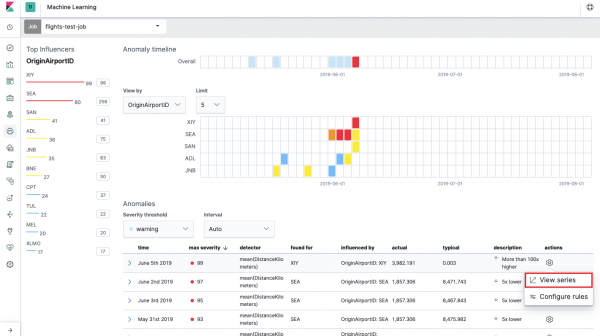
Ez a hőmérsékleti térkép az anomáliákról minden mezőérték szerint. OriginAirportID, amelyet megadtunk a Adatok felosztása. Ahogyan a Single Metric esetében, a szín az anomália eltérés szintjét jelöli. Hasonló elemzést kényelmesen végezhetünk például munkaállomásoknál, hogy nyomon követhessük azokat, ahol gyanúsan sok azonosítás történik stb. Már írtunk , amelyeket szintén összegyűjthetünk és elemezhetünk itt.
A hőtérkép alatt egy anomáliák listája található, ahonnan a Single Metric nézetre léphetünk a részletes elemzéshez.
Populáció
A különböző metrikák közötti korrelációkban az anomáliák keresésére az Elastic Stackben van egy speciális populáció-elemzés. Ezzel pontosan az anomalous értékeket kereshetjük egy szerver teljesítményében másokhoz képest, például a célzott rendszerhez történő kérések számának növekedése esetén.
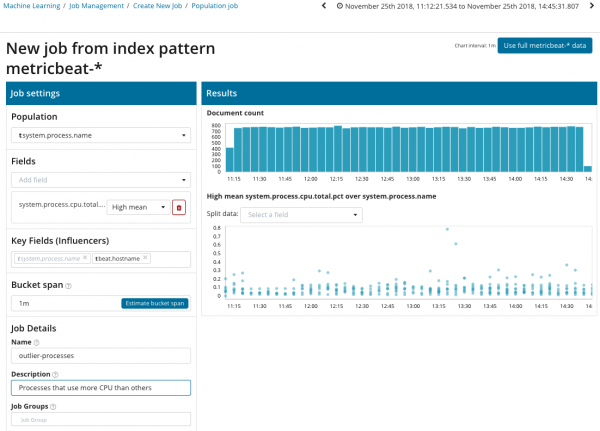
Ezen az ábrán a populáció mezőben található érték az elemzett metrikákra vonatkozik. Jelen esetben ez a folyamat neve. Ennek eredményeképpen látni fogjuk, hogyan befolyásolta egymást a CPU terhelése az egyes folyamatokon.
Figyelje meg, hogy az elemezett adatok grafikonja eltér a Single Metric és Multi Metric esetektől. Ezt a Kibana tervezte a vizualizáció javítása érdekében az elemzett adatok értékeinek eloszlásában.
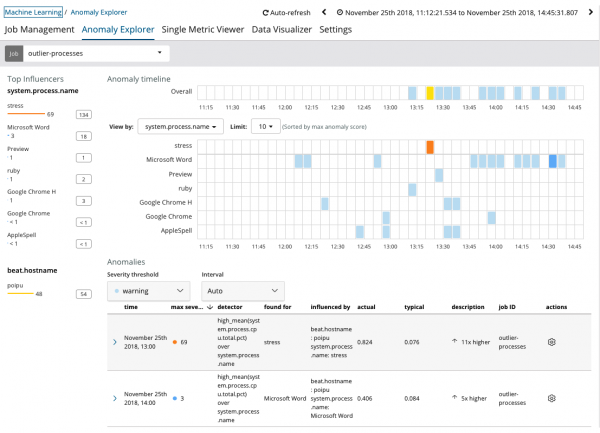
A grafikon alapján látható, hogy az stress (mellesleg, egy speciális utilitás által generálva) folyamat gyanúsan viselkedett a poipuszerveren, amely hatással volt (vagy influencerként jelent meg) a probléma létrejöttére.
Advanced
Finomhangolt analitika. Az Advanced elemzés során a Kibana további beállításokkal rendelkezik. A létrehozó menüben a Advanced csempe megnyomásakor egy ilyen ablak jelenik meg, fülökkel. A Job Details fület szándékosan kihagytuk, ott alapértelmezett beállítások találhatók, amelyek nem kapcsolódnak közvetlenül az elemzés beállításához.
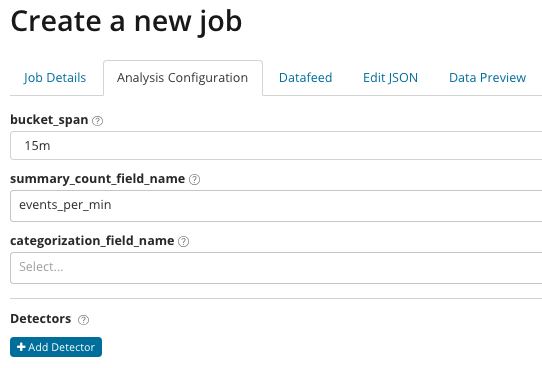
A summary_count_field_name opcionálisan megadhatja a dokumentumból származó, összesített értékeket tartalmazó mező nevét. Ebben a példában ez az események száma percenként. A mezőbe kell megadni a változó értéket tartalmazó mező nevét a dokumentumban. Ezen mező alapján az elemzett adatokat részhalmazokra oszthatjuk. Figyeljen az Add detector gombra az előző ábrán. Az alábbiakban a gomb megnyomásának eredménye látható.
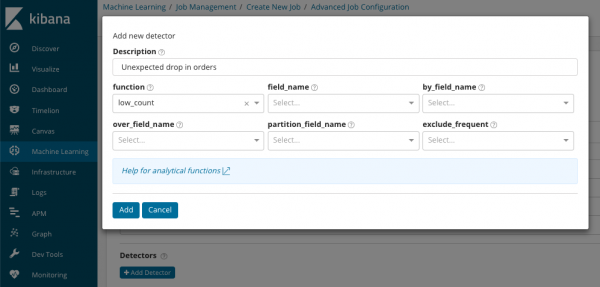
Itt van egy kiegészítő beállítási blokk az anomáliákészlelő testreszabásához egy adott feladatra. A konkrét felhasználási eseteket (különösen a biztonság terén) a következő cikkekben tervezzük megvitatni. Példaként, az egyik elemzett esettanulmány. Ez egy ritkán előforduló értékek keresésével függ össze, és megvalósul .
A mezőben function ki lehet választani egy bizonyos funkciót az anomáliák keresésére. Továbbá rare, van még néhány érdekes funkció — . Ezek az anomáliákat a metrikák viselkedésében mutatják ki a nap vagy a hét folyamán, megfelelően. A többi elemzési funkció .
A field_name azt a dokumentumtáblát jelöli, amely alapján az elemzés zajlik. By_field_name használható az elemzési eredmények különböző értékek alapján történő szétválasztásához a megadott dokumentumtáblán. Ha kitöltjük over_field_name population-elemzést kapunk, amelyet fentebb tárgyaltunk. Ha megadunk egy értéket a partition_field_name, akkor ez alapján a dokumentumtáblán különböző alapvonalakat számítanak ki minden értékhez (az érték szerepét játszhatja például a szerver neve vagy egy folyamat neve a szerveren). Az exclude_frequent szűrhetjük az mind vagy nincs, ami azt jelenti, hogy kizárjuk (vagy belefoglaljuk) a gyakran előforduló dokumentumértékeket.
A cikkben megpróbáltuk a lehető legszűkebben bemutatni a gépi tanulás lehetőségeit az Elastic Stacken, a háttérben még sok részlet megmaradt. Kérjük, írja meg a megjegyzés szekcióban, milyen eseteket tudott megoldani az Elastic Stack segítségével, és milyen feladatokra használja. Kapcsolatba léphet velünk a Habr személyes üzenetein keresztül vagy .
Forrás: habr.com
